Microsoft Fabric中的Eventstream是一个全托管的事件摄取和流式传输服务,支持实时数据处理和分析。 你可以用 Spark 结构化流式传输将事件流与 Fabric 笔记本集成,实时处理和分析流数据。
这种集成让你可以通过 Real-Time 中心,直接在Fabric笔记本中探索事件流和其他实时来源。 你还可以创建新的事件流,并开始从近30个(且还在增长)的流媒体来源中获取数据,包括支持CDC的数据库、消息代理、流媒体服务和公共订阅源。 新的编程模型允许你轻松连接事件流、读取流数据,并使用熟悉的Spark API进行实时分析,无需连接字符串或凭证,使构建实时应用更加安全
先决条件
在开始之前,请确保满足以下先决条件:
- 一个启用事件流的 Fabric 工作区。
- 一个用 Fabric 搭建的笔记本环境。
- Spark 结构化流式处理和 PySpark 或 Scala 的基本知识。
从笔记本查询事件流的步骤
在 Notebook 中发现和添加事件流:
打开Microsoft Fabric 笔记本。
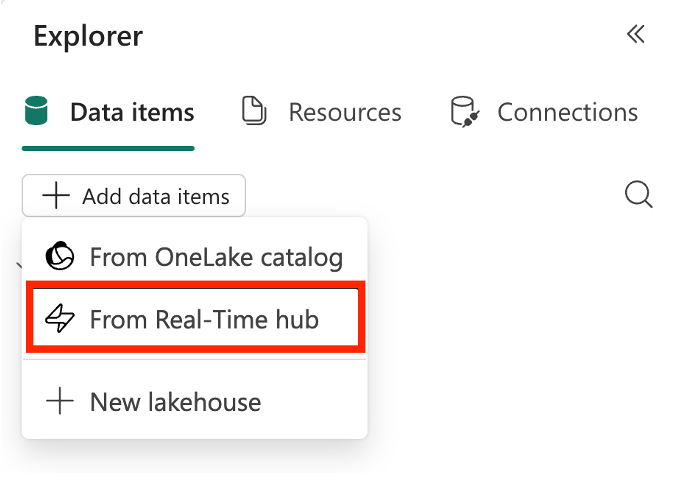
在“数据项”选项卡下选择“添加数据项”,然后从下拉菜单中选择“来自实时中心”。
在“Real-Time 中心”对话框中,找到想要使用不同的搜索和筛选选项查询的目标事件流。
将事件流添加到笔记本环境。
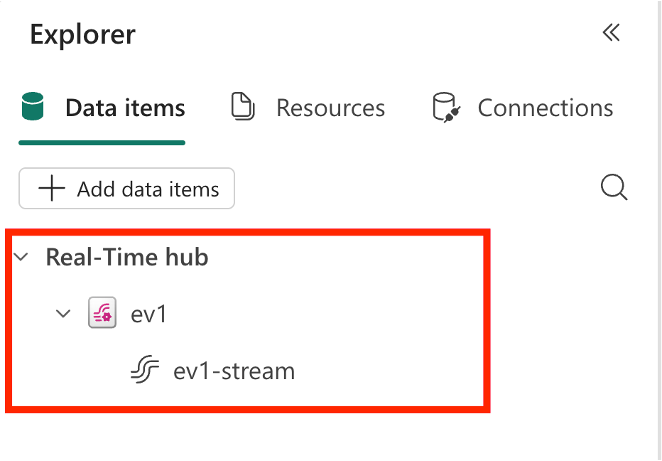
添加事件流项后,它将显示在笔记本对象资源管理器中的 Real-Time 中心 节点下,并具有该项名称。展开该节点后,你将看到事件流项内的默认流或派生流。
从事件流读取流数据:
从对象资源管理器中事件流项的上下文菜单中,选择“ 使用 Spark 读取 ”以创建预配置的代码单元以从所选事件流中读取。
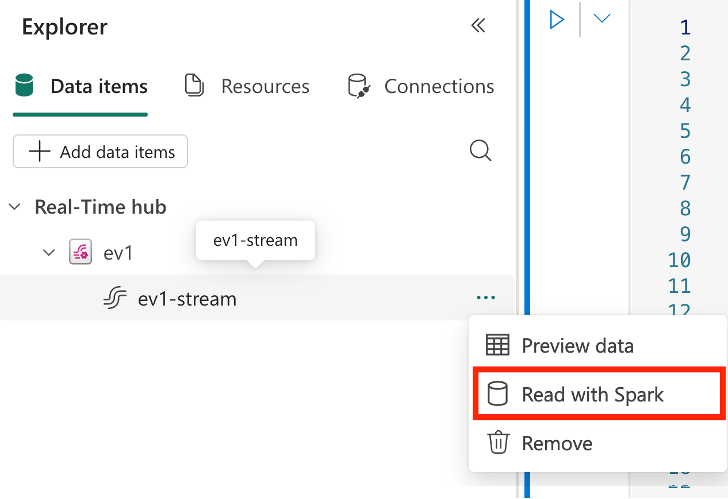
在新创建的代码单元中,可以使用以下 PySpark 代码片段从事件流读取流数据:
from pyspark.sql import SparkSession from pyspark.sql.functions import col from pyspark.sql.types import StringType from pyspark.sql.dataframe import DataFrame eventstream_options = { "eventstream.itemid": __in_eventstream_item_id, "eventstream.datasourceid": __in_eventstream_datasource_id } # Read from Kafka using the config map df_raw = spark.readStream.format("kafka").options(**eventstream_options).load() decoded_df = df_raw.select( col("key").cast(StringType()).alias("key"), col("value").cast(StringType()).alias("value"), col("partition"), col("offset") ) def showDf(x:DataFrame, y:int): x.show() # Print messages to the console query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start() query.awaitTermination()eventstream.itemid值和eventstream.datasourceid选项会自动填充在此代码单元格上方的参数代码单元中。注释
对于每次在使用 Spark 进行读取时的选择,都会生成一个新的代码单元,自动填充必要参数,并为事件流项创建一个新的 Notebook 目标,其中每个 Notebook 目标都是唯一的
eventstream.datasourceid。 对于一个笔记本项,建议将其设置为一个事件流项的目标一次,以避免创建多个目标。在运行任何作业之前,还可以通过在 Eventstream 项的上下文菜单中单击 “预览数据 ”按钮来预览流数据。 一个侧面板将打开,以便在笔记本旁边显示流式数据的快照。
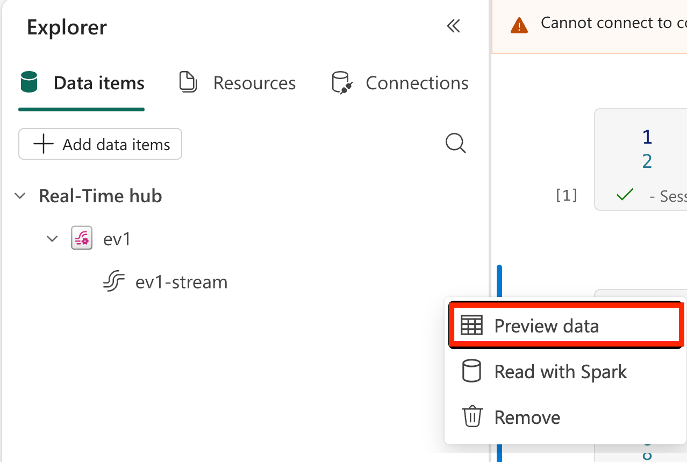
将笔记本添加为目标:还可以将笔记本添加为 Eventstream 的目标,以便从笔记本中开始将数据引入到 Eventstream 中。 有关详细信息,请参阅 向事件流添加 Spark Notebook 目标。
结论
通过Spark结构化流在Fabric中与笔记本集成事件流,可以无缝处理和分析实时数据。 按照本文所述步骤操作,你可以轻松连接事件流,读取流数据,并使用熟悉的Spark API进行实时分析。 这一整合为构建实时应用和从Fabric生态系统内流数据中获取洞察打开了新可能。
相关内容
想了解更多关于在 Fabric 中使用事件流和笔记本的方法,请查看以下资源