适用于:✅ Microsoft Fabric 中的“仓库”模块
本文介绍了从Azure Synapse Analytics专用SQL池迁移到Microsoft Fabric Data Warehouse的方法。
小提示
有关迁移策略和规划的更多信息,请参阅 迁移规划:从 Azure Synapse Analytics 专用 SQL 池迁移到 Fabric Data Warehouse。
使用适用于数据仓库的 Fabric 迁移助手可实现从 Azure Synapse Analytics 专用 SQL 池迁移的自动化体验。 本文的其余部分包含更多手动迁移步骤。
下表总结了数据模式(DDL)、数据库代码(DML)和数据的迁移方法。 选项栏链接到每个场景的详细信息。
| 选项编号 | 选项 | 它的作用是什么 | 技能或偏好 | 方案 |
|---|---|---|---|---|
| 1 | 数据工厂 | 架构 (DDL) 转换 数据提取 数据引入 |
ADF/管道 | 简化的一体式架构 (DDL) 和数据迁移。 建议用于维度表。 |
| 2 | 具有分区的数据工厂 | 架构 (DDL) 转换 数据提取 数据引入 |
ADF/管道 | 使用分区选项增加读/写并行度,与选项 1(事实数据表的建议选项)相比,吞吐量是其 10 倍。 |
| 3 | 具有加速代码的数据工厂 | 架构 (DDL) 转换 | ADF/管道 | 首先转换并迁移架构(DDL),然后使用 CETAS 提取数据,并使用 COPY/数据工厂导入数据,以获得最佳的整体导入性能。 |
| 4 | 存储过程加速代码 | 架构 (DDL) 转换 数据提取 代码评估 |
T-SQL | 使用 IDE 的 SQL 用户可以更精细地控制要处理的任务。 使用 COPY/数据工厂导入数据。 |
| 5 | Visual Studio Code 的 SQL 数据库项目扩展 | 架构 (DDL) 转换 数据提取 代码评估 |
SQL 项目 | 用于部署的 SQL 数据库项目与选项 4 的集成。 使用 COPY 或数据工厂引入数据。 |
| 6 | 创建外部表 AS SELECT (CETAS) | 数据提取 | T-SQL | 将高性能数据提取到 Azure Data Lake Storage (ADLS) Gen2 中,经济高效。 使用 COPY/数据工厂导入数据。 |
| 7 | 使用 dbt 进行迁移 | 架构 (DDL) 转换 数据库代码 (DML) 转换 |
dbt | 现有 dbt 用户可以使用 dbt Fabric 适配器转换其 DDL 和 DML。 然后,必须使用此表中的其他选项迁移数据。 |
选择初始迁移的工作负载
在决定从何处着手开展从 Synapse 专用 SQL 池迁移到 Fabric Data Warehouse 的项目时,请选择一个您可以执行以下操作的工作负载领域:
- 通过快速提供新环境的好处,证明迁移到Fabric Data Warehouse的可行性。 从小而简单的开始,准备多次小迁徙。
- 给予内部技术人员时间,以便他们在迁移到其他领域时能够积累使用相关流程和工具的经验。
- 为进一步的迁移创建模板,该模板需特定于源 Synapse 环境以及当前已有的有用工具和流程。
小提示
创建一个迁移对象清单,并从头到尾记录迁移过程,以便你能为其他专用的 SQL 池或工作负载重复。
初始迁移中迁移的数据量应足够大以展示Fabric Data Warehouse环境的能力和优势,但又不能过大以快速展示价值。 典型的大小为 1-10 TB。
使用 Fabric 数据工厂进行迁移
本节介绍了熟悉 Azure 数据工厂 和 Synapse 管道的用户的数据工厂选项。 拖拽式界面提供了一种简单的方式来转换DDL和迁移数据。
Fabric 数据工厂可以执行以下任务:
- 将模式(DDL)转换为Fabric Data Warehouse语法。
- 在Fabric Data Warehouse上创建模式(DDL)。
- 将数据迁移到Fabric Data Warehouse。
选项 1. 模式与数据迁移——复制数据助手和ForEach 复制活动
该方法使用Data Factory Copy data Assistant连接到源专用SQL池,将专用SQL池的DDL语法转换为Fabric,并将数据复制到Fabric Data Warehouse。 可以选择一个或多个目标表(对于 TPC-DS 数据集,有 22 个表)。 这会生成 ForEach 以循环访问 UI 中选择的表清单,并生成 22 个并行的“复制活动”线程。
- 22
SELECT个查询(每个选定的表一个)在专用的SQL池中生成并执行。 - 确保你有合适的 DWU 和资源类,以允许生成的查询执行。 在这种情况下,你至少需要 DWU1000 和
staticrc10,以允许最多 32 个查询来处理提交的 22 个查询。 - 使用 Data Factory 将数据从专用 SQL 池直接复制到 Fabric 数据仓库时,需要暂存。 摄入过程分为两个阶段:
- 第一阶段将专用SQL池中的数据提取到ADLS。 这个阶段称为分阶段。
- 第二阶段将分阶段的数据导入Fabric Data Warehouse。 大部分摄入时间都花在分段阶段,因此分段对性能有显著影响。
建议用途
使用复制助手生成 ForEach 活动,可提供一个简洁的界面,以便一步完成 DDL 转换,并将专用 SQL 池中的选定表引入到 Fabric Data Warehouse 中。
然而,这种方式并不能提供最优的整体吞吐量。 分级以及源到阶段读写并行化的需求是延迟的主要原因。 仅在尺寸表中使用此选项。
选项 2. DDL/数据迁移 - 使用分区选项的管道
为了提高吞吐量,当你用 Fabric 管道加载更大的事实表时,可以为每个事实表使用 复制活动 并启用分区。 这种配置能提供最佳的 复制活动 性能。
如果可用,请使用源表的物理分区。 如果表没有物理分区,指定一个分区列以及动态分区的最小值和最大值。 在下面的截图中,流水线 源 选项根据列 ws_sold_date_sk 指定了一个动态分区范围。

分区可以提升暂存阶段的吞吐量。 配置时请参考以下指导:
- 根据分区范围的不同,操作可能生成超过 128 个查询,并使用专用 SQL 池中的所有并发时隙。
- 你必须将其扩展到至少 DWU6000,才能执行所有查询。
- 例如,对于 TPC-DS
web_sales表,163 个查询已提交到专用 SQL 池。 在 DWU6000 下,执行了 128 个查询,同时有 35 个查询处于排队状态。 - 动态分区会自动选择范围分区。 在这种情况下,每个提交到专用 SQL 池的 SELECT 查询的范围为 11 天。 例如:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
建议用途
对于事实表,使用带有分区选项的数据工厂以提高吞吐量。
然而,并行读取需要你将专用的 SQL 池扩展到更高的 DWU,以便执行提取查询。 采用分区时,速率比不采用分区高出十倍。 你可以提高 DWU 以提升吞吐量,但专用的 SQL 池最多允许 128 个活跃查询。
如需了解有关 Synapse DWU 与 Fabric 之间映射关系的更多信息,请参阅博客:将 Azure Synapse 专用 SQL 池映射到 Fabric Data Warehouse 计算。
选项 3. DDL 迁移 - 复制数据助手 针对每个 复制活动
前两种方案适用于 较小 的数据库。 如果你需要更高的吞吐量,可以使用以下方案:
- 将数据从专用 SQL 池提取到 ADLS,以减少暂存开销。
- 使用Data Factory或COPY命令将数据导入仓库。
建议用途
您可以继续使用数据工厂来转换您的模式 (DDL)。 通过使用复制数据助手,您可以选择具体的表格或 所有表格。 该方法在设计上会一步完成架构迁移,方法是在查询语句中使用 false 条件 TOP 0,仅提取架构而不提取任何行数据。
以下代码示例介涵盖了使用数据工厂进行架构 (DDL) 迁移。
代码示例:使用数据工厂进行架构 (DDL) 迁移
你可以使用 Fabric Pipelines,轻松迁移来自任何源 Azure SQL 数据库 或专用 SQL 池的表对象的 DDL(架构)。 该流水线将源专用SQL池表的模式(DDL)迁移到Fabric Data Warehouse。

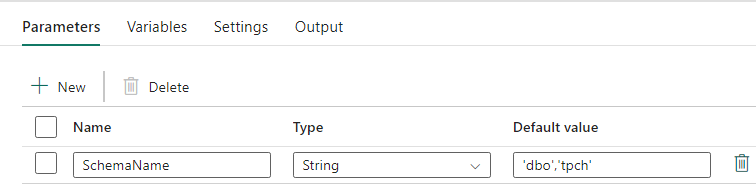
管道设计:参数
该流水线接受一个参数 SchemaName,你用它来指定要迁移哪些模式。 默认模式为 dbo。
在“默认值”字段中,输入逗号分隔的表架构列表,以指示要迁移的模式: 提供两个模式,分别为 'dbo','tpch' 和 dbo。tpch
管道设计:查找活动
创建“查找活动”并将连接设置为指向源数据库。
在“设置”选项卡中:
将“数据存储类型”设置为“外部”。
连接是你的 Azure Synapse 专用 SQL 池。 “连接类型”为“Azure Synapse Analytics”。
“使用查询”设置为“查询”。
通过动态表达式构建 查询 字段,这样你可以在查询中使用该参数
SchemaName返回目标源表列表。 选择 查询 ,然后选择 添加动态内容。查找活动中的此表达式将生成一个 SQL 语句来查询系统视图,以检索架构和表的列表。 它引用该
SchemaName参数以便对 SQL 模式进行过滤。 该表达式的输出是 ForEach 活动作为输入的 SQL 模式和表数组。使用以下代码返回所有用户表及其架构名称的列表。
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

管道设计:ForEach 循环
对于 ForEach 循环,请在“设置”选项卡中配置以下选项:
- 禁用 Sequential,以允许多个迭代并发运行。
- 将“批次数量”设置为 ,从而限制并发迭代的最大次数。
50 - 在 “Items ”字段中使用动态内容来引用LookUp活动的输出。 添加以下代码片段:
@activity('Get List of Source Objects').output.value

管道设计:ForEach 循环中的复制活动
在 ForEach 活动内,添加一个复制活动。 该方法在管道内使用动态表达式语言构建 SELECT TOP 0 * FROM <TABLE> 语句,仅将无数据的模式迁移到仓库。
在“源”选项卡中:
- 将“数据存储类型”设置为“外部”。
- 连接是你的 Azure Synapse 专用 SQL 池。 “连接类型”为“Azure Synapse Analytics”。
- 将“使用查询”设置为“查询”。
- 在 查询 字段中,粘贴动态内容查询,并使用该表达式,返回零行,但包含表模式:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

在“目标”选项卡中:
- 将“数据存储类型”设置为“工作区”。
- 将 Workspace 数据存储类型设置为 Data Warehouse,并将 Data Warehouse 设置为仓库。
- 目标表的架构和表名称是使用动态内容定义的。
- 模式指当前迭代的字段,
SchemaName摘要如下:@item().SchemaName - 表引用了
TableName,代码片段为:@item().TableName
- 模式指当前迭代的字段,

管道设计:接收器
对于接收器,请指向仓库并引用源架构和表名称。
运行这个管道时,你会看到仓库里用正确的模式填充了源代码中的每个表。
通过使用Synapse专用SQL池中的存储过程进行迁移
该选项使用存储过程进行迁移到Fabric Data Warehouse。
你可以在 github.com 上的 microsoft/fabric-migration 获取代码示例。 此代码作为开放源代码共享,因此尽情贡献内容并帮助社区。
Fabric 迁移存储过程能做什么:
- 将模式(DDL)转换为Fabric Data Warehouse语法。
- 在Fabric Data Warehouse上创建模式(DDL)。
- 将数据从 Synapse 专用 SQL 池提取到 ADLS。
- 标记不支持的 T-SQL 代码(存储过程、函数、视图)的 Fabric 语法。
建议用途
如果你符合以下情况,此选项非常适合你:
- 熟悉 T-SQL。
- 想用集成开发环境来开发T-SQL。
- 想要更细致地控制你负责哪些任务。
可以执行架构 (DDL) 转换、数据提取或 T-SQL 代码评估的特定存储过程。
在数据迁移时,可以使用 COPY INTO 或 Fabric Data Factory 将数据导入仓库。
使用 SQL 数据库项目进行迁移
Fabric Data Warehouse 支持 Visual Studio Code 内部可用的 SQL 数据库项目扩展。
此扩展在 Visual Studio Code 中可用。 此功能支持源代码管理、数据库测试和架构验证的功能。
有关源代码控制的更多信息,请参见 开发与部署概述。
建议用途
如果你更喜欢用SQL Database Project进行部署,可以使用这个选项。 该选项将 Fabric 迁移存储过程集成到 SQL 数据库项目中,提供无缝的迁移体验。
SQL 数据库项目可以:
- 将模式(DDL)转换为Fabric Data Warehouse语法。
- 在Fabric Data Warehouse上创建模式(DDL)。
- 将数据从 Synapse 专用 SQL 池提取到 ADLS。
- 标记 T-SQL 代码(存储过程、函数、视图)不支持的语法。
在数据迁移时,可以使用 COPY INTO 或Data Factory来将数据导入仓库。
Microsoft Fabric CAT 团队提供 PowerShell 脚本,通过 SQL 数据库项目提取、创建和部署模式(DDL)和数据库代码(DML)。 想看攻略,可以看 GitHub 上的 microsoft/fabric-migration。
有关 SQL 数据库项目的详细信息,请参阅 SQL 数据库项目扩展入门 ,并从 命令行生成数据库项目。
使用 CETAS 迁移数据
T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS)命令提供了最经济且最优的方法,将数据从Azure Synapse专用SQL池中提取到Azure Data Lake Storage(ADLS)Gen2。
CETAS 的功能:
- 将数据提取到 ADLS 中。
- 这个选项要求你在仓库里创建架构(DDL),然后再导入数据。 迁移架构 (DDL) 时,请考虑本文中的选项。
此选项的优点包括:
- 迁移过程针对每个表仅向源 Synapse 专用 SQL 池提交一个查询。 这个查询不会占用所有并发槽,也不会阻止并发客户生产的ETL或查询。
- 你不需要将规模扩展到 DWU6000,因为每个表仅使用一个并发槽位,因此可以使用更低的 DWU 级别。
- 提取过程在所有计算节点间并行运行,这一特性提升了性能。
建议用途
使用 CETAS 将数据作为 Parquet 提取到 ADLS 中。 Parquet 文件借助列式压缩,实现了高效的数据存储,并且在网络中传输时占用更少带宽。 由于 Fabric 以 Delta Parquet 格式存储数据,因此与文本文件格式相比,数据引入速度快 2.5 倍,因为在引入过程中无需承担转换为 Delta 格式的额外开销。
增加 CETAS 吞吐量:
- 添加并行 CETAS 操作,增加并发槽的使用,但可以提高吞吐量。
- 在 Synapse 专用 SQL 池上缩放 DWU。
通过 dbt 进行迁移
本节说明了适用于已在 Synapse 专用 SQL 池环境中使用 dbt 的客户的 dbt 选项。
dbt 的功能:
- 将模式(DDL)转换为Fabric Data Warehouse语法。
- 在Fabric Data Warehouse上创建模式(DDL)。
- 将数据库代码 (DML) 转换为 Fabric 语法。
dbt 框架在每次执行时都会动态生成 DDL 和 DML (SQL 脚本)。 通过使用以 SELECT 语句编写的模型文件,dbt 只需更改配置文件(连接字符串)和适配器类型,即可将 DDL/DML 即时转换为适用于任何目标平台的语句。
建议用途
DBT框架采用代码优先的方法。 通过本文档中列出的选项(如 CETAS 或 COPY/Data Factory)进行数据迁移。
通过使用 dbt 适配器 for Microsoft Fabric Data Warehouse,您可以通过简单的配置更改,将针对不同平台(如 Azure Synapse 专用 SQL 池、Snowflake、Databricks、Google BigQuery 或 Amazon Redshift)的现有 dbt 项目迁移到仓库。
要开始针对Fabric Data Warehouse的DBT项目,请参见教程:为Fabric Data Warehouse设置DBT。 该文档还列出了在不同仓库和平台之间移动的选项。
将数据引入到 Fabric Data Warehouse
如果要导入Fabric Data Warehouse,可以根据你的偏好使用COPY INTO或Fabric Data Factory。 这两种方法是推荐且性能最佳的选择,因为它们在文件已解压为 Azure Data Lake Storage(ADLS)Gen2 的前提下,具有等效的性能吞吐量。
通过考虑以下因素,设计您的流程以实现最大性能:
- 有了Fabric,从ADLS同时加载多个表到Fabric Data Warehouse时,没有资源争用。 因此,在加载并行线程时不会出现性能下降。 最大引入吞吐量的唯一限制因素是 Fabric 容量的计算能力。
- Fabric 工作负荷管理可分离为加载和查询分配的资源。 查询和数据加载同时执行时,没有资源争用。