适用于: Linux 上的 SQL Server
本文介绍如何在 Linux 上运行 SQL Server 故障转移群集实例 (FCI)。 要在 Linux 上创建 SQL Server FCI,请参见“配置 Linux 故障转移集群实例(RHEL)”。
体系结构说明
集群层基于基于Pacemaker构建的Red Hat Enterprise Linux(RHEL)HA插件。 Corosync 和 Pacemaker 协调群集通信和资源管理。 SQL Server实例一次只激活一个节点。
下图显示了 SQL Server 的 Linux 群集中的组件。
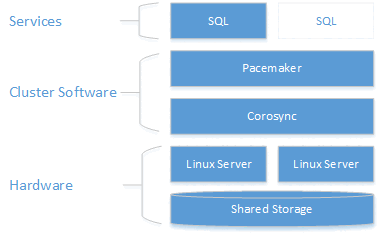
欲了解更多关于集群配置、资源代理选项和管理的信息,请访问 RHEL 参考文档。
Failover
FCI 的故障转移类似于 Windows Server 故障转移群集 (WSFC)。 如果托管 FCI 的群集节点遇到某种故障,FCI 应自动故障转移到另一个节点。 与 WSFC 不同,无法设置首选所有者,因此 Pacemaker 选取即将成为 FCI 新主机的节点。
有时你可能想手动将FCI切换到另一个节点。 此过程与 WSFC 上的 FCI 不同。 在 WSFC 上,可以在角色级别对资源进行故障转移。 在Pacemaker中,你选择一个资源来移动,如果所有约束都正确,其他所有东西也会移动。
切换方式取决于Linux发行版。 按照你Linux发行版的说明操作。
手动故障切换(RHEL 或 Ubuntu)
若要执行手动故障转移,请在 Red Hat Enterprise Linux (RHEL) 或 Ubuntu 服务器上执行以下步骤。
发出以下命令:
sudo pcs resource move <FCIResourceName> <NewHostNode><FCIResourceName>是SQL Server FCI的Pacemaker资源名称,是<NewHostNode>你想托管FCI的集群节点名称。在手动故障转移过程中,Pacemaker 会对已选择手动移动的资源创建位置约束。 若要查看此约束,请运行
sudo pcs constraint。故障切换完成后,移除该约束:
sudo pcs resource clear <FCIResourceName>
手动故障切换(SLES)
Note
从 SQL Server 2025(17.x)开始,不支持 SUSE Linux Enterprise Server (SLES)。 对于 SQL Server 2022(16.x)及更早版本,仅支持 SLES 15。
在 SUSE Linux Enterprise Server (SLES) 中,使用 migrate 命令手动故障转移 SQL Server FCI。 例如:
crm resource migrate <FCIResourceName> <NewHostNode>
<FCIResourceName> 是故障转移集群实例的资源名称,是 <NewHostNode> 新目标主机的名称。
监控故障切换集群
查看当前群集状态:
sudo pcs status
查看集群和资源的实时状态:
sudo crm_mon
在 /var/log/cluster/corosync.log 查看资源代理日志。
向群集添加节点
检查每个节点的 IP 地址。 以下脚本显示当前节点的 IP 地址。
ip addr show新节点需要一个不超过15字符的唯一名称。 通过将计算机名添加到
/etc/hosts来设置该名称。 以下脚本可使用/etc/hosts编辑vi。sudo vi /etc/hosts以下示例展示了
/etc/hosts,其中包含了三个名为sqlfcivm1、sqlfcivm2和sqlfcivm3的节点的新增项。127.0.0.1 localhost localhost4 localhost4.localdomain4 ::1 localhost localhost6 localhost6.localdomain6 10.128.18.128 sqlfcivm1 10.128.16.77 sqlfcivm2 10.128.14.26 sqlfcivm3此文件在每个节点上应相同。
在新节点上停止 SQL Server 服务。
按照说明将数据库文件目录挂载到共享位置。
从 NFS 服务器安装
nfs-utils:sudo yum -y install nfs-utils在客户端和 NFS 服务器上打开防火墙:
sudo firewall-cmd --permanent --add-service=nfs
sudo firewall-cmd --permanent --add-service=mountd
sudo firewall-cmd --permanent --add-service=rpc-bind
sudo firewall-cmd --reload
编辑
/etc/fstab文件,将装载命令包括在内:<IP OF NFS SERVER>:<shared_storage_path> <database_files_directory_path> nfs timeo=14,intr运行
mount -a使更改生效。在新节点上,创建一个文件来存储用于登录 Pacemaker 的 SQL Server 用户名和密码。 以下命令创建并填充此文件:
sudo touch /var/opt/mssql/secrets/passwd
echo "<loginName>" | sudo tee -a /var/opt/mssql/secrets/passwd
echo "<password>" | sudo tee -a /var/opt/mssql/secrets/passwd
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 600 /var/opt/mssql/secrets/passwd
Caution
密码应遵循 SQL Server 默认密码策略。 默认情况下,密码必须为至少八个字符且包含以下四种字符中的三种:大写字母、小写字母、十进制数字、符号。 密码可最长为 128 个字符。 使用的密码应尽可能长,尽可能复杂。
在新节点上,打开 Pacemaker 防火墙端口。 若要使用
firewalld打开这些端口,请运行以下命令:sudo firewall-cmd --permanent --add-service=high-availability sudo firewall-cmd --reload如果你使用的是没有内置高可用性配置的防火墙,请为Pacemaker打开以下端口,以便与集群中的其他节点通信:
- TCP:端口 2224、3121、21064
- UDP:端口 5405
在新节点上安装 Pacemaker 包。
sudo yum install pacemaker pcs fence-agents-all resource-agents为安装 Pacemaker 和 Corosync 包时创建的默认用户设置密码。 使用与现有节点相同的密码。
sudo passwd hacluster启用并启动
pcsd服务和 Pacemaker 服务。 新节点在重启后可以重新加入集群。 在新节点上运行以下命令。sudo systemctl enable pcsd sudo systemctl start pcsd sudo systemctl enable pacemaker为 SQL Server 安装 FCI 资源代理。 在新节点上运行以下命令。
sudo yum install mssql-server-ha在集群中的现有节点上,对新节点进行认证并将其添加到集群中:
sudo pcs cluster auth <nodeName3> -u hacluster
sudo pcs cluster node add <nodeName3>
从群集中删除节点
若要从群集中移除节点,请运行以下命令:
sudo pcs cluster node remove <nodeName>
更改资源监控频率
sudo pcs resource op monitor interval=<interval>s <sqlResourceName>
以下示例将资源的监控间隔设置为2秒 mssqlha :
sudo pcs resource op monitor interval=2s mssqlha
故障排除
在对群集进行故障排除时,了解三个守护程序如何协同工作以管理群集资源会有所帮助。
| Daemon | Description |
|---|---|
| Corosync | 提供仲裁成员资格以及群集节点之间的消息传递。 |
| 起搏器 | 构建于 Corosync 之上,并为资源提供状态机。 |
| PCSD | 通过 pcs 工具管理 Pacemaker 和 Corosync。 |
需要运行 PCSD 才能使用 pcs 工具。
当前群集状态
sudo pcs status 返回有关集群、仲裁、节点、资源以及每个节点上的守护进程状态的基本信息。
以下示例显示了健康的Pacemaker法定人数输出:
Cluster name: MyAppSQL
Last updated: Wed Oct 31 12:00:00 2024  Last change: Wed Oct 31 11:00:00 2024 by root via crm_resource on sqlvmnode1
Stack: corosync
Current DC: sqlvmnode1  (version 1.1.13-10.el7_2.4-44eb2dd) - partition with quorum
3 nodes and 1 resource configured

Online: [ sqlvmnode1 sqlvmnode2 sqlvmnode3 ]

Full list of resources:

mssqlha (ocf::sql:fci): Started sqlvmnode1

PCSD Status:
sqlvmnode1: Online
sqlvmnode2: Online
sqlvmnode3: Online

Daemon Status:
corosync: active/disabled
pacemaker: active/enabled
在此例中, partition with quorum 表示节点的多数集数在线。 如果群集失去节点多数仲裁,pcs status 将返回 partition WITHOUT quorum,并且所有资源均会停止运行。
Online: [sqlvmnode1 sqlvmnode2 sqlvmnode3] 返回当前参与此群集所有节点的名称。 如果有任何节点未参与,pcs status 返回 OFFLINE: [<nodename>]。
PCSD Status 显示每个节点的群集状态。
节点可能处于脱机状态的原因
节点处于脱机状态时检查以下各项。
防火墙
在所有节点上打开以下端口,让Pacemaker能够通信:
- TCP:端口 2224、3121、21064
- UDP:端口 5405
Pacemaker 或 Corosync 服务正在运行
节点通信
节点名映射