卷积神经网络
- 15 分钟
在上一单元中,我们学习了如何定义泛型多层神经网络。 在本单元中,我们将了解用于计算机视觉的 卷积神经网络(CNN)。
计算机视觉不同于通用分类,因为当我们尝试在图片中查找特定对象时,我们将扫描图像以查找某些特定 模式 及其组合。 例如,在寻找猫时,我们首先可能会寻找水平线,这可以形成胡须,然后某些胡须组合可以告诉我们,它实际上是猫的图片。 某些模式的位置和存在非常重要。 为了提取模式,我们将使用 卷积筛选器的概念。
但首先,让我们加载所有依赖项并定义我们将使用的帮助程序函数:
import keras
import tensorflow as tf
import matplotlib.pyplot as plt
import numpy as np


def plot_convolution(data, t, title=''):
    t = tf.constant(t, dtype=tf.float32)
    t = tf.reshape(t, [*t.shape, 1, 1])
    fig, ax = plt.subplots(len(data), 2)
    fig.suptitle(title, fontsize=16)
    for i in range(len(data)):
        d = tf.reshape(tf.constant(data[i], dtype=tf.float32), [1, *data[i].shape, 1])
        ax[i][0].imshow(data[i])
        ax[i][1].imshow(tf.nn.conv2d(d, t, [1, 1, 1, 1], 'SAME')[0, ..., 0])


def plot_results(hist):
    plt.figure(figsize=(12, 4))
    plt.subplot(1, 2, 1)
    plt.plot(hist.history['accuracy'], label='Training acc')
    plt.plot(hist.history['val_accuracy'], label='Validation acc')
    plt.legend()
    plt.subplot(1, 2, 2)
    plt.plot(hist.history['loss'], label='Training loss')
    plt.plot(hist.history['val_loss'], label='Validation loss')
    plt.legend()


def display_dataset(dataset, labels=None, n=10, classes=None):
    fig, ax = plt.subplots(1, n)
    for i in range(n):
        ax[i].imshow(dataset[i])
        ax[i].axis('off')
        if labels is not None:
            # Handle both scalar labels (e.g. MNIST) and array labels (e.g. CIFAR-10)
            lbl = int(labels[i][0]) if np.ndim(labels[i]) > 0 else int(labels[i])
            ax[i].set_title(classes[lbl] if classes is not None else str(lbl))
现在,让我们加载 MNIST 数据集:
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
卷积筛选器
卷积筛选器是在图像的每个像素上运行的小型窗口,计算相邻像素的加权平均值。 它们由权重系数的矩阵定义。 让我们看看在 MNIST 手写数字上应用两个不同的卷积筛选器的示例:
plot_convolution(x_train[:5], [[-1., 0., 1.], [-1., 0., 1.], [-1., 0., 1.]], 'Vertical edge filter')
plot_convolution(x_train[:5], [[-1., -1., -1.], [0., 0., 0.], [1., 1., 1.]], 'Horizontal edge filter')
# Expected output: Two sets of images showing original digits alongside the result of applying vertical and horizontal edge filters
第一个筛选器称为 垂直边缘筛选器,它由以下矩阵定义:$$ \left(\begin{matrix} -1 & 0 & 1 \ -1 & 0 & 0 & 1 \ -1 & 0 & 1 \ \end{matrix} \right) $$ 当此筛选器滑过相对统一的像素区域时,卷积生成的加权总和接近 0, 因为正权重和负权重会取消。当它遇到垂直边缘(其中像素强度从左到右变化),卷积产生较大的正值或负值。 因此,在上面的图像中可以看到垂直边缘通过高值和低值被突出显示,而水平边缘则被平滑处理。
当我们应用水平边缘滤波器时,会发生反向效果:水平线被增强,而垂直线被削弱。
在经典计算机视觉中,将多个筛选器应用于图像以生成特征,然后机器学习算法使用这些筛选器来生成分类器。 在深度学习中,我们构建网络,使其学习最优的卷积滤波器,以独立解决分类问题。
为此,我们引入了 卷积层。
卷积层
卷积层是使用 Conv2D 类定义的。 我们需要指定以下内容:
-
filters- 要使用的筛选器数。 我们将使用 9 个不同的筛选器,这将为网络提供大量机会来探索哪些筛选器最适合我们的方案。 -
kernel_size是滑动窗口的大小。 通常使用 3x3 或 5x5 筛选器。
最简单的 CNN 只包含一个卷积层。 鉴于输入大小为 28x28,应用 9 个 5x5 筛选器后,最终张量为 24x24x9。 空间维度较小,因为默认 padding='valid' 表示未添加填充,并且只有 24 个位置,其中 5 大小的滑动窗口可以容纳在 28 像素内(28 × 5 + 1 = 24)。 使用 padding='same' 将保留空间维度,方法是在输入周围添加零填充。
卷积后,我们将 24×24×9 张量平展为大小为 5184 的单个向量,然后添加密集层以生成 10 个类。
relu 激活函数在卷积层后应用,以引入非线性。
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=9, kernel_size=(5, 5), activation='relu'),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing a Conv2D layer, Flatten, and Dense(10) with ~52k parameters
可以看到,此网络包含大约 52k 个可训练的参数(在卷积层中为 234 个 ,密集层中为 51,850 个),而完全连接的多层网络中约为 80k。 卷积网络通用化得更好,这使我们能够在较小的数据集上取得良好效果。
注释
在大多数情况下,我们希望将卷积层应用于彩色图像。 因此, Conv2D 层需要输入形状$H\times W\times C$,其中$H$ 和 $W$ 是图像的高度和宽度,$C$ 是颜色通道的数量。 对于灰度图像,我们需要与 $C=1$ 相同的形状。
在开始训练之前,我们需要重塑数据:
x_train_c = np.expand_dims(x_train, 3)
x_test_c = np.expand_dims(x_test, 3)
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
正如你所看到的,与上一单元中完全连接的网络相比,我们能够以更少的时间实现更高的准确度。 但是,训练本身需要更多资源,在非 GPU 计算机上可能会变慢。
可视化卷积层
我们还可以可视化我们已训练的卷积层的权重,以更好地理解发生了什么:
fig, ax = plt.subplots(1, 9)
l = model.layers[0].weights[0]
for i in range(9):
    ax[i].imshow(l[..., 0, i])
    ax[i].axis('off')
# Expected output: 9 small images showing the learned 5x5 convolutional filter weights
可以看到,其中一些筛选器看起来就像可以识别一些倾斜的笔划,而另一些筛选器看起来是随机的。
多层卷积神经网络 (CNN) 和池化层
首先,卷积层查找基元模式,例如水平线或垂直线。 我们可以在顶层应用进一步卷积层来查找更高级别的图案,例如基元形状。 然后,更多的卷积层可以将这些形状合并到图片的某些部分,到我们尝试分类的最终对象。
这样做时,我们还可能应用一个技巧:减小图像的空间大小。 一旦我们检测到滑动的 3x3 窗口内有一个水平笔划,它发生在哪个确切的像素上就不那么重要了。 因此,我们可以“缩小”图像的大小,这是通过使用其中一个池化层来完成的:
- 平均池化采用滑动窗口(例如,2x2 像素),并计算窗口中数值的平均值
- 最大池化用最大值替换窗口。 最大池化背后的想法是检测滑动窗口内是否存在某种模式。
因此,在典型的 CNN 中,会有几个卷积层,其中池化层位于它们之间,以减小图像的维度。 我们还将增加筛选器数量,因为随着模式变得越来越高级,我们需要寻找更多有趣的组合。
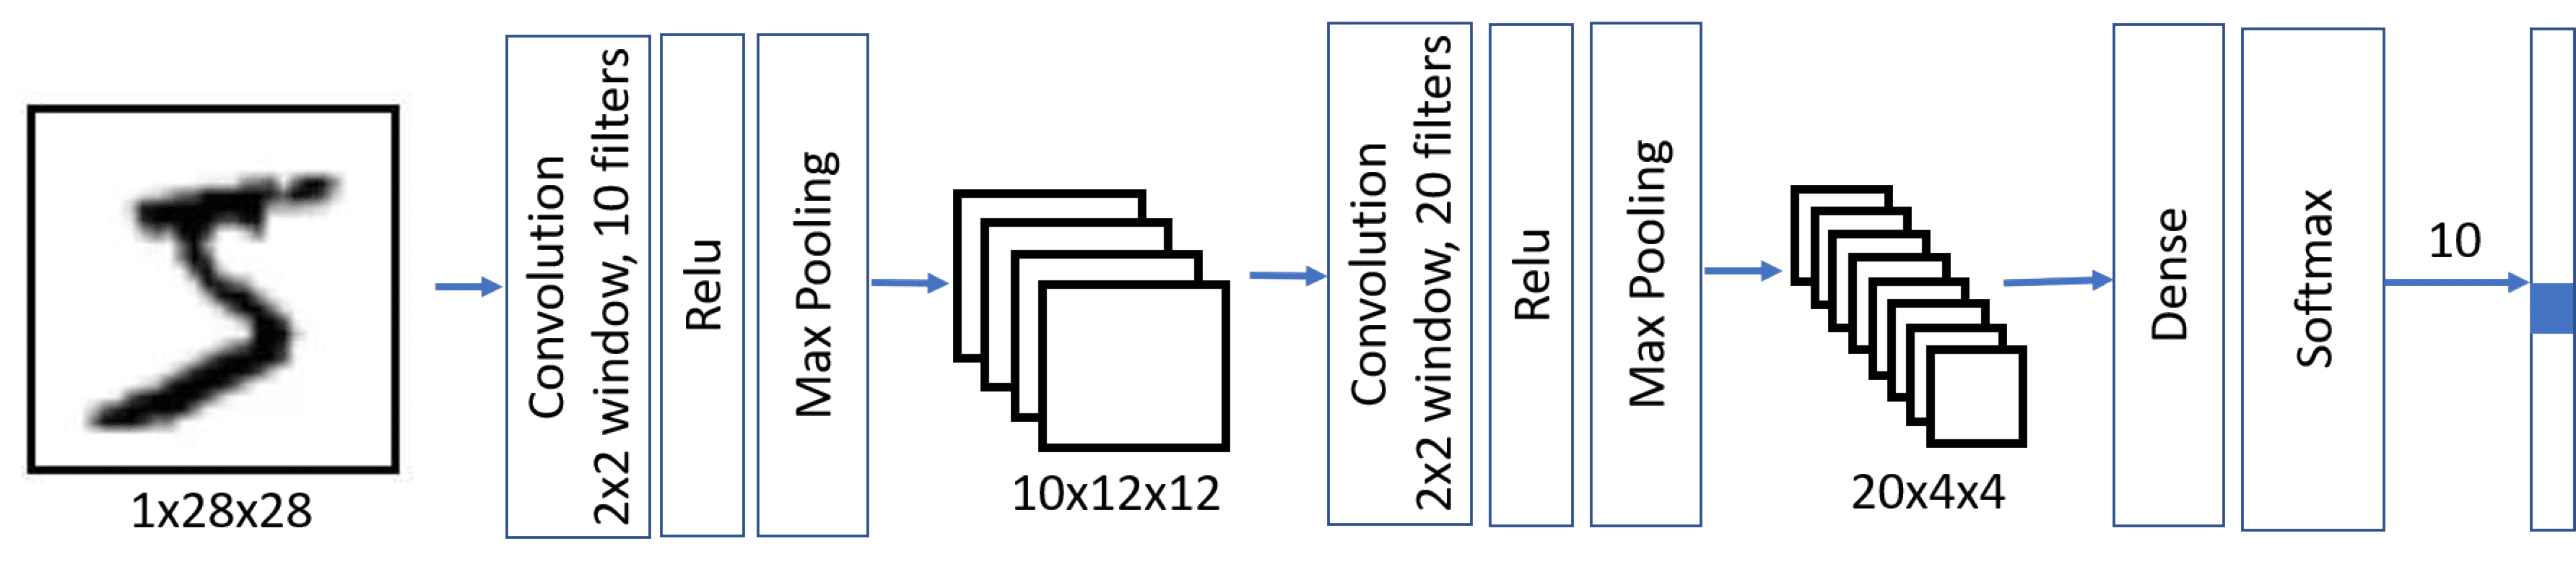
此体系结构也称为 棱锥体系结构 ,因为空间维度减少和功能/筛选器维度的增加。
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=10, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Conv2D(filters=20, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing Conv2D, MaxPooling, Conv2D, MaxPooling, Flatten, Dense with ~8.5k parameters
请注意,可训练参数(~8.5K)的数量明显小于之前的事例。 发生这种情况是因为卷积层通常很少有参数,在应用最终密集层之前图像的维度会减少。
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
请注意,我们能够通过多个层实现更高的准确度,并且需要较少的纪元。 这意味着,更复杂的网络体系结构需要更少的数据来弄清楚发生了什么,并从映像中提取泛型模式。 但是,由于额外的卷积操作,每个时期都涉及更多的计算,因此使用 GPU 训练速度更快。
利用 CIFAR-10 数据集中的真实图像
虽然我们的手写数字识别问题似乎是一个玩具问题,但我们现在准备做一些更严肃的事情。 让我们探索一个更高级的不同对象的图片数据集,称为 CIFAR-10。 它包含 60k 32x32 图像,分为 10 个类。
注释
从此开始,我们将重新加载x_train、y_train、x_test和y_test,使用 CIFAR-10 数据集替换本单元前面使用的 MNIST 数据。 扩展的维度变量 x_train_c 和 x_test_c 不再需要。
(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
display_dataset(x_train, y_train, classes=classes)
# Expected output: A row of 10 CIFAR-10 images with their class labels
经典CNN体系结构是 LeNet,由 Yann LeCun 最初提出手写数字识别。 让我们为 CIFAR-10 适配它。 它遵循上述相同的原则,主要区别是 3 个输入颜色通道而不是 1。
model = keras.Sequential([
    keras.layers.Input(shape=(32, 32, 3)),
    keras.layers.Conv2D(filters=6, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Conv2D(filters=16, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Flatten(),
    keras.layers.Dense(120, activation='relu'),
    keras.layers.Dense(84, activation='relu'),
    keras.layers.Dense(10)
])

model.summary()
# Expected output: Model summary showing the LeNet architecture with Conv2D, MaxPooling, Dense layers
训练此网络需要大量时间,应在启用 GPU 的计算上完成。
model.compile(optimizer='adam', loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])
hist = model.fit(x_train, y_train, validation_data=(x_test, y_test), epochs=10)
# Expected output: Training for 10 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 10 epochs
我们仅用几个训练周期就能达到的精度还可以。 请记住,我们的问题比 MNIST 数字分类要困难得多。 在如此短的训练时间中,获得超过 60 个% 准确性是一个很好的成就,尽管最先进的模型可以使用更深入的体系结构、数据扩充和更长的训练在 CIFAR-10 上实现超过 95 个%。
Takeaways
在本单元中,我们了解了计算机视觉神经网络(卷积网络)背后的主要概念。 支持图像分类、对象检测甚至图像生成网络的实际体系结构都基于 CNN,只是层更多,还有一些额外的训练技巧。
测试你的知识
反馈
此页面是否有帮助?
否
需要有关本主题的帮助?
想要尝试使用 Ask Learn 阐明或指导你完成本主题?