這很重要
這項功能目前處於 公開預覽版。
AI Runtime 提供兩個可管理的 Python 環境,用於無伺服器 GPU 運算。 標準環境包含 cuda。 從環境版本 5 開始, torch 且 torchvision 已不再預先安裝。 Databricks 的 AI 環境預載了 PyTorch、Transformers 及其他機器學習與深度學習框架。 選擇標準環境以完全掌控你的相依堆疊,或選擇 AI 環境,打造即用的訓練設定。 你可以從任一環境開始,自己安裝更多套件。
Tip
- 選擇 標準 環境以完全控制相依性,或選擇 Databricks AI 環境,打造現成可用的機器學習堆疊。
- 標準包括
cuda。 從環境版本 5 開始,torch且torchvision尚未預先安裝。 AI 環境新增了 PyTorch、變形金剛等功能。 - 使用
%uv pip install(環境版本 5 以上)或在筆記本中使用%pip install,或在 CLI 中使用environment.dependencies,以安裝更多套件。
該使用什麼環境
AI 執行環境提供兩個受管理的 Python 環境,分別為標準環境與 Databricks AI 環境。
| 環境 | 主要特性 | 使用時機 |
|---|---|---|
| 標準環境 | 極簡;包含 cuda。 從 環境版本 5 開始, torch 且 torchvision 已不再預先安裝。 |
你想要完全掌控你的相依性堆疊,並且偏好只安裝你需要安裝的設備 |
| Databricks AI 環境 | 預載了熱門的機器學習框架(PyTorch、Transformers 等) | 你需要一個完整的環境,用於訓練、微調和實驗,且不需要手動管理依賴性 |
你也可以使用工作區管理員為 AI 執行時建立的 workspace base 環境 。 請參見 無伺服器 GPU 運算(AI 執行時)的建置。
要在筆記本中選擇環境,請打開 環境 側面板並選擇 基底環境:
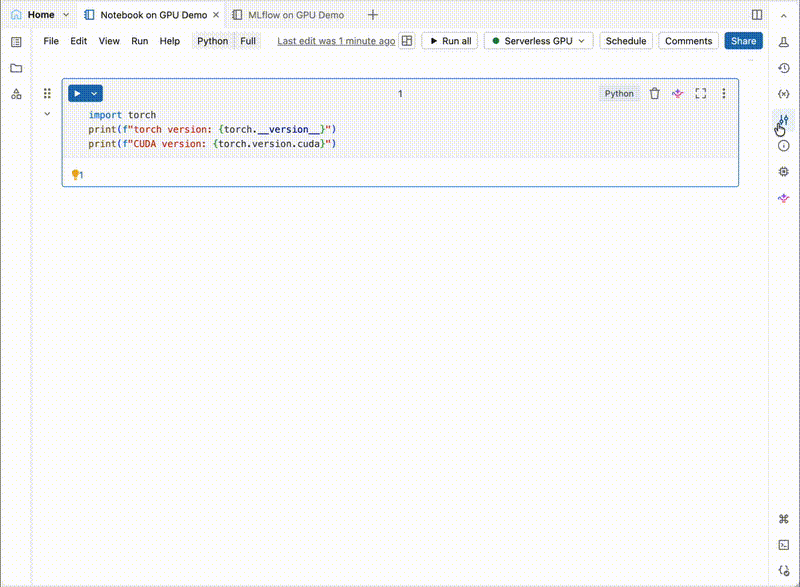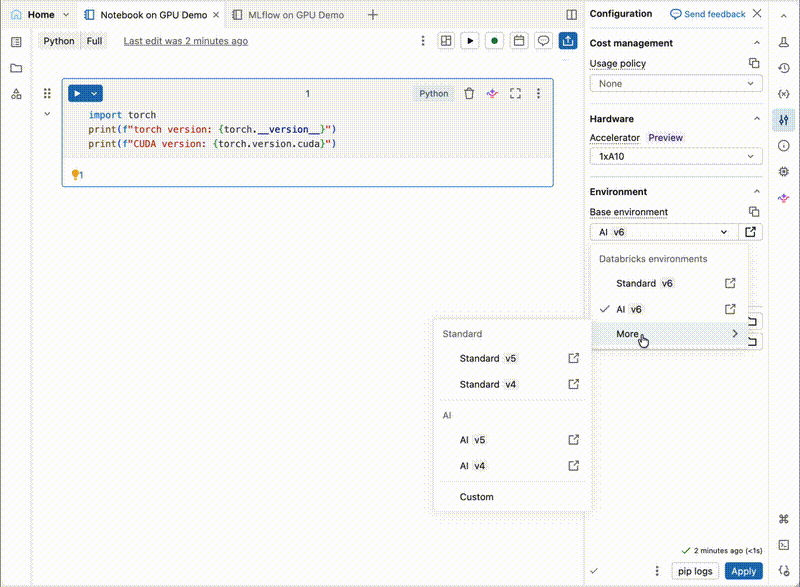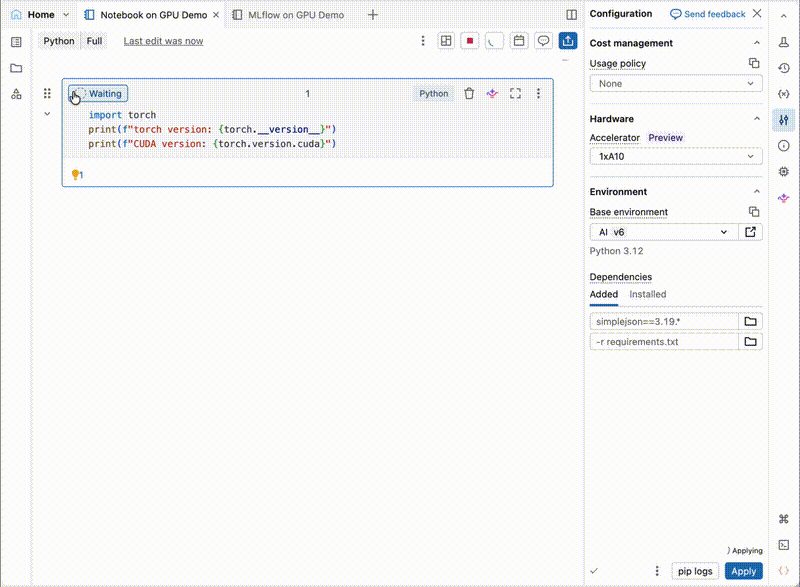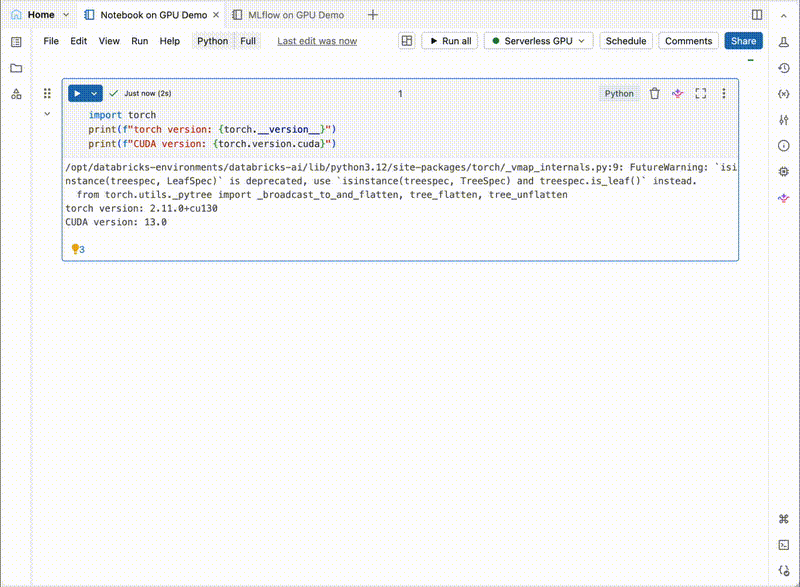
標準環境(最小環境)
一個極簡且穩定的環境,僅包含 AI 執行時運作所需的套件。 該環境包括 cuda,以支援 GPU。 從環境版本 5 開始, torch 且 torchvision 已不再預先安裝。 使用 %uv pip install 或 %pip install 安裝工作負載所需的版本。 關於每個環境版本所安裝的套件,請參閱下方的發布說明。
最佳使用者:希望完全掌控依賴堆疊,且只安裝所需內容的使用者。
選擇方式:在 環境 側面板,選擇 標準 v6 作為基礎環境。
關於不同版本中安裝的套件版本,請參閱發布說明:
Databricks AI 環境
可在環境4及更高版本中取得。 AI 環境建立在標準環境之上,包含常見的執行時套件及專為 GPU 機器學習設計的套件。 預裝套件包括:
- PyTorch(支援 CUDA)
- Transformers(Hugging Face)
- 以及額外的機器學習/深度學習相依
最適合:想要完整環境來訓練工作負載、微調與實驗,且不需手動依賴管理的機器學習從業者。
選擇方式:在 環境 側面板,選擇 AI v6 作為你的基礎環境。
關於不同版本中安裝的套件版本,請參閱發布說明:
安裝額外套件
你可以從受管理環境或工作空間基礎環境開始,然後在上面安裝自己的 Python 套件。 你怎麼安裝它們取決於你如何連接到 AI 執行環境。
在筆記本裡
在筆記本或訓練腳本的頂端使用 %uv pip 安裝套件;它會使用 uv 進行安裝,且比 %pip 更快。 固定版本,讓每次執行都可重現:
%uv pip install "trl==1.1.0"
%uv pip install "transformers==5.5.4"
如需%pip和%uv pip的完整參考資料,包括各自支援哪些環境版本,請參閱「使用%uv命令管理程式庫」。
當你使用 @distributed Decorator 處理多 GPU 工作負載時,呼叫前 .distributed() 安裝的套件會自動被快照並傳播到所有分散式程序。 安裝套件的總大小不得超過 15 GB。 更多細節請參見 「將相依關係加入筆記本」。
使用 CLI
air CLI 使用相同的受管理環境。 選擇一個含有 environment.version 的項目,然後在你的 workload YAML 中的 environment.dependencies 下方列出要安裝在其上的套件。 CLI 會將它們安裝到選定的環境中,並搭配 uv,因此你不必自行管理獨立的虛擬環境:
environment:
  version: '6'
  dependencies:
    - trl==1.1.0
    - transformers==5.5.4
若要從 Databricks 的 AI 環境開始,請設定 version 為 AI 環境識別碼,例如 databricks_ai_v5。 如需瞭解完整的相依性格式、支援的安裝旗標,以及對自訂 Docker 映像檔的支援,請參見 Python 相依性。
工作空間基層環境
工作區管理員可以建立一個無伺服器 GPU 運算的工作 空間基礎環境 ,透過 基礎環境 下拉選單讓工作空間內的所有使用者都能使用。 詳情請參見 「建構無伺服器 GPU 運算(AI 執行時)」。
若要在排程工作負載中使用基底環境,請在工作或套件的區塊中以識別碼 environments 來引用。 例如,這個宣告式自動化套件任務選擇了 Databricks 的 AI 環境:
resources:
  jobs:
    train:
      tasks:
        - task_key: train
          environment_key: default
      environments:
        - environment_key: default
          spec:
            base_environment: databricks_ai_v6
如需完整的工作範例,請參閱 使用 Jobs API 進行排程和宣告式自動化套件。
環境快取與自訂模組
環境何時被快取?
AI 執行時會快取你的筆記本環境,所以當你重新開啟筆記本時,就不需要重新安裝套件。 如需詳細資訊,請參閱 重設環境相依性。
快取適用於互動式筆記本。 透過 air CLI 執行,或排定為作業執行的工作負載不會使用此快取;每次執行時都會重新安裝其相依性。
最佳做法是將套件釘選至特定版本,這樣您的快取環境才能維持有效,並讓執行結果可重現。
我該如何匯入自訂模組?
以下步驟將示範如何使用自己的 Python 模組。
- 把程式碼同步到工作區。 將 Git 儲存庫複製到有 Git 資料夾的工作空間,或直接將檔案上傳為 工作區檔案。 團隊專案可將共用程式碼存放在
/Workspace/Shared底下,個人開發則可存放在使用者資料夾中。 把程式碼放在 Git 資料夾裡可以保持版本控制。 -
將資料夾加入
sys.path,然後在筆記本或訓練指令碼的頂端匯入它:
import sys
sys.path.append("/Workspace/Shared/my-project/src")
from my_module import my_function
局限性
以下功能在 AI 執行環境中無法提供:
- Spark 函式:你無法直接匯入或使用 PySpark 函式。 AI 運行環境僅支援 Python,Spark 不提供本地運行環境。 不過,Spark Connect 也可用於資料載入。 請參見 AI 執行時的載入資料。
- Databricks 執行時機器學習函式庫:預裝套件無法取代 Databricks 執行時機器學習。 Databricks Runtime ML 中部分機器學習函式庫可能未預先安裝於 AI 執行環境。
- 私有產物:AI 執行時在某些情況下確實支援私有產物。 請聯絡您的帳戶團隊以獲取更多詳情。