Azure Service Fabric 引進健康情況模型,可提供豐富、彈性且可延伸的健康情況評估和報告。 此模型可讓您近乎即時地監視叢集的狀態,以及執行中的服務。 您可以輕鬆獲得健康資訊,並在潛在問題蔓延並導致大規模中斷之前加以修正。 在一般模型中,服務會根據其本機檢視傳送報表,並匯總該資訊以提供整體叢集層級檢視。
Service Fabric 元件會使用此豐富的健康情況模型來報告其目前狀態。 您可以使用相同的機制來報告應用程式的健康情況。 如果您投資可擷取自定義條件的高品質健康情況報告,您可以更輕鬆地偵測並修正執行中應用程式的問題。
查看此頁面以取得訓練影片,其說明 Service Fabric 健康情況模型和使用方式:
備註
我們已啟動健康子系統,以滿足對升級監控的需求。 Service Fabric 提供受監視的應用程式和叢集升級,可確保完整可用性、無停機時間,以及最少的使用者介入。 為了達成這些目標,升級會根據已設定的升級原則來檢查健康情況。 只有在健康情況遵守所需的臨界值時,才能繼續升級。 否則,升級會自動回復或暫停,讓系統管理員有機會修正問題。 若要深入瞭解應用程式升級,請參閱 這篇文章。
健康商店
健康資訊存儲庫會保留叢集中單位的健康情況相關資訊,以便輕鬆擷取和評估。 它會實作為 Service Fabric 保存的具狀態服務,以確保高可用性和延展性。 健全狀況存放區是 fabric:/System 應用程式的一部分,而且叢集啟動並執行時可以使用。
健康組織與層級
健康實體依據邏輯階層組織,以反映不同實體之間的互動和相依性。 健康存放區會根據從 Service Fabric 元件收到的報告自動建立健康實體和層次結構。
健康實體會反映 Service Fabric 實體。 (例如, 健康情況應用程式實體 會比對部署在叢集中的應用程式實例,而 健康情況節點實體 則符合 Service Fabric 叢集節點。健康情況階層會擷取系統實體的互動,而這是進階健康情況評估的基礎。 您可以在 Service Fabric 技術概觀中瞭解重要的 Service Fabric 概念。 如需應用程式的詳細資訊,請參閱 Service Fabric 應用程式模型。
健康實體和階層可讓叢集和應用程式有效地報告、除錯及監視。 健康模型提供精確、細緻 的呈現,反映叢集內部多個運行元件的健康狀態。
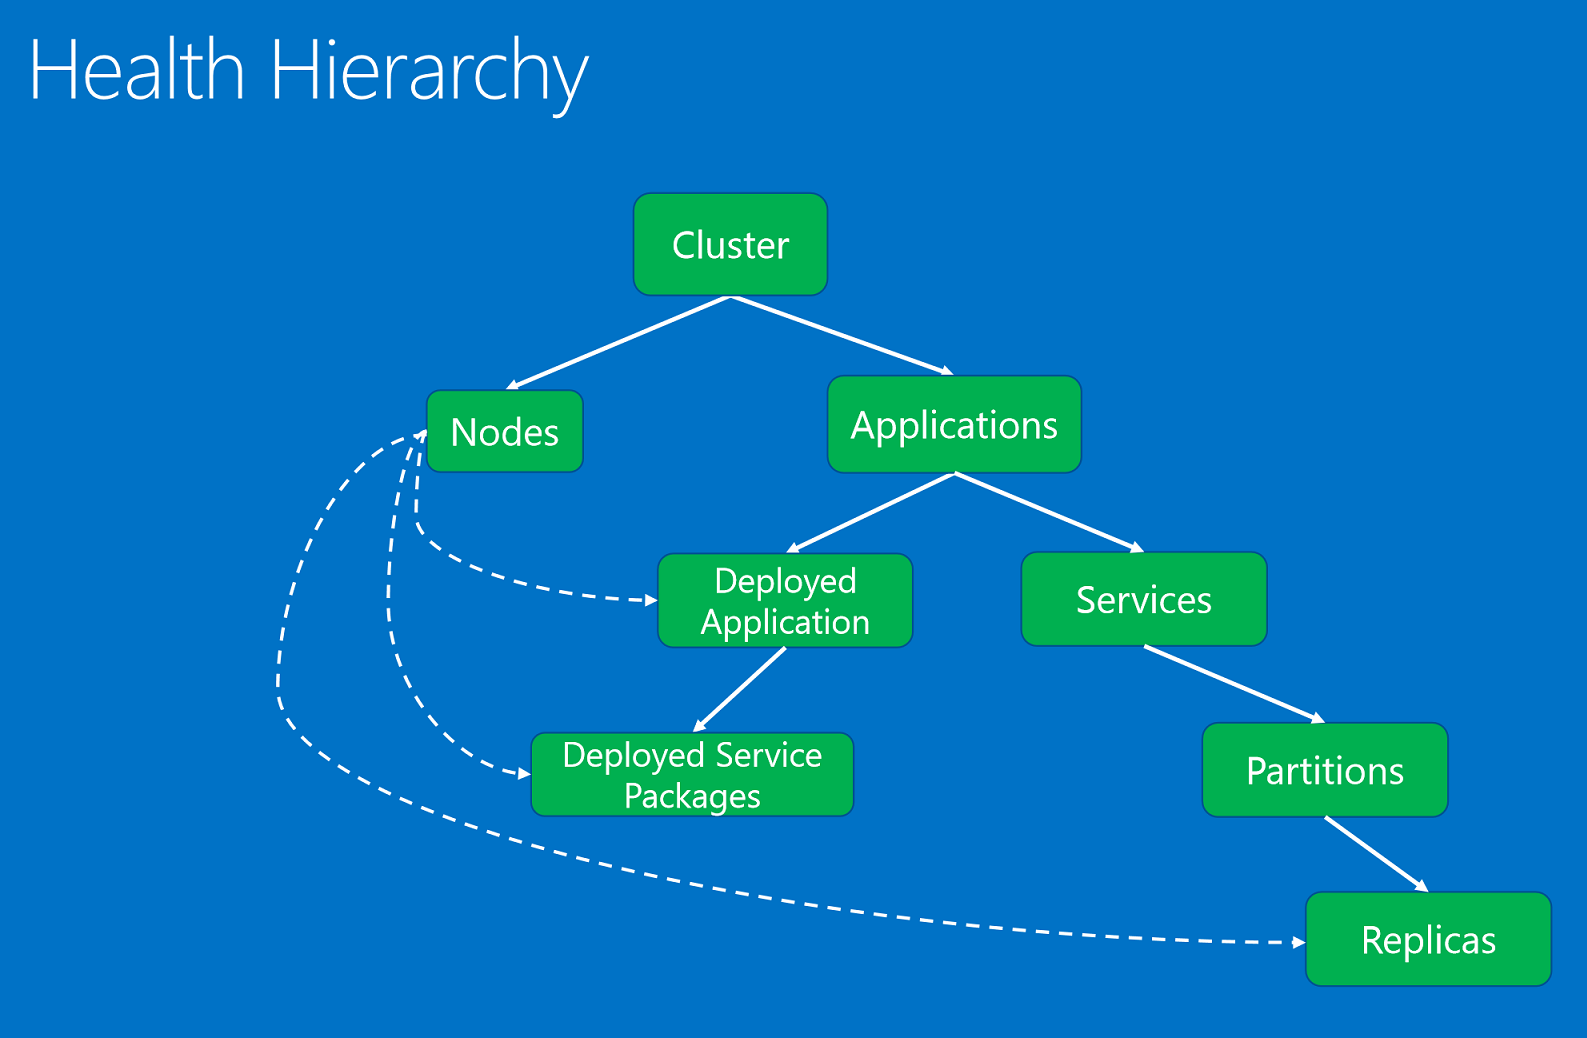 健康實體是根據父子關係組織在階層中的。
健康實體如下:
- 叢集。 表示 Service Fabric 叢集的健康情況。 叢集健康情況報告描述影響整個叢集的條件。 這些條件會影響叢集中或叢集本身中的多個實體。 根據情況,記者無法將問題縮小到一或多個不健康的兒童。 範例包括因為網路分割或通訊問題而導致叢集分割的大腦。
- 節點。 表示 Service Fabric 節點的健康情況。 節點健康情況報告描述影響節點功能的條件。 它們通常會影響其上執行的所有已部署實體。 範例包括磁碟空間不足的節點(或其他全機器屬性,例如記憶體、連線),以及節點關閉時。 節點實體是由節點名稱 (string) 來識別。
- 應用程式。 表示在叢集中執行之應用程式實例的健康情況。 應用程式健康情況報告描述影響應用程式整體健康情況的條件。 它們不能細分為個別子項目(服務或已部署的應用程式)。 範例包括應用程式中不同服務之間的端對端互動。 應用程式實體是由應用程式名稱 (URI) 來識別。
- 服務。 表示在叢集中執行之服務的健全狀況。 服務健康情況報告描述影響服務整體健全狀況的條件。 報告者無法將問題縮小到狀況不良的分區或副本。 範例包括可能對所有分割區造成問題的服務配置(如端口或外部檔案分享)。 服務實體是由服務名稱 (URI) 來識別。
- 分區。 表示服務分區的健康狀態。 分區健康報告描述影響整個副本集的條件。 範例包括當副本數目低於目標計數,以及分區發生仲裁遺失時。 分割區實體是由分割區標識碼 (GUID) 所識別。
- 複本。 顯示具狀態服務副本或無狀態服務實例的健康狀況。 複本是監視程式和系統元件可以針對應用程式回報的最小單位。 針對具狀態服務,範例包括無法將作業複寫到次要複本和複寫速度緩慢的主要複本。 此外,無狀態實例可以在資源用盡或連線問題時回報。 復本實體是由分割區標識碼 (GUID) 和複本或實例識別碼 (long) 來識別。
- DeployedApplication。 表示 節點上執行之應用程式的健康情況。 已部署的應用程式健康情況報告描述節點上應用程式的特定條件,這些條件無法縮小至部署在相同節點上的服務套件。 範例包括當無法在該節點上下載應用程式套件時發生錯誤,以及在節點上設定應用程式安全性主體時發生問題。 已部署的應用程式是由應用程式名稱 (URI) 和節點名稱 (string) 來識別。
- DeployedServicePackage。 表示在叢集中節點上執行之服務套件的健康情況。 它描述服務套件特有的條件,這些條件不會影響相同應用程式相同節點上的其他服務套件。 範例包括無法啟動的服務套件中的程式碼套件,以及無法讀取的設定套件。 部署的服務套件是由應用程式名稱(URI)、節點名稱(字串串)、服務指令清單名稱(字串)和服務套件啟用標識元 (string) 來識別。
健全狀況模型的粒度可讓您輕鬆地偵測和更正問題。 例如,如果服務沒有回應,則報告應用程式實例狀況不良是可行的。 不過,在該層級的報告並不理想,因為問題可能不會影響該應用程式內的所有服務。 報告應該套用至狀況不良的服務或特定的子分割區,如果有更多資訊指向該子分割區。 資料會自動在階層中浮現, 並且在服務和應用程式層級顯現出不健康的分區。 此匯總有助於更快速地找出並解決問題的根本原因。
健康體系階層是由上級與下級關係所組成。 叢集是由節點和應用程式所組成。 應用程式具有服務和已部署的應用程式。 已部署的應用程式已部署服務套件。 服務具有分割區,而且每個分割區都有一或多個複本。 節點與已部署實體之間有特殊關聯性。 由其權威系統元件故障轉移管理員服務所報告的不正常節點會影響部署在其上的應用程式、服務套件及複本。
健康情況階層會根據最新的健康情況報告來表示系統的最新狀態,這幾乎是實時資訊。 內部和外部監視程式可以根據應用程式特定邏輯或自定義受監視條件來報告相同的實體。 使用者報表與系統報告並存。
計畫在設計大型雲端服務階段投入資源來報告和應對健康問題。 這項預先投資可讓服務更容易偵錯、監視及運作。
健康狀態
Service Fabric 使用三種健康狀態來描述實體是否狀況良好:確定、警告和錯誤。 傳送至健康商店的任何報告都必須指定下列其中一項。 健康情況評估結果為下列其中一種狀態。
可能的 健全狀態 如下:
- 確定。 該實體狀況良好。 沒有關於它或其子系的已知問題(適用時)。
- 警告。 實體有一些問題,但仍可正常運作。 例如,有延遲,但它們尚未造成任何功能問題。 在某些情況下,警告條件可能會自行修正,而不需外部介入。 在這些情況下,健康情況報告會提高意識,並提供對所發生狀況的可見度。 在其他情況下,警告條件可能會降級為嚴重問題,而不需要使用者介入。
- Error。 實體狀況不良。 應該採取動作來修正實體的狀態,因為它無法正常運作。
- 未知。 該實體不存在於健康商店中。 您可以從合併多個元件結果的分散式查詢取得此結果。 例如,取得節點清單查詢會移至 FailoverManager、ClusterManager 和 HealthManager; 取得應用程式清單查詢會移至 ClusterManager 和 HealthManager。 這些查詢會合併多個系統元件的結果。 如果另一個系統元件傳回健康存放區中不存在的實體,合併的結果將具有未知的健康狀態。 該實體不在可用狀態,因為健康報告尚未被處理,或在刪除後該實體已被清理。
健康政策
健康商店會套用健康政策,以根據實體的報告和其子系來判斷實體是否健康。
備註
健康情況原則可以在叢集指令清單中指定(適用於叢集和節點健康情況評估),或在應用程式指令清單中指定(用於應用程式評估及其任何子系)。 健康評估請求也可以傳入自定義的健康評估政策,這些政策僅用於該評估。
根據預設,Service Fabric 會針對父子階層關係套用嚴格的規則(所有組件都必須狀況良好)。 如果其中一個子女有一個不健康的情況,父母就會被視為不健康。
叢集健康政策
叢集健康情況原則可用來評估叢集健全狀況狀態和節點健康情況狀態。 原則可以在叢集指令清單中定義。 如果不存在,則會使用默認原則(零容許失敗)。
叢集健康政策包含:
視警告為錯誤。 指定是否要在健康情況評估期間將警告健康情況報告視為錯誤。 預設:false。
MaxPercentUnhealthyApplications。 指定在叢集被視為錯誤之前,不健康的應用程式所佔的最大容許百分比。
MaxPercentUnhealthyNodes。 指定在叢集被視為錯誤之前,節點發生狀況不良的最大容許百分比。 在大型叢集中,某些節點常常會停機或正在維修,因此應該配置容許該百分比。
ApplicationTypeHealthPolicyMap。 應用程式類型健全狀況原則對應可在叢集健康情況評估期間使用,以描述特殊應用程序類型。 根據預設,所有應用程式都會放入集區,並使用 MaxPercentUnhealthyApplications 進行評估。 如果某些應用程式類型應該以不同的方式處理,則可以從全域集區取出它們。 相反地,它們會根據地圖中與其應用程式類型名稱相關聯的百分比來進行評估。 例如,在叢集中,有數千個不同類型的應用程式,以及一些特殊應用程序類型的控制應用程式實例。 控制程式應用程式不應該發生錯誤。 您可以將全域 MaxPercentUnhealthyApplications 指定為 20% 以容許某些失敗,但針對應用程式類型 “ControlApplicationType” 將 MaxPercentUnhealthyApplications 設定為 0。 如此一來,如果其中一些應用程式狀況不良,但低於全域狀況不良百分比,叢集會評估為警告。 警告健康狀態不會影響叢集升級或由錯誤的健康狀態所觸發的其他監控。 但是,即使發生錯誤的一個控制應用程式也會使叢集狀況不良,這會根據升級組態觸發復原或暫停叢集升級。 針對映射中定義的應用程式類型,所有應用程式實例都會從應用程式的全域資源池取出。 它們會根據應用程式類型的應用程式總數進行評估,並使用地圖中的特定 MaxPercentUnhealthyApplications。 其餘所有應用程式都會保留在全域集區中,並使用 MaxPercentUnhealthyApplications 進行評估。
下列範例是叢集指令清單的摘錄。 若要定義應用程式類型映射中的項目,請在參數名稱前加上“ApplicationTypeMaxPercentUnhealthyApplications-”,然後再接上應用程式類型名稱。
<FabricSettings> <Section Name="HealthManager/ClusterHealthPolicy"> <Parameter Name="ConsiderWarningAsError" Value="False" /> <Parameter Name="MaxPercentUnhealthyApplications" Value="20" /> <Parameter Name="MaxPercentUnhealthyNodes" Value="20" /> <Parameter Name="ApplicationTypeMaxPercentUnhealthyApplications-ControlApplicationType" Value="0" /> </Section> </FabricSettings>NodeTypeHealthPolicyMap。 節點類型健康策略映射可在叢集健康評估期間使用,以描述特殊節點類型。 節點類型會根據映射中與其節點類型名稱相關聯的百分比進行評估。 設定這個值不會影響用於MaxPercentUnhealthyNodes的全域節點池。 例如,叢集有數百個不同類型的節點,以及裝載重要工作的幾個節點類型。 該類型的節點不應該關閉。 您可以指定全域MaxPercentUnhealthyNodes至 20% 來容許所有節點的某些失敗,但針對節點類型SpecialNodeType,將 設定MaxPercentUnhealthyNodes為 0。 如此一來,如果其中一些節點狀況不良,但低於全域狀況不良百分比,則叢集會評估為處於警告健康狀態。 警告健康狀態不會影響叢集升級或其他由錯誤健康狀態觸發的監視。 即使只有一個SpecialNodeType類型的節點處於錯誤健康狀態,也會使叢集變得不健康,並可能根據升級配置觸發回退或暫停叢集升級。 相反地,將全域MaxPercentUnhealthyNodes設定為 0,並將最大百分比狀況不良的節點設定SpecialNodeType為 100,且類型為錯誤狀態的一個節點SpecialNodeType仍會將叢集置於錯誤狀態,因為在此情況下全域限制更為嚴格。下列範例是叢集指令清單的摘錄。 若要定義節點類型映射中的條目,請在參數名稱前加上「NodeTypeMaxPercentUnhealthyNodes-」,再接上節點類型名稱。
<FabricSettings>
  <Section Name="HealthManager/ClusterHealthPolicy">
    <Parameter Name="ConsiderWarningAsError" Value="False" />
    <Parameter Name="MaxPercentUnhealthyApplications" Value="20" />
    <Parameter Name="MaxPercentUnhealthyNodes" Value="20" />
    <Parameter Name="NodeTypeMaxPercentUnhealthyNodes-SpecialNodeType" Value="0" />
  </Section>
</FabricSettings>
應用程式健康狀態原則
應用程式健康狀態原則描述如何針對應用程式及其子系完成事件和子狀態匯總的評估。 它可以定義在應用程式封裝的應用程式指令清單 中,ApplicationManifest.xml。 如果未指定任何原則,Service Fabric 會假設實體的健康狀態不良,當它有健康報告或其子項處於警告或錯誤健康狀態時。 可設定的原則如下:
- 將警告視為錯誤。 指定是否要在健康情況評估期間將警告健康情況報告視為錯誤。 預設:false。
- MaxPercentUnhealthyDeployedApplications。 指定在應用程式視為錯誤之前,可狀況不良之已部署應用程式的最大容許百分比。 此百分比的計算方式是將狀況不良的已部署應用程式數目除以叢集中目前部署的應用程式數目。 計算會四捨五入,以容忍少數節點上可能發生的一次失敗。 默認百分比:零。
- DefaultServiceTypeHealthPolicy。 指定預設服務類型健全狀況原則,以取代應用程式中所有服務類型的預設健全狀況原則。
- ServiceTypeHealthPolicyMap。 提供每個服務類型的服務健康政策地圖。 這些原則會取代每個指定服務類型的預設服務類型健全狀況原則。 例如,如果應用程式具有無狀態網關服務類型和具狀態引擎服務類型,您可以以不同的方式設定其評估的健康情況原則。 當您為每個服務類型指定原則時,您可以更細微地控制服務的健康情況。
服務類型健康政策
服務類型健康政策規定如何評估和匯總服務及其子項目。 原則包含:
- MaxPercentUnhealthyPartitionsPerService。 指定服務在被視為不健康之前,允許不健康分區的最大百分比。 默認百分比:零。
- MaxPercentUnhealthyReplicasPerPartition(每分區不健康副本的最大百分比)。 指定一個分割區被視為狀況不良之前,允許的狀況不良副本的最大百分比。 默認百分比:零。
- MaxPercentUnhealthyServices。 最大可容忍的不良服務百分比,在應用程式被視為不良之前。 默認百分比:零。
下列範例是應用程式指令清單的摘錄:
    <Policies>
        <HealthPolicy ConsiderWarningAsError="true" MaxPercentUnhealthyDeployedApplications="20">
            <DefaultServiceTypeHealthPolicy
                   MaxPercentUnhealthyServices="0"
                   MaxPercentUnhealthyPartitionsPerService="10"
                   MaxPercentUnhealthyReplicasPerPartition="0"/>
            <ServiceTypeHealthPolicy ServiceTypeName="FrontEndServiceType"
                   MaxPercentUnhealthyServices="0"
                   MaxPercentUnhealthyPartitionsPerService="20"
                   MaxPercentUnhealthyReplicasPerPartition="0"/>
            <ServiceTypeHealthPolicy ServiceTypeName="BackEndServiceType"
                   MaxPercentUnhealthyServices="20"
                   MaxPercentUnhealthyPartitionsPerService="0"
                   MaxPercentUnhealthyReplicasPerPartition="0">
            </ServiceTypeHealthPolicy>
        </HealthPolicy>
    </Policies>
健康情況評估
使用者和自動化服務可以隨時評估任何實體的健康情況。 為了評估實體的健康狀況,健康中心會匯總實體上的所有健康報告,並評估其所有子系(如果適用)。 健康情況匯總演算法會使用健康情況原則來指定如何評估健康情況報告,以及如何匯總子健康情況狀態(適用時)。
健康情況報告匯總
不同的報告者(系統元件或監看員)可以在不同屬性上為一個實體傳送多個健康報告。 聚合使用相關聯的健康政策,特別是應用程式或叢集健康政策中的 ConsiderWarningAsError 項目。 ConsiderWarningAsError 會指定如何評估警告。
實體的彙總健康狀態是由最差的健康報告觸發的。 如果至少有一個錯誤健康情況報告,匯總的健康情況狀態就是錯誤。
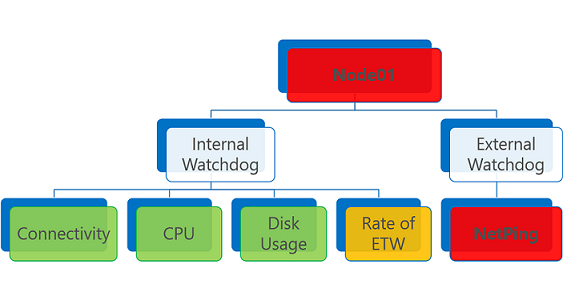
有一份或多份錯誤報告的健康實體將被評估為錯誤狀態。 不論其健康情況狀態為何,過期的健康情況報告也是如此。
如果沒有錯誤報告且有一個或多個警告,匯總的健康狀態會根據 ConsiderWarningAsError 原則標誌,是警告或錯誤。
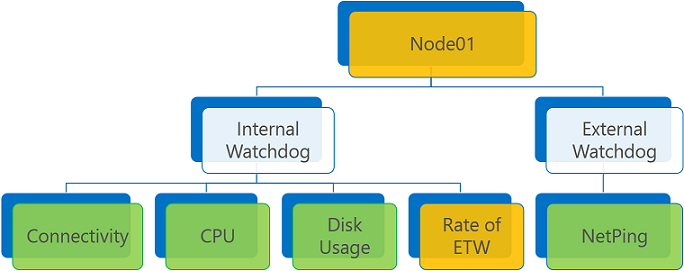
健康情況報告匯總,警告報告和 ConsiderWarningAsError 設定為 false (預設值)。
兒童健康匯總
實體的總體健康狀態會反映其子健康狀態(適用時)。 匯總子健康狀態的演算法使用依據實體類型決定的健康政策。
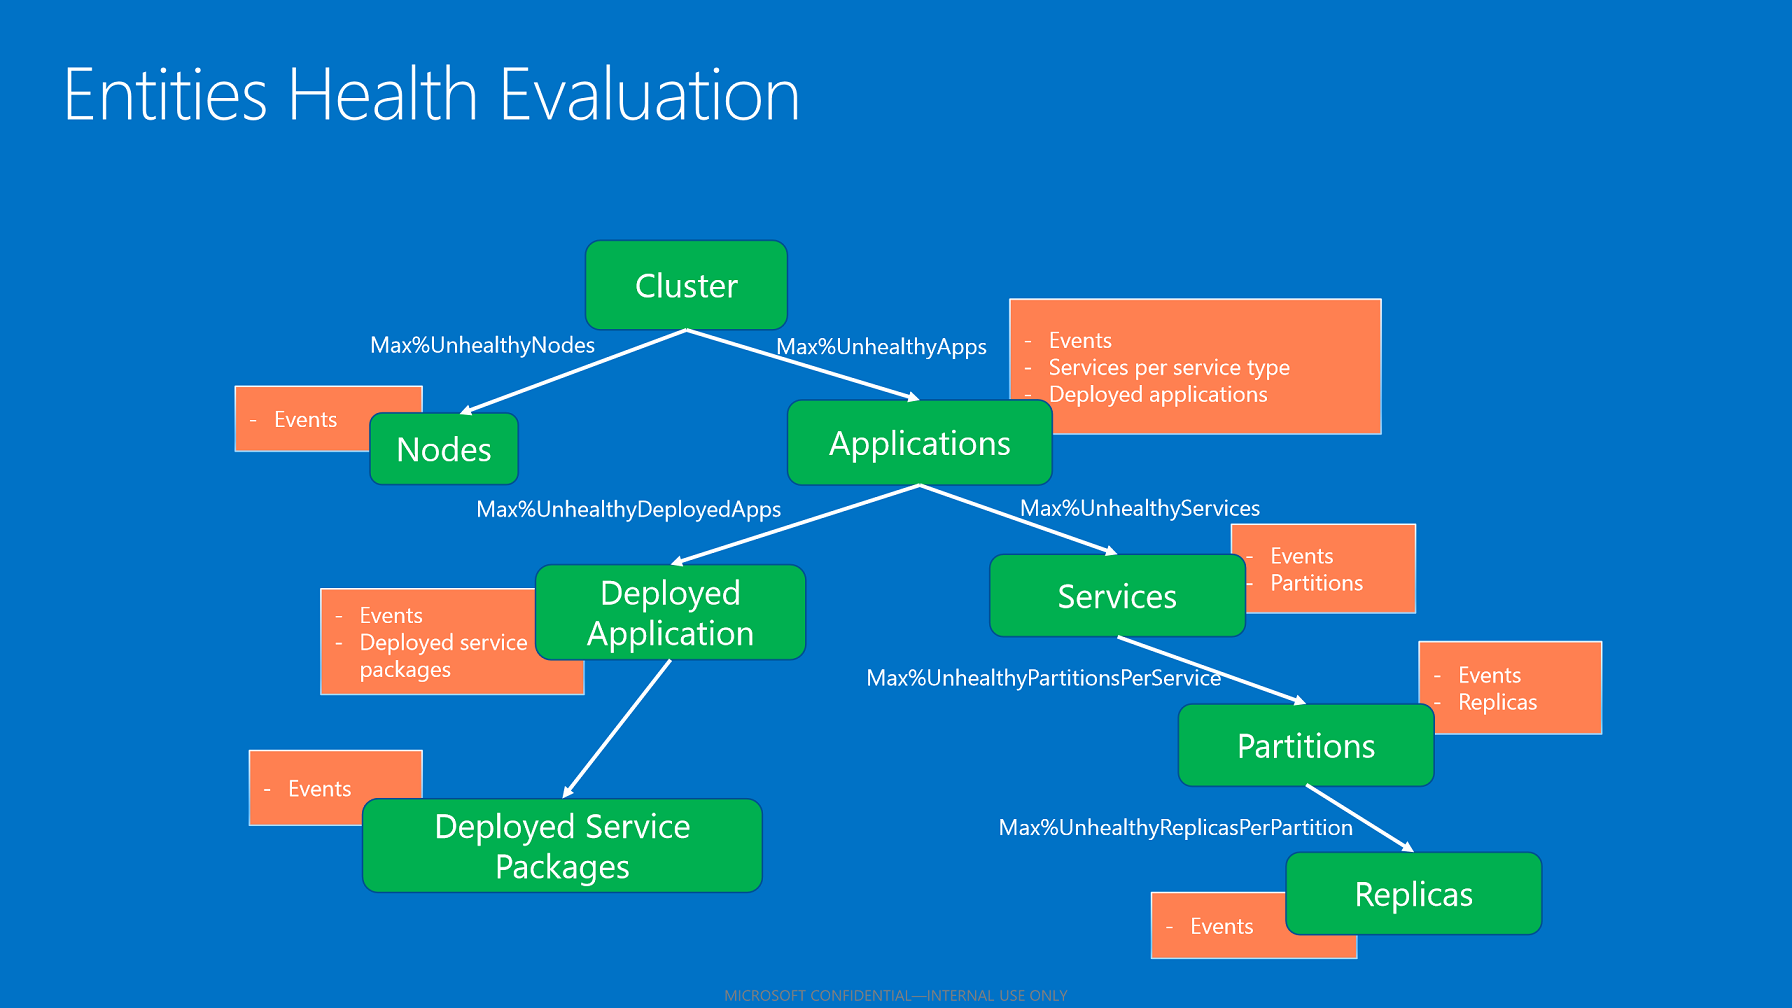
根據健康政策的兒童集合。
在健康商店評估所有孩子之後,根據所設定不健康孩子的最大百分比來統計他們的健康狀況。 此百分比取自以實體和子類型為基礎的原則。
- 如果所有子系都有OK狀態,則子系匯總健全狀況狀態為OK。
- 如果子系同時有 OK 和警告狀態,則子系匯總健全狀況狀態為警告。
- 如果有子項目處於錯誤狀態且不符合不健康子項目的最大允許比例,則匯總的父項目健康狀態為錯誤。
- 如果錯誤狀態的子系遵守狀況不良子系的最大允許百分比,匯總的父健康情況狀態會發出警告。
健康情況報告
系統元件、系統網狀架構應用程式和內部/外部看門狗可以對 Service Fabric 實體進行報告。 記者根據所監視實體的狀況,對受監視實體的健康情況作出 當地 判斷。 它們不需要查看任何全域狀態或匯總數據。 想要的行為是擁有簡單的報告者,而非需要觀察許多事物來推斷該發送哪些資訊的複雜系統。
若要將健康情況數據傳送至健康狀態存放區,記者必須識別受影響的實體,並建立健康情況報告。 若要傳送報告,請使用 FabricClient.HealthClient.ReportHealth API、在 Partition 或 CodePackageActivationContext 物件上公開的健康狀態 API、PowerShell Cmdlet 或 REST。
健康情況報告
叢集中每個實體的健康情況 報告 包含下列資訊:
SourceId。 用來唯一識別健康事件報告者的字串。
實體標識碼。 識別報表所適用的實體。 其會根據 實體類型而有所不同:
- 簇。 沒有。
- 節點。 節點名稱(字串)。
- 應用程式。 應用程式名稱(URI)。 表示部署在叢集中的應用程式實例名稱。
- 服務。 服務名稱(URI)。 表示部署在叢集中的服務實例名稱。
- 分區。 分割識別碼 (GUID)。 表示分割區唯一標識符。
- 複製品。 具狀態服務複本標識碼或無狀態服務實例標識碼 (INT64)。
- DeployedApplication。 應用程式名稱(URI)和節點名稱(字串)。
- DeployedServicePackage。 應用程式名稱(URI)、節點名稱(字串),以及服務指令清單名稱(string)。
屬性。 字串(不是固定列舉),可讓報告生成器針對實體特定屬性的健康事件進行分類。 例如,記者 A 可以報告 Node01 「記憶體」屬性的健康情況,而記者 B 可以報告 Node01 「連線能力」屬性的健康情況。 在健康商店中,這些報告會被視為 Node01 實體的獨立健康事件。
描述。 字串,可讓記者提供有關健康情況事件的詳細資訊。 SourceId、 Property 和 HealthState 應該完整描述報告。 描述增加了易於理解的報表資訊。 文字可讓系統管理員和使用者更輕鬆地瞭解健康情況報告。
HealthState。 列舉 ,描述 報表的健康情況狀態。 接受的值為OK、Warning和Error。
TimeToLive。 健康報告的有效時間範圍。 加上 RemoveWhenExpired,它可讓健康狀態存放區知道如何評估過期的事件。 根據預設,此值是無限的,而且報表永遠有效。
RemoveWhenExpired。 布爾值。 如果設定為 true,就會從健康狀態存放區自動移除過期的健康報告,而且報告不會影響實體健康評估。 當報告僅在指定的一段時間內有效時使用,並且報告者不需要明確地將其清除。它也可用來從健康報告存儲庫中刪除報告(例如,監視程式已更改並停止傳送具有先前來源和屬性的報告)。 它可以使用簡短的 TimeToLive 以及 RemoveWhenExpired 傳送報表,以清除健康狀態存放區中的任何先前狀態。 如果值設定為 false,則會將過期的報告視為健康情況評估的錯誤。 false 值會向健康資料庫發出訊號,告知來源應該定期回報此屬性。 如果不是,那麼監督機構必須發生問題。 監視程式的健康情況會藉由將事件視為錯誤來擷取。
SequenceNumber。 需要不斷增加的正整數,它代表報表的順序。 健康資料存放區會使用它來偵測因網路延遲或其他問題而延遲的過時報告。 如果序號小於或等於相同實體、來源和屬性上次套用的數字,報表就會被拒絕。 如果未指定,則會自動產生序號。 只有在報告狀態轉換時,才需要放入序號。 在此情況下,資料來源必須記住所傳送的報告,並保留在故障轉移時復原所需的資訊。
每個健康情況報告都需要這四個資訊片段--SourceId、實體標識碼、屬性和HealthState-- 。 不允許SourceId字串開頭為 「System.」,其保留給系統報表。 對於相同的實體,針對相同的來源和屬性只有一份報告。 相同來源和屬性的多個報告會彼此覆蓋,無論是在健康用戶端(如果已批處理),或是在健康數據儲存區。 取代是以序號為基礎;較新的報表(具有較高的序號)取代較舊的報表。
健康活動
內部,健康商店會保存 健康事件,其中包含報告中的所有資訊,以及其他元數據。 元數據包含報告提供給健康服務客戶的時間,以及報告在伺服器端被修改的時間。 健康事件是由 健康查詢返回。
新增的元資料包含:
- SourceUtcTimestamp。 報告提供給健康客戶端的時間(國際標準時間)。
- LastModifiedUtcTimestamp。 報表上次在伺服器端修改的時間(國際標準時間)。
- IsExpired。 指示旗標,用於確認報表在健康資料庫執行查詢時是否已過期。 只有在 RemoveWhenExpired 為 false 時,事件才會過期。 否則,查詢不會傳回 事件,而且會從存放區中移除。
- LastOkTransitionAt、 LastWarningTransitionAt、 LastErrorTransitionAt。 OK/警告/錯誤轉換的最後時間。 這些欄位會提供事件健康狀態轉換的歷程記錄。
狀態轉換欄位可用於更智能的警示或「過去的」健康事件資訊。 它們可啟用下列情境:
- 當屬性處於警告或錯誤狀態超過 X 分鐘時,發出警報。 定期檢查狀況可以避免因暫時性狀況引起的警報。 例如,如果健康狀態持續警告超過五分鐘,則警示可以轉譯為(HealthState == Warning and Now - LastWarningTransitionTime > 5 分鐘)。
- 僅針對過去 X 分鐘內已變更的條件發出警示。 如果報表已在指定時間之前發生錯誤,則可以忽略它,因為先前已發出訊號。
- 如果屬性在警告和錯誤之間切換,請確定它處於不健康狀態的時間長度(也就是不正常)。 例如,如果屬性未狀況良好超過 5 分鐘,則警示可以轉譯為 (HealthState != Ok 和 Now - LastOkTransitionTime > 5 分鐘)。
範例:報告和評估應用程式健康情況
下列範例會從來源 MyWatchdog,透過應用程式 fabric:/WordCount 上的 PowerShell 傳送健康情況報告。 健康情況報告包含錯誤健康狀態中健康情況屬性「可用性」的相關信息,並具有無限的 TimeToLive。 然後,它會查詢應用程式健康情況,這會傳回匯總的健康狀態錯誤狀況,以及在健康事件清單中報告的健康情況事件。
PS C:\> Send-ServiceFabricApplicationHealthReport –ApplicationName fabric:/WordCount –SourceId "MyWatchdog" –HealthProperty "Availability" –HealthState Error

PS C:\> Get-ServiceFabricApplicationHealth fabric:/WordCount -ExcludeHealthStatistics


ApplicationName                 : fabric:/WordCount
AggregatedHealthState           : Error
UnhealthyEvaluations            :
                                  Error event: SourceId='MyWatchdog', Property='Availability'.

ServiceHealthStates             :
                                  ServiceName           : fabric:/WordCount/WordCountService
                                  AggregatedHealthState : Error

                                  ServiceName           : fabric:/WordCount/WordCountWebService
                                  AggregatedHealthState : Ok

DeployedApplicationHealthStates :
                                  ApplicationName       : fabric:/WordCount
                                  NodeName              : _Node_0
                                  AggregatedHealthState : Ok

                                  ApplicationName       : fabric:/WordCount
                                  NodeName              : _Node_2
                                  AggregatedHealthState : Ok

                                  ApplicationName       : fabric:/WordCount
                                  NodeName              : _Node_3
                                  AggregatedHealthState : Ok

                                  ApplicationName       : fabric:/WordCount
                                  NodeName              : _Node_4
                                  AggregatedHealthState : Ok

                                  ApplicationName       : fabric:/WordCount
                                  NodeName              : _Node_1
                                  AggregatedHealthState : Ok

HealthEvents                    :
                                  SourceId              : System.CM
                                  Property              : State
                                  HealthState           : Ok
                                  SequenceNumber        : 360
                                  SentAt                : 3/22/2016 7:56:53 PM
                                  ReceivedAt            : 3/22/2016 7:56:53 PM
                                  TTL                   : Infinite
                                  Description           : Application has been created.
                                  RemoveWhenExpired     : False
                                  IsExpired             : False
                                  Transitions           : Error->Ok = 3/22/2016 7:56:53 PM, LastWarning = 1/1/0001 12:00:00 AM

                                  SourceId              : MyWatchdog
                                  Property              : Availability
                                  HealthState           : Error
                                  SequenceNumber        : 131032204762818013
                                  SentAt                : 3/23/2016 3:27:56 PM
                                  ReceivedAt            : 3/23/2016 3:27:56 PM
                                  TTL                   : Infinite
                                  Description           :
                                  RemoveWhenExpired     : False
                                  IsExpired             : False
                                  Transitions           : Ok->Error = 3/23/2016 3:27:56 PM, LastWarning = 1/1/0001 12:00:00 AM
健康模型使用
健全狀況模型可讓雲端服務和基礎 Service Fabric 平臺進行調整,因為監視和健康情況判斷會分散在叢集內的不同監視器之間。 其他系統在叢集層級具有單一集中式服務,可剖析服務發出的所有 潛在 實用資訊。 此方法會阻礙其延展性。 它也不允許他們收集特定資訊,以協助識別問題和潛在問題,讓它們盡可能接近根本原因。
健康情況模型會大量用於監視和診斷、評估叢集和應用程式健康情況,以及用於監視的升級。 其他服務會使用健康情況數據來執行自動修復、建置叢集健康情況歷程記錄,以及在特定條件下發出警示。