Nota
L'accés a aquesta pàgina requereix autorització. Podeu provar d'iniciar la sessió o de canviar els directoris.
L'accés a aquesta pàgina requereix autorització. Podeu provar de canviar els directoris.
Cree y mantenga tablas de búsqueda independientes para los datos que las aplicaciones usan con frecuencia en las consultas cuando un almacén de datos no proporciona índices secundarios adecuados. Este enfoque mejora el rendimiento de lectura evitando exámenes de datos completos cuando las consultas no usan la clave principal o la clave de partición.
Contexto y problema
Muchos almacenes de datos organizan los datos de una colección de entidades mediante la clave principal. Una aplicación puede usar esta clave para buscar y recuperar datos. En la ilustración siguiente se muestra un ejemplo de un almacén de datos que contiene información del cliente organizada por la clave principal, id. de cliente.
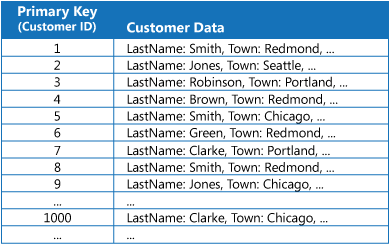
La imagen muestra una tabla de dos columnas de registros de clientes. La primera columna, clave primaria (ID de cliente), contiene los ID de cliente del 1 al 9, seguidos de unos puntos suspensivos, el ID 1000 y otros puntos suspensivos. La segunda columna, Datos del cliente, contiene datos de cliente que constan de un apellido y una ciudad seguida de puntos suspensivos. Entre los ejemplos visibles se incluyen el identificador 1, que se asigna al apellido Smith y a la ciudad Redmond, y el identificador 2, que se asigna al apellido Jones y a la ciudad de Seattle. Otra fila muestra a Smith en Chicago, y otro muestra a Smith en Redmond. Otra fila muestra Jones en Chicago.
Aunque la clave principal es valiosa para las consultas que capturan datos en función del valor de esta clave, una aplicación que necesita recuperar datos basados en algún otro campo no puede usar la clave principal para esa consulta. En el ejemplo de los clientes, una aplicación no puede usar la clave principal de identificador del cliente para recuperar clientes si consulta los datos haciendo referencia únicamente al valor de algún otro atributo, como la ciudad en la que está ubicado el cliente. Para realizar una consulta que haga referencia solo a la ciudad, es posible que la aplicación tenga que capturar y examinar cada registro de cliente, lo que puede ser un proceso lento.
Muchos sistemas de administración de bases de datos relacionales admiten índices secundarios. Un índice secundario es una estructura de datos independiente organizada por uno o varios campos de clave no principales (secundarios). Un índice secundario indica dónde se almacenan los datos de cada valor indexado. Normalmente, los elementos de un índice secundario se ordenan por el valor de las claves secundarias lo cual permite unas búsquedas rápidas de datos. El sistema de administración de bases de datos normalmente mantiene estos índices automáticamente.
Las bases de datos relacionales permiten que varios índices secundarios admitan varios patrones de consulta. Por ejemplo, en una tabla Customers de una base de datos relacional en la que el identificador de cliente es la clave principal, resulta beneficioso agregar un índice secundario sobre el campo Town si la aplicación busca con frecuencia clientes por la ciudad donde residen.
Aunque los índices secundarios son comunes en los sistemas relacionales, no todos los almacenes de datos proporcionan una característica equivalente. Algunos almacenes de datos carecen de índices secundarios, mientras que otros proporcionan índices que no satisfacen los requisitos de consulta, creación de particiones o rendimiento de una carga de trabajo. En estos casos, las aplicaciones deben elegir entre escaneos completos y la gestión manual de índices.
Solución
Cree una tabla de índice que organice los datos mediante una clave especificada. En la sección siguiente se describen tres estrategias comunes para estructurar una tabla de índice. En las dos secciones posteriores se describen los usos de las tablas de índice en escenarios específicos.
Estrategias de estructuración estándar
Las estrategias siguientes se usan normalmente para estructurar una tabla de índice. Elija una estrategia basada en el número de índices secundarios que requiere el escenario y la naturaleza de las consultas que realiza la aplicación.
Desnormalización completa
La desnormalización completa duplica los datos de cada tabla de índice, pero los organiza mediante claves distintas de la clave principal. En la ilustración siguiente se muestran tablas de índice que organizan la misma información de cliente por Town y LastName.
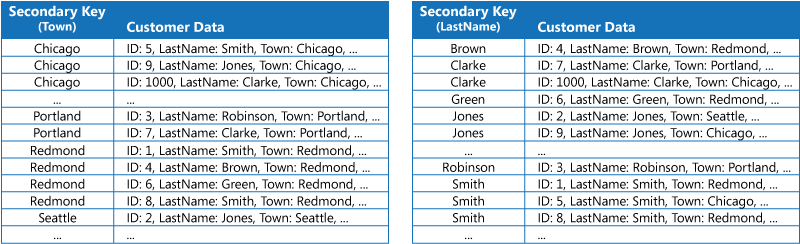
Esta estrategia funciona bien para cargas de trabajo de lectura intensivas en las que los datos cambian con poca frecuencia. A medida que aumenta la velocidad de actualización, el mantenimiento de cada copia agrega sobrecarga de procesamiento (consulte Complejidad de la coherencia). En el caso de los conjuntos de datos de gran volumen, el almacenamiento de las copias también puede requerir un espacio significativo.
Índice normalizado
Una tabla de índice normalizada organiza los datos por claves distintas de la clave principal. La tabla de índice normalizado hace referencia a los datos originales mediante la clave principal en lugar de duplicar esos datos, como se muestra en la ilustración siguiente. Los datos originales se denominan tabla de hechos.
Tip
Aquí, la tabla de hechos significa la tabla de origen autoritativa a la que hace referencia un índice. No implica un modelo de datos dimensional.
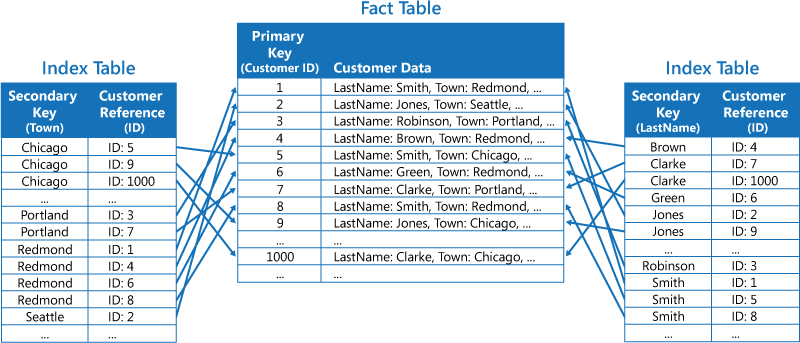
Esta técnica ahorra espacio y reduce la sobrecarga que supone mantener los datos duplicados. La desventaja es que una aplicación tiene que realizar dos operaciones de búsqueda para buscar datos mediante una clave secundaria. La aplicación tiene que buscar la clave principal de los datos de la tabla de índice y, a continuación, usar la clave principal para buscar los datos en la tabla de hechos.
Desnormalización parcial
La desnormalización parcial crea tablas de índice que duplican campos recuperados con frecuencia y se organizan mediante claves distintas de la clave principal. Se hace referencia a la tabla de hechos para acceder a los campos a los que se accede con menos frecuencia. En la ilustración siguiente se muestra cómo se duplican los datos a los que se accede con frecuencia en cada tabla de índice.
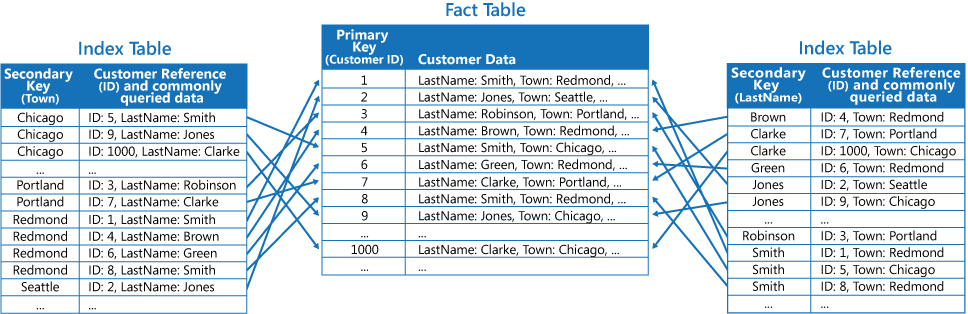
Esta estrategia equilibra los dos primeros enfoques. Puede recuperar rápidamente los datos de las consultas comunes mediante una sola búsqueda, mientras que la sobrecarga de espacio y mantenimiento no es tan significativa como duplicar todo el conjunto de datos.
Claves compuestas
Algunas aplicaciones consultan datos con frecuencia especificando una combinación de valores, por ejemplo, "Buscar todos los clientes que residen en Redmond y que tienen un apellido de Smith". En esta situación, cree claves de índice a partir de varios atributos, como los atributos Town y LastName en este caso.
Use una codificación que conserve los límites de los componentes para que diferentes combinaciones de valores no puedan generar la misma clave. Si las consultas dependen del orden de las claves, asegúrese también de que la codificación conserva el criterio de ordenación necesario en las reglas de intercalación de claves del almacén de datos.
En la ilustración siguiente se muestra una tabla de índice basada en claves compuestas. Las claves se ordenan por Town y, a continuación, por LastName para los registros que tienen el mismo valor para Town.
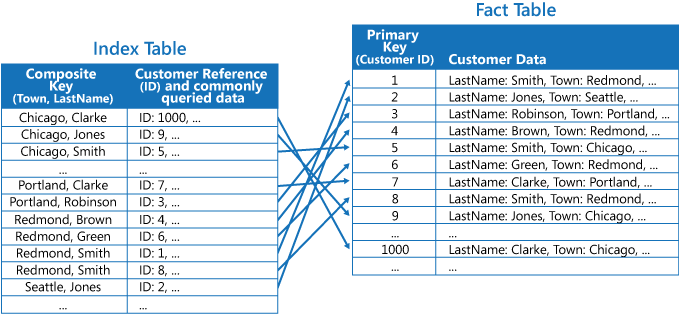
El diagrama contiene una tabla de índice a la izquierda y una tabla de hechos a la derecha. La tabla de hechos organiza los datos del cliente mediante la clave principal, id. de cliente. Cada fila Datos de cliente contiene un apellido de cliente, una ciudad y puntos suspensivos que indican otros datos. La tabla de índice se organiza mediante una clave compuesta que combina Town y LastName. Su segunda columna, Referencia del cliente (ID) y datos consultados habitualmente, contiene un identificador del cliente y una elipsis. Las flechas van desde las filas de la tabla de índice hasta la tabla de hechos, y cada flecha apunta a la fila de ID de cliente a la que hace referencia la entrada de índice correspondiente. Las flechas cruzadas ilustran que las entradas ordenadas por la clave compuesta pueden hacer referencia a filas de cliente en diferentes posiciones de la tabla de hechos.
Tablas de índices sobre datos fragmentados
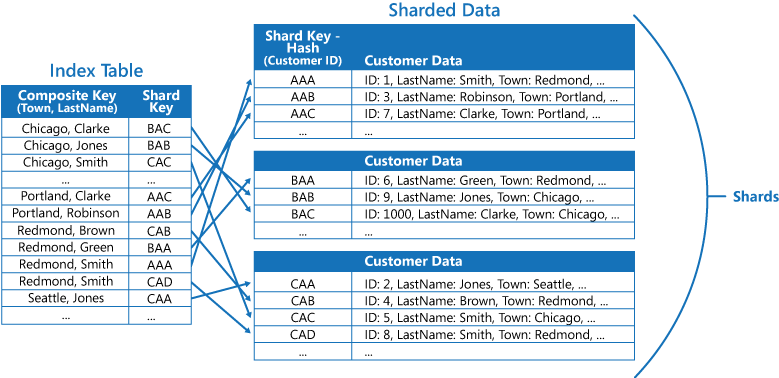
Las tablas de índice pueden acelerar las operaciones de consulta a través de datos particionados. Son especialmente útiles cuando se aplica un hash a la clave de partición. En la ilustración siguiente se muestra un ejemplo en el que la clave de partición es un hash del identificador de cliente. La tabla de índice organiza las entradas por valores no hash, Town y LastName, y almacena la clave de partición hash correspondiente con cada entrada.
Esta disposición admite búsquedas ordenadas y por intervalo en los valores no sometidos a hash, a la vez que proporciona la información de enrutamiento necesaria para recuperar cada registro de la partición correcta. Por ejemplo, una consulta como "Buscar todos los clientes que residen en Redmond" puede localizar los elementos coincidentes en un bloque contiguo de la tabla de índice. A continuación, la aplicación sigue las referencias a los datos del cliente mediante las claves de partición almacenadas en la tabla de índice.
Problemas y consideraciones
Tenga en cuenta los siguientes puntos a medida que decida cómo implementar este patrón:
Sobrecarga de mantenimiento. El mantenimiento de índices secundarios puede agregar una sobrecarga significativa. Analice y comprenda las consultas que usa la aplicación. Cree tablas de índice solo cuando sea probable que las use con regularidad. No cree tablas de índices especulativos para admitir consultas que una aplicación no realiza ni realiza solo ocasionalmente. A medida que crece el número de patrones de consulta, crece el número de tablas de índice, y cada una amplía la superficie operativa que hay que supervisar, mantener y depurar. Pesa la ventaja de la consulta de cada tabla de índice con respecto al costo operativo de mantener otra estructura de datos derivada. Revise periódicamente las tablas de índice existentes para identificar y quitar las que ya no se consultan.
Costo de almacenamiento y rendimiento. La duplicación de datos en una tabla de índices aumenta los costos de almacenamiento en proporción al número de tablas de índice y al tamaño de los campos copiados. El mantenimiento de varias copias de datos también agrega esfuerzo. Cada escritura en una tabla de índice consume capacidad de rendimiento, como transacciones con respecto a los límites de la cuenta de almacenamiento en Azure Table Storage o unidades de solicitud en Azure Cosmos DB. El coste no se limita al almacenamiento, sino que también afecta al rendimiento de escritura.
Penalización por doble búsqueda. La implementación de una tabla de índice como una estructura normalizada que hace referencia a los datos originales necesita una aplicación para realizar dos operaciones de búsqueda para encontrar los datos. La primera operación busca la tabla de índice para recuperar la clave principal, y la segunda usa la clave principal para capturar los datos.
Complejidad de la coherencia. Si un sistema incorpora una serie de tablas de índice en conjuntos de datos grandes, el mantenimiento de la coherencia entre las tablas de índice y los datos originales puede ser difícil. Si los datos de origen y las entradas de índice no se pueden actualizar en la misma transacción, diseñe la aplicación en torno a un modelo de coherencia final. Registre cada cambio en el origen de forma persistente antes de confirmar la escritura. Por ejemplo, consumir un flujo de cambios de una base de datos, usar el patrón Transactional Outbox para escribir un registro de salida en la misma transacción que el cambio en el origen, o encolar un comando antes de modificar los datos de origen. En el enfoque basado en comandos, use un proceso de trabajo para procesar el comando y actualizar los datos de origen y sus índices. No actualice los datos de origen y, a continuación, publique de forma independiente un mensaje de actualización de índice, ya que un error entre esas operaciones puede dejar obsoleto el índice.
Diseñe el consumidor asincrónico para que sea idempotente, ya que la entrega de mensajes y los reintentos pueden hacer que la misma actualización se ejecute más de una vez. Las actualizaciones del mismo registro de origen también pueden llegar fuera de orden. Incluya una versión de origen o un número de secuencia en cada actualización de índice y aplique una actualización solo si es más reciente que la versión del índice. Para las eliminaciones, conserve una lápida versionada o una marca máxima equivalente para que una actualización antigua retrasada no pueda volver a crear la entrada de índice eliminada. Durante el intervalo entre la escritura de datos de origen y la actualización de índice asincrónica, las consultas en la tabla de índice pueden devolver referencias obsoletas a los registros que se han actualizado o eliminado en los datos de origen y pueden omitir registros agregados recientemente.
Particionamiento de tablas de índices. Las tablas de índices pueden estar particionadas o fragmentadas, lo que añade complejidad al enrutamiento de consultas y requiere que la estrategia de particionado se ajuste a los patrones de consulta para los que está diseñado el índice.
Cuándo usar este patrón
Use este patrón cuando una aplicación necesite recuperar datos con frecuencia mediante una clave distinta de la clave principal (o partición) y el almacén de datos no admite de forma nativa índices secundarios o sus índices nativos no satisfacen los requisitos de consulta, creación de particiones o rendimiento de la carga de trabajo.
Este patrón podría no ser adecuado cuando:
Los datos son volátiles. Los datos cambian con tanta frecuencia que la velocidad de escritura supera la velocidad a la que se pueden actualizar las tablas de índice de forma asincrónica. El periodo de desfase aumenta hasta que el índice queda permanentemente desactualizado, lo que lo vuelve ineficaz y hace que el sobrecoste de almacenamiento y capacidad de procesamiento de mantener la tabla de índices sea mayor que cualquier ahorro en las consultas.
Hay claves que no discriminan. Un campo seleccionado como clave secundaria para una tabla indexada no es discriminante y solo puede tener un pequeño conjunto de valores (por ejemplo, un campo booleano que indica si un elemento está activo). La tabla de índice incurre en un costo de rendimiento y almacenamiento completo, pero proporciona una selectividad de consulta mínima.
Los valores de datos tienen una distribución sesgada. El equilibrio de los valores de datos de un campo seleccionado como clave secundaria para una tabla de índice está muy sesgado. Por ejemplo, si el 90 % de los registros contienen el mismo valor en un campo, crear y mantener una tabla de índice para buscar datos basados en este campo podría crear más sobrecarga que examinar secuencialmente los datos. Sin embargo, si las consultas suelen tener como destino valores que se encuentran en el 10 % restante, este índice todavía puede ser útil.
Diseño de cargas de trabajo
Un arquitecto debe evaluar cómo usar el patrón de tabla de índices en el diseño de su carga de trabajo para abordar los objetivos y principios tratados en los pilares del Azure Well-Architected Framework. En la tabla siguiente se proporciona una guía sobre cómo este patrón apoya los objetivos de cada pilar.
| Fundamento | Cómo apoya este patrón los objetivos de los pilares |
|---|---|
| La confiabilidad ayuda a la carga de trabajo a cumplir sus objetivos de resistencia y recuperación mediante la creación de redundancia y conservación de la funcionalidad durante los errores. | El mantenimiento de índices asincrónicos puede impedir que los errores temporales de actualización de índices bloqueen las escrituras de datos de origen. El procesamiento idempotente, la gestión de mensajes muertos, la monitorización y la conciliación ayudan a restaurar la consistencia del índice tras fallos. - RE:07 Autopreservación - Re:10 Supervisión |
| Eficiencia del rendimiento ayuda a su carga de trabajo a satisfacer eficientemente las demandas mediante optimizaciones en el escalado, los datos y el código. | Las tablas de índice ayudan a habilitar búsquedas rápidas en campos de clave no principal sin necesidad de exámenes completos de datos. En el caso de los almacenes de datos particionados, las tablas de índice pueden organizar las entradas por valores sin hash para permitir consultas de rango y ordenación que la clave de partición por sí sola no puede resolver de forma eficiente. - PE:05 Escalado y particionamiento - PE:08 Rendimiento de datos |
Al igual que sucede con cualquier decisión de diseño, si este patrón introduce inconvenientes dentro de un pilar, tenga en cuenta los objetivos de los otros pilares.
Example
Considere una aplicación que almacena información sobre películas. Supongamos que el catálogo es grande y con predominio de lectura, que cada película tiene un género principal, que las consultas sobre actores son frecuentes, que los datos del reparto cambian con poca frecuencia y que se acepta un breve retraso en el índice. Table Storage almacena cada entidad como un conjunto estructurado de propiedades con nombre. Cada entidad incluye una PartitionKey, una RowKey y una marca de tiempo, y las entidades de la misma tabla pueden tener diferentes conjuntos de propiedades.
Table Storage usa una clave principal compuesta que consta de PartitionKey y RowKey. El PartitionKey valor determina la partición en la que se almacena una entidad. Dentro de una partición, el RowKey valor identifica de forma única una entidad. Table Storage está optimizado para consultas que especifican ambas claves o capturan un intervalo contiguo de valores de clave de fila dentro de una partición.
Tip
Table Storage admite actualizaciones transaccionales para las entidades de la misma tabla y partición a través de transacciones de grupo de entidades. Una transacción no puede abarcar una tabla de hechos ni una tabla de índice independiente. Para actualizar de forma atómica una entidad de datos y las entidades de índice, almacénelas en la misma tabla con el mismo PartitionKey. Las transacciones de grupo de entidades se limitan a 100 entidades por lote con una carga máxima de 4 MiB.
En este ejemplo, cree una tabla de Azure con particiones para cada género mediante un identificador de género codificado como clave de partición y un identificador de película estable y único como clave de fila. Almacene los nombres de género y película como propiedades. En la ilustración siguiente se usan nombres legibles en lugar de identificadores para facilitar el seguimiento del ejemplo.

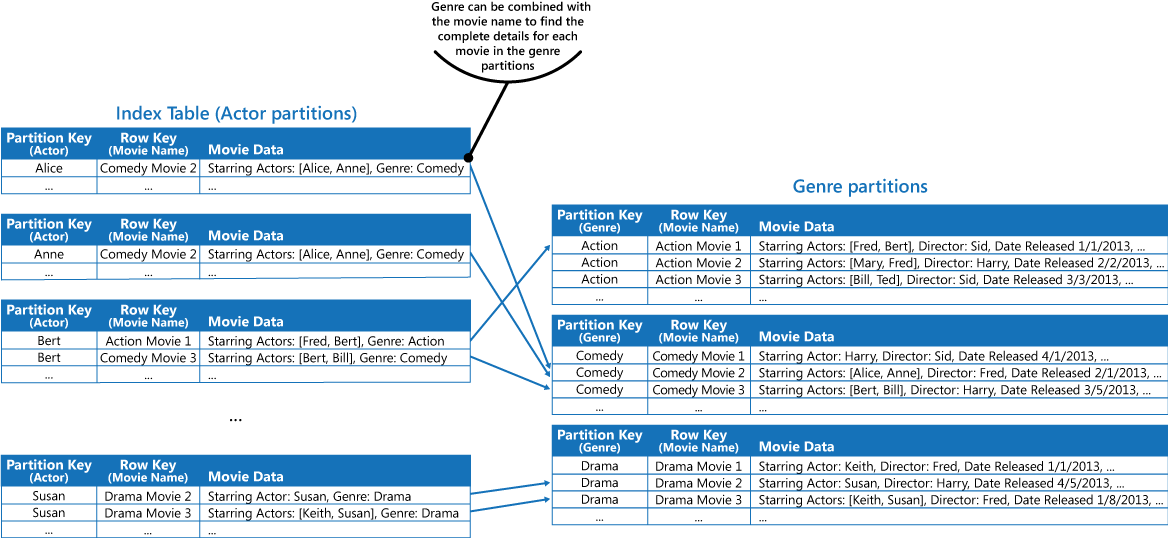
Este enfoque es menos eficaz si la aplicación también necesita buscar películas por actor protagonista. En ese caso, cree una tabla Azure independiente que actúe como una tabla de índice. Use un identificador de actor estable codificado como clave de partición y el identificador de película como clave de fila. Almacene nombres de actor y películas como propiedades. En la ilustración siguiente se usan nombres legibles en lugar de identificadores. Si una película tiene más de un actor, la misma película aparece en varias particiones.
La siguiente figura muestra la tabla de índices de actores.
Tutorial de diseño
La tabla de películas usa el género como clave de partición, lo que significa que las consultas que filtran por género se ejecutan de forma eficaz como análisis de partición sobre intervalos contiguos de claves de fila. Sin embargo, Table Storage solo admite un único índice agrupado en PartitionKey y RowKey. No tiene índices secundarios. Una consulta como "buscar todas las películas protagonizadas por un actor específico" requiere recorrer toda la tabla en cada partición de género, lo que resulta costoso a gran escala.
La tabla de índice de actor aborda esta limitación al revertir el patrón de acceso. Cada identificador de actor se convierte en una clave de partición y cada identificador de película se convierte en una clave de fila, por lo que las consultas por actor se resuelven mediante búsquedas eficientes en la partición. Dado que cada partición contiene solo las películas de un actor, la consulta devuelve un intervalo contiguo de entidades sin examinar datos no relacionados.
Dado que las entradas de película y actor usan tablas independientes y claves de partición, estas entradas no pueden compartir una transacción de grupo de entidades. Mantenga el índice de actores mediante un mecanismo asincrónico y duradero de captura de cambios, y diseñe la aplicación para tolerar un breve desfase en las consultas.
La tabla de índice aplica la desnormalización parcial: cada entrada duplica campos a los que se tiene acceso habitualmente (como los nombres de otros actores) para que las consultas más frecuentes se puedan responder desde la tabla de índice solo con una sola búsqueda. Para los campos a los que se accede con menos frecuencia, la entrada incluye la clave de partición por género de la tabla original de películas, lo que permite realizar una consulta puntual dirigida a la partición de género para obtener el registro completo. Este diseño equilibra la velocidad de las consultas con respecto al costo de almacenamiento y a la sobrecarga de mantenimiento.
Pasos siguientes
La guía de diseño de consultas de Table Storage describe los patrones de índice secundario que usan
PartitionKeyyRowKey, incluidos los enfoques para almacenar entradas de índice en la misma partición o en particiones independientes.Las estrategias de creación de particiones de datos explican cómo seleccionar claves de partición y fila en función de patrones de consulta, distribución de datos, requisitos de transacción y objetivos de escalabilidad.
Las estrategias de arquitectura para optimizar el rendimiento de los datos proporcionan instrucciones para evaluar patrones de consulta, índices, particiones y requisitos de supervisión.
Los niveles de coherencia de Azure Cosmos DB describen los modelos de coherencia que son pertinentes al mantener tablas de índice en Azure Cosmos DB.
Recursos relacionados
Los patrones siguientes también le serán pertinentes cuando implemente este patrón:
Patrón de particionamiento. El patrón de tabla de índices se utiliza con frecuencia junto con datos particionados mediante fragmentos. El patrón de particionamiento describe cómo dividir un almacén de datos en un conjunto de particiones.
Patrón de vista materializada. En lugar de indexar datos para admitir consultas que resumen los datos, puede ser más adecuado crear una vista materializada de los datos. Este patrón describe cómo generar vistas precompletadas sobre los datos para permitir consultas de resumen eficientes.
Patrón de bandeja de salida transaccional. Utilice el patrón de buzón de salida transaccional para ayudar a publicar los cambios de forma fiable para el mantenimiento asíncrono de índices cuando los datos de origen y las entradas del índice no puedan actualizarse en una sola transacción.