Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
VZTAHUJE SE NA: Azure Data Factory Azure Synapse Analytics
Návod
Data Factory v Microsoft Fabric je nová generace Azure Data Factory s jednodušší architekturou, integrovanou AI a novými funkcemi. Pokud s integrací dat začínáte, začněte Fabric Data Factory. Stávající úlohy ADF lze upgradovat na Fabric pro přístup k novým funkcím v oblastech datové vědy, analýz v reálném čase a vytváření sestav.
Tento článek popisuje, jak použít Aktivitu kopírování v pipeline Azure Data Factory nebo Synapse Analytics ke kopírování dat ze Sparku. Vychází z článku „přehled aktivit kopírování“, který představuje obecný přehled této aktivity.
Důležité
Konektor Spark verze 1.0 je ve fázi odebrání. Doporučujeme upgradovat konektor Spark z verze 1.0 na verzi 2.0.
Podporované funkce
Tento konektor Sparku je podporovaný pro následující funkce:
| Podporované funkce | IR |
|---|---|
| aktivita Copy (zdroj/-) | (1) (2) |
| Vyhledávací aktivita | (1) (2) |
(1) Azure Integration Runtime (2) Lokálně hostované Integration Runtime
Seznam úložišť dat podporovaných jako zdroje nebo jímky aktivitou kopírování najdete v tabulce Podporované úložiště dat.
Služba poskytuje integrovaný ovladač, který umožňuje připojení, takže pomocí tohoto konektoru nemusíte ručně instalovat žádný ovladač.
Požadavky
Pokud se vaše úložiště dat nachází uvnitř místní sítě, Azure virtuální sítě, nebo Amazon Virtual Private Cloud, musíte pro připojení nakonfigurovat self-hosted Integration Runtime.
Pokud je vaše úložiště dat spravovanou cloudovou datovou službou, můžete použít Azure Integration Runtime. Pokud je přístup omezený na IP adresy schválené v pravidlech brány firewall, můžete do seznamu povolených přidat ip adresy Azure Integration Runtime.
Funkci managed virtual network Integration Runtime můžete také použít v Azure Data Factory pro přístup k místní síti bez nutnosti instalace a konfigurace místního prostředí Integration Runtime.
Další informace o mechanismech zabezpečení sítě a možnostech podporovaných službou Data Factory najdete v tématu Strategie přístupu k datům.
Začínáme
K provedení aktivity kopírování pomocí datového kanálu můžete použít jeden z následujících nástrojů nebo sad SDK:
- Nástroj pro kopírování dat
- portál Azure
- .NET SDK
- Python SDK
- Azure PowerShell
- REST API
- šablona Azure Resource Manager
Vytvoření propojené služby pro Spark pomocí uživatelského rozhraní
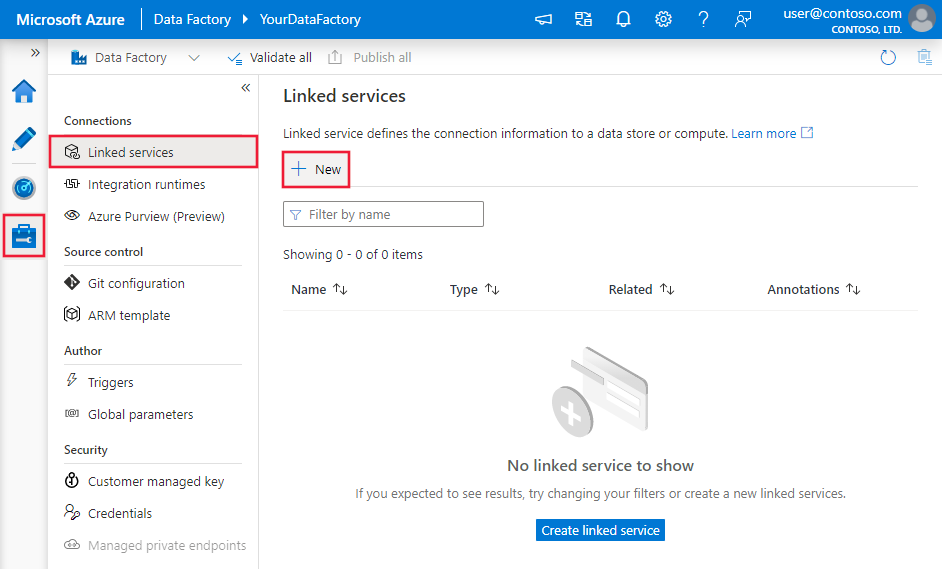
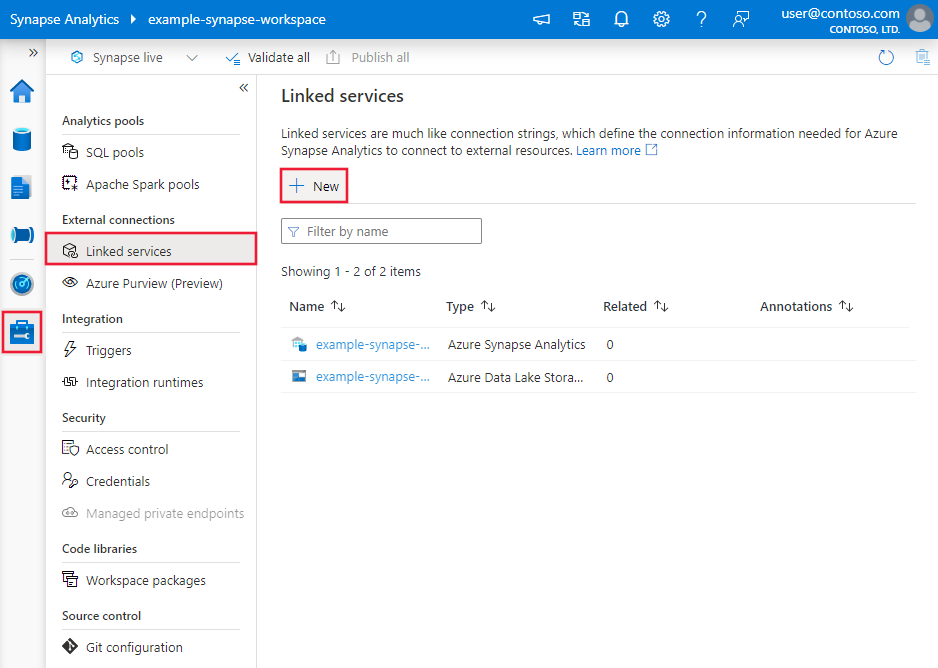
Pomocí následujícího postupu vytvořte propojenou službu se Sparkem v uživatelském rozhraní portálu Azure.
Přejděte na kartu Spravovat v pracovním prostoru Azure Data Factory nebo Synapse a vyberte Propojené služby a potom klikněte na Nový:
Vyhledejte Spark a vyberte konektor Sparku.
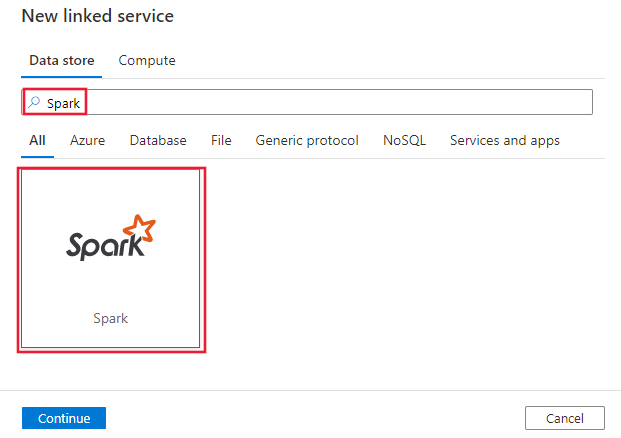
Nakonfigurujte podrobnosti o službě, otestujte připojení a vytvořte novou propojenou službu.
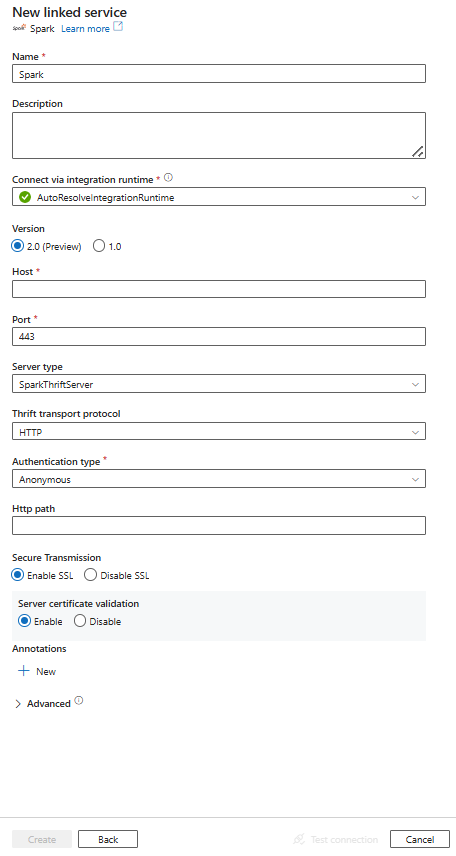
Podrobnosti konfigurace konektoru
Následující části obsahují podrobnosti o vlastnostech, které slouží k definování entit služby Data Factory specifických pro konektor Spark.
Vlastnosti propojené služby
Konektor Spark teď podporuje verzi 2.0. V této části najdete informace o upgradu verze konektoru Spark z verze 1.0. Podrobnosti o nemovitosti najdete v odpovídajících oddílech.
Verze 2.0
Pro propojenou službu Spark verze 2.0 se podporují následující vlastnosti:
| Vlastnost | Popis | Požadováno |
|---|---|---|
| typ | Vlastnost typu musí být nastavená na: Spark | Ano |
| verze | Zadaná verze. Hodnota je 2.0. |
Ano |
| hostitel | IP adresa nebo název hostitele serveru Spark | Ano |
| port | Port TCP, který server Spark používá k naslouchání klientským připojením. Pokud se připojujete k Azure HDInsight, zadejte port 443. | Ano |
| typ serveru | Typ serveru Spark. Povolená hodnota je: SparkThriftServer. |
Ne |
| transportní protokol thrift | Přenosový protokol, který se má použít ve vrstvě Thrift. Povolená hodnota je: HTTP |
Ne |
| typ autentizace | Metoda ověřování používaná pro přístup k serveru Spark. Povolené hodnoty jsou: Anonymní, UsernameAndPassword, WindowsAzureHDInsightService |
Ano |
| uživatelské jméno | Uživatelské jméno, které používáte pro přístup k Spark Serveru. | Ne |
| heslo | Heslo odpovídající uživateli. Označte toto pole jako SecureString pro jeho bezpečné uložení, nebo odkazujte na tajemství uložené v Azure Key Vault. | Ne |
| httpPath | Částečná adresa URL odpovídající serveru Spark. Pro typ ověřování WindowsAzureHDInsightService je /sparkhive2výchozí hodnota . |
Ne |
| enableSsl | Určuje, jestli jsou připojení k serveru šifrovaná pomocí protokolu TLS. Výchozí hodnota je true. | Ne |
| PovolitOvěřováníCertifikátuServeru | Určete, jestli se má při připojení povolit ověření certifikátu SSL serveru. Vždy používejte úložiště důvěryhodných certifikátů systému. Výchozí hodnota je true. |
Ne |
| connectVia | Integration Runtime pro připojení k úložišti dat. Další informace najdete v části Požadavky . Pokud není zadaný, použije výchozí Azure Integration Runtime. | Ne |
Příklad:
{
    "name": "SparkLinkedService",
    "properties": {
        "type": "Spark",
        "version": "2.0",
        "typeProperties": {
            "host": "<cluster>.azurehdinsight.net",
            "port": "<port>",
            "authenticationType": "WindowsAzureHDInsightService",
            "username": "<username>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            }
        }
    }
}
Verze 1.0
Pro propojenou službu Spark verze 1.0 se podporují následující vlastnosti:
| Vlastnost | Popis | Požadováno |
|---|---|---|
| typ | Vlastnost typu musí být nastavená na: Spark | Ano |
| hostitel | IP adresa nebo název hostitele serveru Spark | Ano |
| port | Port TCP, který server Spark používá k naslouchání klientským připojením. Pokud se připojujete k Azure HDInsight, zadejte port 443. | Ano |
| typ serveru | Typ serveru Spark. Povolené hodnoty jsou: SharkServer, SharkServer2, SparkThriftServer |
Ne |
| transportní protokol thrift | Přenosový protokol, který se má použít ve vrstvě Thrift. Povolené hodnoty jsou: Binary, SASL, HTTP |
Ne |
| typ autentizace | Metoda ověřování používaná pro přístup k serveru Spark. Povolené hodnoty jsou: Anonymní, Uživatelské jméno, UsernameAndPassword, WindowsAzureHDInsightService |
Ano |
| uživatelské jméno | Uživatelské jméno, které používáte pro přístup k Spark Serveru. | Ne |
| heslo | Heslo odpovídající uživateli. Označte toto pole jako SecureString pro jeho bezpečné uložení, nebo odkazujte na tajemství uložené v Azure Key Vault. | Ne |
| httpPath | Částečná adresa URL odpovídající serveru Spark. | Ne |
| enableSsl | Určuje, jestli jsou připojení k serveru šifrovaná pomocí protokolu TLS. Výchozí hodnota je false. | Ne |
| důvěryhodná certifikační cesta | Úplná cesta k souboru .pem obsahujícího důvěryhodné certifikáty certifikační autority pro ověření serveru při připojování přes protokol TLS. Tuto vlastnost lze nastavit pouze při použití protokolu TLS v místním prostředí IR. Výchozí hodnota je soubor cacerts.pem nainstalovaný s prostředím IR. | Ne |
| Use System Trust Store (Použít systémový důvěryhodný úložiště) | Určuje, jestli se má použít certifikát certifikační autority z úložiště důvěryhodnosti systému nebo ze zadaného souboru PEM. Výchozí hodnota je false. | Ne |
| povolitNeshoduCNJménaHostitele | Určuje, jestli se má při připojování přes protokol TLS vyžadovat název certifikátu TLS/SSL vystavený certifikační autoritou, který odpovídá názvu hostitele serveru. Výchozí hodnota je false. | Ne |
| povolitVlastnoručněPodepsanýServerovýCertifikát | Určuje, jestli chcete povolit certifikáty podepsané svým držitelem ze serveru. Výchozí hodnota je false. | Ne |
| connectVia | Integration Runtime pro připojení k úložišti dat. Další informace najdete v části Požadavky . Pokud není zadaný, použije výchozí Azure Integration Runtime. | Ne |
Příklad:
{
    "name": "SparkLinkedService",
    "properties": {
        "type": "Spark",
        "typeProperties": {
            "host": "<cluster>.azurehdinsight.net",
            "port": "<port>",
            "authenticationType": "WindowsAzureHDInsightService",
            "username": "<username>",
            "password": {
                "type": "SecureString",
                "value": "<password>"
            }
        }
    }
}
Vlastnosti datové sady
Úplný seznam oddílů a vlastností dostupných pro definování datových sad najdete v článku o datových sadách . Tato část obsahuje seznam vlastností podporovaných datovou sadou Spark.
Pokud chcete kopírovat data ze Sparku, nastavte vlastnost typu datové sady na SparkObject. Podporují se následující vlastnosti:
| Vlastnost | Popis | Požadováno |
|---|---|---|
| typ | Vlastnost typu datové sady musí být nastavená na: SparkObject. | Ano |
| schéma | Název schématu | Ne (pokud je zadán dotaz ve zdroji aktivity) |
| tabulka | Název tabulky. | Ne (pokud je zadán dotaz ve zdroji aktivity) |
| názevTabulky | Název tabulky se schématem Tato vlastnost je podporována pro zpětnou kompatibilitu. Používejte schema a table pro nové úlohy. |
Ne (pokud je zadán dotaz ve zdroji aktivity) |
Příklad
{
    "name": "SparkDataset",
    "properties": {
        "type": "SparkObject",
        "typeProperties": {},
        "schema": [],
        "linkedServiceName": {
            "referenceName": "<Spark linked service name>",
            "type": "LinkedServiceReference"
        }
    }
}
Vlastnosti kopírovací aktivity
Úplný seznam oddílů a vlastností dostupných pro definování aktivit najdete v článku Pipelines . Tato část obsahuje seznam vlastností podporovaných zdrojem Sparku.
Spark jako zdroj
Pokud chcete kopírovat data ze Sparku, nastavte typ zdroje v aktivitě kopírování na SparkSource. Ve zdrojové části aktivity kopírování jsou podporovány následující vlastnosti:
| Vlastnost | Popis | Požadováno |
|---|---|---|
| typ | Vlastnost typu zdroje aktivity kopírování musí být nastavena na: SparkSource. | Ano |
| dotaz | Ke čtení dat použijte vlastní dotaz SQL. Například: "SELECT * FROM MyTable". |
Ne (pokud je v datové sadě zadán název tabulky) |
Příklad:
"activities":[
    {
        "name": "CopyFromSpark",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Spark input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SparkSource",
                "query": "SELECT * FROM MyTable"
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
Mapování datových typů pro Spark
Při kopírování dat z a do Sparku se ve službě používají následující dočasná mapování datových typů. Informace o tom, jak aktivita kopírování mapuje zdrojové schéma a datový typ na jímku, najdete v tématu Mapování schématu a datového typu.
| Datový typ Spark | Dočasný datový typ služby (pro verzi 2.0) | Dočasný datový typ služby (pro verzi 1.0) |
|---|---|---|
| Booleovský typ | Booleovský | Booleovský |
| ByteType | Sbyte | Int16 |
| Krátký typ | Int16 | Int16 |
| IntegerType | Int32 | Int32 |
| DlouhýTyp | Int64 | Int64 |
| FloatType | Jednotlivý | Jednotlivý |
| Dvojitý typ | Dvojitý | Dvojitý |
| Datový typ | Datum a čas | Datum a čas |
| Typ časové značky | DateTimeOffset (časové posunutí datum/čas) | Datum a čas |
| Typ řetězce | Řetězec | Řetězec |
| TypBinární | Bajt[] | Bajt[] |
| Desetinný typ | Desetinný | Desetinný Řetězec (přesnost > 28) |
| ArrayType | Řetězec | Řetězec |
| Typ struktury | Řetězec | Řetězec |
| typ mapy | Řetězec | Řetězec |
| Typ časového razítka NTZ | Datum a čas | Datum a čas |
| TypIntervaluRokMěsíc | Řetězec | Nepodporováno |
| TypIntervaluDenníČas | Řetězec | Nepodporováno |
Vlastnosti aktivity vyhledávání
Podrobnosti o vlastnostech zjistíte v aktivitě Vyhledávání.
Životní cyklus a upgrade konektoru Spark
Následující tabulka ukazuje fázi vydání a protokoly změn pro různé verze konektoru Spark:
| Version | Fáze vydání | Záznam změn |
|---|---|---|
| Verze 1.0 | Removed | Nelze použít. |
| Verze 2.0 | Dostupná verze GA | • enableServerCertificateValidation je podporován. • Výchozí hodnota enableSSL je true. • Pro typ ověřování WindowsAzureHDInsightService je výchozí hodnota httpPath/sparkhive2.• DecimalType se čte jako datový typ Decimal. • TimestampType se čte jako datový typ DateTimeOffset. • YearMonthIntervalType, DayTimeIntervalType se čtou jako datový typ String. trustedCertPath
useSystemTrustStore
allowHostNameCNMismatch• a allowSelfSignedServerCertnejsou podporovány. • SharkServer a SharkServer2 nejsou podporovány pro serverType. • Binární soubor a SASL nejsou podporovány pro thriftTransportProtocl. • Typ ověřování uživatelského jména není podporován. |
Upgrade konektoru Spark z verze 1.0 na verzi 2.0
Na stránce Upravit propojenou službu vyberte verzi 2.0 a nakonfigurujte propojenou službu odkazem na vlastnosti propojené služby verze 2.0.
Mapování datových typů pro propojenou službu Spark verze 2.0 se liší od mapování datového typu pro verzi 1.0. Nejnovější mapování datových typů najdete v tématu Mapování datových typů pro Spark.
Související obsah
Seznam úložišť dat, která jsou podporována jako zdroje a jako cílová úložiště aktivitou kopírování, najdete v podporovaných úložištích dat.