Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Azure NetApp Files
Microsoft Fabric
Azure AI Vyhledávač
Microsoft Foundry
Azure Machine Learning
Nápady na řešení
Tento článek popisuje nápad na řešení. Architekt cloudu může tyto pokyny použít k vizualizaci hlavních komponent pro typickou implementaci této architektury. Tento článek použijte jako výchozí bod k návrhu dobře navrženého řešení, které je v souladu s konkrétními požadavky vaší úlohy.
Tato myšlenka řešení popisuje, jak Azure NetApp Files Object REST API pomáhá organizacím používat existující podniková data souborů pro analytiku a AI bez toho, aby je napřed zkopírovaly do samostatného úložiště objektů. Aplikace kompatibilní se službou Amazon S3 můžou podporovat vyhledávání dokumentů a analýzu s asistencí umělé inteligence, zatímco stávající pracovní postupy NFS a SMB k datům nadále přistupují. Zabránění samostatnému kopírování zdrojových dat může zkrátit dobu nasazení analytických úloh, snížit duplicitní náklady na úložiště a odebrat synchronizační kanály, které by týmy jinak sestavovaly, monitorovaly a odstraňovaly. Méně úložišť zdrojových dat také znamená méně kopií pro řízení a ochranu. Tento přístup podporuje přírůstkovou modernizaci, aniž by organizace musely nahradit své stávající aplikace založené na souborech.
Architecture
Tato architektura se zaměřuje na integraci Microsoft Fabric s Azure NetApp Files prostřednictvím rozhraní REST API objektu. Diagram také ukazuje Azure Databricks jako alternativní uživatel analýzy stejných Azure NetApp Files dat. Nemusíte nasazovat obě platformy. Stávající aplikace nadále přistupují k datům prostřednictvím protokolu NFS nebo SMB podle konfigurace svazku a požadavků klienta.
Výpočetní prostředky Azure Databricks přistupují ke koncovému bodu rozhraní REST API objektu Azure NetApp Files prostřednictvím požadavků kompatibilních s S3 pomocí konektoru Hadoop S3A. Tato alternativní analytická cesta nepoužívá místní bránu ani Microsoft OneLake.
Navazující služby AI v diagramu jsou ilustrativní. Jejich integrace příjmu dat se nezobrazuje.
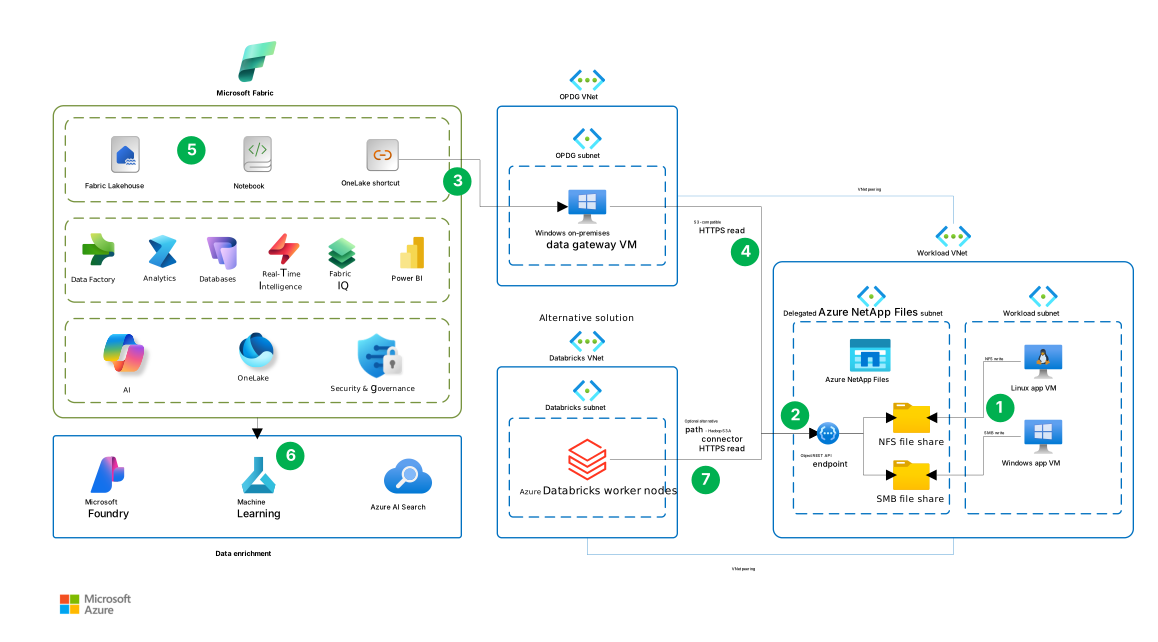
Stáhněte si soubor Visio této architektury.
Tok dat
Následující očíslované interakce popisují diagram architektury. Kroky 1 až 5 popisují primární postup v Microsoft Fabric. Krok 6 představuje volitelné rozšiřování navazujících dat. Krok 7 představuje alternativní analytický postup, nejde o pokračování postupu ve Fabric. Šipky s označením čtení přes HTTPS znázorňují požadavky směřující ke koncovému bodu objektového rozhraní REST API; požadovaná data se vracejí klientovi.
Aplikace zapisují data do souborů. V podsíti úloh zapisuje virtuální počítač s linuxovou aplikací do sdílené složky NFS a virtuální počítač s aplikací pro Windows zapisuje do sdílené složky SMB. Azure NetApp Files obsahuje obě sdílené složky v delegované podsíti.
Rozhraní REST API objektu zpřístupňuje data souboru. Koncový bod v delegované podsíti ANF poskytuje přístup kompatibilní se S3 ke nakonfigurovaným adresářům na svazcích Azure NetApp Files. Připojení z koncového bodu ke sdíleným prostředkům NFS a SMB představuje přístup ke stávajícím datům, nikoli kopii do samostatného objektového úložiště.
Fabric přistupuje k datům prostřednictvím zástupce v OneLake. zástupce odkazuje na data služby Azure NetApp Files prostřednictvím připojení, které používá virtuální počítač brány místních dat Windows v podsíti OPDG (brána místních dat). Zkratka OneLake je připojená k této bráně.
Brána čte z rozhraní Object REST API. Brána používá partnerské propojení mezi virtuální sítí OPDG a virtuální sítí úloh k dosažení koncového bodu. Cesta pro čtení přes HTTPS kompatibilní se S3 připojuje bránu ke koncovému bodu, který přistupuje k datům souboru, na který se odkazuje, pro službu Fabric. Požadavky na připojení najdete v tématu Připojení OneLake ke svazku Azure NetApp Files.
Fabric zpracovává a analyzuje data. Podporované úlohy v prostředí Fabric využívají data prostřednictvím zástupce. Poznámkové bloky například čtou odkazované soubory a zapisují odvozené výsledky do tabulek lakehouse pro účely analýzy a vytváření sestav v Power BI. Rámeček Fabric v diagramu ukazuje tyto možnosti zpracování a analýzy.
Volitelné navazující služby obohacují data. Šipka pod Fabric vede ke skupině obohacení dat, která obsahuje Microsoft Foundry, Azure Machine Learning a Azure AI Vyhledávač. Tento krok představuje volitelné následné zpracování. Diagram nezobrazuje příjem dat ani orchestraci potřebnou k připojení těchto služeb a zkratka OneLake tyto integrace nevytváří.
Případně Azure Databricks čte data souboru přímo. Pracovní uzly v podsíti Databricks používají konektor Hadoop S3A k odesílání požadavků HTTPS na čtení na stejný koncový bod REST API objektového úložiště přes propojené virtuální sítě. Tato cesta nahrazuje přístupovou a zpracovatelskou cestu Fabric v krocích 3 až 5. Neprochází přes místní bránu ani OneLake.
Zvolte umístění zástupce podle toho, jak chcete s daty pracovat:
- Existující kompatibilní tabulky Delta. Vytvořte zástupce tabulky v oddílu Tabulky lakehouse, který cílí na úplnou tabulku Delta, včetně jejího transakčního protokolu. Fabric rozpozná cílové umístění jako tabulku, na kterou se můžete dotazovat prostřednictvím Sparku a koncového bodu analýzy SQL, zatímco zdrojová data zůstávají na Azure NetApp Files.
- Soubory pro přímý přístup nebo zpracování Vytvořte zkratky v části Soubory v lakehouse. Kompatibilní úlohy můžou kromě dokumentů číst i samostatné soubory Parquet, CSV a JSON, aniž by bylo nutné nejprve zkopírovat zdrojové soubory do OneLake. Pokud navazující analytika vyžaduje tabulky lakehouse, transformujte nebo načtěte zdrojová data do odvozených tabulek Delta v OneLake.
Samostatné soubory Parquet nejsou automaticky tabulkami Delta. zástupce v Souborech automaticky nezaregistruje cíl jako tabulku. Další informace naleznete v tématu Kam umístit zkratky v lakehouse.
Components
Následující komponenty podporují architekturu zaměřenou na Fabric a volitelnou alternativu Azure Databricks.
Azure NetApp Files je plně spravovaná služba úložiště souborů založená na technologii NetApp. V této architektuře tato architektura ukládá podnikovou datovou sadu a poskytuje přístup přes NFS, SMB a objektový přístup kompatibilní se S3 prostřednictvím rozhraní Object REST API. Poskytuje také funkce vytváření snímků a replikace.
Objektové rozhraní REST API služby Azure NetApp Files zpřístupňuje existující data souborů prostřednictvím rozhraní kompatibilního s S3. V této architektuře umožňuje kompatibilním analytickým aplikacím a aplikacím umělé inteligence přistupovat k datům bez nutnosti nejprve vytvořit samostatnou kopii v objektovém úložišti. Rozhraní podporuje podmnožinu operací Amazon S3. Než zvolíte tuto integraci, ověřte, že podporované operace splňují požadavky vaší aplikace.
Microsoft Fabric je analytická platforma, která sjednocuje přesun dat, zpracování dat, příjem dat, transformaci, zpracování datových proudů prostřednictvím Real-Time intelligence a sestavování sestav. V této architektuře slouží jako analytická platforma pro zpracování a analýzu dat z Azure NetApp Files prostřednictvím zkratek OneLake.
OneLake je sjednocené logické datové jezero pro Fabric. V této architektuře zpřístupní zkratky OneLake odkazovaná data Azure NetApp Files podporovaným úlohám Fabric.
Azure Virtual Network poskytuje privátní připojení mezi prostředky Azure v této architektuře. Partnerské propojení virtuálních sítí umožňuje virtuálnímu počítači brány a volitelným výpočetním prostředkům Azure Databricks dosáhnout koncového bodu rozhraní Object REST API služby Azure NetApp Files.
Místní brána dat připojuje zástupce OneLake ke koncovému bodu bucketu Azure NetApp Files. Navzdory svému názvu, v této architektuře brána běží ve standardním režimu na virtuálním počítači Azure s podporovaným operačním systémem Windows. Zvolte bitovou kopii, která splňuje požadavky na instalaci brány. Instalace Server Core a kontejnery Windows nejsou podporovány. Brána zahájí odchozí připojení prostřednictvím Azure Relay ke komunikaci s Fabric. Nevyžadují se žádná příchozí připojení z Fabric. Nakonfigurujte bránu firewall nebo proxy server tak, aby povolovaly odchozí koncové body popsané v části Úprava nastavení komunikace pro místní bránu pro data.
Azure Databricks je volitelná alternativní analytická platforma pro úlohy datového inženýrství a strojového učení. Jeho úlohy Sparku používají konektor Hadoop S3A nakonfigurovaný pro koncový bod rozhraní REST API objektu pro přístup k datové sadě Azure NetApp Files místo použití cesty integrace Fabric.
Alternativy
Tato architektura zahrnuje více komponent, které můžete nahradit jinými službami nebo přístupy Azure v závislosti na funkčních a nefunkčních požadavcích vaší úlohy. Zvažte následující alternativy a jejich kompromisy.
Storage
Při výběru mezi Azure Blob Storage a Azure NetApp Files zvažte požadavky na protokol aplikací a měřený výkon:
Zvolte Blob Storage, když klienti můžou používat rozhraní BLOB STORAGE REST API nebo NFS 3.0 a nevyžadují protokol SMB nebo NFS 4.1. Obě rozhraní mají přístup ke stejným datům. Přístupová cesta systému souborů NFS 3.0 Blob Storage je optimalizovaná pro vysokou propustnost a sekvenční úlohy náročné na čtení, kde je propustnost důležitější než nízká latence.
Zvolte Azure NetApp Files, když aplikace a analytické úlohy potřebují přistupovat ke stejným souborům prostřednictvím protokolu SMB nebo NFS 4.1 a rozhraní REST API kompatibilního s S3 nebo když souborové aplikace vyžadují náhodné vstupně-výstupní operace s nízkou latencí. Pro data, která jsou již na Azure NetApp Files, přidává REST API objektového úložiště přístup k analýzám bez migrace zdrojových aplikací nebo dat.
U obou možností změřte end-to-end latenci a propustnost v rámci souběžného zatížení zdrojové aplikace a analytických úloh. Výkon systému souborů NFS nebo SMB neurčuje výkon rozhraní Object REST API ani výkonu Fabric, proto otestujte zamýšlenou cestu přístupu podle požadavků úlohy. Porovnejte celkové náklady, včetně změn aplikací, migrace a jakéhokoli průběžného duplikování a synchronizace. Porovnání protokolů a úloh zatížení najdete v tématu Porovnání služeb úložiště Azure.
Integration
Úlohy Azure Databricks můžou pomocí konektoru Hadoop S3A číst data Azure NetApp Files prostřednictvím rozhraní Object REST API bez OneLake nebo místní brány dat. Nakonfigurujte důvěryhodné certifikáty TLS a bezpečně uložené přihlašovací údaje a před spoléháním na zpětný zápis ověřte požadované operace zápisu. Pokud potřebujete inicializační skripty, použijte skripty s platností pro cluster uložené ve svazcích katalogu Unity na podporovaných výpočetních prostředcích podle aktuálních pokynů Azure Databricks k inicializačním skriptům.
Podrobnosti scénáře
Tento vzor použijte, když stejná datová sada musí obsluhovat aplikace, které očekávají připojený systém souborů a analýzy nebo služby AI, které očekávají rozhraní objektů kompatibilní s S3.
Aplikace spuštěné na virtuálních počítačích nebo v kontejnerech mohou i nadále používat Azure NetApp Files prostřednictvím protokolů NFS nebo SMB. Můžou například používat existující kód pro přístup k souborům, připojené sdílené složky a adresářové struktury. Rozhraní REST API Azure NetApp Files objektu mapuje kořenový adresář svazku nebo podadresář do bucketu kompatibilního se S3, aby kompatibilní objektoví klienti mohli přistupovat ke stejným podkladovým souborům.
Tento přístup je užitečný, když chcete ke stávajícím úlohám založeným na souborech přidat analytické nástroje nebo funkce AI, aniž by bylo nutné měnit původní aplikace tak, aby používaly objektové úložiště. Podřízené pracovní postupy můžou podle potřeby vytvářet odvozená data, jako jsou transformované datové sady, indexy, embeddingy a mezipaměti.
Když klienti souborů a objektů přistupují ke stejným datům, zohledněte rozdíly v identitě, oprávněních, uzamčení a požadavcích na konzistenci aplikací. Definujte, jak producenti signalizují, že je soubor nebo dávka dokončena, než jej příjemci objektů zpracují. Producenti by měli dokončit zapisování a zavřít soubory předtím, než signalizují připravenost, a během zpracování spotřebiteli tyto soubory nijak neměnit. Otestujte toto předání pro přerušené zápisy a opakované pokusy o zpracování.
Modely identit a autorizace se také liší v různých metodách přístupu. Původní oprávnění k souborům jednotlivých uživatelů se do Fabric automaticky nepřenesou. Nakonfigurujte oprávnění Fabric pro určené příjemce a ujistěte se, že identita používaná rozhraním REST API objektu má přístup pouze k požadovaným zdrojovým datům. Další informace naleznete v tématu Zabezpečení.
Mapujte adresáře do samostatných kontejnerů v případech, kdy spotřebitelé vyžadují různé úrovně přístupu Klasifikace dat, uchovávání, navazující autorizace a správa odvozených dat zůstávají v odpovědnosti úloh. Další informace najdete v tématu Vytvoření bucketu.
Potenciální případy použití
Tato architektura podporuje úlohy, které potřebují analyzovat strukturovaná nebo nestrukturovaná data, která jsou již uložená v Azure NetApp Files. Následující příklady ukazují různé způsoby, jak může Fabric tato data využívat.
Zpracovávání dokumentu
Aplikace mohou ukládat dokumenty, obrázky nebo jiné nestrukturované soubory do Azure NetApp Files prostřednictvím protokolů NFS nebo SMB. Fabric notebook může číst dokončené soubory pomocí zástupce OneLake a odesílat jejich obsah do služby zpracování dokumentů, jako je Azure Document Intelligence, k extrakci. Uložte výsledná strukturovaná data do tabulek lakehouse pro ověřování, analýzu a vytváření sestav.
Pokyny k integraci najdete v tématu Integrace funkce Document Intelligence prostřednictvím SynapseML.
Analýza dat
Aplikace můžou do sdílené složky Azure NetApp Files zapisovat strukturovaná data, jako jsou soubory CSV nebo Parquet. Fabric poznámkové bloky můžou číst dokončené soubory pomocí zástupce OneLake, kombinovat je s jinými daty lakehouse a zapisovat odvozené výsledky do tabulek lakehouse.
Tento model může podporovat scénáře, jako je technická analýza a analýza kvality, analýza dat ze snímačů a provozní generování sestav, aniž by bylo nutné, aby zdrojové aplikace měnily způsob ukládání souborů.
U existujících kompatibilních datových sad Delta vytvořte zástupce OneLake v oddílu Tabulky lakehouse, který cílí na úplnou tabulku Delta, včetně jejího transakčního protokolu. Fabric pak dokáže rozpoznat cíl jako tabulku a zdrojová data můžou zůstat na Azure NetApp Files. Další informace najdete v tématu Kam umístit zástupce v lakehouse.
Vyhledávání a získávání pomocí AI
Dokumenty uložené na Azure NetApp Files můžou také sloužit jako zdrojový obsah pro úlohy AI. Pracovní postup zpracování může například číst dokumenty prostřednictvím zkratky OneLake a použít je k vytvoření indexu Azure AI Vyhledávač pro generování rozšířené o vyhledávání (RAG).
Vyhledávací index a veškeré embeddingy představují odvozená data a jsou ukládány odděleně od zdrojových souborů. Navrhněte pracovní postup tak, aby indexovaný obsah zůstal synchronizovaný se zdrojovými aktualizacemi, přejmenováním a odstraněním. Při načítání indexovaného obsahu také zajistěte uplatňování příslušných mechanismů řízení přístupu, protože původní oprávnění SMB a NFS se automaticky nestanou oprávněními pro vyhledávání na úrovni jednotlivých uživatelů.
Stejný model je možné rozšířit i na jiné úlohy umělé inteligence. Například poznámkové bloky Fabric můžou připravit datové sady ze zdrojových souborů a uložit připravená data do OneLake pro využití službou Azure Machine Learning. Informace o možnostech a omezeních integrace najdete v tématu Integrace OneLake s Azure Machine Learning.
Considerations
Tyto aspekty implementují pilíře Dobře navržené architektury Azure, což je sada hlavních principů, které můžete použít ke zlepšení kvality pracovní zátěže. Další informace najdete v tématu Well-Architected Framework. Další pokyny najdete v tématu Doporučení Well-Architected Framework pro Azure NetApp Files.
Reliability
Spolehlivost pomáhá zajistit, aby vaše aplikace splňovala závazky, které jste pro své zákazníky udělali. Další informace najdete v kontrolním seznamu pro kontrolu návrhu pro spolehlivost.
Azure NetApp Files běží na flotile fyzických serverů odolné proti chybám využívající ONTAP a poskytuje SLA s vysokou dostupností. Pokud chcete získat další ochranu před výpadky zón dostupnosti nebo oblastí, můžete volitelně nakonfigurovat replikaci mezi zónami nebo mezi oblastmi. Tato replikace je asynchronní a vyžaduje přepnutí při selhání na cílový svazek dat, které musí iniciovat zákazník. Zvolte možnost replikace a nastavte harmonogram v souladu s cíli obnovení vaší úlohy. Další informace najdete v tématu spolehlivost služby Azure NetApp Files.
Sdílení jedné datové sady také způsobuje, že se dostupnost úložiště stává společnou závislostí pro souborové aplikace a analytické úlohy. Tyto možnosti úložiště nezajišťují komplexní dostupnost typu end-to-end pro bránu, pipeline indexování ani aplikace, které je využívají. Slaďte cíle obnovení s kompletní pracovní zátěží, včetně brány, následného zpracování a odvozených dat.
Jediný virtuální počítač brány představuje jediný bod selhání integrační cesty Fabric. Pro důležité obchodní úlohy nasaďte alespoň dva členy brány na samostatných virtuálních počítačích v clusteru brány. Ujistěte se, že každý člen má přístup ke koncovému bodu Object REST API a může navázat požadovaná odchozí spojení. Otestujte chování zatížení, když se člen brány stane nedostupným.
- Obnovení souborů a svazků je podporováno pomocí prostorově úsporných snímků k určitému časovému okamžiku. Aplikace Teams může obnovit jednotlivé soubory, vrátit celý svazek nebo vytvořit nový svazek z bodu obnovení po náhodném odstranění, poškození nebo neúspěšném analytickém procesu. Dostupné operace obnovení najdete v tématu ochrana dat na základě snímků ve službě Azure NetApp Files.
Zabezpečení
Zabezpečení poskytuje záruky proti záměrným útokům a zneužití cenných dat a systémů. Další informace naleznete v dokumentu Kontrolní seznam návrhu zabezpečení.
Udržování menšího počtu kopií zdrojových dat může snížit počet úložišť pro ochranu. Azure NetApp Files šifruje data v klidu a rozhraní REST API objektu používá k ochraně přenášených dat protokol TLS. Přístupová oprávnění k souborům závisí na protokolu:
Klienti SMB a NFS nadále používají své stávající modely ověřování a autorizace. Stávající seznamy řízení přístupu NTFS (ACL), oprávnění NFS a pravidla mapování identit zůstávají v platnosti pro tyto klienty.
Klienti rozhraní Object REST API se ověřují pomocí přístupového klíče S3. Oprávnění bucketu definují, jestli má klient v mapovaném adresáři přístup jen pro čtení nebo pro čtení i zápis. Požadavky na objekty nezahrnují identitu jednotlivého uživatele SMB, NFS nebo následného uživatele. Azure NetApp Files provádí každou operaci objektu pod nakonfigurovanou zosobněnou identitou systému souborů daného bucketu. Stávající oprávnění souborů a seznamy ACL se posuzují pouze vůči této identitě.
Použitá identita souborového systému je pro svazky NFS identifikátor uživatele (UID) a identifikátor skupiny (GID) nebo pro svazky SMB uživatelský účet. Dvouprotokolové svazky používají typ identity, který odpovídá jejich nakonfigurovanému stylu zabezpečení. Tato identita určuje přístupová oprávnění k souborům. Přístupový klíč S3 autentizuje objektového klienta. Další informace najdete v tématu Zabezpečení a oprávnění rozhraní REST API objektu.
Zástupce kompatibilní s OneLake S3 se vůči bucketu ověřuje pomocí ID přístupového klíče a tajného přístupového klíče. Zdrojové seznamy ACL systému NTFS, oprávnění NFS a identity jednotlivých vlastníků souborů se do OneLake nekopírují ani nemapují. Uživatelé Fabric mají autorizaci na základě oprávnění OneLake a Fabric. Mohou přistupovat pouze k obsahu zpřístupněnému prostřednictvím zástupce přes bucket a identitu, za kterou se vydává, ale OneLake nevynucuje původní oprávnění k souborům pro jednotlivé uživatele. Tento typ zástupce/odkazu nepodporuje OAuth založené na Microsoft Entra, instanční objekty služby a RoleArn.
Uživatel Fabric může například přečíst dokument prostřednictvím zástupce, i když ho jeho osobní účet SMB nemůže přečíst přímo, pokud oprávnění Fabric přístup umožňují a impersonovaná identita bucketu může dokument přečíst. Před zpřístupněním adresáře ověřte, že zamýšlená cílová skupina Fabric má oprávnění k přístupu k jeho obsahu.
Nakonfigurujte identitu pro impersonaci bucketu pouze s oprávněními ke zdroji, která úloha vyžaduje. Omezte přístup k zástupci a lakehouse. K správě certifikátů TLS a přístupových klíčů S3 použijte postup práce s certifikáty a úložiště přihlašovacích údajů založené na Azure Key Vault. Definujte a otestujte postup obměny, který koordinuje změny certifikátů a přihlašovacích údajů s aktualizacemi připojení Fabric a dalších využívajících systémů. Vygenerování nových přístupových údajů bucketu okamžitě zneplatní stávající dvojici, proto počítejte s přerušením provozu během aktualizace klientů a po rotaci ověřte přístup.
Pokud používáte certifikát TLS s vlastním podpisem, ujistěte se, že mu každý hostitel brány důvěřuje. Další informace najdete v požadavcích na bránu OneLake.
Zabezpečení a dodržování předpisů závisí na konfiguraci úložiště, přístupu a navazujících služeb. Zahrňte následné zpracování a odvozená data do rozsahu zásad správného řízení a dodržování předpisů. Požadavky, jako jsou GDPR a HIPAA, se vztahují na celé pracovní zatížení, tam, kde se uplatňují. Další informace najdete v tématu Zabezpečení a oprávnění rozhraní REST API objektu a vytvoření zástupce kompatibilního s Amazon S3 ve OneLake.
Optimalizace nákladů
Optimalizace nákladů se zaměřuje na způsoby, jak snížit zbytečné výdaje a zlepšit efektivitu provozu. Další informace najdete v kontrolním seznamu pro kontrolu návrhu pro optimalizaci nákladů.
Vyhnutí se samostatné kopii zdrojových dat může snížit náklady na duplicitní úložiště a synchronizaci. Porovnejte tyto úspory s náklady na kapacitu a výkon služby Azure NetApp Files, výpočetní prostředky brány, kapacitu Fabric a navazující zpracování a úložiště.
Tento ukázkový odhad cen zahrnuje fond kapacity 1 TiB Azure NetApp Files Standard, virtuální počítač Windows D8s_v5 pro místní bránu dat, dva spravované disky 128 GiB P10, bránu NAT s veřejnou IP adresou a zpracováním odchozích dat, Fabric kapacitu F2 a 100 GB nativního úložiště OneLake.
Konfigurace jedné brány není vysoce dostupná. Volitelné služby AI Search, služby embeddings a náklady na Azure Databricks jsou vyloučeny. Upravte prostředky pro požadavky vaší úlohy na kapacitu, síť a dostupnost.
Přístup ke studeným datům: Přesuňte neaktivní datové bloky včetně dat snímků do levnějšího úložiště při zachování přístupu k souborům a objektům. Vyhodnoťte poplatky za načítání, latenci a změny propustnosti specifické pro úroveň služby s ohledem na vzor přístupu úlohy.
Úrovně služeb a správné dimenzování: Zvolte úroveň služby Azure NetApp Files, která odpovídá požadavkům datové sady na kapacitu a propustnost. Úroveň služby Flexible umožňuje nezávisle zřizovat kapacitu a propustnost fondu. Zkontrolujte kapacitu zpoplatněného fondu a propustnost, jak se poptávka mění, abyste se vyhnuli trvalému nadměrnému přidělování prostředků.
Efektivita provozu
Efektivita provozu se zabývá provozními procesy, které nasazují aplikaci a udržují ji spuštěnou v produkčním prostředí. Další informace najdete v kontrolním seznamu pro kontrolu návrhu pro efektivitu provozu.
Zástupci OneLake snižují provozní složitost tím, že odpadá potřeba datového kanálu, který udržuje samostatnou kopii zdrojových dat pro analytiku. Bez samostatného kanálu kopírování nemusí týmy plánovat úlohy kopírování, zotavovat se po selhání přenosu nebo slaďovat zdrojová a zkopírovaná data jako součást rutinních operací.
Týmy zdrojové aplikace a analytiky musí koordinovat změny a reakce na incidenty pro sdílenou datovou sadu Azure NetApp Files. Stanovte odpovědnost za monitorování, zpracování selhání a přihlašovací údaje pro Object REST API a správu certifikátů.
Monitorujte výkon úložiště, brány a Fabric za účelem identifikace omezení a přizpůsobení kapacity nebo propustnosti:
Pomocí Azure Monitor můžete sledovat propustnost čtení a zápisu svazku, počet IOPS pro čtení a zápis, další IOPS, průměrnou latenci čtení a zápisu, spotřebu kapacity a indikátor dosažení limitu propustnosti. Nastavte upozornění na trvalé zvýšení latence, opakované omezování QoS a prahové hodnoty kapacity místo izolovaných špiček; metriky Azure NetApp Files se agregují v intervalech a latence úložiště nezahrnuje každou komponentu REST na straně klienta.
Korelujte metriky úložiště s měřeními na straně klienta, jako jsou percentily latence požadavků, velikost objektu, souběžnost, opakování, stavové kódy HTTP, procesor, paměť a propustnost sítě. Tím se odliší limit propustnosti svazku od poddimenzovaného výpočetního klienta, neefektivního nastavení sady SDK, režie na malé objekty nebo síťové vzdálenosti.
Monitorujte procesor, paměť, dostupné místo na disku a propustnost sítě u jednotlivých virtuálních počítačů brány spolu s chybami brány a dobami dokončení úloh. Nakonfigurujte výstrahy pro dlouhodobé přetížení prostředků a nedostatek místa na disku s využitím prahových hodnot vytvořených během reprezentativních testů úloh. Při řešení chyb nebo pomalého přístupu používejte diagnostické protokoly brány . Monitorujte virtuální počítač a síť samostatně, protože diagnostika brány neposkytuje úplné pokrytí infrastruktury.
Monitorujte využití kapacity Fabric a omezování pomocí aplikace Fabric Capacity Metrics. Nakonfigurujte oznámení o využití kapacity pro zodpovědné správce. Porovnejte využití kapacity s měřeními brány a úložiště, abyste zjistili, jestli zpoždění pocházejí z přístupu ke zdroji nebo ze zpracování ve Fabric před změnou kapacity.
Efektivita výkonu
Efektivita výkonu odkazuje na schopnost vaší úlohy efektivně škálovat tak, aby splňovala požadavky uživatelů. Další informace najdete v kontrolním seznamu pro kontrolu návrhu týkajícího se efektivity výkonu.
Azure NetApp Files může podporovat jak aplikace NFS nebo SMB citlivé na latenci, tak analytické nebo AI klienty kompatibilní s S3 používající stejnou datovou sadu. Zachování zdrojových dat na jednom svazku může odstranit fázi kopírování, která by jinak zpožďovala indexování, trénování nebo dávkové zpracování a spotřebovávala šířku pásma klienta, sítě a cílového úložiště.
Latence úložiště kratší než milisekunda na podporovaných úrovních služby Azure NetApp Files je nejvíce relevantní pro úlohy NFS a SMB. Nezaručuje latenci typu end-to-end u požadavků rozhraní REST API objektů HTTPS. Před nastavením cíle latence proveďte srovnávací test cesty přístupu kompatibilní s S3 s reprezentativními objekty a souběžností.
Velikost úložiště: Dimenzujte propustnost pro kombinované zatížení souborových aplikací a klientů objektového úložiště. Automatické QoS prováže propustnost svazku s kvótou svazku. Ruční QoS umožňuje samostatné přidělení v rámci rozpočtu na propustnost poolu.. Před úpravou výkonu benchmarkujte reprezentativní úlohy.
Nastavení velikosti brány: Nastavte velikost virtuálních počítačů brány pro kombinovanou poptávku úloh, které přistupují k Azure NetApp Files prostřednictvím zástupců OneLake. Jako výchozí bod použijte pokyny pro změnu velikosti a škálování brány . Ověřte dimenzování pomocí reprezentativních objemů dat a souběžného přístupu prostřednictvím zkratek. Měřením využití procesoru a paměti a propustnosti sítě brány spolu s časy dokončení úloh určete, zda zvýšit prostředky virtuálního počítače nebo přidat členy brány.
Dimenzování kapacity Fabric: Dimenzujte kapacitu Fabric pro kombinovanou úlohu zpracování a generování sestav, včetně Power BI. Postupujte podle pokynů v průvodci plánováním kapacity Fabric a odhadujte počáteční kapacitu, otestujte reprezentativní pilotní nasazení a upravte kapacitu na základě měřeného využití a omezování.
Umístěte výpočetní prostředky blízko svazku, vhodně nakonfigurujte klientské síťové připojení a otestujte je se skutečným pracovním zatížením. Zvyšte paralelismus a používejte vhodně velké požadavky pro sekvenční analýzy, ale při zvýšení latence nebo počtu chyb omezte souběžnost. V případě NFS nebo SMB ověřte nastavení připojení, protokolu a aplikace. V případě REST ověřte podporu požadovaných operací rozhraní API klienta a otestujte opakované použití připojení, chování při nahrávání, opakování a výpis objektů.
Ověřte kompletní propustnost a latenci v rámci souběžného zatížení a slaďte požadavky na analýzu s požadavky na výkon zdrojové aplikace.
Contributors
Společnost Microsoft udržuje tento článek. Tento článek napsali následující přispěvatelé.
Hlavní autoři:
- Dan Jackson | Architekt cloudových řešení, NetApp
- Anthony Mashford | Architekt cloudových řešení, NetApp
- Daniel Söderholm | Senior Solution Engineer, Cloud + AI Platforms, Microsoft
Další přispěvatelé:
- Heather Grandy | Senior Solution Engineer pro datové platformy, Microsoft
Pokud chcete zobrazit nepublikované profily LinkedIn, přihlaste se k LinkedIn.
Další kroky
- Úvod do objektového rozhraní REST API pro Azure NetApp Files
- Připojte OneLake ke svazku Azure NetApp Files
- Inicializační skripty v Azure Databricks
- Integrujte OneLake s Azure Machine Learning