Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Azure Monitor pro Azure Cosmos DB poskytuje zobrazení metrik pro monitorování vašeho účtu a vytváření řídicích panelů. Metriky služby Azure Cosmos DB se ve výchozím nastavení shromažďují. Tato funkce nevyžaduje, abyste explicitně povolili ani nenakonfigurovali nic.
Definice metriky
Normalizovaná spotřeba RU je metrika mezi 0% až 100%, která slouží k měření využití zřízené propustnosti v databázi nebo kontejneru. Metrika se odesílá v 1minutových intervalech a je definována jako maximální využití jednotek žádostí za sekundu (RU/s) napříč všemi rozsahy hodnot klíčů oddílů v daném časovém intervalu. Každý rozsah klíčů oddílu se mapuje na jeden fyzický oddíl a je přiřazen k uchovávání dat pro rozsah možných hodnot hash. Obecně platí, že čím vyšší je normalizované procento RU, tím více jste využili zřízenou propustnost. Metriku lze také použít k zobrazení využití jednotlivých rozsahů partitionových klíčů na databázi nebo kontejneru.
Předpokládejme například, že máte kontejner, ve kterém nastavíte maximální propustnost automatického škálování 20 000 RU/s (škáluje se mezi 2000 až 20 000 RU/s) a máte dva rozsahy klíčů oddílů (fyzické oddíly) P1 a P2. Vzhledem k tomu, že Azure Cosmos DB distribuuje zřízenou propustnost rovnoměrně napříč všemi rozsahy klíčů oddílů, mohou P1 a P2 škálovat v rozmezí 1000 až 10 000 RU/s. Předpokládejme, že v 1minutovém intervalu spotřeboval P1 v dané sekundě 6 000 RU a P2 spotřeboval 8 000 RU. Normalizovaná spotřeba RU P1 je 60 % a 80 % pro P2. Celková normalizovaná spotřeba RU celého kontejneru je MAX(60 %, 80 %) = 80 %.
Pokud vás zajímá, jak se spotřeba jednotek žádosti zobrazuje v intervalu za sekundu spolu s typem operace, můžete použít diagnostické protokoly výslovného souhlasu a dotazovat se na tabulku PartitionKeyRUConsumption . Pokud chcete získat základní přehled operací a stavového kódu, který vaše aplikace provádí s prostředkem služby Azure Cosmos DB, můžete použít integrovanou metriku Požadavků služby Azure Monitor Total Requests (API for NoSQL), Mongo Requests, Gremlin Requests nebo Cassandra Requests . Později můžete tyto požadavky filtrovat podle stavového kódu 429 a rozdělit je podle typu operace.
Co očekávat a dělat, když je normalizované RU/s vyšší
Když normalizovaná spotřeba RU dosáhne 100% pro daný rozsah klíčů oddílu a pokud klient v daném časovém intervalu 1 sekundy stále odesílá požadavky do konkrétního rozsahu klíčů oddílu, obdrží chybu s omezenou rychlostí (429).
To nemusí nutně znamenat, že je problém s vaším zdrojem. Klientské sady SDK služby Azure Cosmos DB a nástroje pro import dat, jako je Azure Data Factory a knihovna bulk Executor, ve výchozím nastavení automaticky opakují požadavky na 429. Obvykle se opakují až devětkrát. V důsledku toho se v metrikách může zobrazit 429s, ale tyto chyby se nemusely vůbec vrátit do vaší aplikace.
Obecně platí, že pokud u produkční zátěže zaznamenáte mezi 1 až 5% požadavků s kódy stavu 429 a vaše celková doba odezvy je přijatelná, je to zdravý znak, že jednotky RU/s jsou plně využívány. V tomto případě, když normalizovaná metrika spotřeby RU dosahuje 100 %, znamená to pouze to, že v dané sekundě alespoň jeden rozsah klíčů oddílu použil veškerou přidělenou propustnost. To je přijatelné, protože celkový počet výskytů kódu 429 je stále nízký. Nevyžaduje se žádná další akce.
Pokud chcete zjistit, jaké procento vašich požadavků směřovaných na databázi nebo kontejner výsledkem jste získali kód 429, přejděte ze svého účtu služby Azure Cosmos DB na Přehledy>Žádosti>Celkový počet žádostí podle stavového kódu. Vyfiltrujte konkrétní databázi a kontejner. Pro rozhraní API pro Gremlin použijte metriku Požadavků Gremlin.
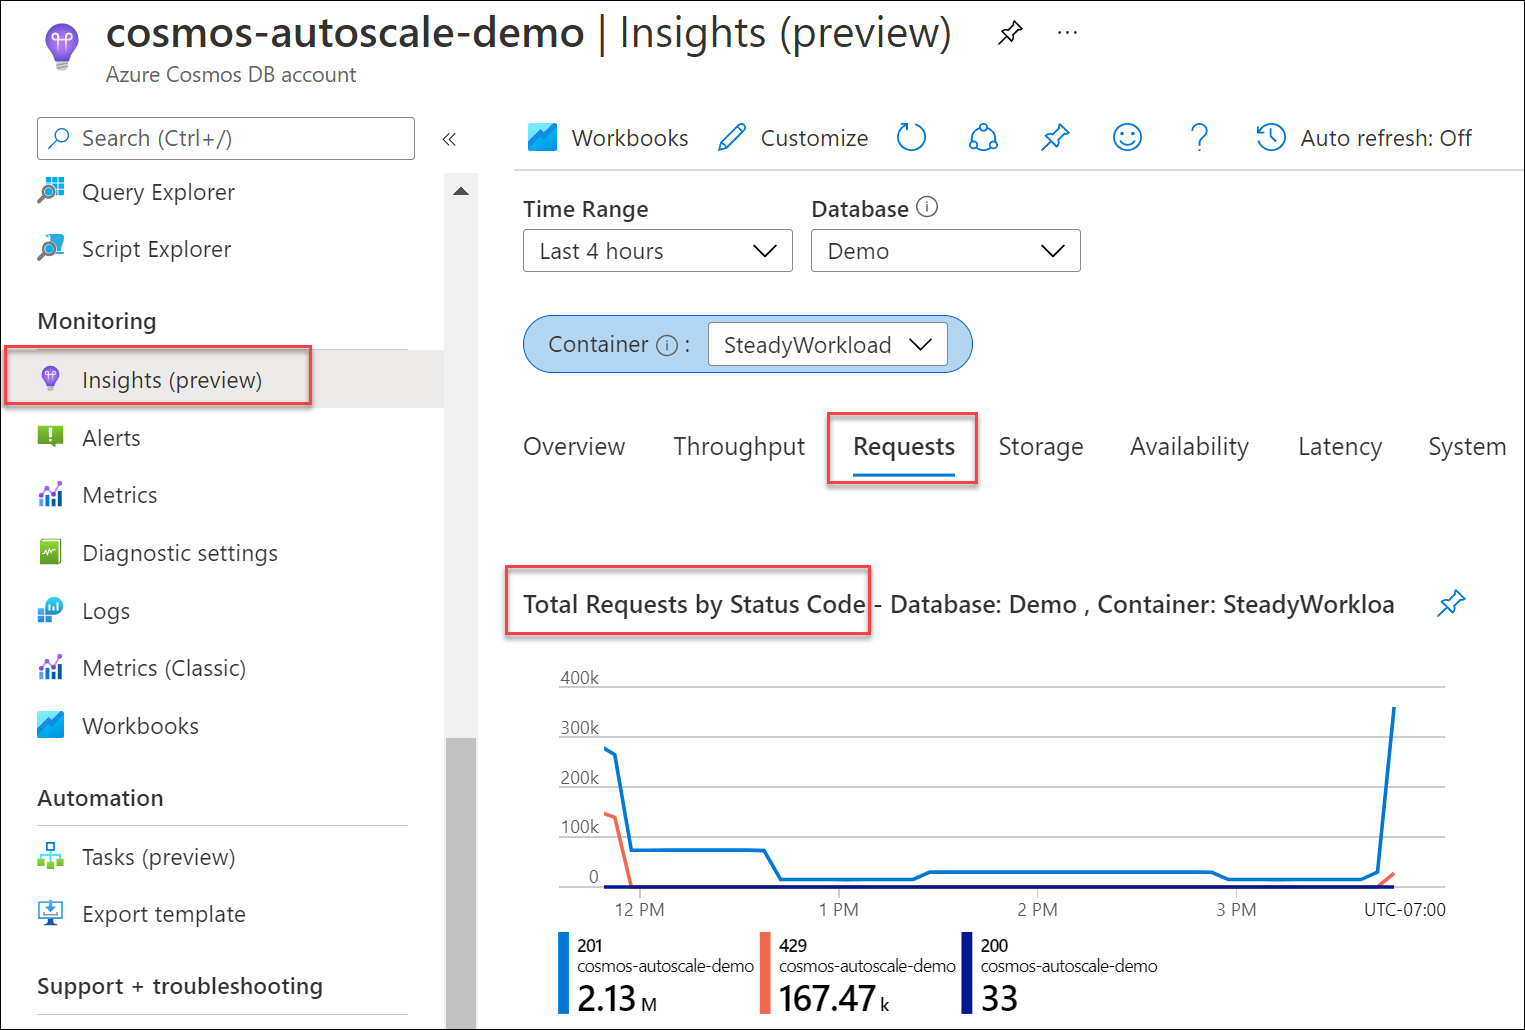
Pokud je normalizovaná metrika spotřeby RU konzistentně 100 % napříč několika rozsahy klíčů oddílů a míra 429s je větší než 5 %, doporučuje se zvýšit propustnost. Pomocí metrik služby Azure Monitor a diagnostických protokolů služby Azure Monitor můžete zjistit, které operace jsou náročné a jaké je jejich využití ve špičce. Informace o osvědčených postupech najdete v tématu Osvědčené postupy pro škálování zřízené propustnosti (RU/s).
Není to vždy případ, kdy se zobrazí chyba omezování rychlosti 429, jen proto, že normalizovaná RU dosáhla 100%. Je to proto, že normalizovaná RU je jedna hodnota, která označuje maximální využití napříč všemi rozsahy klíčů přiřazení. Jeden rozsah klíčů oddílu může být zaneprázdněný, ale jiné rozsahy klíčů oddílu mohou obsluhovat požadavky bez potíží. Například jedna operace, jako je uložená procedura, která plně využívá všechny RU/s v rozsahu klíče oddílu, vede ke krátkému nárazovému zvýšení metriky normalizované spotřeby RU. V takových případech nebudou žádné chyby omezující rychlost, pokud je celková frekvence požadavků nízká nebo jsou požadavky směřovány do jiných oddílů v různých rozsazích klíčů oddílů.
Další informace najdete v tématu Diagnostika a řešení potíží s výjimkami 429.
Jak monitorovat horké oddíly
Normalizovaná metrika spotřeby RU se dá použít k monitorování, jestli má vaše pracovní zátěž horký oddíl. Vznikne přehřátý oddíl, když jeden nebo několik logických klíčů oddílu spotřebovává nepřiměřenou část celkového počtu RU/s kvůli vysokému objemu požadavků. Příčinou může být návrh klíče oddílu, který nedistribuuje žádosti rovnoměrně. Výsledkem je, že mnoho požadavků se směruje na malou podmnožinu logických oddílů (což znamená rozsahy klíčů oddílů), které se stanou horkými. Vzhledem k tomu, že všechna data logického oddílu se nacházejí v jednom rozsahu klíčů oddílu a celkový počet RU/s je rovnoměrně rozdělený mezi všechny rozsahy klíčů oddílů, může horký oddíl vést k 429s a neefektivnímu využití propustnosti.
Identifikace horkého oddílu
Pokud chcete ověřit, jestli existuje horký oddíl, přejděte do části Insights>Propustnost>Normalizovaná spotřeba RU (%) podle PartitionKeyRangeID. Vyfiltrujte konkrétní databázi a kontejner.
Každý PartitionKeyRangeId se mapuje na jeden fyzický oddíl. Pokud existuje jeden „PartitionKeyRangeId“, který má vyšší normalizovanou spotřebu RU než ostatní (například jeden je konzistentně na 100%, ale ostatní jsou na 30% nebo méně), může to být známka toho, že se jedná o horký oddíl.
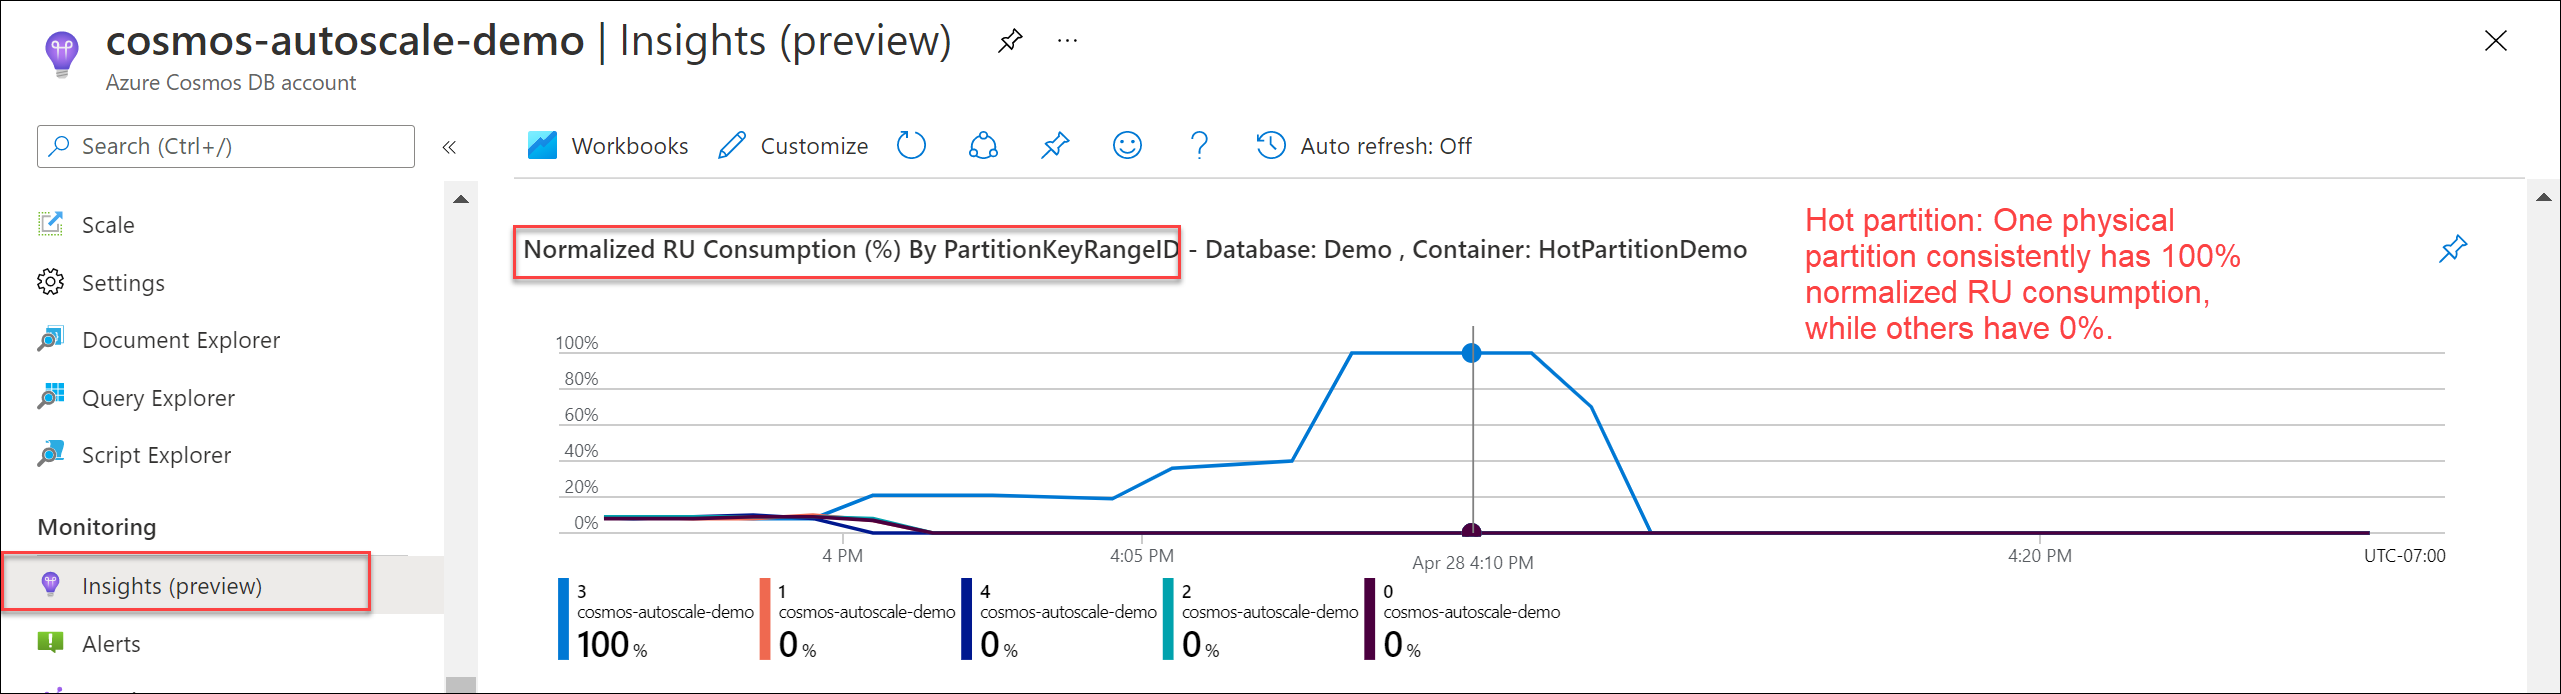
Pokud chcete identifikovat logické oddíly, které spotřebovávají nejvíce RU/s, přečtěte si, jak identifikovat horký oddíl.
Normalizovaná spotřeba RU a automatické škálování
Normalizovaná metrika spotřeby RU se zobrazí jako 100%, pokud jakýkoli rozsah klíčů oddílu využije všechny přidělené RU/s v libovolné sekundě v rámci časového intervalu. Jednou z běžných otázek je, proč je normalizovaná spotřeba RU na 100 %, ale Azure Cosmos DB nerostla RU/s na maximální propustnost pomocí automatického škálování?
Note
Následující informace popisují aktuální implementaci automatického škálování a můžou se v budoucnu změnit.
Když používáte automatické škálování, Azure Cosmos DB škáluje ru/s pouze na maximální propustnost, pokud je normalizovaná spotřeba RU 100 % pro trvalou nepřetržitou dobu v 5sekundovém intervalu. Tím se zajistí, aby logika škálování byla pro uživatele nákladově přívětivá, protože zajišťuje, že jednorázové špičky v momentální špičce nevedou k zbytečným škálováním a vyšším nákladům. Pokud dojde k momentální špičce, systém obvykle dynamicky zvýší kapacitu na vyšší hodnotu než dříve dosaženou v RU/s, ale nižší než maximální hodnota RU/s.
Představte si například, že máte kontejner s maximální propustností autoscale 20 000 RU/s (škálovaná mezi 2000–20 000 RU/s) a dvěma rozsahy klíčů pro oddíly. Každý rozsah klíčů oddílu se může škálovat mezi 1 000 až 10 000 RU/s. Protože automatické škálování zřizuje všechny požadované prostředky předem, můžete kdykoli použít až 20 000 RU/s.
Teď řekněme, že máte občasnou špičku provozu:
Během jedné sekundy vzroste Partice 1 na 10 000 RU/s, poté klesne na 1 000 RU/s na následující čtyři sekundy.
Oddíl 2 najednou dosáhne hodnoty 8 000 RU/s a poté následující čtyři sekundy klesne na 1 000 RU/s.
Takto se metriky chovají:
Normalizovaná spotřeba RU (která ukazuje maximální využití v intervalu napříč všemi partícemi) ukazuje 100% využití, protože partice 1 dosáhla svého maxima během jedné sekundy.
Zřízené metriky propustnosti a metriky RU s automatickým škálováním se ale neškálí na maximální počet RU/s jenom kvůli 1sekundovým špičkám. Škáluje se na základě 5sekundového intervalu, aby byl nákladově efektivní. V předchozím příkladu tedy spotřeba jednotek 1 a 2 RU nedosáhne 10 000 RU/s na základě 5sekundového intervalu.
V důsledku toho, i když automatické škálování nedosáhlo svého maxima, stále jste byli schopni využít celý dostupný počet RU/s pro ten výkyvový okamžik. Pokud chcete ověřit spotřebu RU/s, můžete použít volitelnou funkci diagnostických protokolů k dotazování na celkovou spotřebu RU/s na úrovni sekund napříč všemi rozsahy klíče oddílu.
CDBPartitionKeyRUConsumption
| where TimeGenerated >= (todatetime('2022-01-28T20:35:00Z')) and TimeGenerated <= todatetime('2022-01-28T20:40:00Z')
| where DatabaseName == "MyDatabase" and CollectionName == "MyContainer"
| summarize sum(RequestCharge) by bin(TimeGenerated, 1sec), PartitionKeyRangeId
| render timechart
** Obecně řečeno, pokud u produkčního zatížení s využitím automatického škálování uvidíte mezi 1 až 5% požadavků s chybou 429 a celková latence je přijatelná, znamená to, že RU/s jsou plně využity. I když normalizovaná spotřeba RU občas dosáhne 100% a automatické škálování se neškálí na maximální počet RU/s, je to v pořádku, protože celková míra 429s je nízká. Není vyžadována žádná akce.
Tip
Pokud používáte automatické škálování a zjistíte, že normalizovaná spotřeba RU je konzistentně 100% a konzistentně se škáluje na maximální počet RU/s, je to znamení, že použití ruční propustnosti může být nákladově efektivnější. Pokud chcete zjistit, jestli je pro vaši úlohu nejvhodnější automatické škálování nebo ruční propustnost, přečtěte si, jak si vybrat mezi standardní (ruční) a zřízenou propustností automatického škálování. Azure Cosmos DB také odesílá doporučení k nákladům na základě vzorů úloh, které doporučují propustnost ručního nebo automatického škálování.
Zobrazení metriky normalizované spotřeby jednotek žádosti
Přihlaste se do Azure Portalu.
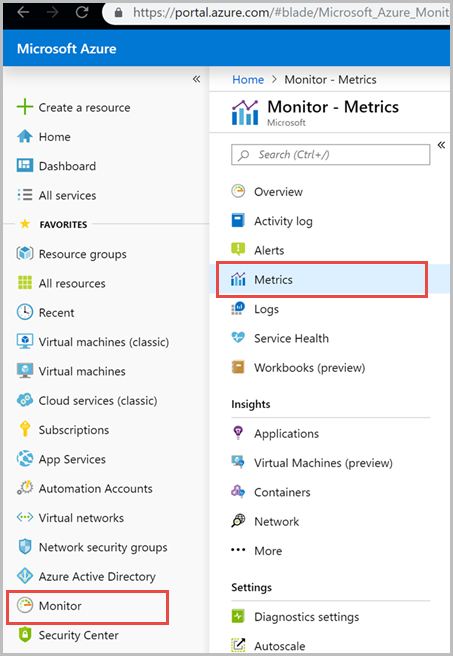
V levém navigačním panelu vyberte Monitorování a vyberte Metriky.
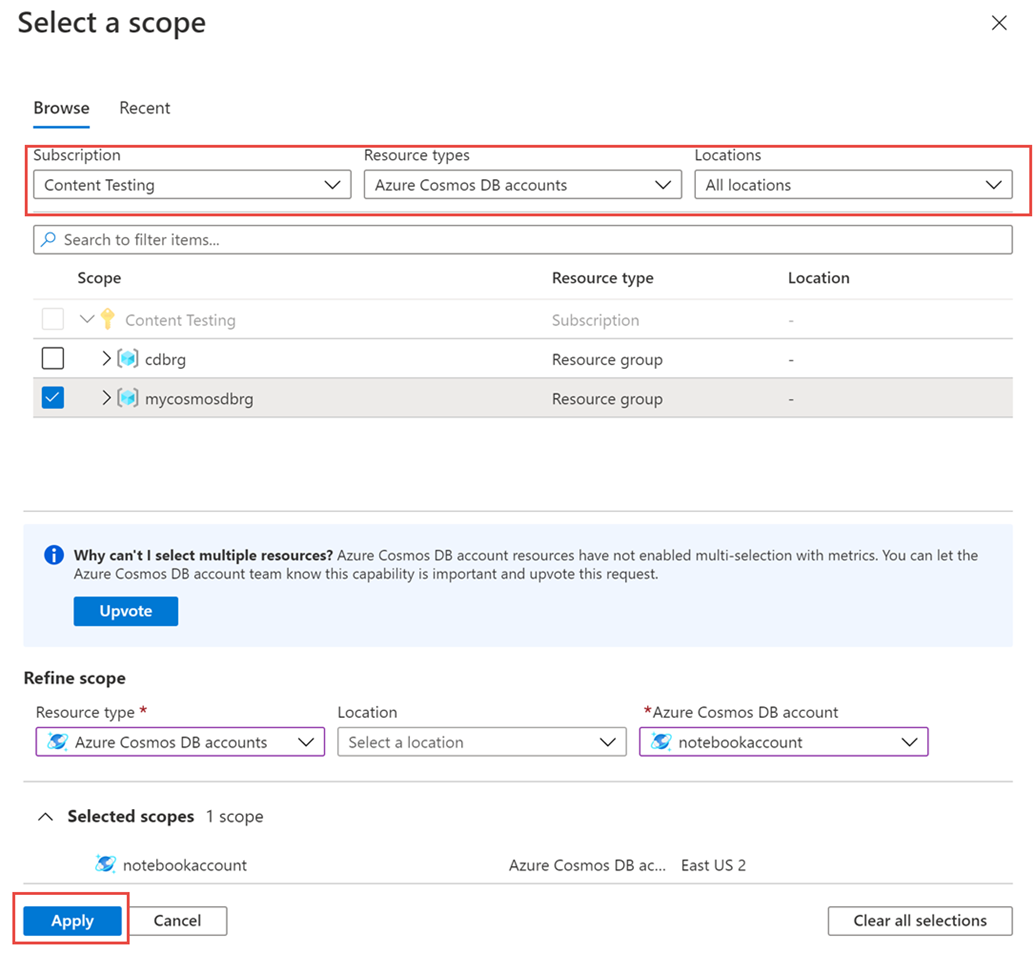
Z podokna Metrek vyberte požadovaný >, vyberte požadované předplatné a >. Jako typ prostředku vyberte účty Služby Azure Cosmos DB, zvolte jeden z existujících účtů služby Azure Cosmos DB a vyberte Použít.
Dále můžete vybrat metriku ze seznamu dostupných metrik. Můžete vybrat metriky specifické pro jednotky žádostí, úložiště, latenci, dostupnost, Cassandra a další. Podrobné informace o všech dostupných metrikách v tomto seznamu najdete v článku Metriky podle kategorií . V tomto příkladu vybereme metriku Normalizovaná spotřeba RU a jako hodnotu agregace zvolíme Max.
Kromě těchto podrobností můžete také vybrat časový rozsah a časové intervaly metrik. Maximálně můžete zobrazit metriky za posledních 30 dnů. Po použití filtru se na základě filtru zobrazí graf.
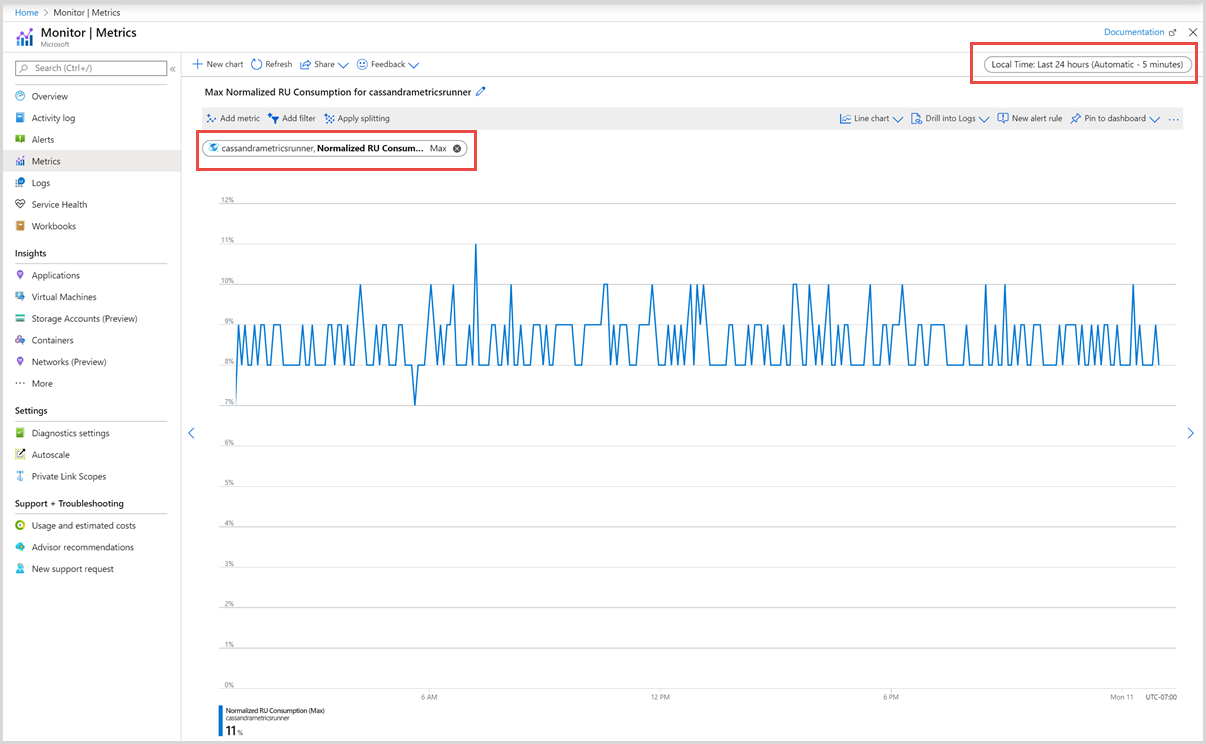


Filtry pro normalizovanou metriku spotřeby RU
Metriky a graf zobrazený také můžete filtrovat podle konkrétního názvu kolekce, DatabaseName, PartitionKeyRangeID a oblasti. Pokud chcete metriky filtrovat, vyberte Přidat filtr a zvolte požadovanou vlastnost, například CollectionName a odpovídající hodnotu, kterou vás zajímá. Graf pak zobrazí normalizovanou metriku spotřeby RU pro kontejner pro vybrané období.
Metriky můžete seskupit pomocí možnosti Použít rozdělení. U databází se sdílenou propustností se v normalizované metrice RU zobrazují data pouze v členitosti databáze, ale nezobrazují se žádná data na kolekci. U databáze se sdílenou propustností se proto při použití rozdělení podle názvu kolekce nezobrazí žádná data.
Normalizovaná metrika spotřeby jednotek žádosti pro každý kontejner se zobrazí, jak je znázorněno na následujícím obrázku:
