Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Azure Data Explorer (ADX) je plně spravovaná analytická platforma pro analýzu rozsáhlých telemetrických dat a dat protokolů v reálném čase. Tento článek vysvětluje, jak se ingestované náklady na GB vypočítají v Azure Data Exploreru, jaké faktory ho řídí a jak můžete optimalizovat cluster pro nákladovou efektivitu. Analytické platformy pro velké objemy dat používají různé cenové modely. Řada platforem vychází z cen na faktorech, jako jsou objem dotazů, příjem dat, doba trvání úložiště a výpočetní prostředky. Tato složitost znesnadňuje porovnání cen napříč produkty.
Tento článek vám pomůže porozumět nákladům na používání Azure Data Exploreru. V tomto článku se používá metrika náklady na GB ingestované. Tato metrika je celkové náklady na cluster (výpočetní prostředky, úložiště, sítě a značky služeb) vydělené celkovým objemem přijatých dat původní velikosti během tohoto období.
Reprezentativní snímek clusterů ADX v červnu 2025 se používá k vytvoření ukázkové analýzy. Následující části ukazují hlavní výsledky analýzy, vysvětlují, co řídí varianty nákladů a jak můžou uživatelé optimalizovat náklady na GB ingestované bez ohrožení výkonu.
Poznámka:
- Všechny údaje o nákladech v tomto článku zobrazují ceny podle ceníku a nezahrnují slevy ani úspory z důvodu závazků.
- Pro účely této ukázkové analýzy se náklady na GB vyjadřují ve vzorových jednotkách nákladů (SCU), kde každá jednotka SCU představuje obecnou jednotku nákladů, například jeden cent v USA.
- Seznam cen a jejich výpočet najdete v cenové kalkulačce Azure Data Exploreru.
Náklady na ingestované analýzy GB
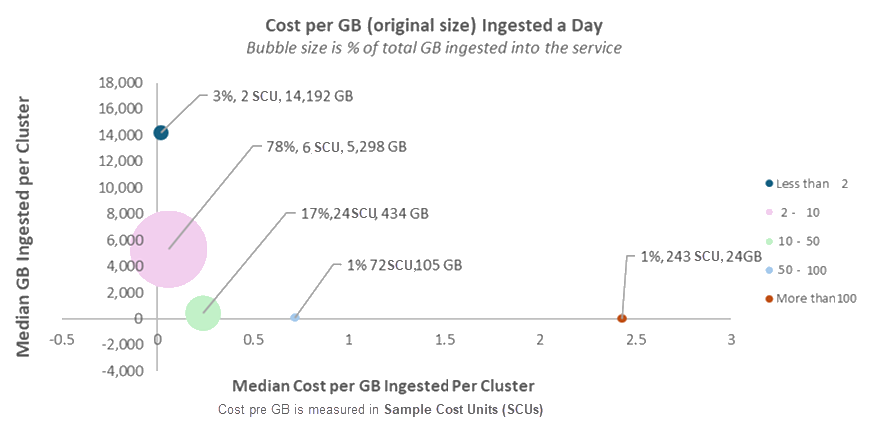
Následující graf ukazuje medián denně zpracovaných GB v původní velikosti (osa Y) v porovnání s mediánem nákladů na zpracovaný GB (osa X) pro každou skupinu nákladů. Velikost bublin představuje podíl skupiny celkových dat přijatých do služby.
Náklady na ingestované GB se v různých clusterech liší, ale vynikne několik vzorů:
Většina dat (>75%) se ingestuje za cenu mezi 2 a 10 SU na GB (před slevami).
Méně než 5% dat je ingestováno rychlostí méně než 2 SCU na GB.
I v rámci stejné kategorie využití (nebo "bubliny") se zobrazí významná variace. Například v největší bublině jeden cluster ingestuje při 2 SCU na GB, zatímco jiná dosáhne 10 SCU na GB. To je rozdíl 5X. Následující části vysvětlují klíčové důvody této varianty.
Clustery s vyššími náklady na GB jsou méně časté a obvykle mají nižší objemy vkládání dat. Obecně platí, že menší objemy dat znamenají vyšší náklady na GB.
Důležité
Bublinový graf ukazuje, že se náklady na ingestované GB v různých clusterech liší. Tato varianta neznačí dobré ani špatné postupy. Odráží různé scénáře, konfigurace a vzory použití pro službu.
Jeden cluster může například uchovávat data delší kvůli dodržování předpisů, což zvyšuje náklady na úložiště. Další možností je použít zásady aktualizace, které zpracovávají data během příjmu dat, což zvyšuje využití výpočetních prostředků. Tyto scénáře jsou záměrné volby návrhu v souladu s konkrétními cíli a přirozeně ovlivňují náklady na GB.
Co ovlivňuje náklady na ingesovaný GB
Za rozdíly v nákladech na GB přijatých na cluster jsou tyto klíčové faktory:
Doba trvání úložiště: Čím déle ukládáte data, tím vyšší jsou náklady. Viz zásady uchovávání informací.
Vysoké využití procesoru: Akce, jako jsou náročné dotazy, zpracování dat nebo transformace, způsobují vysoké využití procesoru.
Nastavení mezipaměti: Ukládání do mezipaměti zvyšuje výkon, ale může zvýšit náklady. Viz zásady mezipaměti.
Použití studených dat: Dotazy, které přistupují ke studeným datům, aktivují transakce čtení a zvyšují náklady. Podívejte se na horkou a studenou mezipaměť.
Transformace a optimalizace dat: Funkce, jako jsou zásady aktualizace, materializovaná zobrazení a dělení spotřebovávají prostředky procesoru a můžou zvýšit náklady. Viz zásady aktualizace, materializovaná zobrazení a oddíly.
Objem příjmu dat: Clustery pracují nákladově efektivněji s vyššími objemy příjmu dat.
Streamování vs. příjem dat ve frontě: Každý má jiný profil nákladů v závislosti na případu použití. Viz streamování a zařazeno do fronty.
Návrh schématu: Široké tabulky s mnoha sloupci potřebují více výpočetních prostředků a prostředků úložiště, což zvyšuje náklady.
Pokročilé funkce: Možnosti, jako jsou sledující, privátní koncové body a sandboxy Pythonu využívají více prostředků a můžou přidávat náklady.
Volba datového kanálu: Některé cesty příjmu dat stojí méně. Příjem Event Grid je například obvykle levnější než Event Hubs.
Automatické škálování: Clustery bez automatického škálování často stojí více, protože neupravují jejich velikost na základě poptávky.
Většinu těchto faktorů můžete nakonfigurovat pro optimalizaci výkonu i nákladů.
Bližší pohled na klíčové obchodní faktory nákladů
Tato část popisuje klíčové faktory, které ovlivňují náklady na GB ingestované v Azure Data Exploreru a poskytují přehled o tom, jak tyto náklady spravovat a optimalizovat.
Dopad uchovávání dat na náklady
V ADX jsou všechna ingestovaná data uložená v trvalém úložišti. Každá tabulka a materializované zobrazení mají zásady uchovávání informací , které definují, jak dlouho se data uchovávají. Čím déle se data uchovávají, tím vyšší jsou náklady na základě cen služby Azure Storage. Pokud potřebujete dlouhodobé úložiště, například kvůli dodržování předpisů, se náklady na ingestované GB zvýší, protože zahrnují průběžné náklady na úložiště.
Kromě rozsahu hlášeného clusterem existují dva další faktory nákladů:
- Vyrovnávací paměť uchování: Ve výchozím nastavení se ukládá dalších 7 dnů dat, aby se chránila před náhodnými ztrátami dat.
- Režie na obnovitelnost: U tabulek, ve kterých je povolené nastavení obnovitelnosti (výchozí), se data uchovávají po dobu dalších 14 dnů. To zahrnuje zprostředkující objekty blob vygenerované během operací sloučení a opětovného sestavení.
Velikost clusteru
Velikost clusteru je počet počítačů (uzlů) v clusteru. Každý počítač přidává náklady v závislosti na typu (SKU). Automatické škálování upraví velikost clusteru na základě využití procesoru, aby systém mohl optimalizovat náklady a výkon tím, že se vyhne nečinným nebo redundantním prostředkům.
Automatické škálování upraví velikost clusteru, aby se zajistilo, že se data uložená v mezipaměti vejdou do dostupného prostoru SSD. V důsledku toho může velká mezipaměť zvýšit velikost clusteru a pokud je využití procesoru nízké, může to vést k vyšším nákladům na GB. Další informace o optimalizaci velikosti mezipaměti najdete v nástroji Přehled clusterů na kartě Mezipaměť.
Clustery, které spouštějí mnoho dotazů nebo dělají úlohy náročné na procesor, jako jsou materializovaná zobrazení, zásady aktualizace nebo dělení, můžou cluster škálovat a zvýšit náklady na GB. Mějte na paměti, že tyto funkce můžou výrazně zvýšit výkon dotazů a snížit využití procesoru dotazů a zlepšit tak celkovou efektivitu.
Objem přijatých dat
S růstem clusteru se přidává více uzlů, což zvyšuje celkové náklady. Náklady jsou rozložené mezi všechna ingestovaná data, takže čím více dat ingestujete, tím nižší jsou náklady na GB.
Využití studených dat
Když dotazy často přistupují k studeným datům uloženým na disku, způsobují transakce čtení, které využívají více prostředků, a můžou zvýšit celkové náklady na cluster.
Streamování vs. příjem dat ve frontě
Každá metoda příjmu dat má různé charakteristiky nákladů, latence a funkčnosti, takže každá z nich je pro různé scénáře lepší. Z hlediska nákladů je streaming ingestion levnější, když ingestujete mnoho malých tabulek s pozvolně přicházejícími daty, zatímco queued ingestion je nákladově efektivnější pro velké tabulky.
Návod
Optimalizace nákladů na ingestované GB
Zkontrolujte konfigurace klíčových ovladačů nákladů a ujistěte se, že odpovídají potřebám vašeho clusteru a požadavkům na služby pro zajištění efektivity. Zejména:
- Minimalizujte dotazy nad studenými daty, abyste snížili počet transakcí čtení.
- Povolte automatické škálování tak, aby dynamicky odpovídalo velikosti clusteru podle poptávky.