Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Migrujte úlohy z klasického výpočetního prostředí na bezserverové výpočetní prostředky. Bezserverové výpočetní prostředky zpracovávají zřizování, škálování, upgrady za běhu a optimalizaci automaticky.
Většina klasických úloh se dá migrovat s minimálními změnami kódu nebo bez nich. Tato stránka se zaměřuje na tyto úlohy. Některé funkce, například df.cache, ještě nejsou podporovány na bezserverové, ale nebudou vyžadovat změny kódu, jakmile budou k dispozici. Některé úlohy, které závisí na poznámkových blocích R nebo Scala, vyžadují klasické výpočetní prostředky a nebudou moct migrovat na bezserverovou architekturu. Úplný seznam aktuálních omezení najdete v tématu Omezení bezserverového výpočetního prostředí.
Migrujte s migračním agentem
Important
Tato funkce je v beta verzi. Správci pracovního prostoru jej mohou povolit ze stránky Previews tím, že se přihlásí do náhledu Compute Agenta . Viz Manage Azure Databricks preview.
K migraci jednoho notebooku nebo úlohy do bezserverového výpočetního prostředí můžete použít migračního agenta. Agent přezkoumá prostředí pracovní zátěže, knihovny, konfigurace Sparku, tagy a kód a poté každou změnu navrhne jako individuální návrh, který můžete přijmout nebo odmítnout. Přijaté změny jsou aplikovány na místě a lze je vrátit zpět.
Co agent kontroluje a mění
| Area | Co agent dělá |
|---|---|
| Prostředí a knihovny | Převádí instalace knihoven do specifikace serverless prostředí, včetně instalací %pip, inicializačních skriptů clusteru, knihoven clusteru v úlohách a odkazů na soukromý index balíčků. |
| Proměnné prostředí | Převádí proměnné prostředí clusteru do jejich serverless ekvivalentů, zachovává odkazy na tajné informace pracovního prostoru a vynechává hodnoty spravované platformou. |
| Přístup k datům a úložišti | Přepisuje cesty nekompatibilní se serverless, jako jsou lokální disk, dbfs:/ a připojené cesty, na svazky Unity Catalog. Agent automaticky provádí jednoznačné přepisy a žádá vás, abyste si vybrali svazek, pokud je cíl nejasný. |
| Konfigurace Sparku | Klasifikuje každou konfiguraci Sparku, komentuje konfigurace, které je bezpečné zrušit, a označuje a odstraňuje konfigurace, které serverless nepodporuje. Zahrnuje jak konfigurace připojené ke clusteru, tak konfigurace v notebooku. |
| Kód pracovní zátěže | Přepisuje kód, který serverless nepodporuje, na kompatibilní ekvivalenty, například RDD operace přepsané do DataFrame operací, a upravuje kód pro chování SQL v ANSI režimu na serverless. |
| Štítky | Překládá vlastní clusterové tagy, například cost-center tag, na jejich serverless ekvivalenty. |
| Výkonnostní režim | Navrhuje režim výkonu založený na konfiguraci clusteru. Viz Volba režimu výkonu. |
Požadavky
Doporučuje se administrátorský přístup pracovního prostoru, aby byla zajištěna úplná migrace. Je to proto, že agent také kontroluje globální init skripty na úrovni pracovního prostoru nad rámec cílové zátěže. Možná budete moci migrovat, pokud máte
CAN MANAGEoprávnění k zátěži, ale bez administrátorských oprávnění to může vést k chybějícím knihovnám, nastavení prostředí nebo tagům.Potvrďte, že máte přístup k agentovi. Zadejte
/computev Genie Code./computeMělo by se objevit v menu automatického doplňování. Pokud se nezobrazí, správce pracovního prostoru musí ve vašem pracovním prostoru povolit náhled.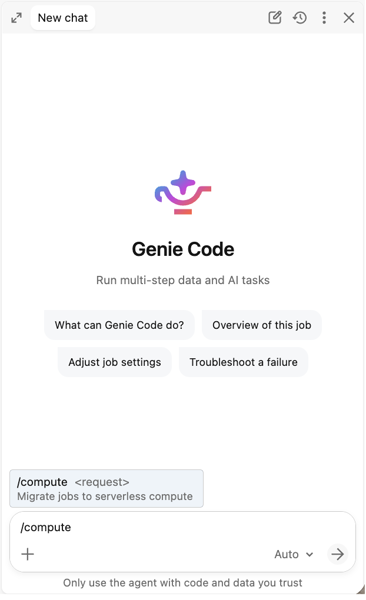
Migrace poznámkového bloku
- Otevřete zápisník, který chcete přestěhovat.
- Otevřete Genie Code a spusťte
/compute migrate to serverlessz příkazové palety/. - Projděte zjištění agenta. Agent prohledává prostředí, knihovny a kód zápisníku a navrhuje změnu pro každou položku, která ji potřebuje, například přesun instalace knihovny do specifikace prostředí nebo přepsání kódové buňky tak, aby běžela na serverless.
- Přijměte nebo odmítněte každou navrhovanou změnu.
- Aplikujte změny, které jste přijali. Jsou zapsány do sešitu přímo na místě.
- Připojte notebook k serverless a spusťte ho, abyste potvrdili, že se chová podle očekávání. Viz Ověřování migrované pracovní zátěže.
Migrujte práci
- Otevřete práci, kterou chcete přestěhovat.
- Otevřete Genie Code a spusťte
/compute migrate to serverlessz příkazové palety/. - Agent vytvoří klon vaší úlohy a pokusí se migrovat naklonovanou úlohu do bezserverového prostředí.
- Projděte zjištění agenta. Pro multitaskovou úlohu agent vyjmenovává každou úlohu a její konfiguraci clusteru pro jednotlivé úlohy a navrhuje změny pro každou z nich, přičemž zachová harmonogram dané úlohy.
- Přijměte nebo odmítněte každou navrhovanou změnu na migrační ploše: prostředí a knihovny, konfigurace Spark a jakýkoli kód pracovní zátěže, který se musí změnit.
- Aplikujte změny, které jste přijali. Výpočetní prostředky úlohy jsou přepnuty do režimu serverless.
- Spusť úlohu v prostředí serverless a ověř výsledky. Viz Ověřování migrované pracovní zátěže.
- Volitelně, jako poslední krok, agent propaguje migrovaný klon. Zkopíruje konfiguraci klonu a zápisníky zpět na původní práci (zachová stejné ID práce, rozvrh a oprávnění), pak klon smaže. Pokud přeskočíte nasazení a ponecháte obě úlohy, pozastavte plánování u té úlohy, kterou právě nespouštíte, jinak stejný spouštěč aktivuje obě a může dojít k duplicitním zápisům nebo jiným vedlejším účinkům.
Ověřit migrovanou pracovní zátěž
Agent navrhuje a aplikuje změny, ale nespouští vaši pracovní zátěž ani neověřuje její výstup. Vždy spusťte migrovanou pracovní zátěž na serverless a ověřte výsledky, než se na ni spoléháte, zvlášť u zátěží, které zapisují do produkčních tabulek. Pokud agent navrhne změnu, která vypadá špatně, odmítněte ji a pošlete nám zpětnou vazbu, abychom agenta mohli vylepšit. Viz Odeslání zpětné vazby k produktu.
Tip
Zatímco ověřujete migrovanou pracovní zátěž, spusťte ji v režimu optimalizovaném pro výkon. Startuje rychleji než standardní režim, takže při potvrzení výsledků dostanete rychlejší zpětnou vazbu. Před spuštěním v produkci přepněte na režim, který nejlépe vyhovuje zátěži. Viz Volba režimu výkonu.
Když agent najde něco, co nemůže bezpečně migrovat, nahlásí blokující problém a standardně se zastaví. Můžete mu explicitně nařídit, aby přešel přes některé blokátory kompatibility nebo závislostí, ale tím riskujete, že tyto závislosti, atribuce nákladů nebo chování za běhu se nepřenesou a workload může selhat na serverless.
Vrátit zpět změny migrace
Změny, které agent uplatní, jsou vratné.
U zápisníku ho otevřete a obnovte verzi z doby těsně před migrací. Viz Historie verzí v poznámkových blocích Databricks.
U úkolu, pokud jste nepropagovali migrovaný klon, vaše původní práce se nikdy nezměnila: spusťte ji jako dříve a smažte klon. Pokud jste klon povýšili, obnovte jej ze zálohy, kterou agent vytvořil předtím, než provedl jakékoli změny:
- Otevřete zálohovací složku ve svém pracovním prostředí Home:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Agent tuto cestu ukázal během migrace. Pokud je několik časových značek, vyberte tu těsně před migrací. - Otevřete
job.yaml, které obsahuje nastavení úlohy před migrací, a použijte tato nastavení znovu na tutéž úlohu pomocí požadavkuPOST /api/2.2/jobs/reset, který přepíše nastavení úlohy hodnotami, které zadáte. Můžete je také vložit do JSON definice práce v uživatelském rozhraní. Tím se vrací práce ke klasickému výpočetnímu režimu. - Open
mapping.yaml, který uvádí každý zálohovaný soubor a původní cestu, odkud pochází. Každý záložní soubor zkopírujte zpět přes původní cestu, abyste zrušili přepisy kódu. - Spusť úkol, abys potvrdil, že se chová stejně jako před migrací.
Migrace tuto zálohu nikdy nesmaže. Úlohy, které agent neupravil, například úlohy pocházející z Gitu, SQL nebo dbt úlohy, jsou zaznamenány v job.yaml, ale jejich soubory se do zálohy nekopírují, takže je v případě potřeby obnovte ze svého „source of truth“.
Známá omezení
- Jako blokátory jsou hlášeny následující položky: vlastní image, varianty prostředí ML Runtime, verze Databricks Runtime starší než 13, konfigurace Sparku, které nelze v prostředí serverless bezpečně ignorovat, a závislosti, jako jsou egg balíčky, soubory JAR a knihovny Maven. Blokátor znamená, že se agent zastaví, místo aby migroval danou položku. Můžete to buď vyřešit sami a migraci spustit znovu, nebo říct agentovi, aby migroval, což tu položku nechá nevyřešenou a může způsobit selhání zátěže na serverless.
- Agent čte init skripty uložené v pracovních souborech nebo svazcích Unity Catalog. Init skripty uložené v ABFSS nebo DBFS nelze číst a jsou hlášeny jako blokátory.
- Agent nekontroluje každý klasický výpočetní atribut. Cluster log delivery a SSH klíče nejsou modelovány a i když detekuje mnoho závislostí DBFS mountů z kódu zátěže, nevyjmenovává ani neřeší každý mount.
- Cache a checkpoint API, globální dočasné pohledy, DBFS volání pro správu mountů a kód Scala nebo R jsou ve výchozím nastavení tvrdé blokátory. Můžete agentovi nařídit, aby pokračoval, ale nevyřešená funkčnost zůstane nezměněná a může selhat i na serverless.
- Pracovní pozice s více než 10 migrovatelnými úkoly nelze v současnosti migrovat.
- Agent migruje jednu pracovní zátěž najednou. Neexistuje zjišťování v rámci celé flotily, hromadná migrace ani pracovní postup schvalování administrátorem.
- Agent navrhuje změny a aplikuje ty, které přijmete, ale neprovádí vaši pracovní zátěž ani nekontroluje správnost výstupu. Ověřte migrované pracovní zatížení, než se na něj spoléhate pro produkční data.
- Pokud je zdrojem pravdy vašeho workloadu Databricks Asset Bundle nebo složka Git, agent aplikuje změny na aktuální objekt pracovního prostoru. Slaďte tyto změny s balíčkem nebo repozitářem, aby pozdější nasazení migraci nepřepsalo.
Ruční migrace na serverless
Pokud chcete migrovat úlohy z klasického výpočetního prostředí na bezserverové výpočetní prostředky, postupujte takto:
- Zkontrolujte požadavky: Ověřte, že váš pracovní prostor, sítě a přístup ke cloudovému úložišti splňují požadavky. Viz Než začnete.
- Aktualizovat kód: Proveďte potřebné změny kódu a konfigurace. Viz Aktualizace kódu.
- Otestujte své úlohy: Ověřte kompatibilitu a správnost před přechodem. Viz Testování úloh.
- Zvolte režim výkonu: Vyberte režim výkonu, který nejlépe odpovídá vašim požadavkům na úlohy. Viz Volba režimu výkonu.
- Migrace ve fázích: Postupné zavádění bezserverových úloh, počínaje novými a nízkými riziky Viz Migrace ve fázích.
- Monitorování nákladů: Sledování spotřeby serverless DBU a nastavení upozornění. Viz Monitorování nákladů.
Než začnete
Než začnete s migrací, možná budete muset aktualizovat některé starší konfigurace v pracovním prostoru.
| Předpoklad | Action | Podrobnosti |
|---|---|---|
| Pracovní prostor je aktivován pro katalog Unity. | Migrace z Hive Metastore v případě potřeby | Upgradujte pracovní prostor Azure Databricks na Unity Catalog |
| Nakonfigurované sítě | Nahrazení párování VPC pomocí NCC, Private Link nebo pravidel brány firewall | Síťování výpočetní roviny bez serveru |
| Přístup ke cloudovému úložišti | Nahrazení starších vzorů přístupu k datům externími umístěními katalogu Unity | Připojte se ke cloudovému úložišti objektů pomocí katalogu Unity |
Ověřte, že je váš pracovní prostor v podporované oblasti.
Aktualizace kódu
Následující části obsahují seznam změn kódu a konfigurace potřebných k tomu, aby vaše úlohy byly kompatibilní s bezserverovou architekturou.
Přístup k datům
Vzory přístupu ke starším verzím dat nejsou podporovány v bezserverové verzi. Aktualizujte kód tak, aby místo toho používal katalog Unity.
| Klasický vzor | Bezserverová výměna | Podrobnosti |
|---|---|---|
Cesty DBFS (dbfs:/...) |
Svazky katalogu Unity | Co jsou svazky katalogu Unity? |
| Tabulky Hive Metastore | Tabulky katalogu Unity (nebo federace HMS) | Upgradujte pracovní prostor Azure Databricks na Unity Catalog |
| Přihlašovací údaje účtu úložiště | Externí umístění katalogu Unity | Připojte se ke cloudovému úložišti objektů pomocí katalogu Unity |
| JDBC vlastní JARy | Lakehouse Federace | Co je federace dotazů? |
Výstraha
Přístup k DBFS je omezený na bezserverové prostředí. Před migrací aktualizujte všechny dbfs:/ cesty ke svazkům Unity Catalogu. Další informace naleznete v tématu Migrace souborů uložených v DBFS.
Příklad: Nahrazení cest DBFS a odkazů na metastore Hive
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
Rozhraní API a kód
Některá rozhraní API a vzory kódu nejsou na bezserverové platformě podporována. Na tuto tabulku se můžete podívat, jestli je potřeba aktualizovat kód.
| Klasický vzor | Bezserverová výměna | Podrobnosti |
|---|---|---|
Rozhraní RDD API (sc.parallelize, rdd.map) |
Rozhraní API datového rámce | Porovnání Spark Connect s klasickým Sparkem |
df.cache(), df.persist() |
Odebrání volání do mezipaměti | Omezení výpočetních prostředků bez serveru |
spark.sparkContext, sqlContext |
Použijte přímo spark (SparkSession) |
Porovnání Spark Connect s klasickým Sparkem |
Proměnné Hive (${var}) |
Sql DECLARE VARIABLE nebo Python f-string |
DECLARE VARIABLE |
| Nepodporované konfigurace Sparku | Odeberte nepodporované konfigurace. Bezserverová technologie většinu nastavení automaticky ladí. | Konfigurace vlastností Sparku pro bezserverové poznámkové bloky a úlohy |
Příklad: Nahrazení operací RDD datovými rámci
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Příklad: Nahrazení SparkContext a ukládání do mezipaměti
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Knihovny a prostředí
Knihovny a prostředí můžete spravovat na úrovni pracovního prostoru pomocí základních prostředí a na úrovni poznámkového bloku pomocí jeho bezserverového prostředí.
| Klasický vzor | Bezserverová výměna | Podrobnosti |
|---|---|---|
| Inicializační skripty | Bezserverová prostředí | Konfigurace bezserverového prostředí |
| Knihovny v rámci clusteru | Knihovny příslušející poznámkovým blokům nebo prostředím | Konfigurace bezserverového prostředí |
| Knihovny Maven/JAR | Podpora úkolů JAR pro úlohy; PyPI pro poznámkové bloky | Úloha JAR pro pracoviště úloh |
| Docker kontejnery | Bezserverová prostředí pro potřeby knihovny | Konfigurace bezserverového prostředí |
Připnutí balíčků Python v requirements.txt pro reprodukovatelná prostředí. Viz Zadejte verze balíčků Python.
Streamování
Úlohy streamování se podporují v bezserverové verzi, ale některé triggery se nepodporují. Aktualizujte kód tak, aby používal podporované triggery.
| Trigger Sparku | Podporováno | Poznámky |
|---|---|---|
Trigger.AvailableNow() |
Ano | Doporučený |
Trigger.Once() |
Ano | Toto je zastaralé. Místo toho použijte Trigger.AvailableNow(). |
Trigger.ProcessingTime(interval) |
Ne | Návrat INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
Ne | Místo toho používejte průběžný režim kanálů Lakeflow. |
Výchozí (nenastaví se .trigger()) |
Ne | Vynechání .trigger() výchozí na ProcessingTime("0 seconds"), což není podporováno na serverless. Vždy nastavte .trigger(availableNow=True) explicitně. |
Pro průběžné streamování migrujte do deklarativních kanálů Sparku v průběžném režimu nebo používejte úlohy průběžného plánování s AvailableNow. U velkých zdrojů nastavte maxFilesPerTrigger nebo maxBytesPerTrigger, aby se zabránilo chybám nedostatku paměti.
Příklad: Oprava triggerů streamování
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testování úloh
- Rychlý test kompatibility: Spusťte úlohu na klasických výpočetních prostředcích s režimem přístupu Standard a Modulem Databricks Runtime 14.3 nebo novějším. Pokud je spuštění úspěšné, může úloha migrovat na bezserverovou beze změny kódu.
- Porovnání A/B (doporučeno pro produkční prostředí): Spusťte stejnou úlohu v klasickém prostředí (řízení) a bezserverovém prostředí (experiment). Porovnejte výstupní tabulky a ověřte jejich správnost. Iterujte, dokud se výstupy neshodují.
- Dočasné konfigurace: Během testování můžete dočasně nastavit podporované konfigurace Sparku. Odeberte je, jakmile budou stabilní.
Volba režimu výkonu
Bezserverové úlohy a kanály podporují dva režimy výkonu: standardní a optimalizované pro výkon. Zvolený režim výkonu závisí na vašich požadavcích na úlohy.
| Mode | dostupnost | Startup | Nejvhodnější pro |
|---|---|---|---|
| Standard | Úlohy, kanály Lakeflow | 4–6 minut | Dávka citlivá na náklady |
| Optimalizované pro výkon | Poznámkové bloky, úlohy, kanály Lakeflow | Sekundy | Interaktivní, latence citlivá |
Migrace ve fázích
- Nové úlohy: Spusťte všechny nové poznámkové bloky a úlohy na bezserverové platformě.
- Úlohy s nízkým rizikem: Migrace úloh PySpark/SQL již ve standardním režimu přístupu a modulu Databricks Runtime 14.3 nebo novějším
- Složité úlohy: Migrace úloh vyžadujících změny kódu (přepsání RDD, aktualizace DBFS, opravy triggerů)
- Zbývající úlohy: Pravidelně kontrolujte, jak se možnosti rozšiřují.
Monitorování nákladů
Bezserverová fakturace je založená na spotřebě DBU, nikoli na provozu clusteru. Před migrací ve velkém měřítku ověřte očekávání nákladů pomocí reprezentativních úloh. Nástroje a strategie pro monitorování nákladů bez serveru najdete v tématu Monitorování nákladů na bezserverové výpočetní prostředky.
Dodatečné zdroje
- Osvědčené postupy pro bezserverové výpočetní prostředky: Tipy pro optimalizaci bezserverových úloh
- Bezserverová omezení výpočetních prostředků: Úplný seznam aktuálních omezení a nepodporovaných funkcí
- Konfigurace bezserverového prostředí: Správa knihoven a závislostí
- Podporované konfigurace Sparku: Konfigurace Sparku dostupné na bezserverovém prostředí
- Spark Connect vs. classic Spark: Rozdíly v chování v bezserverové architektuře
- zabezpečení sítě Serverless: síťové adaptéry, Private Link a konfigurace brány firewall
- Poznámky k verzi bezserverového výpočetního prostředí: Sledování nových funkcí při jejich dodávání
- Průvodce upgradem katalogu Unity: Migrace z metastoru Hive do katalogu Unity
Další informace najdete také v následujících blogových příspěvcích:
- Co je bezserverová architektura?: Přehled funkcí bez serveru a výsledků zákazníků
- Vývoj datového inženýrství: Jak bezserverová výpočetní řešení transformují poznámkové bloky a úlohy Lakeflow: Jak bezserverové výpočty pohání úlohy a kanály Lakeflow