Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
HDInsight poskytuje elasticitu s možnostmi škálování nahoru a dolů, pokud jde o počet pracovních uzlů ve vašich clusterech. Tato elasticita umožňuje zmenšit cluster po pracovní době nebo o víkendech. A rozšiřte ho během období největšího pracovního vytížení.
Rozšiřte kapacitu clusteru před pravidelným dávkovým zpracováním, aby měl dostatek prostředků. Po dokončení zpracování a snížení využití můžete vertikálně snížit kapacitu clusteru HDInsight na méně pracovních uzlů.
Cluster můžete škálovat ručně pomocí jedné z následujících metod. Možnosti automatického škálování můžete také použít k automatickému vertikálnímu navýšení a snížení kapacity v reakci na určité metriky.
Poznámka:
Podporují se pouze clustery s HDInsight verze 3.1.3 nebo vyšší. Pokud si nejste jisti verzí clusteru, můžete zkontrolovat stránku Vlastnosti.
Nástroje pro škálování clusterů
Microsoft poskytuje následující nástroje pro škálování clusterů:
| Užitnost | Popis |
|---|---|
| PowerShell Az |
Set-AzHDInsightClusterSize
-ClusterName CLUSTERNAME -TargetInstanceCount NEWSIZE
|
| Azure CLI |
az hdinsight resize
--resource-group RESOURCEGROUP --name CLUSTERNAME --workernode-count NEWSIZE
|
| Azure Classic CLI | azure hdinsight cluster resize CLUSTERNAME NEWSIZE |
| Azure Portal | Otevřete podokno clusteru HDInsight, v nabídce vlevo vyberte Velikost clusteru , pak v podokně Velikost clusteru zadejte počet pracovních uzlů a vyberte Uložit. |
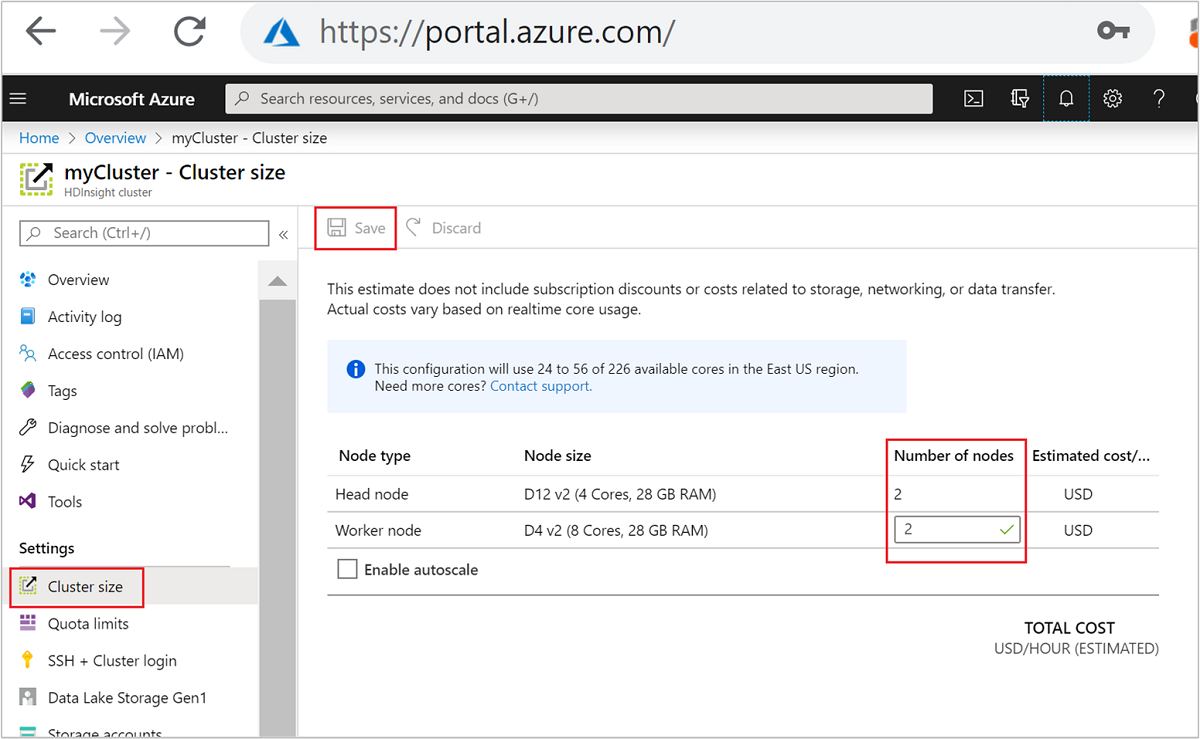
Pomocí některé z těchto metod můžete vertikálně navýšit nebo snížit kapacitu clusteru HDInsight během několika minut.
Důležité
Dopad operací škálování
Když přidáte uzly do spuštěného clusteru HDInsight (vertikální navýšení kapacity), úlohy zůstanou nedotčené. Nové úlohy je možné bezpečně odeslat, když je proces škálování spuštěný. Pokud operace škálování selže, váš cluster zůstane funkční.
Pokud odeberete uzly (vertikální snížení kapacity), čekající nebo spuštěné úlohy po dokončení operace škálování selžou. Příčinou této chyby je restartování některých služeb během procesu škálování. Cluster se může během ruční operace škálování zaseknout v nouzovém režimu.
Dopad změny počtu datových uzlů se u jednotlivých typů clusterů podporovaných službou HDInsight liší:
Apache Hadoop
Bez problémů můžete zvýšit počet pracovních uzlů ve spuštěném clusteru Hadoop, aniž by to mělo vliv na jakékoli úlohy. Nové úlohy je možné odeslat také během probíhající operace. Selhání v operaci škálování jsou řádně zpracována. Cluster zůstane vždy ve funkčním stavu.
Při vertikálním snížení kapacity clusteru Hadoop s menším počtem datových uzlů se některé služby restartují. Toto chování způsobí selhání všech spuštěných a čekajících úloh při dokončení operace škálování. Po dokončení operace však můžete úlohy znovu odeslat.
Apache HBase
Během běhu můžete do clusteru HBase bezproblémově přidávat nebo odebírat uzly. Regionální servery se automaticky vyrovnávají během několika minut od dokončení operace škálování. Místní servery ale můžete vyrovnávat ručně. Přihlaste se k hlavnímu uzlu clusteru a spusťte následující příkazy:
pushd %HBASE_HOME%\bin
hbase shell
balancer
Další informace o použití prostředí HBase naleznete v tématu Začínáme s příkladem Apache HBase v HDInsight.
Poznámka:
Neplatí pro clustery Kafka.
Apache Hive LLAP
Po škálování na
Npracovní uzly služba HDInsight automaticky nastaví následující konfigurace a restartuje Hive.- Maximální celkový počet souběžných dotazů:
hive.server2.tez.sessions.per.default.queue = min(N, 32) - Počet uzlů používaných LLAP Hive:
num_llap_nodes = N - Počet uzlů pro spuštění démona Hive LLAP:
num_llap_nodes_for_llap_daemons = N
- Maximální celkový počet souběžných dotazů:
Jak bezpečně zmenšit rozsah clusteru
Zmenšení clusteru se spuštěnými úlohami
Pokud se chcete vyhnout selhání spuštěných úloh během operace zmenšení kapacity, můžete zkusit tři věci:
- Před snížením kapacity clusteru počkejte, než se úlohy dokončí.
- Ručně ukončete úlohy.
- Po dokončení operace škálování znovu odešlete úlohy.
Pokud chcete zobrazit seznam čekajících a spuštěných úloh, můžete použít uživatelské rozhraní Resource Manageru YARN, a to takto:
Na webu Azure Portal vyberte váš cluster. Cluster se otevře na nové stránce portálu.
V hlavním zobrazení přejděte na řídicí panely clusteru>domovská stránka Ambari. Zadejte přihlašovací údaje ke clusteru.
V uživatelském rozhraní Ambari vyberte v seznamu služeb v nabídce vlevo YARN .
Na stránce YARN vyberte Rychlé odkazy a najeďte myší na aktivní hlavní uzel a pak vyberte uživatelské rozhraní Resource Manageru.
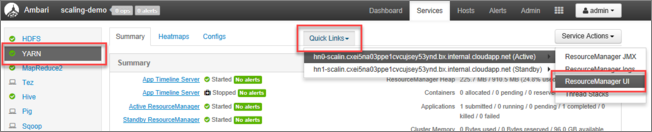
K uživatelskému rozhraní Resource Manageru můžete přistupovat přímo s https://<HDInsightClusterName>.azurehdinsight.net/yarnui/hn/cluster.
Zobrazí se seznam úloh spolu s jejich aktuálním stavem. Na snímku obrazovky je aktuálně spuštěná jedna úloha:
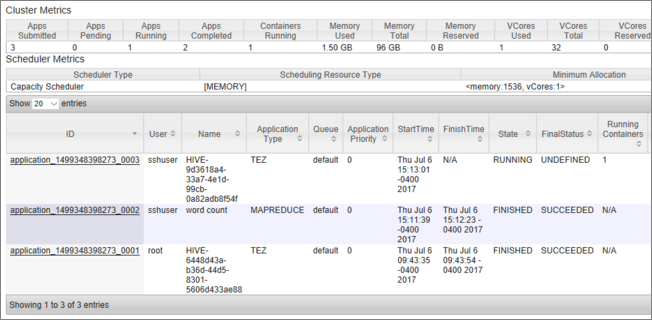
Spuštěním následujícího příkazu z prostředí SSH ručně ukončete spuštěnou aplikaci:
yarn application -kill <application_id>
Například:
yarn application -kill "application_1499348398273_0003"
Uvíznutí v nouzovém režimu
Při vertikálním snížení kapacity clusteru hdInsight používá rozhraní pro správu Apache Ambari k prvnímu vyřazení dalších pracovních uzlů z provozu. Uzly replikují své bloky HDFS do jiných online pracovních uzlů. Potom služba HDInsight bezpečně škáluje cluster dolů. SYSTÉM HDFS během operace škálování přejde do nouzového režimu. Po dokončení škálování má HDFS být vydáno. V některých případech se ale systém HDFS během operace škálování zablokuje v nouzovém režimu kvůli nedostatečné replikaci bloku souborů.
Ve výchozím nastavení je systém HDFS nakonfigurovaný s dfs.replication nastavením 1, které řídí, kolik kopií každého bloku souborů je k dispozici. Každá kopie bloku souboru je uložená na jiném uzlu clusteru.
Pokud není k dispozici očekávaný počet kopií bloku, hdFS přejde do nouzového režimu a Ambari vygeneruje výstrahy. SYSTÉM HDFS může pro operaci škálování vstoupit do nouzového režimu. Pokud se požadovaný počet uzlů pro replikaci nerozpozná, cluster se může zaseknout v nouzovém režimu.
Ukázkové chyby, když je zapnutý nouzový režim
org.apache.hadoop.hdfs.server.namenode.SafeModeException: Cannot create directory /tmp/hive/hive/819c215c-6d87-4311-97c8-4f0b9d2adcf0. Name node is in safe mode.
org.apache.http.conn.HttpHostConnectException: Connect to active-headnode-name.servername.internal.cloudapp.net:10001 [active-headnode-name.servername. internal.cloudapp.net/1.1.1.1] failed: Connection refused
Můžete zkontrolovat protokoly názvového uzlu z /var/log/hadoop/hdfs/ složky poblíž času, kdy byl cluster škálován, a zjistit, kdy se nachází v nouzovém režimu. Soubory protokolu jsou pojmenovány Hadoop-hdfs-namenode-<active-headnode-name>.*.
Původní příčinou bylo, že Hive při spouštění dotazů závisí na dočasných souborech v HDFS. Když HDFS přejde do nouzového režimu, Hive nemůže spouštět dotazy, protože nemůže zapisovat do HDFS. Dočasné soubory v HDFS jsou umístěny na místní jednotce připojené k jednotlivým virtuálním počítačům pracovních uzlů. Soubory se replikují mezi dalšími pracovními uzly ve třech exemplářích, minimálně.
Jak zabránit uvíznutí služby HDInsight v nouzovém režimu
Existuje několik způsobů, jak zabránit tomu, aby služba HDInsight zůstala v nouzovém režimu:
- Před snižováním kapacity služby HDInsight zastavte všechny úlohy Hive. Případně naplánujte proces snížení kapacity, abyste se vyhnuli konfliktu s běžícími úlohami Hive.
- Před vertikálním snížením kapacity ručně vyčistíte pomocné
tmpsoubory adresáře Hive v HDFS. - Vertikálně navyšte kapacitu HDInsight pouze na tři pracovní uzly, minimálně. Vyhněte se tak nízkému, jako je jeden pracovní uzel.
- Spuštěním příkazu v případě potřeby ponechejte nouzový režim.
Následující části popisují tyto možnosti.
Zastavení všech úloh Hive
Před vertikálním navýšením kapacity na jeden pracovní uzel zastavte všechny úlohy Hive. Pokud je vaše úloha naplánovaná, po dokončení práce Hive spusťte vertikální snížení kapacity.
Před škálováním zastavte úlohy Hive. Pomáhá minimalizovat počet pomocných souborů v dočasné složce (tmp), pokud nějaké jsou.
Ruční vyčištění dočasných souborů Hive
Pokud Hive zanechal dočasné soubory, můžete tyto soubory před snížením kapacity ručně vyčistit, aby bylo možné se vyhnout nouzovému režimu.
Zkontrolujte, které umístění se používá pro dočasné soubory Hive, a to tak, že se podíváte na
hive.exec.scratchdirvlastnost konfigurace. Tento parametr je nastaven v:/etc/hive/conf/hive-site.xml<property> <name>hive.exec.scratchdir</name> <value>hdfs://mycluster/tmp/hive</value> </property>Zastavte služby Hive a ujistěte se, že jsou dokončené všechny dotazy a úlohy.
Vypsat obsah pomocného adresáře uvedeného výše,
hdfs://mycluster/tmp/hive/zjistit, zda obsahuje nějaké soubory:hadoop fs -ls -R hdfs://mycluster/tmp/hive/hiveTady je ukázkový výstup, když existují soubory:
sshuser@scalin:~$ hadoop fs -ls -R hdfs://mycluster/tmp/hive/hive
drwx------   - hive hdfs          0 2017-07-06 13:40 hdfs://mycluster/tmp/hive/hive/4f3f4253-e6d0-42ac-88bc-90f0ea03602c
drwx------   - hive hdfs          0 2017-07-06 13:40 hdfs://mycluster/tmp/hive/hive/4f3f4253-e6d0-42ac-88bc-90f0ea03602c/_tmp_space.db
-rw-r--r--   3 hive hdfs         27 2017-07-06 13:40 hdfs://mycluster/tmp/hive/hive/4f3f4253-e6d0-42ac-88bc-90f0ea03602c/inuse.info
-rw-r--r--   3 hive hdfs          0 2017-07-06 13:40 hdfs://mycluster/tmp/hive/hive/4f3f4253-e6d0-42ac-88bc-90f0ea03602c/inuse.lck
drwx------   - hive hdfs          0 2017-07-06 20:30 hdfs://mycluster/tmp/hive/hive/c108f1c2-453e-400f-ac3e-e3a9b0d22699
-rw-r--r--   3 hive hdfs         26 2017-07-06 20:30 hdfs://mycluster/tmp/hive/hive/c108f1c2-453e-400f-ac3e-e3a9b0d22699/inuse.info
Pokud víte, že s těmito soubory je Hive hotová, můžete je odebrat. Ujistěte se, že Hive nemá spuštěné žádné dotazy, a to tak, že se podíváte na stránku uživatelského rozhraní Resource Manageru Yarn.
Příklad příkazového řádku pro odebrání souborů z HDFS:
hadoop fs -rm -r -skipTrash hdfs://mycluster/tmp/hive/
Přizpůsobit kapacitu HDInsight na tři a více pracovních uzlů.
Pokud vaše clustery často uvíznou v nouzovém režimu při škálování dolů na méně než tři pracovní uzly, ponechte alespoň tři pracovní uzly.
Je nákladnější mít tři pracovní uzly než snížit jejich počet na pouze jeden pracovní uzel. Tato akce ale brání tomu, aby váš cluster uvízl v nouzovém režimu.
Škálování služby HDInsight dolů na jeden pracovní uzel
I když je cluster zmenšen na jeden uzel, pracovní uzel 0 stále zůstává funkční. Pracovní uzel 0 nelze nikdy vyřadit z provozu.
Spuštěním příkazu opusťte nouzový režim.
Poslední možností je provést příkaz pro opuštění nouzového režimu. Pokud systém HDFS vstoupil do nouzového režimu kvůli nedostatečné replikaci souboru Hive, spusťte následující příkaz, abyste opustili nouzový režim:
hdfs dfsadmin -D 'fs.default.name=hdfs://mycluster/' -safemode leave
Snížení kapacity clusteru Apache HBase
Servery oblastí se po dokončení operace škálování automaticky vyrovnávají během několika minut. Pokud chcete ručně vyrovnávat servery oblastí, proveďte následující kroky:
Připojte se ke clusteru HDInsight pomocí SSH. Další informace najdete v tématu Použití SSH se službou HDInsight.
Spusťte prostředí HBase:
hbase shellK ručnímu vyvážení serverů oblastí použijte následující příkaz:
balancer
Další kroky
Konkrétní informace o škálování clusteru HDInsight najdete v tématu: