Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
SQL analytics-endpointet giver dig en skrivebeskyttet T-SQL query surface over Delta-tabellerne i dit lakehouse. Hver lakehouse provisionerer automatisk et SQL-analyse-endpoint, når det oprettes — der er ikke noget ekstra at sætte op. Bag kulisserne kører SQL-analyse-endpointet på samme motor som Fabric data warehouse, så du får højtydende, lav-latenstid SQL-forespørgsler uden at administrere infrastrukturen.
SQL analytics-endpointet er ikke unikt for lakehouses. Andre Fabric-elementer — herunder warehouses, mirrored databases, SQL-databaser og Azure Cosmos DB — leverer også automatisk et SQL-analyseendepunkt. Oplevelsen og begrænsningerne er de samme på tværs af dem alle.

Det kan du gøre
SQL-analyse-endpointet kører i skrivebeskyttet tilstand over Delta-tabeller — du kan ikke indsætte, opdatere eller slette data gennem det. For at ændre data, skift til søhuset og brug Apache Spark.
Inden for denne skrivebeskyttede grænse kan du:
- Query Delta-tabeller med T-SQL — Kør SELECT-sætninger mod enhver Delta-tabel i dit lakehouse, inklusive tabeller eksponeret via genveje til ekstern Azure Data Lake Storage eller Amazon S3.
- Opret visninger, funktioner og lagrede procedurer — Indkapsl forretningslogik og genanvendelige forespørgselsmønstre i T-SQL-objekter, der bevares i SQL-analyse-endpointet.
- Anvend sikkerhed på række- og objektniveau — Brug SQL-granularrettigheder til at styre, hvilke brugere der kan se hvilke tabeller, kolonner eller rækker.
- Byg Power BI-rapporter — Power BI semantiske modeller kan forbinde til SQL-analyse-endpointet via Tabular Data Stream (TDS)-endpointet, så du kan bygge rapporter over dine lakehouse-data.
- Forespørg på tværs af arbejdsområder — Brug OneLake-genveje til at referere til Delta-tabeller i andre lakehouses eller lagre, og saml dem derefter i en enkelt forespørgsel. For flere scenarier på tværs af arbejdsområder, se Lakehouse SQL analytics endpoint use cases.
Note
Eksterne Delta-tabeller, der er oprettet med Spark-kode, er ikke synlige for SQL Analytics-slutpunktet. Brug genveje i tabellesektionen for at gøre eksterne Delta-tabeller synlige. For at lære hvordan, se Opret en genvej.
Access SQL-analyse-endpointet
Du kan åbne SQL-analyse-endpointet på to måder:
- Fra arbejdsområdet — Find SQL analytics endpoint-elementet i din arbejdsområdeliste (det deler navn med dit lakehouse) og vælg det.
- Fra Lakehouse Explorer — I øverste højre område af båndet bruger du dropdown-menuen til at skifte til SQL analytics endpoint-visningen.
Uanset hvad åbner query editor, hvor du kan skrive og køre T-SQL-forespørgsler mod dine Delta-tabeller.
Sikkerhed
SQL-sikkerhedsregler sat på SQL-analyse-endpointet gælder kun, når data tilgås via endpointet. De gælder ikke, når de samme data tilgås via Spark eller andre værktøjer.
For at sikre dine data:
- Sæt SQL granular permissions på SQL analytics-endpointet for at styre access til specifikke tabeller, kolonner eller rækker.
- Sæt workspace-roller og tilladelser til at kontrollere, hvem der kan access lakehouse og dets data via andre stier.
For mere om sikkerhedsmodellen, se OneLake security for SQL analytics endpoints.
Synkronisering af metadata
Når du opretter eller opdaterer en Delta-tabel i dit lakehouse, opdager SQL-analyse-endpointet automatisk ændringen og opdaterer sine SQL-metadata — tabeldefinitioner, kolonnetyper og statistikker. Der er ingen importtrin og ingen manuel synkronisering nødvendig. Du har flere muligheder for manuelt at starte en opdatering af SQL-analyse-endpointets metadata.
For mere information, se SQL analytics endpoint metadata sync.
Klargøring igen
Hvis SQL analytics-endpointet ikke kan provisionere, når du opretter et lakehouse, kan du prøve igen direkte fra lakehouse-hjemmesiden uden at genskabe lakehouse.
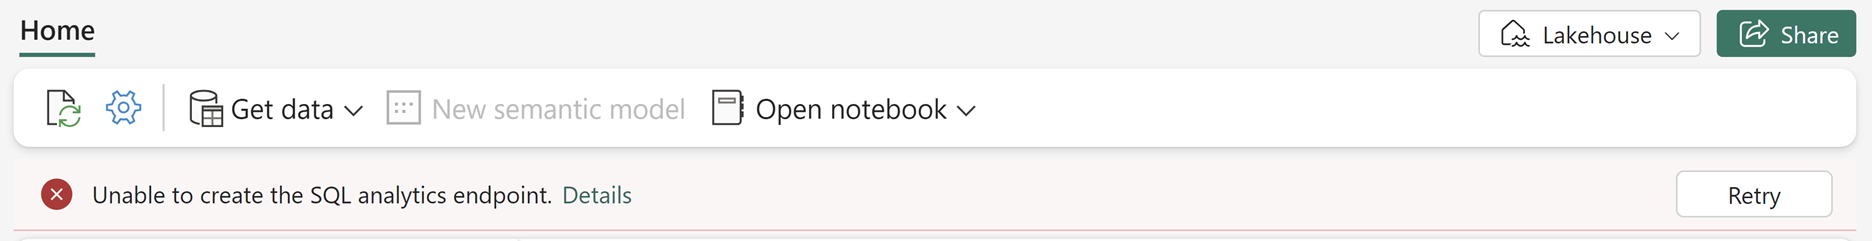
Note
Reprovisionering kan stadig fejle, ligesom den oprindelige provisionering kan. Hvis gentagne forsøg fejler, kontakt support.
Begrænsninger
SQL-analyse-endpointet deler sin motor med lageret i Fabric, og de deler de samme begrænsninger.
Følgende begrænsninger gælder for automatisk generering af skemaer og registrering af metadata i SQL Analytics-slutpunktet.
Dataene skal være i Delta Parquet-format, så de automatisk kan findes i SQL-analyseslutpunktet. Delta Lake er et open source-lagringsframework , der muliggør opbygning af lakehouse-arkitektur.
Delta-kolonnetilknytning efter navn understøttes, men Delta-kolonnetilknytning efter id understøttes ikke. Du kan få flere oplysninger under Delta Lake-funktioner og Fabric-oplevelser.
- Delta-kolonnetilknytning i SQL Analytics-slutpunktet er i øjeblikket en prøveversion.
Delta-tabeller, der er oprettet uden for mappen
/tables, er ikke tilgængelige i SQL Analytics-slutpunktet.Hvis du ikke kan se en lakehouse-tabel i SQL analytics-endpointet, så tjek placeringen af tabellen. Kun tabellerne, der refererer til data i mappen
/tables, er tilgængelige i SQL-analyse-endpointet. De tabeller, der refererer til data i mappen/filesi søen, vises ikke i SQL Analytics-slutpunktet. Du kan løse problemet ved at flytte dine data til mappen/tables.Nogle kolonner, der findes i Spark Delta-tabellerne, er muligvis ikke tilgængelige i tabellerne i SQL Analytics-slutpunktet. For hver Delta-tabel i din Lakehouse genererer SQL-analyse-endpointet automatisk en tabel med T-SQL-datatyper. SQL analytics endpoint-motoren er baseret på Fabric data warehouse-motoren og deler datatyper. Du kan se en komplet liste over understøttede datatyper under Datatyper i Fabric data warehouse.
Hvis du tilføjer en fremmed nøglebegrænsning mellem tabeller i SQL Analytics-slutpunktet, kan du ikke foretage yderligere skemaændringer (f.eks. tilføje de nye kolonner). Hvis du ikke kan se Delta Lake-kolonnerne med de typer, der skal understøttes i SQL Analytics-slutpunktet, skal du kontrollere, om der er en fremmed nøglebegrænsning, der kan forhindre opdateringer i tabellen.
Du kan finde oplysninger om og anbefalinger til ydeevnen for SQL-analyseslutpunktet under Overvejelser i forbindelse med ydeevnen for SQL-analyseslutpunkt.
Skalar-UDF'er understøttes, når de er indbyggede. Du kan få mere at vide under CREATE FUNCTION og Scalar UDF inlining.
Varchar(max)-datatypen understøttes kun i SQL-analyseendepunkter, der er aktiveret med den nye metadata-synkronisering.
Dataafskæring til 8 KB gælder stadig på tabellerne i SQL-analyse-endpointet i lakehouse, inklusive genveje til et spejlet element, hvis SQL-analyseendpointet ikke bruger ny metadata-synkronisering.
Du kan bekræfte, om en tabel har en varchar(max) -kolonne fra skemametadata ved hjælp af følgende T-SQL-forespørgsel. En max_length værdi af -1 repræsenterer varchar(max):
SELECT o.name, c.name, type_name(user_type_id) AS [type], max_length
FROM sys.columns AS c
INNER JOIN sys.objects AS o
ON c.object_id = o.object_id
WHERE max_length = -1
AND type_name(user_type_id) IN ('varchar', 'varbinary');
Skemaer med navne, der er i konflikt med systemskemaer (såsom
sysellerinformation_schema) og databasesikkerhedsprincipper (såsomdb_owner,db_datareader), understøttes ikke i SQL-analyse-endpointet. Tabeller under disse skemaer vil ikke synkronisere til SQL-analyse-endpointet.Et arbejdsområde understøtter op til 150 lager- og SQL-analyseendpoint-elementer tilsammen. Oprettelse af yderligere elementer ud over denne grænse understøttes ikke. Slet et eksisterende element, før du opretter et nyt.