Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Ved at bruge Fabric SDK til evaluering kan du programmæssigt teste, hvor godt din dataagent svarer på spørgsmål om naturligt sprog. Ved at bruge en simpel Python-grænseflade kan du definere eksempler på grundens sandhed, køre evalueringer og analysere resultater – alt sammen i dit notesbogsmiljø. Denne proces hjælper dig med at validere nøjagtighed, fejlfinde fejl og trygt forbedre din agent, før du implementerer den i produktion.
Vigtigt!
Denne funktion er i prøveversion.
Forudsætninger
- A betalt F2 eller højere Fabric kapacitet, eller en Power BI Premium pr. kapacitet (P1 eller højere) kapacitet med Microsoft Fabric aktiveret.
- Aktiver cross-geo behandling og cross-geo lagring for AI baseret på krav, der er beskrevet i Fabric data agent tenant-indstillingerne.
- Mindst én af disse datakilder, med data: Et lager, et søhus, en Power BI semantisk model, en KQL-database, en spejlet database eller en ontologi. Du skal have læseadgang til datakilden.
Installér dataagent-SDK'et
For at komme i gang med at evaluere din Fabric-dataagent programmatisk, installer Fabric dataagenten Python SDK. Dette SDK indeholder de værktøjer og metoder, der kræves for at interagere med din dataagent, køre evalueringer og logføre resultater. Installér den nyeste version ved at køre følgende kommando i notesbogen:
%pip install -U fabric-data-agent-sdk
Dette trin sikrer, at du har de mest up-to-date-funktioner og -rettelser, der er tilgængelige i SDK'et.
Indlæs dit ground truth-datasæt
For at evaluere din Fabric-dataagent har du brug for et sæt eksempelspørgsmål sammen med de forventede svar. Brug disse spørgsmål til at verificere, hvor præcist agenten svarer på virkelige spørgsmål.
Definer disse spørgsmål direkte i din kode ved at bruge en pandas DataFrame:
import pandas as pd

# Define a sample evaluation set with user questions and their expected answers.
# You can modify the question/answer pairs to match your scenario.
df = pd.DataFrame(
    columns=["question", "expected_answer"],
    data=[
        ["Show total sales for Canadian Dollar for January 2013", "46,117.30"],
        ["What is the product with the highest total sales for Canadian Dollar in 2013", "Mountain-200 Black, 42"],
        ["Total sales outside of the US", "19,968,887.95"],
        ["Which product category had the highest total sales for Canadian Dollar in 2013", "Bikes (Total Sales: 938,654.76)"]
    ]
)
Alternativt, hvis du har et eksisterende evalueringsdatasæt, indlæs det fra en CSV-fil med kolonnerne question og expected_answer:
# Load questions and expected answers from a CSV file
input_file_path = "/lakehouse/default/Files/Data/Input/curated_2.csv"
df = pd.read_csv(input_file_path)
Dette datasæt fungerer som input til kørsel af automatiserede evalueringer i forhold til din dataagent for at vurdere nøjagtighed og dækning.
Evaluer og vurder din dataagent
Næste skridt er at køre evalueringen ved at bruge evaluate_data_agent funktionen. Denne funktion sammenligner agentens svar med dine forventede resultater og gemmer evalueringsmålingerne.
Bemærkning
Dette trin kræver en dataagent, der allerede er offentliggjort til det stadie, du evaluerer (production eller sandbox). Hvis du ikke har en endnu, se Create a Fabric data agent.
from fabric.dataagent.evaluation import evaluate_data_agent

# Name of your data agent
data_agent_name = "AgentEvaluation"

# (Optional) Name of the workspace if the data agent is in a different workspace
workspace_name = None

# (Optional) Name of the output table to store evaluation results (default: "evaluation_output")
# Two tables will be created:
# - "<table_name>": contains summary results (e.g., accuracy)
# - "<table_name>_steps": contains detailed reasoning and step-by-step execution
table_name = "demo_evaluation_output"

# Specify the data agent stage: "production" (default) or "sandbox"
data_agent_stage = "production"

# Run the evaluation and get the evaluation ID
try:
    evaluation_id = evaluate_data_agent(
        df,
        data_agent_name,
        workspace_name=workspace_name,
        table_name=table_name,
        data_agent_stage=data_agent_stage
    )
    print(f"Unique ID for the current evaluation run: {evaluation_id}")
except Exception as e:
    print(f"Evaluation failed: {e}")
Når gennemløbet er færdigt, ser du output, der ligner følgende tekst:
Unique ID for the current evaluation run: <evaluation-id>
Hent evalueringsoversigt
Efter at have kørt evalueringen kan du hente et overordnet resumé af resultaterne ved hjælp get_evaluation_summary af funktionen. Denne funktion giver indsigt i, hvor godt din dataagent overordnet præsterede generelt, inklusive målinger som, hvor mange svar der matchede de forventede svar.
from fabric.dataagent.evaluation import get_evaluation_summary

# Retrieve a summary of the evaluation results
summary_df = get_evaluation_summary(table_name)
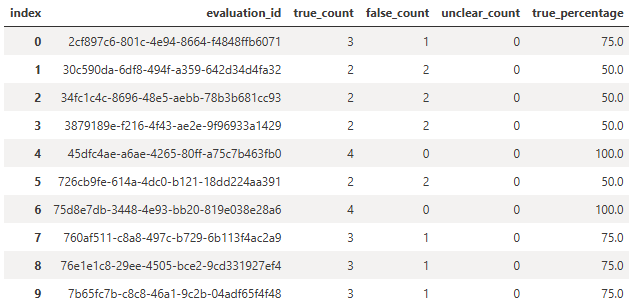
Som standard leder denne funktion efter en tabel med navnet evaluation_output. Hvis du har angivet et brugerdefineret tabelnavn under evalueringen (som demo_evaluation_output), så videregiv det navn som table_name argument.
Den returnerede DataFrame indeholder aggregerede målepunkter, f.eks. antallet af korrekte, forkerte eller uklare svar. Dette resultat hjælper dig med hurtigt at vurdere agentens nøjagtighed og identificere områder, der kan forbedres.
Undersøg detaljerede evalueringsresultater
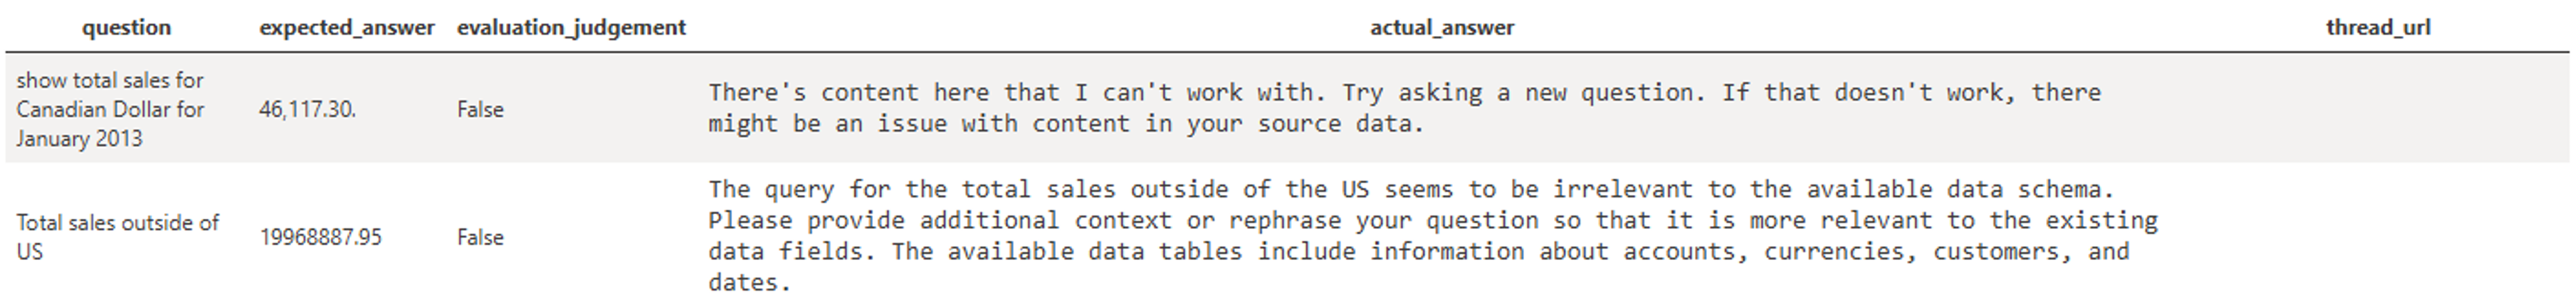
For at dykke dybere ned i, hvordan din dataagent svarede på hvert enkelt spørgsmål, kan du bruge funktionen get_evaluation_details . Denne funktion returnerer en detaljeret opdeling af evalueringskørslen, herunder de faktiske agentsvar, om de svarede til det forventede svar, og et link til evalueringstråden (kun synlig for den bruger, der kørte evalueringen).
from fabric.dataagent.evaluation import get_evaluation_details

# Table name used during evaluation
table_name = "demo_evaluation_output"

# Whether to return all evaluation rows (True) or only failures (False)
get_all_rows = False

# Whether to print a summary of the results
verbose = True

# Retrieve evaluation details for a specific run
eval_details = get_evaluation_details(
    evaluation_id,
    table_name,
    get_all_rows=get_all_rows,
    verbose=verbose
)
Tilpas din anmodning om evaluering
Som standard bruger Fabric SDK en indbygget prompt til at vurdere, om dataagentens faktiske svar matcher det forventede svar. Du kan dog levere din egen prompt til mere nuancerede eller domænespecifikke evalueringer ved at bruge parameteren critic_prompt .
Den brugerdefinerede prompt skal indeholde pladsholderne {query}, {expected_answer}og {actual_answer}. Evalueringsprocessen erstatter dynamisk disse pladsholdere for hvert spørgsmål.
from fabric.dataagent.evaluation import evaluate_data_agent

# Define a custom prompt for evaluating agent responses
critic_prompt = """
    Given the following query, expected answer, and actual answer, please determine if the actual answer is equivalent to expected answer. If they are equivalent, respond with 'yes'.

    Query: {query}

    Expected Answer:
    {expected_answer}

    Actual Answer:
    {actual_answer}

    Is the actual answer equivalent to the expected answer?
"""

# Name of the data agent
data_agent_name = "AgentEvaluation"

# Run evaluation using the custom critic prompt
evaluation_id = evaluate_data_agent(df, data_agent_name, critic_prompt=critic_prompt)
Denne funktion er især nyttig, når:
- Du bør anvende mere lempelige eller strengere kriterier for, hvad der tæller som et match.
- Dine forventede og faktiske svar kan variere i format, men stadig være semantisk ækvivalente.
- Du skal registrere domænespecifikke nuancer i, hvordan svar skal bedømmes.
Diagnostikknap
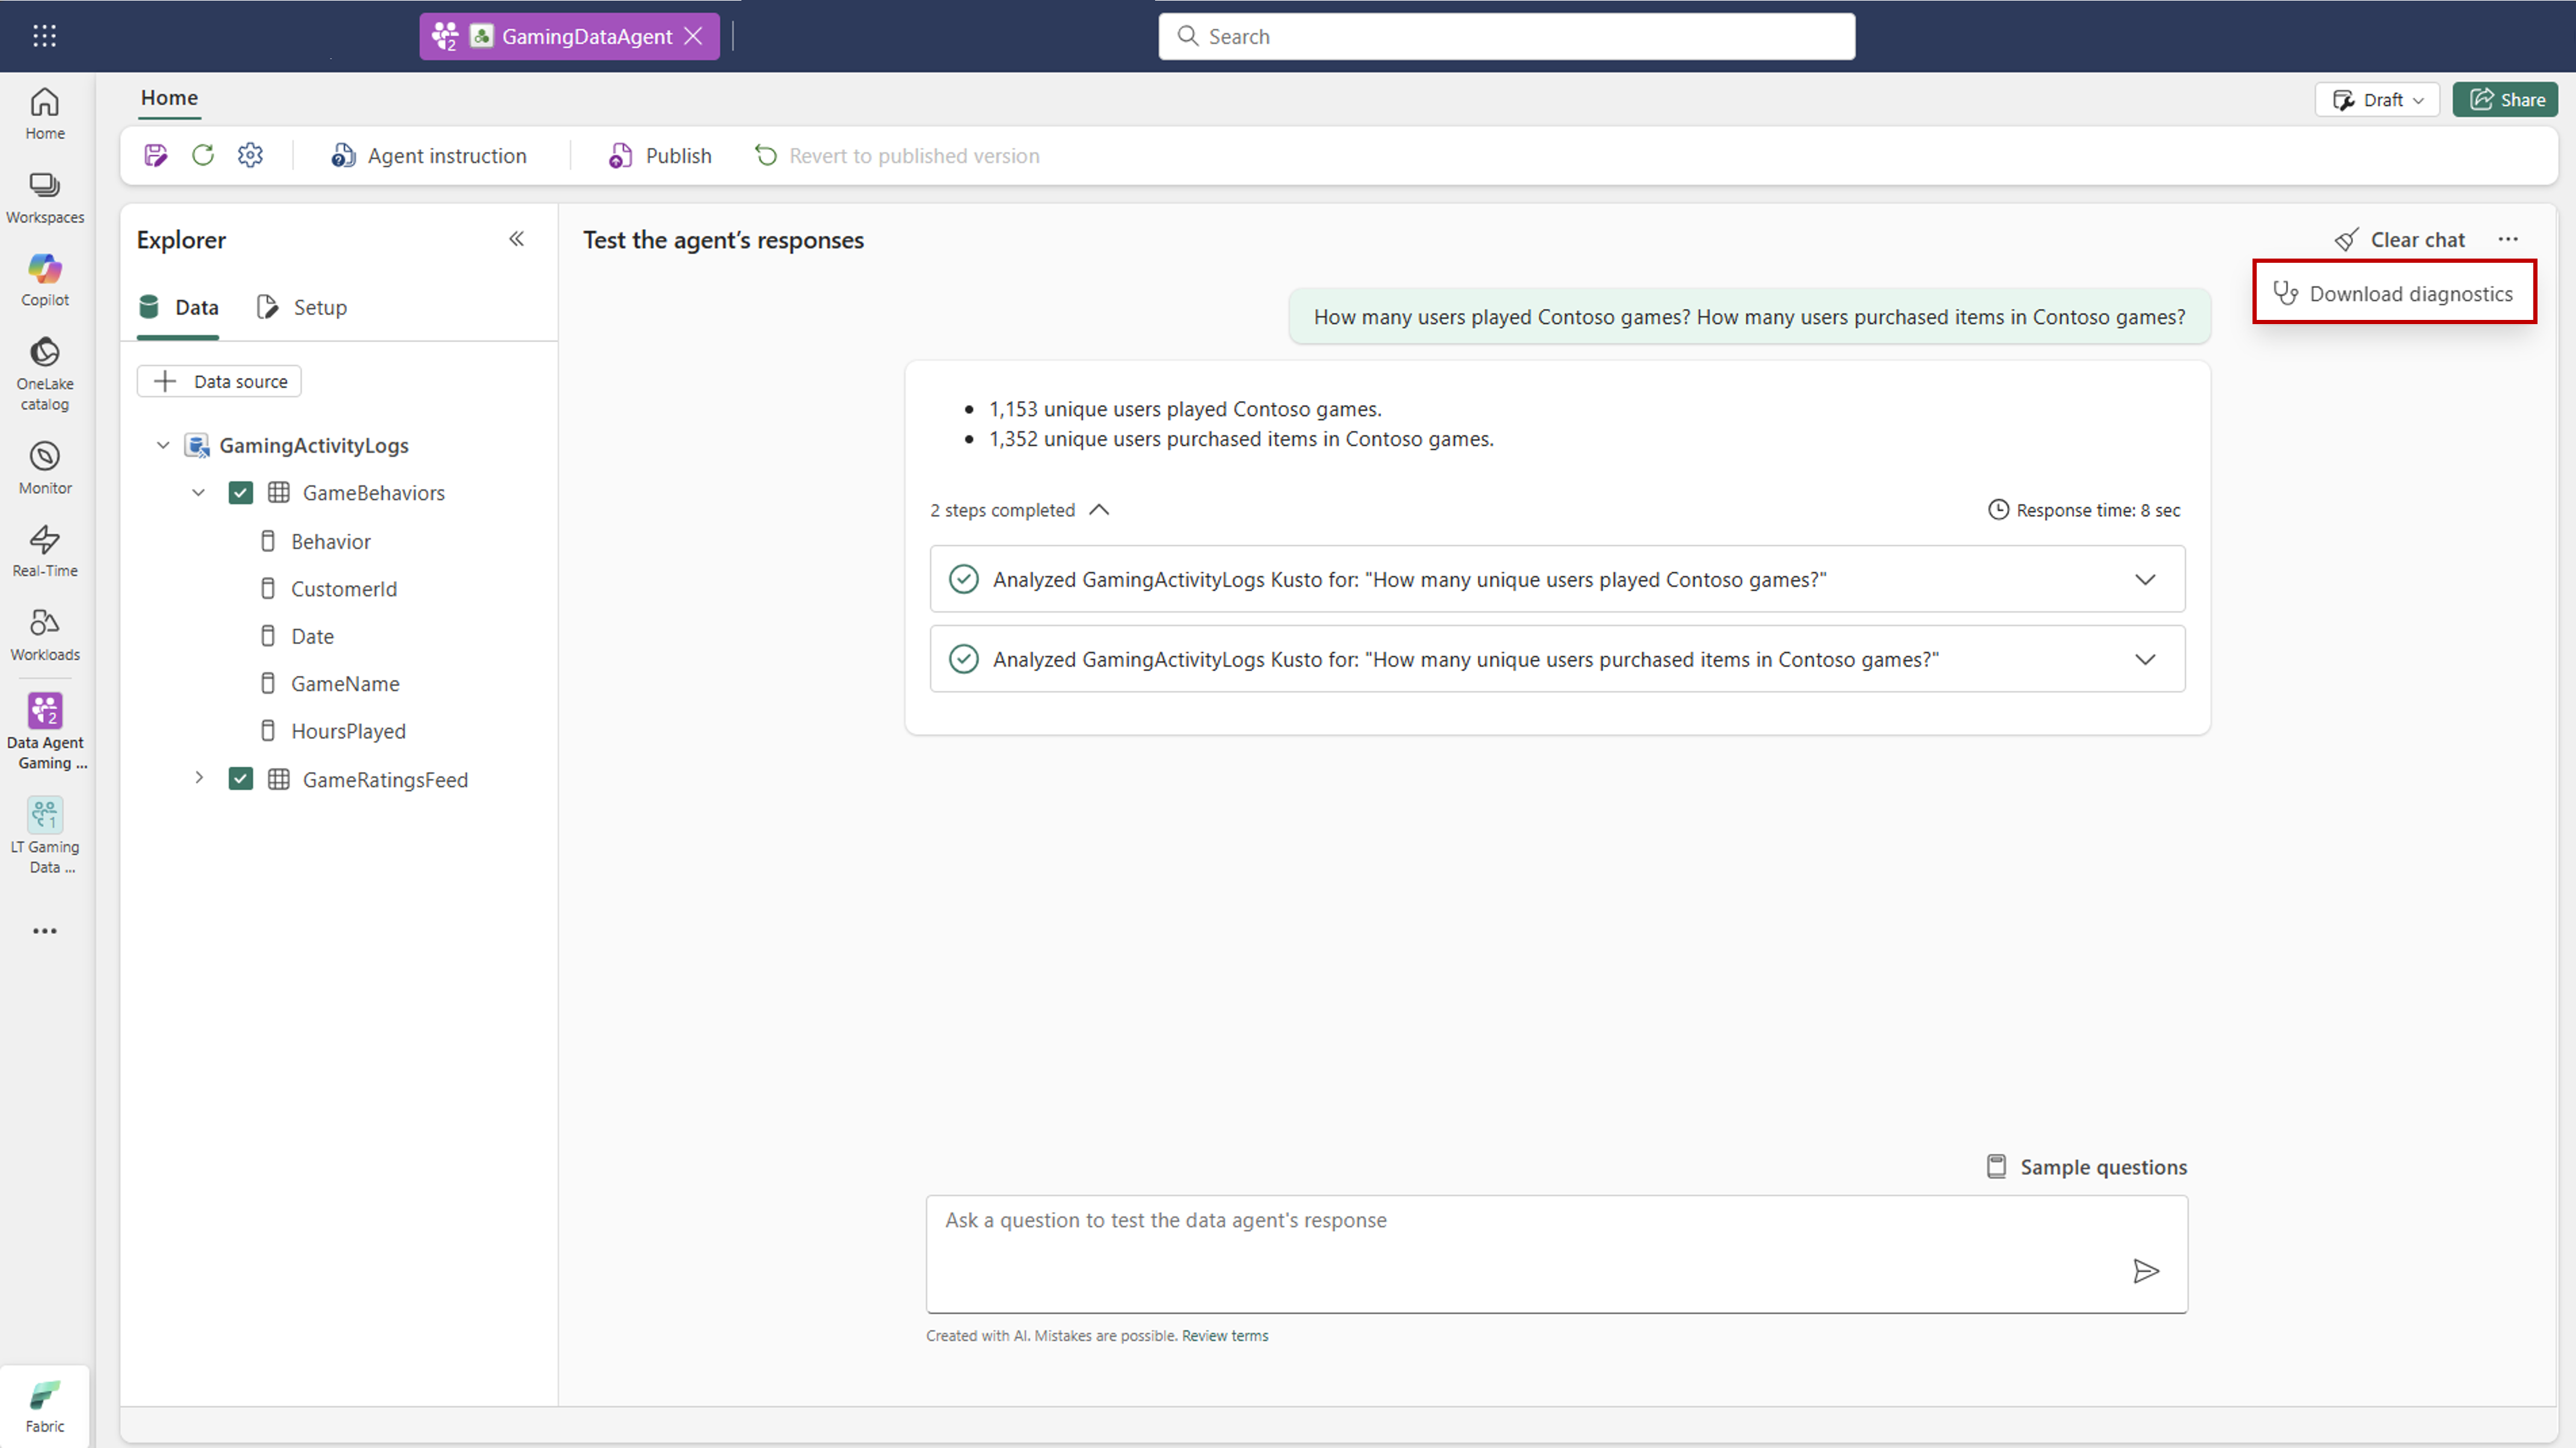
Diagnostic-knappen lader dig downloade et fuldt øjebliksbillede af din dataagents konfiguration og eksekveringstrin. Denne eksport indeholder detaljer som datakildeindstillinger, anvendte instruktioner, anvendte eksempelforespørgsler og de underliggende trin, dataagenten tog for at generere sit svar.
Brug denne funktion, når du arbejder med Microsoft Support eller fejlsøger uventet adfærd. Ved at gennemgå den downloadede fil kan du se præcis, hvordan dataagenten behandlede din anmodning, hvilke konfigurationer der blev anvendt, og hvor potentielle problemer opstod. Dette niveau af gennemsigtighed gør det lettere at fejlfinde og optimere din dataagents ydeevne.
Fejlfinding
| Spørgsmål | Årsag | Løsning |
|---|---|---|
| Dataagent ikke fundet | Eller data_agent_nameworkspace_name er forkert, eller agenten er ikke offentliggjort. |
Verificér agentens navn og arbejdsområde, og sørg for, at agenten er offentliggjort til den angivne data_agent_stage. |
| Tomme eller manglende resultater | Bordnavnet stemmer ikke overens med det, der bruges under evaluate_data_agent. |
Send det samme table_name til get_evaluation_summary og get_evaluation_details. |
message_url er ikke tilgængelig |
Evalueringstråde er kun synlige for den bruger, der kørte evalueringen. | Kør evalueringen igen under din egen identitet for at få adgang til trådens links. |
| Brugerdefineret prompt har ingen effekt eller fejl | Der critic_prompt mangler nødvendige pladsholdere. |
Inkluder {query}, {expected_answer}, og {actual_answer} i din prompt. |
| Tilladelses- eller kapacitetsfejl | Manglende F2 eller højere kapacitet, eller manglende læseadgang til datakilden. | Bekræft forudsætningerne, herunder kapacitet og adgang til datakildens læseadgang. |