Bemærk
Adgang til denne side kræver godkendelse. Du kan prøve at logge på eller ændre mapper.
Adgang til denne side kræver godkendelse. Du kan prøve at ændre mapper.
Gælder for:✅ Warehouse i Microsoft Fabric
Denne artikel beskriver metoder til at migrere datalagre fra SQL Server til Microsoft Fabric data warehouse.
Tip
For mere information om strategi og planlægning, se Migrationsplanlægning: SQL Server to Fabric data warehouse.
Brug Fabric Migration Assistant til data warehouse for en automatiseret migrationsoplevelse fra SQL Server. Resten af denne artikel beskriver flere manuelle migrationstrin.
Følgende tabel opsummerer metoder til migrering af dataskemaet (DDL), databasekoden (DML) og dataene. Hver mulighed beskrives senere i denne artikel.
| Valgmulighed | Metode | Hvad den gør | Færdighed eller præference | Scenarie |
|---|---|---|---|---|
| 1 | datafabrik | Skemakonvertering Dataudtræk Indtagelse af data |
Data Factory-pipeline | Forenklet skema- og datamigration. Anbefales til dimensionstabeller. |
| 2 | Data Factory med partitionering | Skemakonvertering Dataudtræk Indtagelse af data |
Data Factory-pipeline | Paralleliseret migration for store faktatabeller. |
| 3 | Skema-først migration | Skemakonvertering | Data Factory-pipeline | Migrer først skemaet, og udtræk og indtag data separat for bedre kontrol over gennemstrømningen. |
| 4 | SQL-migreringsscripts | Skemakonvertering Dataudtræk Kodevurdering |
T-SQL | Brug en IDE og scripts til detaljeret kontrol over migreringsopgaver. |
| 5 | SQL-databaseprojekter | Skemakonvertering Kodevurdering |
SQL-projekt | Brug et databaseprojekt til versionskontrol, vurdering og implementering. |
| 6 | DBT | Skemakonvertering Databasekodekonvertering |
dbt | Genanvend et eksisterende dbt-projekt ved at ændre adapteren og målkonfigurationen. |
Vælg en arbejdsbelastning til den indledende migrering
Når du beslutter, hvor du skal starte et SQL Server til Fabric data warehouse migreringsprojekt, skal du vælge et arbejdsområde, hvor du kan:
- Bevis muligheden for at migrere til Fabric data warehouse ved hurtigt at levere fordelene ved det nye miljø. Start småt og enkelt, og forbered dig på flere små migrationer.
- Giv dit tekniske personale tid til at opnå relevant erfaring med de processer og værktøjer, de bruger til at migrere andre arbejdsbyrder.
- Lav en skabelon til yderligere migrationer, der er specifik for dit SQL Server-miljø, værktøjer og processer.
Tip
Lav et inventar over objekter, der skal migreres, og dokumenter migreringsprocessen fra start til slut, så den kan gentages for andre databaser eller arbejdsbelastninger.
Datamængden i en indledende migration bør være stor nok til at demonstrere kapaciteterne og fordelene ved Fabric data warehouse, men lille nok til hurtigt at vise værdi. En størrelse i intervallet 1-10 terabyte er typisk.
Migrer med Fabric Data Factory
Fabric Data Factory leverer en low-code grænseflade, der kan konvertere table DDL og migrere data fra SQL Server.
Fabric Data Factory kan udføre følgende opgaver:
- Konverter skema (DDL) til Fabric data warehouse syntaks.
- Opret skema-objekter i Fabric data warehouse.
- Migrer data til Fabric data warehouse.
Mulighed 1. Skema- og datamigration med kopiassistent
Denne metode bruger Data Factory Copy Assistant til at forbinde til kilden SQL Server databasen, konvertere table DDL til Fabric syntaks og kopiere data til Fabric data warehouse. Du kan vælge en eller flere kildetabeller. Den genererede pipeline bruger en ForEach-aktivitet til at kopiere de valgte tabeller parallelt.
Når du konfigurerer kopieringsoperationen:
- Brug SQL Server-connectoren til kildeforbindelsen.
- Begræns parallelle kopier til et niveau, som kildedatabasen og netværket kan opretholde.
- Overvåg kilde-CPU, I/O, brugen af transaktionslogfiler og produktionsarbejdsbelastningens latens under udtrækning.
Anbefalet brug
Brug Copy Assistant til en simpel grænseflade, der konverterer DDL og indtaster udvalgte tabeller i én operation. Denne metode passer godt til dimensionstabeller og mindre arbejdsbyrder.
For store tabeller skal man bruge partitionering for at øge læse- og skriveparallelisme.
Mulighed 2. Datamigration med opdeling
For store faktatabeller skal du bruge en Copy activity for hver tabel og konfigurere kildepartitionering. Brug fysiske partitioner, når de er tilgængelige, eller konfigurer dynamisk område-partitionering ved at angive en passende numerisk eller datokolonne samt dens minimums- og maksimumsværdier.
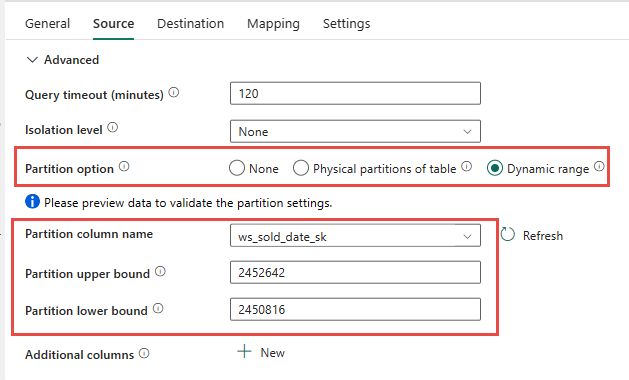
Når du bruger partitionering:
- Vælg en partitionskolonne, der fordeler rækkerne jævnt.
- Undgå at oprette flere samtidige kildeforespørgsler, end SQL Server kan behandle uden at påvirke produktionsarbejdsbyrder.
- Test partitionsområdet og parallelkopieringsindstillingerne mod en repræsentativ arbejdsbyrde.
- Øg parallelismen gradvist, mens du overvåger kilde og destination.
Anbefalet brug
Brug Data Factory-partitionering til store faktatabeller, når parallel udtrækning forbedrer gennemstrømningen. Mål batchantallet og partitionsintervallerne i henhold til dine kildedatabaser, ressourcer og netværkskapacitet.
Mulighed 3. Skema-først migration
For større databaser, adskil skema-migrering fra datamigration:
- Konverter og lav tabelskemaer i Fabric data warehouse.
- Udtræk kildedata ind i Azure Data Lake Storage (ADLS) Gen2.
- Brug Data Factory eller COPY INTO-kommandoen til at indlæse de trindelte data i Fabric data warehouse.
Ved at adskille disse faser kan du justere ekstraktion og indtagelse uafhængigt.
Skema-migration med Data Factory
Du kan bruge en Fabric pipeline til at migrere tabelskemaer fra SQL Server til Fabric data warehouse uden at kopiere rækker.
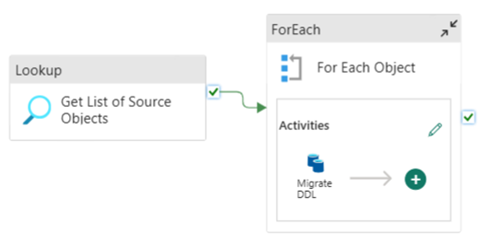
Konfigurer pipelineparametre
Opret en SchemaName parameter, der angiver, hvilke skemaer der skal migreres. Brug dbo som standard, eller indtast en komma-adskilt liste såsom 'dbo','sales'.
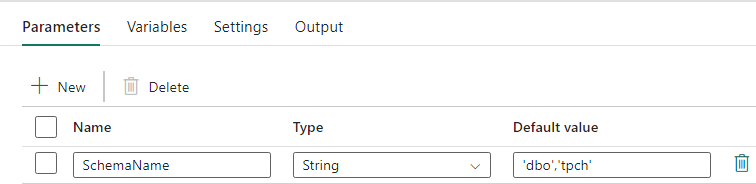
Konfigurér Lookup-aktiviteten
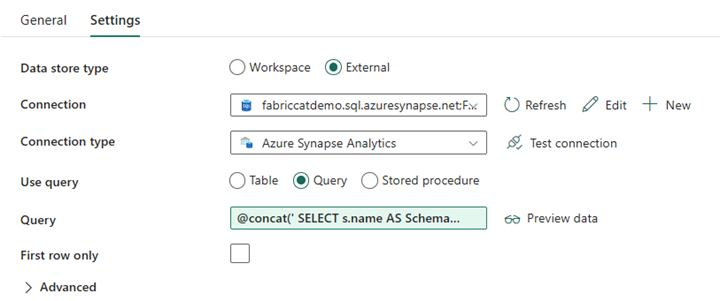
Opret en opslagsaktivitet, og sæt dens forbindelse til kildedatabasen SQL Server. Under fanen Indstillinger:
- Angiv Datalagertype til Ekstern.
- Vælg kildeforbindelsen til SQL Server.
- Sæt Brug forespørgsel til forespørgsel.
- Tilføj en dynamisk forespørgsel, der returnerer kildeskemaet og tabelnavnene.
Brug følgende udtryk til at oprette forespørgslen:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Konfigurér ForEach-aktiviteten
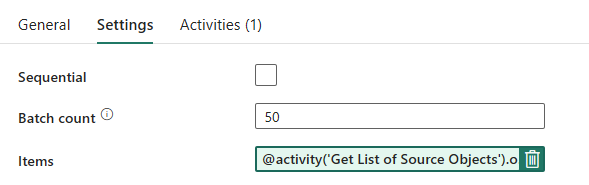
I fanen Indstillinger for ForEach-aktiviteten:
- Deaktiver Sequential for at tillade iterationer at køre samtidig.
- Sæt batch-tællingen til en værdi, som kildedatabasen kan opretholde. Start med en konservativ værdi og test den.
- Sæt Items til
@activity('Get List of Source Objects').output.value.
Konfigurer Copy activity
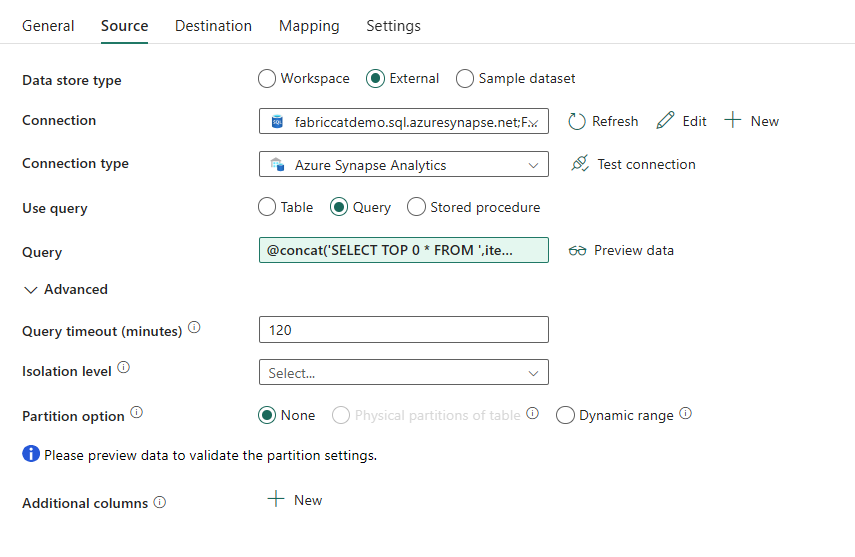
Inde i ForEach-aktiviteten tilføjes en Copy activity. Under fanen Kilde:
- Angiv Datalagertype til Ekstern.
- Vælg kildeforbindelsen til SQL Server.
- Sæt Brug forespørgsel til forespørgsel.
- Sæt forespørgsel til at
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)kun tabelmetadata migreres.
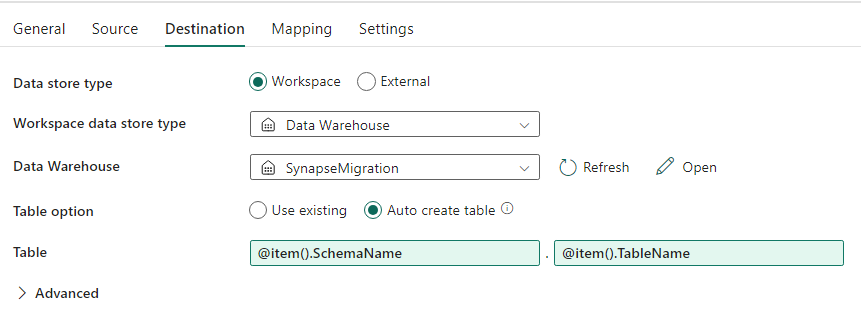
Under fanen Destination:
- Angiv Datalagertype til Arbejdsområde.
- Indsæt Workspace data store-typen til data warehouse, og vælg destinationslageret.
- Sæt destinationsskemaet til
@item().SchemaName. - Sæt destinationstabellen til
@item().TableName.
Efter du har kørt pipelinen, skal du verificere, at Fabric data warehouse indeholder hver valgt tabel med det forventede skema.
Migrer ved hjælp af SQL-scripts
Brug T-SQL og PowerShell migrationsscripts, når du ønsker detaljeret kontrol over skemakonvertering, dataudtrekking og kodevurdering.
Migrationsskrifter kan:
- Konverter skema (DDL) til Fabric data warehouse syntaks.
- Opret skema-objekter i Fabric data warehouse.
- Udtræk data fra SQL Server til ADLS Gen2.
- Marker ikke-understøttet T-SQL-syntaks i lagrede procedurer, funktioner og visninger.
Microsoft Fabric CAT-teamet leverer migrationskodeeksempler i fabric-migrationsarkivet.
Anbefalet brug
Brug scripts, når du er fortrolig med T-SQL, foretrækker et integreret udviklingsmiljø og har brug for at styre individuelle migrationsopgaver. Brug COPY INTO Data Factory til at indlæse udtrukket data i Fabric data warehouse.
Overfør ved hjælp af SQL-databaseprojekter
Fabric data warehouse understøttes i SQL Database Projects-udvidelsen til Visual Studio Code.
Et SQL-databaseprojekt tilbyder versionskontrol, databasetestning, skemavalidering og implementeringsmuligheder. Det kan:
- Konverter skema (DDL) til Fabric data warehouse syntaks.
- Opret skema-objekter i Fabric data warehouse.
- Vurder ikke-understøttet T-SQL-syntaks i lagrede procedurer, funktioner og visninger.
Til datamigrering kan du bruge Data Factory til at kopiere direkte fra SQL Server, eller udtrække data til ADLS Gen2 og indtaste dem med COPY INTO eller Data Factory.
For en gennemgang af brugen af SQL-databaseprojekter med migrationsscripts, se fabric-migration-repositoryet.
For mere information, se Kom i gang med SQL Database Projects-udvidelsen og Byg et databaseprojekt fra kommandolinjen.
Migration med dbt
Hvis din SQL Server data warehouse bruger DBT, kan du bruge DBT-adapteren til Fabric data warehouse til at konvertere skema- og databasekode ved at ændre målprofilen og adapteren.
DBT-rammeværket genererer DDL- og DML-scripts ud fra modelfiler. Du skal migrere dataene separat ved at bruge Data Factory eller en anden datamigreringsmulighed i denne artikel.
For at komme i gang, se Tutorial: Opsæt DBT til Fabric data warehouse.
Dataindlæsning i Fabric data warehouse
For staged data kan du bruge COPY INTO eller Fabric Data Factory til at indlæse filer fra ADLS Gen2 til Fabric data warehouse. Overvej følgende vejledning:
- Udtræk store tabeller parallelt, når kildedatabasen og netværket har tilstrækkelig kapacitet.
- Foretræk Parquet-filer for at reducere lager- og netværksbrug samt forbedre indlæsningseffektiviteten.
- Indlæs flere destinationstabeller samtidig, når din Fabric-kapacitet kan understøtte arbejdsbyrden.
- Overvåg både kildeudtrækning og Fabric-kapacitet for at finde den optimale grad af parallelisme.