Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Die Vektorsuche ist eine Möglichkeit, Informationen zu finden, die in einer Datenbank in Form von Vektoren gespeichert sind. Vektoren sind Zahlengruppen, die Funktionen oder Merkmale von Medien darstellen, z. B. Text oder Bilder. Sie erfassen semantische Beziehungen innerhalb der Informationen, wodurch die Ähnlichkeitssuche über den exakten Stichwortabgleich hinaus ermöglicht wird.
Azure bietet mehrere Möglichkeiten zum Speichern und Durchsuchen von vektorisierten Daten. In diesem Artikel können Sie den richtigen Azure Vektorsuchdienst für Ihre Anwendungen auswählen.
Es werden die folgenden Dienste auf Basis ihrer Vektorsuchfunktionen verglichen:
- Azure KI Suche
- Azure Cosmos DB für NoSQL
- Azure DocumentDB
- Azure-Datenbank für PostgreSQL
- Azure Managed Redis
- Azure SQL-Datenbank
Informationen zum Vergleichen der Systemanforderungen für jeden Dienst finden Sie unter Auswählen eines Kandidatendiensts und einer Funktionsmatrix.
Auswählen eines Kandidatendiensts
In diesem Abschnitt können Sie den besten Dienst oder die besten Dienste für Ihre Anforderungen auswählen. Um die Auswahl einzugrenzen, sollten Sie zunächst die Systemanforderungen berücksichtigen.
Wesentliche Anforderungen
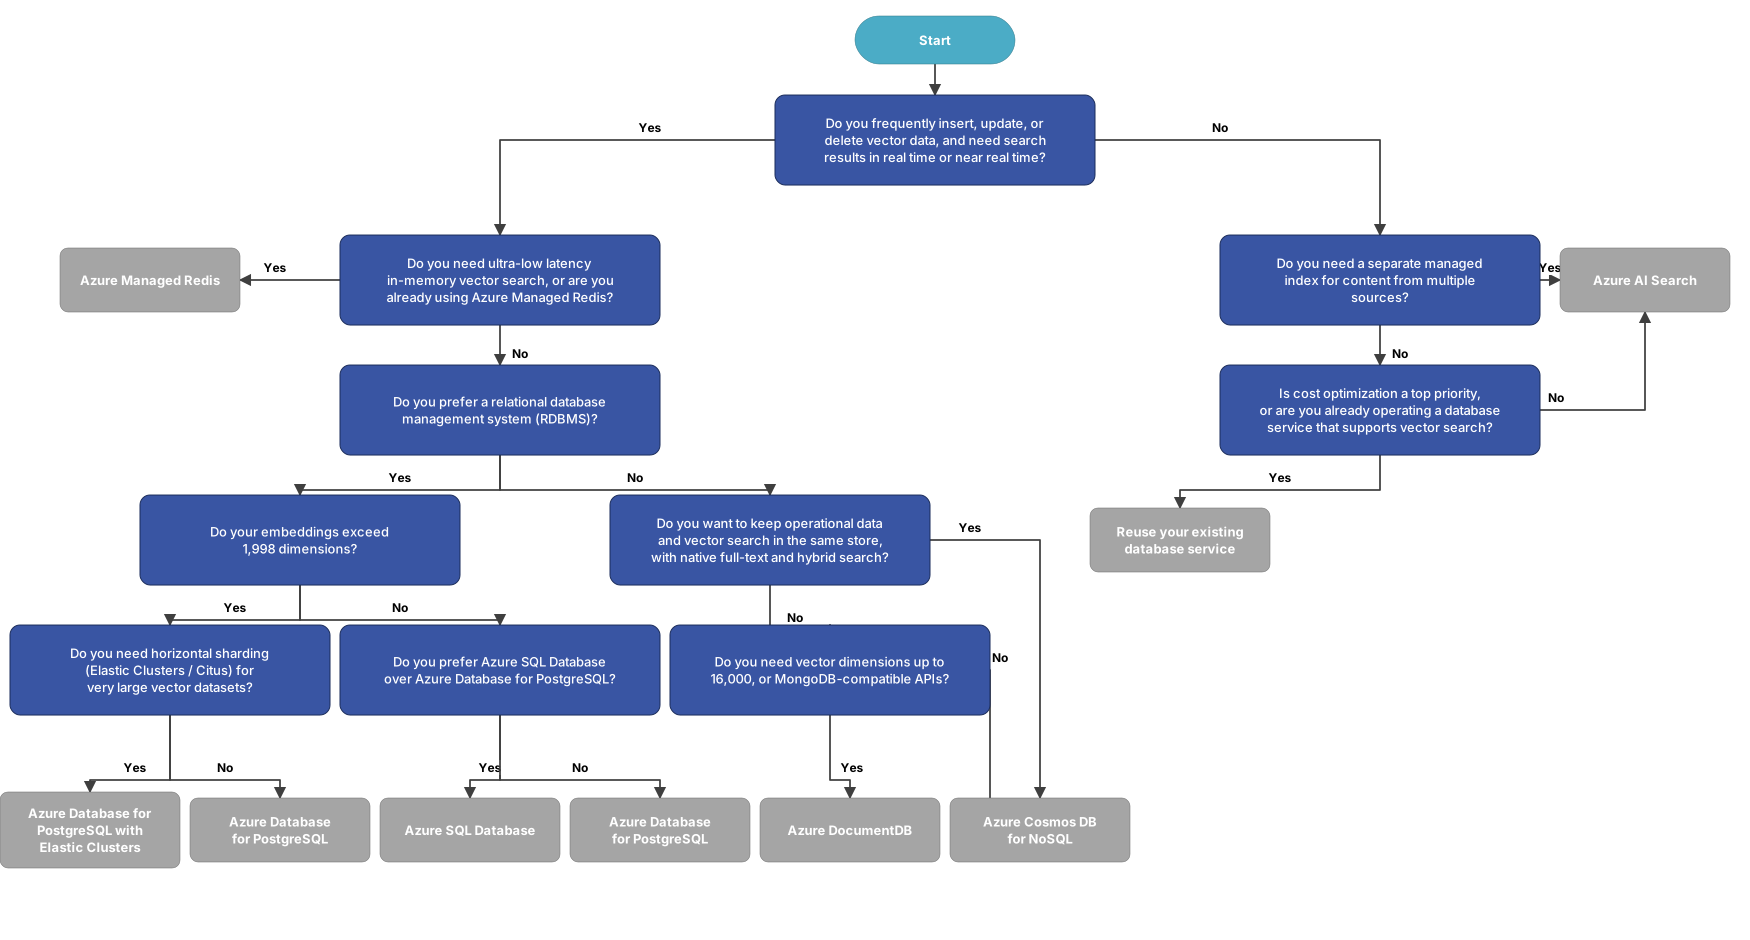
Wenn Sie entscheiden möchten, ob Sie eine herkömmliche Datenbanklösung oder KI-Suche verwenden möchten, berücksichtigen Sie Ihre Anforderungen und ob Sie Live- oder Echtzeitvektorsuchen für Ihre Daten durchführen können. Wenn Sie häufig Werte in vektorisierten Feldern ändern und diese Änderungen in Echtzeit oder in Echtzeit durchsuchbar sein müssen, ist eine herkömmliche relationale oder NoSQL-Datenbank für Ihr Szenario am besten geeignet. Ebenso ist Ihre vorhandene Datenbank möglicherweise die beste Methode, um Ihr Leistungsziel zu erreichen. Wenn Ihre Arbeitsauslastung jedoch keine Echtzeit- oder Nah-Echtzeit-Vektorsuchbarkeit erfordert und Sie einen Index von Vektoren verwalten können, können Sie die KI-Suche verwenden.
Wenn Sie eine herkömmliche Datenbanklösung auswählen, wählen Sie einen Datenbankdienst basierend auf den Fähigkeiten Ihres Teams und Ihren vorhandenen Datenbanken aus. Wenn Sie bereits einen Datenbankdienst wie Azure Cosmos DB für NoSQL verwenden, ist dieser Dienst möglicherweise die einfachste Lösung für Ihr Szenario.
Azure Cosmos DB für NoSQL eignet sich gut, wenn Sie die Betriebsdaten und die Vektorsuche im selben System beibehalten möchten und wenn Sie die Volltextbewertung, hybride Suche oder integrierte Reranking benötigen. Der semantische Reranker befindet sich in der Vorschau. Wenn Ihre Anwendung einen Datensatz und dessen Einbettung zusammen schreibt, müssen Sie keinen separaten Suchindex synchronisieren, bevor Sie das aktualisierte Element abfragen.
DIE KI-Suche ist eine gute Wahl, wenn Sie einen separaten verwalteten Index für Inhalte aus mehreren Quellen benötigen, mit integrierter Vektorisierung und suchspezifischen Features wie Faceting und AutoVervollständigen.
Azure Database for PostgreSQL unterstützt die horizontale Skalierung mithilfe von elastischen Clustern, einem verwalteten Angebot der Open-Source Citus-Erweiterung, die horizontales Sharding unterstützt. Diese Funktion verteilt Vektordaten über mehrere Knoten, die für große Vektordatensets nützlich sein können.
Erwägen Sie Azure Managed Redis, wenn Sie eine In-Memory-Vektorsuche mit extrem niedriger Latenz benötigen oder Redis bereits für Caching oder die Sitzungsverwaltung im Einsatz ist.
Jeder Datenbankdienst verfügt über eindeutige Funktionen und Einschränkungen für die Vektorsuche. Überprüfen Sie, ob der Datenbanktyp über die erforderliche Funktionalität verfügt.
Neue Dienste und zusätzliche Datenbankinstanzen können Kosten und Komplexität erhöhen. Um den Aufwand zu verringern, können Sie Ihr vorhandenes Design weiterhin verwenden. Die Vektorsuche in Ihren aktuellen Datenbanken ist möglicherweise kostengünstiger als ein dedizierter Vektorsuchdienst.
Die Unterstützung für erweiterte Abruffunktionen variiert je nach Dienst. Azure Cosmos DB für NoSQL und Azure DocumentDB bieten eine native Hybridsuche, die die Volltext- und Vektorsuche mithilfe der reziprozialen Rangfusion (RRF) kombiniert. Azure Cosmos DB für NoSQL bietet auch einen semantischen Reranker als Vorschau. AI Search bietet hybride Suche und semantische Rangfolge als verwaltete Suchfunktionen. Implementieren Sie für Dienste, die diese Funktionen nicht bereitstellen, die erforderliche Rangfolgelogik in Der Anwendung oder im Datenbankcode.
Funktionsmatrix
Die Tabellen in diesem Abschnitt fassen Azure Vektorsuchdienstfunktionen zusammen. Vergleichen Sie die verfügbaren Dienste mit Ihren Anforderungen. Einige Dienste eignen sich besser für bestimmte Szenarien. Berücksichtigen Sie daher die in jeder Tabelle angezeigten Trade-Offs.
Wenn Sie in Microsoft Fabric arbeiten, können Sie Real-Time Intelligence für die Vektorähnlichkeitssuche (VSS) verwenden, indem Sie ein Ereignishaus als Vektordatenbank verwenden. Weitere Informationen finden Sie in der Fabric Dokumentation.
Grundlegende Funktionen
Manchmal unterscheidet sich die native Unterstützung für Vektordatentypen, ANN-Vektorindizes (Approximate Nearest Neighbor, ungefährer nächster Nachbar), Vektordimensionsgrenzwerte, mehrere Vektorfelder und mehrere Vektorindizes zwischen den Diensten. Ihre Workload erfordert möglicherweise eine oder mehrere dieser Features.
In der folgenden Tabelle sind die Vektorfunktionen der einzelnen Azure-Dienste aufgeführt.
| Fähigkeit | Azure Cosmos DB für NoSQL-Datenbanklösungen | Azure DocumentDB | Azure-Datenbank für PostgreSQL | Azure Managed Redis | KI-Suche | SQL Database |
|---|---|---|---|---|---|---|
| Integrierte Vektorsuche | Ja | Ja1 | Ja2 | Ja3 | Ja4 | Ja |
| Vektordatentyp | Ja | Ja | Ja | Ja | Ja | Ja5 |
| Dimensionsgrenzwerte6 | 4.0967 oder 505 mit einem flachen Index | 16.0008, 4.000 oder 2.000, je nach Konfiguration | 16.0009 oder 2.000 | 32,768 | 4.09610 | 1.998 11 |
| Mehrere Vektorfelder | Ja | Ja12 | Ja | Ja | Ja | Ja |
| Mehrere Vektorindizes | Ja | Ja13 | Ja | Ja | Ja | Ja |
- Azure DocumentDB unterstützt die Vektorsuche bei Einbettungen.
-
pgvector, eine Erweiterung von PostgreSQL, unterstützt die Vektorsuche. Diepg_diskannErweiterung bietet DiskANN-basierte Vektorindizierung für eine effiziente ANN-Suche in großem Maßstab. - Das RediSearch-Modul in Azure Managed Redis bietet Vektorsuche.
- KI-Suche unterstützt Vektoren.
- SQL-Datenbank unterstützt einen Vektordatentyp.
- OpenAI-Einbettungsmodelle umfassen 1.536 Dimensionen für text-embedding-ada-002 und für text-embedding-3-small und 3.072 Dimensionen für text-embedding-3-large. Azure Vision multimodale Einbettungsmodelle haben 1.024 Dimensionen für Bild und Text.
- Vektoren, die mit dem flachen Indextyp indiziert werden, können bis zu 505 Dimensionen aufweisen. Vektoren, die mithilfe des QuantizedFlat- oder DiskANN-Indextyps indiziert werden, können bis zu 4.096 Dimensionen aufweisen.
- Mithilfe der DiskANN- und Produktquantisierung können Sie Vektoren bis zu 16.000 Dimensionen indizieren. Hierarchical navigable small world (HNSW) oder IVFFlat mit halber Genauigkeit unterstützt Vektorindizes von bis zu 4.000 Dimensionen. Ohne Komprimierung beträgt die standardmäßige maximale Vektordimension für die Indizierung 2.000. Weitere Informationen finden Sie in den Vektorabmessungen für Azure DocumentDB.
- Vektoren können bis zu 16.000 Dimensionen aufweisen. Die Indizierung mithilfe von IVFFlat- und HNSW-Algorithmen unterstützt jedoch Vektoren mit bis zu 2.000 Dimensionen.
- AI Search unterstützt die auf Matryoshka Representation Learning basierende Dimensionstrunkierung. Text-embedding-3-Modelle können Vektordimensionen reduzieren. Sie können beispielsweise 256 oder 512 Dimensionen verwenden.
- SQL-Datenbank unterstützt einen systemeigenen Vektordatentyp mit bis zu 1.998 Dimensionen.
- Jeder Azure DocumentDB-Vektorindex zielt auf einen Vektorpfad ab. Erstellen Sie einen separaten Vektorindex für jedes Vektorfeld, das Sie abfragen müssen.
- Sie können mehrere Indizes in einer Azure DocumentDB-Auflistung erstellen, aber nur ein Vektorindex kann auf einen bestimmten Vektorpfad abzielen.
Suchmethoden
Workloads müssen Vektorsuche häufig mit Volltextsuche oder Hybridsuche kombinieren. Die Hybridsuche ist eine Volltextsuche oder semantische Suche in Kombination mit einer Vektorsuche. In Kombination erzielen hybride Suche und Reranking eine hohe Genauigkeit für Workloads. Sie können die Hybridsuche manuell implementieren und neu gewichten, indem Sie Ihren eigenen Code verwenden, oder Sie können überlegen, wie Ihr Vektorspeicher diese Arbeitslastanforderungen unterstützt.
| Suchmethode | Azure Cosmos DB für NoSQL-Datenbanklösungen | Azure DocumentDB | Azure-Datenbank für PostgreSQL | Azure Managed Redis | KI-Suche | SQL Database |
|---|---|---|---|---|---|---|
| Volltextsuche | Ja12 | Ja2 | Ja3 | Ja4 | Ja | Ja5 |
| Hybridsuche | Ja6 | Ja7 | Ja8 | Ja9 | Ja10 | Ja11 |
| Integrierte Neuanordnung | Ja (Vorschau)13 | Nein | Nein | Nein | Ja1 | Nein |
- Die semantische Rangfolge rerankt Ergebnisse von Volltext- und Vektorsuchen.
- Azure DocumentDB unterstützt die Suche und Abfrage mithilfe von Textindizes.
- PostgreSQL unterstützt die Volltextsuche.
- Azure Managed Redis unterstützt die Volltextsuche mithilfe des Moduls RediSearch, einschließlich Texttokenisierung, Stemming und Relevanzbewertung.
- SQL Server unterstützt die Volltextsuche.
- Azure Cosmos DB für NoSQL unterstützt die Hybridsuche, die BM25-Volltextbewertung und Vektorsuche mithilfe von RRF kombiniert. Sie können den Komponentenbewertungen Gewichtungen zuweisen.
- Azure DocumentDB unterstützt die Hybridsuche nativ, die Volltext- und Vektorsuche mit gegenseitiger Rangfusion kombiniert.
- Die Hybridsuche ist nicht integriert, aber Beispielcode ist verfügbar.
- Azure Managed Redis unterstützt Hybridsuche durch die Verwendung von VSS in Kombination mit Attributfiltern für Text-, numerische, Tag- und Geofelder.
- Die Hybridsuche, die Volltextsuche, Vektorsuche und semantische Rangfolge kombiniert, ist ein Feature in der KI-Suche.
- Ein Beispiel für die Hybridsuche für SQL-Datenbank und SQL Server ist verfügbar.
- Azure Cosmos DB für NoSQL unterstützt die Volltextsuche und die Volltextbewertung.
- Der semantische Reranker für Azure Cosmos DB für NoSQL ist als Vorschau verfügbar. Sie kann die Ergebnisse von Vektor-, Volltext- oder Hybridabfragen mithilfe der unterstützten Azure Cosmos DB SDKs neu ordnen.
Vektordaten-Indizierungsalgorithmen
Die Vektordatenindizierung ist die Möglichkeit, Vektoren effizient zu speichern und abzurufen. Die Indexierung beeinflusst die Geschwindigkeit und Genauigkeit von Ähnlichkeitssuchen und Nächste-Nachbarn-Abfragen in Datenquellen.
Indizes verwenden in der Regel entweder einen vollständigen k-nächstgelegenen Nachbaralgorithmus (Ek-NN) oder einen ANN-Algorithmus. Ek-NN führt eine vollständige Suche über alle Datenpunkte durch und gibt die exakten k nächsten Nachbarn zurück. Beim Durchsuchen einer kleinen Datenmenge funktioniert Ek-NN in Millisekunden. Bei größeren Datasets treten möglicherweise Latenzen auf.
DiskANN, HNSW und IVFFlat sind ANN-Algorithmusindizes. Die Auswahl der geeigneten Indizierungsstrategie erfordert eine sorgfältige Prüfung verschiedener Faktoren, z. B. die Art des Datasets, die spezifischen Anforderungen der Abfragen und die verfügbaren Ressourcen. DiskANN kann sich Änderungen im Dataset anpassen und Rechenressourcen sparen. HNSW eignet sich hervorragend für Systeme, die schnelle Abfrageantworten erfordern und sich an Änderungen im Dataset anpassen können. IVFFlat ist in Umgebungen wirksam, in denen Hardwareressourcen begrenzt sind oder Abfragevolumen nicht hoch sind.
In der folgenden Tabelle sind die verfügbaren Vektordatenindizierungstypen aufgeführt.
| Indizierungsansatz | Azure Cosmos DB für NoSQL-Datenbanklösungen | Azure DocumentDB | Azure-Datenbank für PostgreSQL | Azure Managed Redis | KI-Suche | SQL Database |
|---|---|---|---|---|---|---|
| DiskANN | Ja | Ja1 | Ja2 | Nein | Nein | Ja3 |
| Ek-NN | Ja | Ja | Ja | Ja4 | Ja | Ja |
| HNSW | Nein | Ja1 | Ja | Ja5 | Ja | Nein |
| IVFFlat | Nein | Ja | Ja | Nein | Nein | Nein |
| Andere | Flat, quantizedFlat6 | Ein Vektorfeld und Index pro Pfad78 | - | - | Skalare Quantisierung, binäre Quantisierung9 | - |
- Weitere Informationen finden Sie im integrierten Vektorspeicher in Azure DocumentDB.
- Weitere Informationen finden Sie unter DiskANN für Azure Database for PostgreSQL.
- Native DiskANN-Vektorindizierung befindet sich in der Vorschau. Weitere Informationen finden Sie unter Vektorsuche und Vektorindizes in der SQL-Datenbank-Engine.
- Azure Managed Redis unterstützt die Ek-NN-Suche unter Verwendung des FLAT-Indextyps für die Brute-Force-Suche.
- Azure Managed Redis unterstützt HNSW für ANN-Suche. Weitere Informationen finden Sie unter VSS.
- Weitere Informationen finden Sie unter Vektorindizierungsrichtlinien.
- Die Indizierung gilt nur für einen Vektor pro Pfad.
- Sie können nur einen Index pro Vektorpfad erstellen.
- KI-Suche unterstützt skalare und binäre Quantisierung , um die Vektorgröße in einem Suchindex zu reduzieren.
Ähnlichkeits- und Abstandsberechnungsfunktionen
Die Vektorsuche unterstützt Kosinus-Ähnlichkeit, Punktprodukt und Euklidische Entfernungsberechnungsmethoden . Verwenden Sie diese Methoden, um die Ähnlichkeit oder den Abstand zwischen zwei Vektoren zu berechnen.
Bei der vorläufigen Datenanalyse werden Metriken und Euklidean-Entfernungen verwendet, sodass Sie eine Vielzahl von Datenstrukturerkenntnissen extrahieren können. Die Textklassifizierung funktioniert in der Regel bei euklidischen Entfernungen besser. Der Abruf der am ehesten ähnlichen Texte mit einem bestimmten Text funktioniert in der Regel besser mit Kosinusähnlichkeit.
Azure OpenAI-Einbettungen basieren auf der Kosinusähnlichkeit zur Berechnung der Ähnlichkeit zwischen Dokumenten und einer Abfrage.
| Integrierte Vektorvergleichsberechnung | Azure Cosmos DB für NoSQL-Datenbanklösungen | Azure DocumentDB | Azure-Datenbank für PostgreSQL | Azure Managed Redis | KI-Suche | SQL Database |
|---|---|---|---|---|---|---|
| Kosinusähnlichkeit | Ja1 | Ja | Ja | Ja2 | Ja | Ja3 |
| Euklidischer Abstand | Ja1 | Ja | Ja | Ja2 | Ja | Ja3 |
| Skalarprodukt | Ja1 | Ja | Ja | Ja2 | Ja | Ja3 |
- Weitere Informationen finden Sie in der Vektorabstandsberechnung für Azure Cosmos DB für NoSQL.
- Azure Managed Redis unterstützt Kosinusgleichheit, Euklidean-Entfernung und innere Produktabstandsmetriken. Weitere Informationen finden Sie unter VSS.
- Weitere Informationen finden Sie in den Beispielen für die Entfernungsberechnung für SQL-Datenbank und SQL Server.
Integration in Azure OpenAI und andere Komponenten
Sie können die Vektorsuche mit anderen Microsoft Komponenten verknüpfen. Mit Azure OpenAI können Sie beispielsweise Vektoren für Ihre Daten und Eingabeabfragen für VSS erstellen.
| Fähigkeit | Azure Cosmos DB für NoSQL-Datenbanklösungen | Azure DocumentDB | Azure-Datenbank für PostgreSQL | Azure Managed Redis | KI-Suche | SQL Database |
|---|---|---|---|---|---|---|
| Foundry IQ-Integration | Nein | Nein | Nein | Nein | Ja | Nein |
| Integration des Foundry Agent-Diensts | Ja1 | Nein | Ja2 | Ja2 | Ja3 | Ja2 |
| Integrierte Generierung von Azure OpenAI-Embeddings | Nein | Nein | Ja4 | Nein | Ja5 | Ja6 |
| Integration des semantischen Kerns | Ja7 | Ja8 | Ja9 | Ja10 | Ja11 | Ja12 |
- Die Integration des Foundry Agent Service wird über den Agentstatusspeicher bereitgestellt.
- Die Integration des Foundry Agent Service wird über Daten, Vektorsuche oder Toolzugriff bereitgestellt.
- Die Integration des Foundry Agent Service wird über die Wissensabruf- und Vektorsuche bereitgestellt.
- Die Azure AI-Erweiterung ist verfügbar.
- DIE KI-Suche enthält eine Fähigkeit, mit der Textblöcke vektorisiert werden.
- Sie können eine gespeicherte Prozedur für die Bereitstellung Ihres Einbettungsmodells erstellen.
- Dieser Dienst wird als Speicherconnector und als Vektordatenbankconnector unterstützt. Weitere Informationen finden Sie in der C#-Dokumentation und in der Python Dokumentation.
- Dieser Dienst wird als Vektordatenbankconnector unterstützt. Weitere Informationen finden Sie in der C#-Dokumentation und in der Python Dokumentation.
- Dieser Dienst wird als Speicherconnector und als Vektordatenbankconnector unterstützt. Weitere Informationen finden Sie in der C#-Dokumentation.
- Dieser Dienst wird als Vektordatenbankconnector unterstützt. Weitere Informationen finden Sie unter Verwenden des Redis-Connectors.
- Dieser Dienst wird als Speicherconnector und als Vektordatenbankconnector unterstützt. Weitere Informationen finden Sie in der C#-Dokumentation und in der Python Dokumentation.
- Dieser Dienst wird als Speicherconnector unterstützt.
Überlegungen zur Verwendung
Die Funktionsmatrix identifiziert Dienste, die Ihren funktionalen Anforderungen entsprechen. Wenn mehrere Dienste qualifiziert sind, vergleichen Sie, wie sich jede Option auf die Datenplatzierung, Aktualität, Filterung, Kapazität und Einbettungswartung auswirkt.
Datenplatzierung und Aktualität
Azure Cosmos DB für NoSQL, Azure DocumentDB, Azure Database for PostgreSQL und Azure SQL-Datenbank können Einbettungen mit den Betriebsdatensätzen der Workload speichern. Wenn Ihre Anwendung eine Einbettung generiert und mit dem Datensatz schreibt, werden beide Werte über den Datenbankschreibpfad aktualisiert. Dieser Entwurf vermeidet einen separaten Suchindexsynchronisierungsprozess.
AI Search verwaltet einen Vom Quellsystem getrennten Suchindex. Sie können Dokumente an den Index übertragen oder einen Indexer verwenden, um Daten aus einer unterstützten Datenquelle abzurufen. Mit einem separaten Index können Sie Inhalte aus mehreren Systemen kombinieren und gestalten und den Abruf unabhängig von Transaktionsworkloads skalieren. Außerdem wird eine weitere Kopie der durchsuchbaren Daten erstellt. Berücksichtigen Sie die Zeit zwischen einer Quellaktualisierung und der entsprechenden Indexaktualisierung.
Wählen Sie ein kolokalisiertes Design, wenn sich operative Datensätze häufig ändern und beim Abrufen die aktualisierten Werte verwendet werden müssen. Wählen Sie einen separaten Suchindex aus, wenn sich der Korpus über mehrere Systeme erstreckt oder verwaltete Inhaltsextraktion, Anreicherung und Vektorisierung erfordert.
Filtern und Partitionieren
Die meisten Produktionsvektorabfragen verwenden Filter, um Mandanten-, Sicherheits-, Dokumentenmappen- oder Anwendungsgrenzen zu erzwingen. Wertet Filter mit der Vektorsuche aus, da sie sowohl den Rückruf als auch die Latenz beeinflussen können.
- Fügen Sie in Azure Cosmos DB für NoSQL der
WHERE-Klausel einer Abfrage, dieVectorDistanceverwendet, unterstützte Prädikate hinzu. Ein Partitionsschlüsselfilter beschränkt die Suche auf die übereinstimmende logische Partition. - Fügen Sie in Azure DocumentDB dem
cosmosSearchOperator unterstützte Filter hinzu. - Erstellen Sie in der KI-Suche filterbare nicht Vektorfelder, und verwenden Sie Vektorfiltermodi , um zu steuern, ob der Dienst einen Filter vor oder nach dem Vektorabruf anwendet.
Kapazität und regionale Gestaltung
Die Dienste verwenden unterschiedliche Skalierungs- und Abrechnungseinheiten, sodass Listenpreisvergleiche die Kosten einer bestimmten Workload nicht anzeigen. Modellindexgröße, Vektorabmessungen, Abfragerate, Aktualisierungsrate, Replikate, Partitionen und Datenbankdurchsatz. Schließen Sie die Kosten der Quelldatenbank ein, wenn Sie einen separaten Suchindex auswerten.
Regionales Design unterscheidet sich ebenfalls:
- Azure Cosmos DB bietet integrierte Datenverteilung über Azure Regionen hinweg und unterstützt mehrere Schreibbereiche.
- AI Search ist ein regionaler Dienst. Ein Multiregion-AI-Search-Design verwendet in jeder Region einen Suchdienst und erfordert einen Prozess, der die Indizes synchron hält.
Einbettungen auf dem aktuellen Stand halten
Einbettungen sind abgeleitete Daten. Generieren Sie sie neu, wenn sich der Quellinhalt ändert oder wenn Sie ein anderes Einbettungsmodell übernehmen.
Indexer für die KI-Suche können Chunking und integrierte Vektorisierung für unterstützte Quellen orchestrieren. Bei einem datenbankzentrierten Entwurf führt Ihre Anwendung oder Datenpipeline diese Schritte aus und schreibt die resultierenden Vektoren. Ein Änderungsfeed oder ein Quellereignis kann diesen Prozess starten, der neue Inhalt kann jedoch erst semantisch durchsucht werden, wenn die aktualisierte Einbettung gespeichert wird.
Beitragende
Microsoft verwaltet diesen Artikel. Die folgenden Mitwirkenden haben diesen Artikel geschrieben.
Hauptautoren:
- Yu Saito | Lösungstechniker
- Miho Yamamoto | Senior Solution Engineer
Andere Mitwirkende:
- Keita Onabuta | Senior Solution Engineer
- Manish Sharma | Hauptprogramm-Manager
Um nicht-öffentliche LinkedIn-Profile anzuzeigen, melden Sie sich bei LinkedIn an.
Nächste Schritte
- Intelligente Anwendungen und KI
- VSS mithilfe von Azure SQL und Azure OpenAI
- Native Vektorunterstützung in Azure SQL und SQL Server
- Vektordatenbank in Azure Cosmos DB
- VSS in Azure Managed Redis
- Vectorsuche in Azure KI-Suche
- Vektorsuche in Azure Cosmos DB für NoSQL