Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Ein benutzerdefinierter Text-zu-Sprache-Avatar ermöglicht es Ihnen, einen benutzerdefinierten und einzigartigen synthetisch sprechenden Avatar für Ihre Anwendung zu erstellen. Mit benutzerdefiniertem Text zu Sprach-Avatar können Sie einen einzigartigen und natürlichen Avatar für Ihr Produkt oder Ihre Marke erstellen. Der Avatar ist noch realistischer, wenn Sie auch eine professionelle Stimme oder Sprachsynchronisierung für avatar für denselben Akteur verwenden.
Es gibt zwei Arten von benutzerdefinierten Text-zu-Sprache-Avataren.
- Benutzerdefinierter Video-Avatar: wird von Ihren bereitgestellten Videoaufzeichnungsdaten Ihrer ausgewählten Schauspieler erstellt.
- Benutzerdefinierter Foto-Avatar: wird von Ihrem bereitgestellten Bild erstellt.
Wichtig
Der Zugriff auf den benutzerdefinierten Text-zu-Sprache-Avatar ist auf der Grundlage von Berechtigungs- und Nutzungskriterien eingeschränkt. Fordern Sie den Zugriff über das Aufnahmeformular an.
Wichtig
Der Zugriff auf einen benutzerdefinierten Foto-Avatar, der Teil von benutzerdefiniertem Text zu Sprach avatar ist, ist auf der Grundlage von Berechtigungs- und Nutzungskriterien begrenzt. Erfahren Sie hier mehr, und fordern Sie Zugriff auf das Aufnahmeformular an.
Wie funktioniert es?
Das Erstellen eines benutzerdefinierten Video-Avatars erfordert mindestens 10 Minuten Videoaufzeichnung des Avatar-Talents als Schulungsdaten, und Sie müssen zuerst die Zustimmung des Schauspielertalents erhalten.
Das Erstellen eines benutzerdefinierten Foto-Avatars erfordert nur ein Foto des Zeichens. Wenn das Foto von einer echten Person ist, müssen Sie zuerst seine Zustimmung einholen.
Das benutzerdefinierte Avatarmodell kann Folgendes unterstützen:
- Videogenerierung über die Batchsynthese-API
- Livechat über die Streamingsynthese-API
Berücksichtigen Sie folgende Überlegungen, bevor Sie loslegen:
Ihr Anwendungsfall: Möchten Sie den Avatar verwenden, um Videoinhalte wie Schulungsmaterial oder eine Produkteinführung zu erstellen? Möchten Sie den Avatar als virtueller Verkäufer in Echtzeit mit Ihren Kunden verwenden? Es gibt für die unterschiedlichen Anwendungsfälle einige Voraussetzungen bezüglich der Aufzeichnungen.
Das Aussehen des Avatars: Der benutzerdefinierte Text-zu-Sprache-Avatar gleicht dem Avatar-Darsteller der Trainingsdaten. Das Anpassen des Aussehens des Avatarmodells, z. B. Kleidung, Frisuren usw. wird nicht unterstützt. Wenn Ihre Anwendung also verschiedene Erscheinungsbilder desselben Avatars erfordert, sollten Sie Trainingsdaten für jedes Erscheinungsbild vorbereiten, da sie als individuelle Avatarmodelle betrachtet werden.
Die Stimme des Avatars: Der benutzerdefinierte Text für den Avatar kann mit Standardstimme, professioneller Stimme oder Sprachsynchronisierung für Avatare verwendet werden.
- Sprachsynchronisierung für Avatar: Eine synthetische Stimme, die der Stimme des Avatar-Talents ähnelt, wird zusammen mit dem benutzerdefinierten Avatar mit Audio aus dem Schulungsvideo trainiert. Die Sprachsynchronisierung für Avatare wird derzeit nur für benutzerdefinierte Video-Avatare unterstützt.
- Professionelle Stimme: Optimieren Sie eine professionelle Stimme mit mehr Schulungsdaten und bieten Sie eine Premium-Spracherfahrung für Ihren Avatar, einschließlich natürlicher Unterhaltungen, vielseitiger und mehrsprachiger Unterstützung.
Übersicht über die Schritte zum Erstellen eines benutzerdefinierten Video-Avatars:
Video zum Erhalten einer Einwilligung. Erhalten Sie eine Videoaufzeichnung des Talents, das eine Einwilligungserklärung liest. Sie müssen der Nutzung ihrer Bild- und Sprachdaten zustimmen, um ein benutzerdefiniertes Text-zu-Sprache-Avatar-Modell zu trainieren. Wenn erwartet wird, dass die Sprachsynchronisierung für Avatare mit einem benutzerdefinierten Video-Avatarmodell trainiert wird, müssen sie auch der Verwendung ihrer Sprachdaten zustimmen, um eine synthetische Version ihrer Stimme zu trainieren.
Vorbereiten von Trainingsdaten. Stellen Sie sicher, dass die Videoaufzeichnung das richtige Format hat. Es ist ratsam, die Videoaufnahme in einem professionellen Studio aufzuzeichnen, um ein sauberes Hintergrundbild zu erhalten. Die Qualität des resultierenden Avatars hängt stark von dem aufgezeichneten Video ab, das für das Training verwendet wird. Faktoren wie Sprechgeschwindigkeit, Körperhaltung, Gesichtsausdruck, Gesten, konsistente Position des Akteurs und Beleuchtung sind bei der Videoaufzeichnung unerlässlich, um einen ansprechenden benutzerdefinierten Text-zu-Sprache-Avatar zu erstellen. Ausführlichere Informationen finden Sie unter Vorbereiten von Trainingsdaten.
Trainieren des Avatarmodells. Wenn die Daten vorbereitet wurden, laden Sie Ihre Daten in das benutzerdefinierte Avatar-Portal hoch, und beginnen Sie mit dem Training Ihres Modells. Die Einwilligungsüberprüfung erfolgt während des Trainings. Stellen Sie sicher, dass Sie Zugriff auf das Feature für den benutzerdefinierten Sprachsynthese-Avatar haben, bevor Sie ein Projekt erstellen.
Bereitstellen und Verwenden Ihres Avatarmodells in Ihren Anwendungen
Übersicht über die Schritte zum Erstellen eines benutzerdefinierten Foto-Avatars:
Sie können einen benutzerdefinierten Foto-Avatar im Microsoft Foundry-Portal aus einem einzigen Referenzbild erstellen. Für den Ablauf ist kein manueller Offlineeinrichtungsprozess erforderlich.
Vorbereiten von Trainingsdaten. Ein benutzerdefinierter Foto-Avatar kann entweder mit dem Foto einer realen Person oder mit einem virtuellen menschlichen Bild trainiert werden. Details finden Sie unter Erstellen eines benutzerdefinierten Foto-Avatars .
Video zum Erhalten einer Einwilligung. Erhalten Sie ein Video des Talents, das eine Einwilligungserklärung liest. Dies ist erforderlich, wenn ein Foto-Avatar aus dem Foto einer realen Person trainiert wird. Sie müssen die Zustimmung für die Verwendung ihres Bilds geben, um ein benutzerdefiniertes Foto-Avatarmodell zu trainieren.
Erstellen und verwenden Sie das Avatarmodell. Beginnen Sie im Foundry-Projekt mit der Erstellung eines benutzerdefinierten Foto-Avatars und verwenden Sie das resultierende Avatarmodell mit Batch- oder Echtzeitsynthese.
Komponentensequenz
Das benutzerdefinierte Text-zu-Sprache-Avatarmodell enthält drei Komponenten: die Textanalyse, den Text-zu-Sprache-Audiosynthesizer und den Videorenderer des Text-zu-Sprache-Avatars.
- Um eine Avatar-Videodatei oder -Stream mithilfe des Avatarmodells zu generieren, wird zunächst Text zuerst in die Textanalyse eingegeben. Als Ausgabe wird eine Phonemsequenz bereitgestellt.
- Der Audiosynthesizer synthetisiert das Sprach-Audio für den Eingabetext, und diese beiden Komponenten werden von Standard- oder benutzerdefinierten Sprachmodellen bereitgestellt.
- Schließlich prognostiziert das Text-zu-Sprache-Avatarmodell das Bild der Lippensynchronisierung mit dem Sprachaudio, sodass das synthetische Video generiert wird.
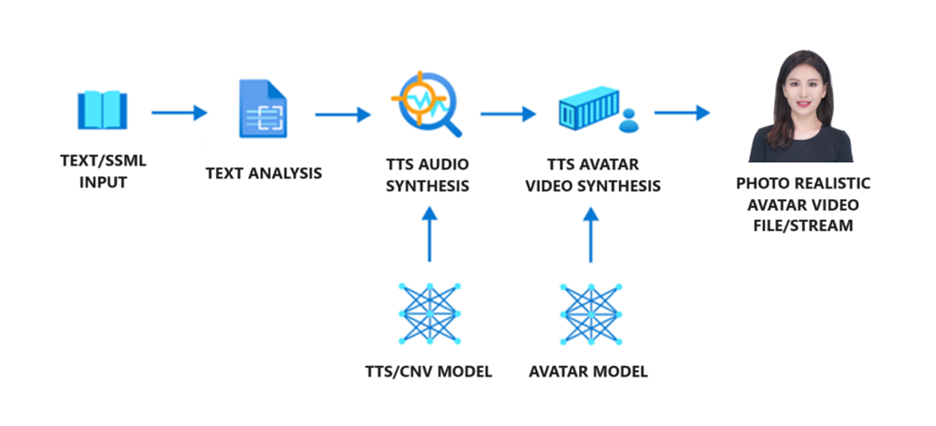
Die Text-zu-Sprache-Avatarmodelle werden mithilfe tiefer neuronaler Netzwerke basierend auf den Aufzeichnungsbeispielen von Videos mit Menschen in verschiedenen Sprachen trainiert. Alle Sprachen mit Standardstimmungen und benutzerdefinierten Stimmen können unterstützt werden.
Verfügbar Speicherorte
Die aktuelle Liste der Regionen, die benutzerdefinierte Avatarschulungen und -nutzung unterstützen, finden Sie in der Tabelle "Sprachdienstbereiche".
Benutzerdefinierte Stimme und benutzerdefinierter Text-zu-Sprache-Avatar
Benutzerdefinierte Stimme und benutzerdefinierter Text-zu-Sprache-Avatar sind separate Funktionen. Sie können diese unabhängig oder gemeinsam verwenden. Wenn Sie auch eine professionelle Stimme für den Schauspieler schaffen, kann der Avatar sehr realistisch sein.
Der benutzerdefinierte Text-zu-Sprache-Avatar kann mit einer Standardstimme oder einer benutzerdefinierten Stimme als Stimme des Avatars genutzt werden. Weitere Informationen finden Sie unter Avatarstimme und -sprache.
Es gibt zwei Arten von benutzerdefinierter Stimme für einen benutzerdefinierten Avatar:
- Sprachsynchronisierung für Avatar: Wenn Sie während des Trainings des angepassten Video-Avatars die Option Stimmensynchronisation für Avatar aktivieren, wird ein synthetisches Stimmenmodell, das dem Talent des Avatars ähnelt, gleichzeitig mit dem Avatar trainiert. Diese Stimme ist ausschließlich dem benutzerdefinierten Video-Avatar zugeordnet und kann nicht unabhängig verwendet werden. Unterstützte Regionen finden Sie in der Tabelle "Sprachdienstbereiche".
- Professionelle Stimme: Sie können eine professionelle Stimme optimieren. Professionelle Sprachoptimierung und benutzerdefinierter Text zu Sprach-Avatar sind separate Features. Sie können diese unabhängig oder gemeinsam verwenden. Wenn Sie sich dafür entscheiden, sie zusammen zu verwenden, müssen Sie sich separat für professionelle Sprach-Feinabstimmung und benutzerdefinierten Text-zu-Sprache-Avatar bewerben, und Sie werden separat für professionelle Sprach-Feinabstimmung und benutzerdefinierten Text-zu-Sprache-Avatar berechnet. Weitere Informationen hierzu finden Sie in der Preisübersicht. Wenn Sie außerdem beabsichtigen, professionelle Sprach-Feinabstimmung mit einem Text-zu-Sprache-Avatar zu verwenden, müssen Sie Ihr benutzerdefiniertes Sprachmodell in eine der unterstützten Regionen für Avatare bereitstellen oder kopieren.
Wenn Sie eine professionelle Stimme optimieren und sie zusammen mit dem benutzerdefinierten Avatar verwenden möchten, achten Sie auf die folgenden Punkte:
- Stellen Sie sicher, dass der benutzerdefinierte VoIP-Endpunkt in derselben Microsoft Foundry-Ressource wie der benutzerdefinierte Avatarendpunkt erstellt wird. Lesen Sie bei Bedarf den Abschnitt Trainieren ihres professionellen Sprachmodells, um das Custom Voice-Modell in dieselbe Microsoft Foundry Ressource wie den benutzerdefinierten Avatarendpunkt zu kopieren.
- Die Option für benutzerdefinierte Stimmen finden Sie in der Stimmenliste auf der Seite zur Erstellung von Avatar-Inhalten und in den Live-Chat-Spracheinstellungen.
- Wenn Sie die Batchsynthese für die Avatar-API verwenden, fügen Sie die Eigenschaft
"customVoices"hinzu, um die Bereitstellungs-ID des Custom Voice-Modells dem Sprachnamen in der Anforderung zuzuordnen. Weitere Informationen finden Sie unter Sprachsyntheseeigenschaften. - Wenn Sie die Echtzeitsynthese für die Avatar-API verwenden, lesen Sie unseren Beispielcode auf GitHub, um die benutzerdefinierte Stimme festzulegen.