Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Migrieren Sie Ihre Workloads von klassischem Compute zu serverloser Berechnung. Serverlose Berechnungsdienste übernehmen automatisch die Bereitstellung, Skalierung, Laufzeitupgrades und Optimierung.
Die meisten klassischen Workloads können mit minimalen oder ohne Codeänderungen migriert werden. Diese Seite konzentriert sich auf diese Workloads. Einige Features, wie z. B. df.cache, werden auf serverlosen Plattformen noch nicht unterstützt, erfordern aber keine Codeänderungen, sobald sie verfügbar sind. Bestimmte Workloads, die von R- oder Scala-Notizbüchern abhängen, erfordern eine klassische Berechnung und können nicht ohne Server migriert werden. Eine vollständige Liste der aktuellen Einschränkungen finden Sie unter Serverless Compute Limitations.
Migrieren Sie mit dem Migrationsagenten
Important
Dieses Feature befindet sich in der Betaversion. Workspace-Administratoren können sie über die Vorschauseite aktivieren, indem sie sich für die Compute Agent-Vorschau entscheiden. Siehe Manage Azure Databricks Previews.
Du kannst einen Migrationsagenten nutzen, um ein einzelnes Notizbuch oder einen Job auf serverlose Rechenleistungen zu migrieren. Der Agent überprüft die Umgebung der Arbeitslast, Bibliotheken, Spark-Konfigurationen, Tags und Code und schlägt dann jede Änderung als individuellen Vorschlag vor, den Sie akzeptieren oder ablehnen können. Akzeptierte Änderungen werden an Ort und Stelle angewendet und können rückgängig gemacht werden.
Was der Makler überprüft und ändert
| Region | Was der Agent tut |
|---|---|
| Umwelt und Bibliotheken | Übersetzt Bibliotheksinstallationen in eine Spezifikation für eine serverlose Umgebung, einschließlich %pip-Installationen, Cluster-Init-Skripten, Cluster-Bibliotheken in Jobs und Verweise auf einen privaten Paketindex. |
| Umgebungsvariablen | Übersetzt Clusterumgebungsvariablen in ihre serverlosen Entsprechungen, bewahrt Workspace-Secret-Referenzen und lässt plattformverwaltete Werte weg. |
| Daten- und Speicherzugriff | Schreibt serverlos-inkompatible Pfade, wie lokale Festplatte dbfs:/und Mount-Pfade, auf Unity Catalog-Volumes um. Der Agent führt eindeutige Umschreibungen automatisch an und bittet Sie, ein Volumen auszuwählen, wenn das Ziel unklar ist. |
| Spark-Konfigurationen | Klassifiziert jede Spark-Konfiguration, kommentiert Konfigurationen, die sicher zum Entfernen sind, und markiert und entfernt Konfigurationen, die serverless nicht unterstützt. Deckt sowohl clustergebundene als auch In-Notebook-Konfigurationen ab. |
| Workloadcode | Schreibt Code, den serverless nicht unterstützt, in kompatible Äquivalente um, wie RDD-Operationen, die in DataFrame-Operationen umgeschrieben werden, und passt den Code an das ANSI-Mode-SQL-Verhalten auf serverless an. |
| Stichwörter | Übersetzt benutzerdefinierte Cluster-Tags, wie zum Beispiel einen Cost-Center-Tag, in deren serverlose Äquivalente. |
| Leistungsmodus | Schlägt einen Leistungsmodus basierend auf der Konfiguration des Clusters vor. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus". |
Anforderungen
Ein Workspace-Admin-Zugriff wird empfohlen, um eine vollständige Migration sicherzustellen. Das liegt daran, dass der Agent auch globale Init-Skripte auf Arbeitsflächenebene über die Zielarbeitslast hinaus inspiziert. Du kannst möglicherweise migrieren, wenn du über die Berechtigung
CAN MANAGEfür die Arbeitslast verfügst, aber ohne Administratorrechte kann es zu fehlenden Bibliotheken, Umgebungseinstellungen oder Tags kommen.Bestätigen Sie, dass Sie Zugang zum Agenten haben. Gib Genie-Code
/computeein./computesollte im Autovervollständigungsmenü erscheinen. Wenn sie nicht angezeigt wird, muss ein Workspace-Administrator die Vorschau in Ihrem Workspace aktivieren.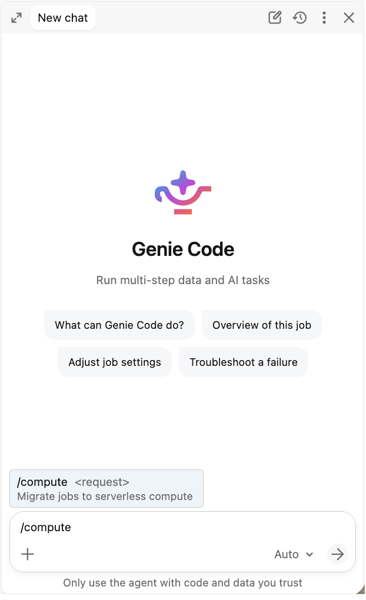
Notebook migrieren
- Öffne das Notizbuch, das du migrieren möchtest.
- Öffne Genie Code und starte
/compute migrate to serverlessaus der/Befehlspalette. - Überprüfen Sie die Erkenntnisse des Agenten. Der Agent scannt die Umgebung, die Bibliotheken und den Code des Notebooks und schlägt für jedes benötigte Element eine Änderung vor, wie zum Beispiel das Verschieben einer Bibliotheksinstallation in eine Umgebungsspezifikation oder das Umschreiben einer Codezelle für serverlosen Betrieb.
- Akzeptieren oder lehnen Sie jede vorgeschlagene Änderung ab.
- Wenden Sie die von Ihnen akzeptierten Änderungen an. Sie werden direkt im Notebook geschrieben.
- Verbinde das Notebook mit Serverless und lasse es laufen, um sicherzugehen, dass es sich wie erwartet verhält. Siehe Überprüfung einer migrierten Arbeitslast.
Einen Job migrieren
- Öffne den Job, zu dem du wechseln möchtest.
- Öffne Genie Code und starte
/compute migrate to serverlessaus der/Befehlspalette. - Der Agent klont deinen Job und versucht, den geklonten Job auf serverlos zu migrieren.
- Überprüfen Sie die Ergebnisse des Agenten. Für einen Multitask-Job zählt der Agent jede Aufgabe und deren Cluster-Konfiguration pro Aufgabe auf und schlägt Änderungen für jeden vor, während der Zeitplan des Jobs erhalten bleibt.
- Akzeptieren oder lehnen Sie jede vorgeschlagene Änderung auf der Migrationsfläche ab: Umgebung und Bibliotheken, Spark-Konfigurationen und jeglichen Workload-Code, der geändert werden muss.
- Wenden Sie die von Ihnen akzeptierten Änderungen an. Die Rechenkapazität des Jobs wird auf Serverless umgestellt.
- Führe den Job serverlos aus und bestätige die Ergebnisse. Siehe Überprüfung einer migrierten Arbeitslast.
- Optional kann der Agent als letzten Schritt den migrierten Klon heraufstufen. Es kopiert die Konfiguration und Notizbücher des Klons zurück auf deinen ursprünglichen Job (wobei die gleiche Job-ID, der Zeitplan und die Berechtigungen bebleiben), und löscht dann den Klon. Wenn du die Heraufstufung überspringst und beide Jobs behältst, pausiere den Zeitplan des Jobs, den du nicht ausführst; andernfalls löst derselbe Trigger beide aus und kann doppelte Schreibvorgänge oder andere Nebenwirkungen verursachen.
Verifizieren Sie eine migrierte Arbeitslast
Der Agent schlägt Änderungen vor und setzt sie um, führt aber deinen Workload nicht aus und überprüft die Ausgabe nicht. Führe immer eine migrierte Workload serverlos aus und überprüfe die Ergebnisse, bevor du darauf angewiesen bist, besonders bei Workloads, die in Produktionstabellen schreiben. Wenn der Makler eine Änderung vorschlägt, die falsch aussieht, lehnen Sie sie ab und schicken Sie uns Feedback, damit wir den Makler verbessern können. Siehe "Produktfeedback übermitteln".
Tip
Während du eine migrierte Arbeitslast validierst, führe sie im leistungsoptimierten Modus aus. Er startet schneller als im Standardmodus, sodass du schnelleres Feedback bekommst, wenn du das Ergebnis bestätigt. Wechsle zu dem Modus, der am besten zur Arbeitslast passt, bevor du es in der Produktion ausführst. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus".
Wenn der Agent etwas findet, das er nicht sicher migrieren kann, meldet er einen Blocker und stoppt standardmäßig. Sie können explizit anweisen, bestimmte Kompatibilitäts- oder Abhängigkeitsblocker zu übergehen, akzeptieren damit jedoch das Risiko, dass diese Abhängigkeiten, die Kostenzuordnung oder das Laufzeitverhalten nicht erhalten bleiben und die Arbeitslast in serverlosen Umgebungen fehlschlagen kann.
Migrationsänderungen rückgängig machen
Die Änderungen, die der Agent vornimmt, sind rückgängig.
Für ein Notizbuch öffne es und stelle die Version von kurz vor der Migration wieder her. Siehe Versionsverlauf in Databricks-Notizbüchern.
Bei einem Auftrag wurde dein ursprünglicher Auftrag nie geändert, wenn du den migrierten Klon nicht befördert hast: führe ihn wie zuvor aus und lösche den Klon. Wenn Sie den Klon heraufgestuft haben, stellen Sie ihn aus dem Backup wieder her, das der Agent erstellt hat, bevor er Änderungen vorgenommen hat:
- Öffnen Sie den Backup-Ordner in Ihrem Arbeitsbereich Home:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. Der Agent zeigte diesen Weg während der Wanderung. Wenn es mehrere Zeitstempel gibt, wähle den, der kurz vor der Migration war. - Öffne
job.yaml, das deine Jobeinstellungen vor der Migration enthält, und wende diese Einstellungen mit einerPOST /api/2.2/jobs/resetAnfrage wieder auf denselben Job an, wodurch die Einstellungen des Jobs mit den von dir bereitgestellten Einstellungen überschreibt werden. Du kannst sie auch in die JSON-Definition des Jobs in der Benutzeroberfläche einfügen. Dadurch wird der Job auf klassische Berechnung zurückgegeben. - Öffnen
mapping.yaml, das jede gesicherte Datei und den ursprünglichen Pfad auflistet, von dem sie stammt. Kopieren Sie jede Sicherungsdatei zurück an ihren ursprünglichen Speicherort, um die Codeänderungen rückgängig zu machen. - Führe den Job aus, um sicherzustellen, dass er sich genauso wie vor der Migration verhält.
Die Migration löscht dieses Backup nie. Aufgaben, die der Agent nicht geändert hat, etwa aus Git stammende, SQL- oder dbt-Aufgaben, werden in job.yaml erfasst, ihre Dateien werden jedoch nicht in das Backup kopiert. Stellen Sie sie daher bei Bedarf aus Ihrer maßgeblichen Quelle wieder her.
Bekannte Einschränkungen
- Folgende Versionen werden als Blocker gemeldet: benutzerdefinierte Images, ML-Runtime-Varianten, Databricks Runtime-Versionen vor 13, Spark-Konfigurationen, die serverlos nicht sicher ignoriert werden können, sowie Abhängigkeiten wie Eggs, JARs und Maven-Bibliotheken. Ein Blocker bedeutet, dass der Agent aufhört, anstatt diesen Gegenstand zu migrieren. Du kannst es entweder selbst lösen und die Migration erneut ausführen oder dem Agenten sagen, dass er trotzdem migrieren soll, wodurch das Element ungelöst bleibt und die Arbeitslast auf Serverless versagt.
- Der Agent liest Init-Skripte, die in Workspace-Dateien oder Unity-Catalog-Volumes gespeichert sind. Init-Skripte, die in ABFSS oder DBFS gespeichert sind, können nicht gelesen werden und werden als Blocker gemeldet.
- Der Agent inspiziert nicht jedes klassische Compute-Attribut. Die Bereitstellung von Cluster-Protokollen und SSH-Schlüssel werden nicht abgebildet, und obwohl viele DBFS-Mount-Abhängigkeiten im Workload-Code erkannt werden, werden nicht alle Mounts aufgelistet oder aufgelöst.
- Cache- und Checkpoint-APIs, globale temporäre Ansichten, DBFS-Mount-Management-Aufrufe sowie Scala- oder R-Code sind standardmäßig harte Blocker. Du kannst den Agenten anweisen, fortzufahren, aber die ungelöste Funktionalität bleibt unverändert und kann auf Serverless versagen.
- Jobs mit mehr als 10 migratierbaren Aufgaben können derzeit nicht migriert werden.
- Der Agent verlagert jeweils eine Arbeitslast. Es gibt keine flottenweite Entdeckung, Massenmigration oder Genehmigungsprozesse für Administratoren.
- Der Agent schlägt Änderungen vor und wendet die von dir akzeptierten an, führt aber deine Aufgaben nicht aus und prüft nicht, ob die Ausgabe korrekt ist. Verifiziere eine migrierte Arbeitslast, bevor du dich darauf für Produktionsdaten verlässt.
- Wenn die Quelle der Wahrheit deines Workloads ein Databricks Asset Bundle oder ein Git-Ordner ist, wendet der Agent Änderungen am jeweiligen Workspace-Objekt vor. Gleiche diese Änderungen mit deinem Bundle oder Repository ab, damit ein späterer Deployment die Migration nicht überschreibt.
Manuell auf serverlos migrieren
Führen Sie die folgenden Schritte aus, um Ihre Workloads von der klassischen Compute zur serverlosen Berechnung zu migrieren:
- Überprüfen Sie die Voraussetzungen: Überprüfen Sie, ob Ihr Arbeitsbereich, Ihr Netzwerk und der Cloudspeicherzugriff die Anforderungen erfüllen. Weitere Informationen finden Sie unter Vorbereitung.
- Aktualisieren von Code: Nehmen Sie alle erforderlichen Code- und Konfigurationsänderungen vor. Informationen finden Sie unter Aktualisieren des Codes.
- Testen Sie Ihre Workloads: Überprüfen Sie die Kompatibilität und Korrektheit, bevor Sie sie überschneiden. Weitere Informationen finden Sie unter "Testen Ihrer Workloads".
- Wählen Sie einen Leistungsmodus aus: Wählen Sie den Leistungsmodus aus, der Ihren Workloadanforderungen am besten entspricht. Weitere Informationen finden Sie unter "Auswählen eines Leistungsmodus".
- In Phasen migrieren: Führen Sie serverlose Architekturen schrittweise ein, beginnend mit neuen und risikoarmen Workloads. Siehe Migrieren in Phasen.
- Überwachen sie die Kosten: Verfolgen Sie den Serverlosen DBU-Verbrauch und richten Sie Warnungen ein. Siehe "Kosten überwachen".
Bevor Sie anfangen
Bevor Sie mit der Migration beginnen, müssen Sie möglicherweise einige ältere Konfigurationen in Ihrem Arbeitsbereich aktualisieren.
| Voraussetzung | Action | Einzelheiten |
|---|---|---|
| Der Arbeitsbereich ist für Unity Catalog aktiviert | Migrieren von Hive Metastore bei Bedarf | Upgrade eines Azure Databricks Arbeitsbereichs zum Unity-Katalog |
| Netzwerkkonfiguration abgeschlossen | Ersetzen des VPC-Peerings durch NCCs, Private Link oder Firewallregeln | Serverlose Computeebenennetzwerke |
| Cloudspeicherzugriff | Ersetzen Sie Altdatenzugriffsmuster durch externe Speicherorte im Unity-Katalog. | Herstellen einer Verbindung mit Cloudobjektspeichern mithilfe von Unity Catalog |
Vergewissern Sie sich, dass sich Ihr Arbeitsbereich in einer unterstützten Region befindet.
Aktualisieren Ihres Codes
In den folgenden Abschnitten werden die Code- und Konfigurationsänderungen aufgeführt, die erforderlich sind, um Ihre Workloads mit serverlosen Servern kompatibel zu machen.
Datenzugriff
Ältere Datenzugriffsmuster werden auf serverlosen Servern nicht unterstützt. Aktualisieren Sie Ihren Code, um stattdessen Unity-Katalog zu verwenden.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
DBFS-Pfade (dbfs:/...) |
Unity Catalog-Volumes | Was sind Unity Catalog-Volumes? |
| Hive-Metastore-Tabellen | Unity Catalog-Tabellen (oder HMS-Verbund) | Upgrade eines Azure Databricks Arbeitsbereichs zum Unity-Katalog |
| Anmeldeinformationen für Speicherkonto | Externe Speicherorte des Unity-Katalogs | Herstellen einer Verbindung mit Cloudobjektspeichern mithilfe von Unity Catalog |
| Benutzerdefinierte JDBC-JARs | Lakehouse-Verbund | Was ist der Abfrageverbund? |
Warnung
DER DBFS-Zugriff ist auf serverlosen Servern beschränkt. Aktualisieren Sie alle dbfs:/ Pfade zu Unity-Katalogvolumes vor der Migration. Weitere Informationen finden Sie unter Migrieren von Dateien, die in DBFS gespeichert sind.
Beispiel: Ersetzen von DBFS-Pfaden und Hive-Metastore-Verweisen
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs und Code
Bestimmte APIs und Codemuster werden auf serverlosen Servern nicht unterstützt. Verweisen Sie auf diese Tabelle, um festzustellen, ob Ihr Code aktualisiert werden muss.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
RDD-APIs (sc.parallelize, rdd.map) |
DataFrame-APIs | Vergleichen von Spark Connect mit Spark Classic |
df.cache(), df.persist() |
Entfernen von Zwischenspeicherungsaufrufen | Serverlose Computebeschränkungen |
spark.sparkContext, sqlContext |
Verwenden Sie spark (SparkSession) direkt |
Vergleichen von Spark Connect mit Spark Classic |
Hive-Variablen (${var}) |
SQL DECLARE VARIABLE oder Python f-Zeichenfolgen |
DECLARE VARIABLE |
| Nicht unterstützte Spark-Konfigurationen | Entfernen Sie nicht unterstützte Konfigurationen. Die meisten Einstellungen werden von Serverless automatisch optimiert. | Konfigurieren von Spark-Eigenschaften für serverlose Notizbücher und Aufträge |
Beispiel: Ersetzen von RDD-Vorgängen durch DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Beispiel: Ersetzen von SparkContext und Zwischenspeichern
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Bibliotheken und Umgebungen
Sie können Bibliotheken und Umgebungen auf Arbeitsbereichsebene mithilfe von Basisumgebungen und auf Notizbuchebene mithilfe der serverlosen Umgebung des Notizbuchs verwalten.
| Klassisches Muster | Serverlose Ersetzung | Einzelheiten |
|---|---|---|
| Init-Skripte | Serverlose Umgebungen | Konfigurieren der Serverless-Umgebung |
| Clusterweite Bibliotheken | Notebook-relevante oder Umgebungsbibliotheken | Konfigurieren der Serverless-Umgebung |
| Maven/JAR-Bibliotheken | JAR-Aufgabenunterstützung für Aufgaben; PyPI für Notebooks | JAR-Aufgabe für Einzelvorgänge |
| Docker-Container | Serverlose Umgebungen für Bibliotheksanforderungen | Konfigurieren der Serverless-Umgebung |
Anheften Python Pakete in requirements.txt für reproduzierbare Umgebungen. Siehe Specify Python Paketversionen.
Streamen
Streamingworkloads werden auf serverlosen Servern unterstützt, aber bestimmte Trigger werden nicht unterstützt. Aktualisieren Sie Ihren Code, um die unterstützten Trigger zu verwenden.
| Spark-Trigger | Unterstützt | Hinweise |
|---|---|---|
Trigger.AvailableNow() |
Ja | Empfohlen |
Trigger.Once() |
Ja | Dies ist veraltet. Verwenden Sie stattdessen Trigger.AvailableNow(). |
Trigger.ProcessingTime(interval) |
No | Gibt INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED zurück |
Trigger.Continuous(interval) |
No | Verwenden Sie stattdessen den kontinuierlichen Modus für Lakeflow-Pipelines. |
Standardwert (kein .trigger() festgelegt) |
No | Das Weglassen von .trigger() führt standardmäßig zu ProcessingTime("0 seconds"), was auf einer serverlosen Architektur nicht unterstützt wird. Setzen Sie .trigger(availableNow=True) immer explizit. |
Migrieren Sie für kontinuierliches Streaming zum Spark Declarative-Pipelines im kontinuierlichen Modus oder verwenden Sie kontinuierlich-geplante Einzelvorgänge mit AvailableNow. Setzen Sie bei großen Quellen maxFilesPerTrigger oder maxBytesPerTrigger ein, um Speicherfehler zu verhindern.
Beispiel: Beheben von Streamingtriggern
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testen Sie Ihre Workloads
- Schnellkompatibilitätstest: Führen Sie die Workload auf der klassischen Compute mit Standardzugriffsmodus und Databricks Runtime 14.3 oder höher aus. Wenn die Ausführung erfolgreich ist, kann die Workload ohne Codeänderungen zu serverlosen Servern migriert werden.
- A/B-Vergleich (empfohlen für die Produktion): Führen Sie dieselbe Workload sowohl auf der klassischen (Kontrollgruppe) als auch der serverlosen (Experiment) Umgebung aus. Diff-Ergebnistabellen und Korrektheit überprüfen. Iteriere, bis die Ausgaben übereinstimmen.
- Temporäre Konfigurationen: Sie können während des Tests vorübergehend unterstützte Spark-Konfigurationen festlegen. Entfernen Sie sie, sobald sie stabil sind.
Auswählen eines Leistungsmodus
Serverlose Aufträge und Pipelines unterstützen zwei Leistungsmodi: Standard- und Leistungsoptimiert. Der von Ihnen ausgewählte Leistungsmodus hängt von Ihren Workloadanforderungen ab.
| Modus | Verfügbarkeit | Unternehmensgründung | Am besten geeignet für: |
|---|---|---|---|
| Standard | Aufträge, Lakeflow-Pipelines | 4-6 Minuten | Kostensensitiver Batch |
| Leistungsoptimiert | Notizbücher, Aufträge, Lakeflow-Pipelines | Sekunden | Interaktiv, latenzempfindlich |
Migrieren in Phasen
- Neue Workloads: Starten Sie alle neuen Notizbücher und Jobs in einer serverlosen Umgebung.
- Workloads mit geringem Risiko: Migrieren Sie PySpark/SQL-Workloads bereits im Standardzugriffsmodus und Databricks Runtime 14.3 oder höher.
- Komplexe Workloads: Migrieren Sie Arbeitslasten, die Codeänderungen benötigen (RDD-Neuschreibungen, DBFS-Updates, Triggerfixes).
- Verbleibende Workloads: Überprüfen Sie regelmäßig, wenn die Funktionen erweitert werden.
Kosten überwachen
Serverlose Abrechnung basiert auf DBU-Verbrauch und nicht auf Cluster-Uptime. Überprüfen Sie die Kostenerwartungen mit repräsentativen Workloads, bevor Sie die Migration im großen Maßstab durchführen. Tools und Strategien zur Überwachung serverloser Kosten finden Sie unter Überwachen der Kosten für serverloses Berechnen.
Weitere Ressourcen
- Bewährte Methoden für serverlose Berechnung: Optimierungstipps für serverlose Workloads
- Serverlose Computebeschränkungen: Vollständige Liste der aktuellen Einschränkungen und nicht unterstützten Features
- Konfigurieren der serverlosen Umgebung: Verwalten von Bibliotheken und Abhängigkeiten
- Unterstützte Spark-Konfigurationen: Spark-Konfigurationen, die auf serverlosen Servern verfügbar sind
- Spark Connect im Vergleich zum klassischen Spark: Verhaltensunterschiede in der serverlosen Architektur
- Serverlose Netzwerksicherheit: NCCs, Private Link und Firewallkonfiguration
- Anmerkungen zur Veröffentlichung von serverlosen Rechenkapazitäten: Nachverfolgen neuer Funktionen bei der Veröffentlichung
- Unity Catalog-Upgradehandbuch: Migrieren von Hive Metastore zu Unity-Katalog
Weitere Informationen finden Sie auch in den folgenden Blogbeiträgen:
- Was ist serverloses Computing?: Übersicht über serverlose Funktionen und Kundenergebnisse
- Entwicklung des Datenengineerings: Wie serverloses Computing Notebooks und Lakeflow-Aufträge transformiert: Wie serverloses Computing Lakeflow-Jobs und -Pipelines antreibt