Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Nachdem Sie Ihre Featureansichtsdefinitionen erstellt haben, die im Unity-Katalog gespeichert sind, können Sie Featuredaten aus der Quelltabelle mithilfe der Featuredefinitionen erstellen. Dieser Prozess wird als Materialisierung Ihrer Features bezeichnet. Azure Databricks erstellt und verwaltet Lakeflow-Pipelines zum Auffüllen von Tabellen im Unity-Katalog für Modellschulungen und Batchbewertungen oder Online-Bereitstellungen.
Informationen zum Bereitstellen von Featureansichten finden Sie unter "Featureansichten bereitstellen".
Um materialisierte Werte nach Korrektur oder Hinzufügen historischer Quelldaten neu zu berechnen, siehe Backfill Feature Views.
Um materialisierte Werte für ausgewählte Entitäten zu entfernen, siehe Featurewerte für Entitäten löschen.
Anforderungen
- Features müssen als Featureansichten erstellt und im Unity-Katalog gespeichert werden.
- Für Versionsanforderungen siehe Anforderungen.
Materialisierungsunterstützung nach Merkmalstyp
Ob und wo ein Merkmal materialisiert werden kann, hängt von seinem Typ ab:
-
ColumnSelectionFeatures können in Online-Stores materialisiert werden. Siehe ColumnSelection-Materialisierung. - Batch-Features
Lastmit einemRollingWindowkönnen in Online-Stores materialisiert werden. Siehe Materialize freshness-bounded latest values. -
RequestSource,FeatureViewSource, undCustomUDFMerkmale können nicht materialisiert werden. Siehe On-Demand-Funktionen und Materialisierung.
Merkmale, die erst für Online-Stores materialisiert werden, sind dennoch offline nutzbar: create_training_set und compute_features berechnen ihre zeitpunktbezogenen Werte direkt aus der Quelle, sodass keine Offline-Materialisierung erforderlich ist.
ColumnSelection-Materialisierung
ColumnSelection Features wählen den neuesten Wert einer einzelnen Spalte pro Entitätsschlüssel ohne Aggregation aus. Sie können nur in Online-Stores verfügbar gemacht werden. Bei Offline-Anwendungsfällen (Schulung und Batch-Inferenz) werden ColumnSelection Features direkt zur Abfragezeit aus den Quelldaten abgerufen, sodass eine Offline-Materialisierung nicht erforderlich ist.
Materialisierungsverhalten
- Die Pipeline schreibt die aktuellste Zeile pro Entitätsschlüssel in die Onlinetabelle, ohne Aggregationsfenster.
- Die Onlinematerialisierung füllt die Onlinetabelle mit dem aktuellen aktuellen Wert pro Entitätsschlüssel aus.
Beispiel
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    DeltaTableSource, Feature, ColumnSelection, TableTrigger, OnlineStoreConfig,
)

fe = FeatureEngineeringClient()

delta_source = DeltaTableSource(
    catalog_name="catalog",
    schema_name="schema",
    table_name="transactions",
)

amount_feature = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# Register before materializing
amount_feature = fe.register_feature(
    feature=amount_feature,
    catalog_name="catalog",
    schema_name="schema",
)

mfs = fe.materialize_features(
    features=[amount_feature],
    online_config=OnlineStoreConfig(
        catalog_name="catalog",
        schema_name="feats_online",
        table_name_prefix="txn_",
        online_store_name="lb_usw2"
    ),
    trigger=TableTrigger(),
)
ColumnSelection Merkmale nutzen TableTrigger, der die Pipeline ausführt, sobald die Quell-Delta-Tabelle einen neuen Commit erhält. Kein offline_config ist erforderlich, da ColumnSelection Merkmale direkt aus der Quelle für Offline-Anwendungsfälle gelesen werden (Schulungs- und Batch-Inferenz).
Note
RequestSource Features können nicht materialisiert werden, da sie Daten darstellen, die vom Aufrufer zur Inferenzzeit bereitgestellt werden (oder aus dem gelabelten DataFrame während der Trainingszeit extrahiert wurden). Es gibt keine Quelltabelle, aus der gelesen werden soll. Die Werte sind nur in der Anforderungsnutzlast oder im Schulungsdatenframe vorhanden.
Aktuellste Werte mit Frischebeschränkung materialisieren
Eine Batch-Aggregation Last mit einem RollingWindow verleiht einem Online-Feature eine Lebensdauer (TTL): Sein Wert läuft im Online-Store ab, wenn kein Quellwert in das Zeitfenster fällt. Dies ist nützlich, wenn das Alter eines Wertes bestimmt, ob er sicher zu bedienen ist. Zum Beispiel kann ein Gerätezustand aus der letzten Stunde bedient werden, während ein älterer Zustand auf null aufgelöst wird, anstatt unbegrenzt verfügbar zu bleiben.
Ein RollingWindow definiert eine explizite Dauer, die der Funktion ein TTL-ähnliches Verhalten verleiht. Wenn zum Beispiel die Quelle täglich Werte veröffentlicht und Sie nur Werte der letzten sieben Tage behalten möchten, verwenden Sie eine RollingWindow mit einer Sieben-Tage-Dauer. Bei jedem Trigger ersetzt die Materialisierung die Online-Tabelle vollständig, sodass Werte, die außerhalb des Fensters liegen, nach einem vorhersehbaren Zeitplan entfernt werden. Dies liefert das gleiche Ergebnis wie ein Streamingvorgang Last mit einem RollingWindow, kostet aber weniger, da die Berechnung nicht kontinuierlich ausgeführt werden muss.
Dieses Veröffentlichungsmuster ähnelt einer Feature-Tabelle mit einer TTL, die im Snapshot-Modus veröffentlicht wird. Wenn Sie eine Reihe von Feature-Tabellen pflegen und diese zusammen mit anderen Feature Views verwenden möchten, können Sie sie für das Feature Views-Authoring-Framework anpassen. Verwenden Sie einen Batch Last mit einer RollingWindow und einer TableTrigger.
Diese Kombination verfügt über einen speziellen reinen Online-Materialisierungsmodus mit folgenden Anforderungen:
- Die Quelle muss ein
DeltaTableSourcesein. - Die Aggregationsfunktion muss
Lastsein, und ihr Fenster muss einRollingWindowsein. - Die Materialisierung muss ein
OnlineStoreConfigbereitstellen,OfflineStoreConfigweglassen undTableTriggerverwenden.
Im folgenden Beispiel ist latest_device_state_1h ein registriertes Feature, das diese Anforderungen erfüllt:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import OnlineStoreConfig, TableTrigger

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=[latest_device_state_1h],
    online_config=OnlineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="latest_device_state_serving",
        online_store_name="device_state_store",
    ),
    trigger=TableTrigger(),
)
Für Offline-Training und Batch-Scoring berechnet der Feature-Engineering-Client den Zeitpunktwert direkt aus der Quelle. Für diese Funktion wird keine Offline-Materialisierung eingelesen.
Considerations
- Der Ablaufzeitpunkt wird nur durch einen Trigger vorverlegt. Der Wert und sein Ablaufzeitpunkt werden vorgezogen, wenn ein Commit der Quelltabelle eine Aktualisierung der Materialisierung auslöst. Allein vergehende Zeit löst keine Aktualisierung aus. Wenn die Quelle aufhört zu veröffentlichen, bleibt der zuletzt materialisierte Wert im Online-Shop, bis ein späterer Commit eine Aktualisierung auslöst.
- Richten Sie die Zeitreihen-Spalte an die Veröffentlichungszeit der Quelle. Die Zeitreihenspalte muss widerspiegeln, wann die Quelle die Daten veröffentlicht hat. Andernfalls unterscheiden sich die Online- und Offline-Werte, da der Online-Shop zur Triggerzeit beitritt, während Offline-Lesungen zur Zeitreihenzeit beitreten.
- Setze die Fensterzeit auf ein Vielfaches der Veröffentlichungsfrequenz. Wenn die
RollingWindow-Dauer kein Vielfaches des Veröffentlichungstakts der Quelle ist, werden einige Werte während des Offline-Trainings als abgelaufen behandelt, obwohl sie online noch sichtbar sind.
On-Demand-Funktionen und Materialisierung
RequestSource Die Werte stammen aus der Trainingsanfrage DataFrame oder der Inferenzanfrage, daher gibt es keine Quelltabelle, die materialisiert werden könnte.
FeatureViewSource-Features wenden während des Trainings oder der Bereitstellung eine CustomUDF auf die Werte vorgelagerter Features an. Sie speichern kein vorab berechnetes Ergebnis. Die Materialisierung wird auch für CustomUDF-Features, die auf einer Delta-Tabelle basieren, nicht unterstützt.
Für einen Abhängigkeitsgraphen wie revenue_sum_7d und cost_sum_7d, die in ein margin-Feature einfließen:
- Für Offline-Training rufen Sie
create_training_setmitmarginan. Es ermittelt die vorgelagerten Features und berechnet Point-in-Time-Werte, wobei kompatible Offline-Materialisierungen verwendet werden, sofern verfügbar. - Für Online-Service implementieren Sie die unterstützten Umsatz- und Kostenfunktionen in einem Online-Shop. Der Endpunkt ruft sie ab und berechnet
marginfür jede Anfrage. - Übergeben Sie an
materialize_featuresnur die unterstützten Upstream-Funktionen, nicht anmarginund auch keine requestbasierten Funktionen. Materialisierung materialisiert nicht rekursiv die Abhängigkeiten eines abgeleiteten Merkmals.
Ein Graph, der nur auf Anfragen unterstützte Funktionen basiert, benötigt keinen Online-Shop. Siehe Mit FeatureViewSource-Features trainieren und Abgeleitete Features bereitstellen.
Berechtigungen
Materialisierung erfordert Rechte auf das Feature sowie auf die Quell- und Zielressourcen. Beschreibungen aller Unity Catalog-Berechtigungen finden Sie unter Referenz zu Unity Catalog-Berechtigungen.
Das Materialisieren eines Features erfordert
MANAGE. Das Aufrufenmaterialize_featureserstellt und verwaltet die unterstützenden Lakeflow-Pipelines und Unity-Catalog-Tabellen, es handelt sich also um eine Verwaltungsoperation. Sie müssen überMANAGEfür das Feature sowieREAD FEATUREverfügen, um die materialisierte Featuredefinition zu lesen.Das Löschen einer materialisierten Funktion ist auf den Ersteller beschränkt. Nur der Nutzer, der eine materialisierte Funktion erstellt hat, kann sie mit
delete_materialized_featurelöschen. Diese Einschränkung ist unabhängig von den Unity-Katalog-Privilegien:MANAGEAuf dem Feature oder seinem Elternschema kann ein anderer Benutzer es nicht löschen.Das Lesen von Quelldaten erfordert
SELECT. Für ein Feature, das eine Delta-Tabelle als Quelle verwendet, muss auf der QuelltabelleSELECTvorhanden sein. Für ein Feature, das eine Quelle vom Typ Stream verwendet, müssen SieSELECTin der Ingestionstabelle des Streams haben.Für weitere Berechtigungen, die durch die Authentifizierungskonfiguration eines Streams erforderlich sind, siehe Kafka-Authentifizierung.
Das Erstellen von Zieltabellen erfordert
CREATE TABLE. Du musstOnlineStoreConfigfür jedes Schema haben, das durchOfflineStoreConfigoderCREATE TABLEangegeben ist. Offline- und Online-Ziele können in unterschiedlichen Schemata oder Katalogen liegen, und die Materialisierung erfordert Privilegien für jedes Ziel.Für die Veröffentlichung in einem Online-Shop ist
CAN USEerforderlich.CAN USEmuss auf der Lakebase-Instanz oder in dem Projekt vorhanden sein, die bzw. das vom Onlineshop verwendet wird. Informationen zu Lakebase-Berechtigungen finden Sie unter Grant project permissions.Zum Auflisten materialisierter Features ist
READ FEATUREfür das übergeordnete Feature erforderlich. Umlist_materialized_featureszu verwenden, müssen Sie überREAD FEATUREfür das materialisierte Feature verfügen.Das Lesen materialisierter Daten erfordert
SELECT. Du musst auf jeder Offline- oder Online-Ausgabetabelle, auf die du zugreifst,SELECThaben.READ FEATUREauf dem übergeordneten Feature gewährt keinen Zugriff auf diese Tabellen.
Für jede Unity-Katalog-Ressource, die an der Materialisierung beteiligt ist, benötigen Sie außerdem USE CATALOG für den übergeordneten Katalog und USE SCHEMA für das übergeordnete Schema. Diese Anforderung gilt für die Funktion, jede Quell- oder Stream-Aufnahmetabelle und jedes konfigurierte Ziel.
READ FEATURE und MANAGE, die für ein Schema oder einen Katalog gewährt wurden, gelten für alle derzeit vorhandenen und zukünftigen Objekte, die er enthält.
API-Datenstrukturen
OfflineStoreConfig
Konfiguration für den Offlinespeicher, in dem materialisierte Features geschrieben werden. Beim Aufrufen von materialize_features erstellt das Feature-Store-Backend Tabellen mit diesem Präfix. Jede Pipelineausführung materialisiert die neuesten Featurewerte in der Tabelle entsprechend dem Materialisierungszeitplan.
OfflineStoreConfig(
    catalog_name: str,        # Catalog name for the offline table where materialized features will be stored
    schema_name: str,         # Schema name for the offline table
    table_name_prefix: str    # Table name prefix for the offline table. The pipeline may create multiple tables with this prefix, each updated at different cadences
)
from databricks.feature_engineering.entities import OfflineStoreConfig

offline_store = OfflineStoreConfig(
    catalog_name="main",
    schema_name="feature_store",
    table_name_prefix="customer_features"
)
OnlineStoreConfig
Konfiguration für den Online-Shop, in dem Features gespeichert werden, die für den Modelldienst genutzt werden. Die Materialisierung erstellt Delta-Tabellen mit dem catalog.schema.table_name_prefix und streamt die Tabellen in den Online Feature Store mit demselben Namen.
from databricks.feature_engineering.entities import OnlineStoreConfig

online_store = OnlineStoreConfig(
    catalog_name="main",
    schema_name="feature_store",
    table_name_prefix="customer_features_serving",
    online_store_name="customer_features_store"
)
MaterializedFeature
Stellt eine Featureansicht dar, die materialisiert wurde, d. h. eine vorkompilierte Darstellung, die im Unity-Katalog verfügbar ist. Es gibt separate materialisierte Features für die Offlinetabelle und die Onlinetabelle. Normalerweise instanziiert man MaterializedFeature nicht direkt.
Das Feld latest_backfill_operation enthält den Namen des jüngsten Backfill des materialisierten Merkmals. Siehe Backfill Feature Views.
API-Funktionsaufrufe
materialize_features()
Materialisiert eine Liste von Feature Views entweder in eine Offline-Delta-Tabelle oder in einen Online Feature Store. Features müssen im Unity Catalog registriert werden, bevor sie diese Funktion aufrufen (z. B. create_feature oder register_feature verwenden). Lokal erstellte Features, die nicht registriert wurden, funktionieren nicht.
FeatureEngineeringClient.materialize_features(
    *,                                                                     # Arguments are keyword-only
    features: List[Feature],                                               # List of Feature Views to materialize
    offline_config: Optional[OfflineStoreConfig] = None,                   # Offline store config (aggregation features only)
    online_config: Optional[OnlineStoreConfig] = None,                     # Online store config
    trigger: Union[CronSchedule, TableTrigger, StreamingMode],             # Materialization trigger
    tags: Optional[Dict[str, str]] = None,                                 # Custom tags for cost attribution
    budget_policy_id: Optional[str] = None,                                # Serverless usage policy for cost attribution
) -> List[MaterializedFeature]:
Die Methode gibt eine Liste der materialisierten Features zurück, die Metadaten dazu enthalten, wann Featurewerte aktualisiert werden, und die Unity-Katalogtabellen, in denen Features materialisiert sind.
Wenn sowohl ein OnlineStoreConfig als auch ein OfflineStoreConfig bereitgestellt werden, werden pro bereitgestelltem Feature zwei materialisierte Features zurückgegeben, eines für jeden Store-Typ.
Der trigger Parameter steuert, wann die Materialisierungspipeline ausgeführt wird:
-
CronSchedule: Wird nach einem Zeitplan ausgeführt, der aus der zeitlichen Konfiguration des Features abgeleitet wird, oder nach einem vom Aufrufer angegebenen Quartz-Cron-Zeitplan. Unterstützung für Batch-Aggregationsfunktionen (AggregationFunctionausDeltaTableSource). -
TableTrigger: Wird ausgeführt, wenn die Upstream-Delta-Tabelle einen Commit empfängt. Unterstützung fürColumnSelectionFunktionen und Aggregationsfunktionen (AggregationFunction), die durch einDeltaTableSourceunterstützt werden. Bei Aggregationsmerkmalen wird die Pipeline so gedrosselt, dass sie höchstens einmal pro halber Granularität des Features ausgeführt wird (die Schiebedauer für ein Schiebefenster oder die Fensterlänge für ein rollierendes Fenster), begrenzt auf 1 Stunde und nie öfter als alle 5 Minuten. Zum Beispiel höchstens alle 30 Minuten für eine Granularität von 1 Stunde oder höchstens einmal pro Stunde für eine Granularität von 2 Stunden oder mehr. Das Intervall wird ab dem vorherigen Durchlauf berechnet, sodass ein Commit, der nach Ablauf des Intervalls eintrifft, dennoch umgehend einen Durchlauf auslöst. -
StreamingMode: Wird als fortlaufende Streamingpipeline ausgeführt. Erforderlich für Funktionen, die von einerStreamSourceunterstützt werden.
Features, die unterschiedliche Triggertypen in einem einzelnen materialize_features Aufruf erfordern, können nicht kombiniert werden. Führen Sie stattdessen separate Anrufe aus.
Um die Kosten einer Materialisierung zuzuordnen, übergeben Sie tags, budget_policy_id oder beides. Azure Databricks wendet diese auf den erstellten Einzelvorgang oder die Pipeline an, sodass die damit verbundenen Kosten in der Systemtabelle für abrechenbare Nutzung unter Ihrer Zuordnung (Attribution) erfasst werden. Beide werden bei der Erstellung angewendet, daher bedeutet es, für eine bestehende Materialisierung eine andere Zuordnung vorzunehmen, dass eine neue erstellt werden muss.
budget_policy_id nimmt die ID einer serverlosen Nutzungsrichtlinie an. Um eine zu erstellen und ihre ID zu erhalten, siehe Erstellen einer serverlosen Nutzungsrichtlinie. Für die Tag-Limits, die Ressourcen, die jeder Wert erreicht, und wie man die attributierten Ausgaben abfragt, siehe Feature Store Kostenmanagement.
Materialisieren im Offlinespeicher
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CronSchedule, OfflineStoreConfig,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=features,
    offline_config=OfflineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features"
    ),
    trigger=CronSchedule(
        quartz_cron_expression="0 0 * * * ?",  # Hourly
        timezone_id="UTC",
    ),
)
Materialisieren im Online-Store
Note
Um die meisten Aggregationsfunktionen in einen Online-Shop zu integrieren, müssen Sie auch in einen Offline-Shop wechseln. Beide offline_config und online_config sind erforderlich. Der online_store_name muss auf einen vorhandenen Online Feature Store verweisen. Anweisungen zum Erstellen eines Features finden Sie unter Databricks Online Feature Stores.
ColumnSelection-Funktionen erfordern keinen OfflineStoreConfig. Siehe ColumnSelection-Materialisierung.
Die Charge Last mit RollingWindow Sonderfall ist ebenfalls nur online verfügbar. Siehe Materialize freshness-bounded latest values.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CronSchedule, OfflineStoreConfig, OnlineStoreConfig,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=features,
    offline_config=OfflineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features"
    ),
    online_config=OnlineStoreConfig(
        catalog_name="main",
        schema_name="feature_store",
        table_name_prefix="customer_features_serving",
        online_store_name="customer_features_store"
    ),
    trigger=CronSchedule(
        quartz_cron_expression="0 0 * * * ?",  # Hourly
        timezone_id="UTC",
    ),
)
Streaming-Features bereitstellen
Streamingfeatures können nur für Online-Stores materialisiert werden; der offline_config Parameter wird nicht unterstützt. Die Offline-Materialisierung wird nicht unterstützt, da Streaming-Features eine Echtzeit-Pipeline erfordern, um Aktualität im Subsekundenbereich sicherzustellen. Für das Offline-Training oder die Evaluierung wird der Feature-Engineering-Client die Feature-Werte auf Grundlage jedes ausgewerteten Datenpunkts neu berechnen.
Streamingfeatures können nicht mit Batchfeatures im selben materialize_features Aufruf gemischt werden.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    OnlineStoreConfig, StreamingMode,
)

fe = FeatureEngineeringClient()

materialized = fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online"
    ),
    trigger=StreamingMode(),
)
list_materialized_features()
Gibt die Materialisierungen eines einzelnen Features zurück, das durch den vollständigen Namen identifiziert wird.
feature_name ist erforderlich und nur als Schlüsselwort zulässig. Um die Materialisierungen für viele Features zu überprüfen, listen Sie zunächst die Features in einem Katalog oder Schema auf und rufen Sie dann für jedes zurückgegebene Feature list_materialized_features auf.
Standardmäßig werden maximal 100 Materialisierungen zurückgegeben. Sie können diesen Grenzwert mithilfe des max_results Parameters ändern.
FeatureEngineeringClient.list_materialized_features(
    *,                                      # Arguments are keyword-only
    feature_name: str,                      # Required: full name of the feature whose materializations to list
    max_results: int = 100,                 # Maximum number of materializations to return
) -> List[MaterializedFeature]:
delete_materialized_feature()
Bevor Sie ein materialisiertes Feature löschen, entfernen oder aktualisieren Sie alle Modelle oder Featurespezifikationen, die auf das Feature verweisen.
Löscht ein materialisiertes Feature. Das zu übergebende Feature hängt vom Featuretyp ab:
-
Aggregationsfunktionen: Übergeben die offline materialisierte Funktion. Wenn ein online materialisiertes Feature für das gleiche Feature vorhanden ist, werden beide gelöscht. Übergeben Sie für ein reines Online-Batch-Feature
Lastmit einemRollingWindowdas online materialisierte Feature. -
ColumnSelectionfeatures: Geben die online materialisierten Features weiter.ColumnSelectionFeatures sind nur für den Online-Shop materialisiert (siehe ColumnSelection materialization), wodurch keine gekoppelte Offline-Funktion existiert.
Im Rahmen der Materialisierung werden Features nach Datenquellen- und Aggregationsfenstern zur Effizienz gruppiert.
ColumnSelection Features haben kein Aggregationsfenster, sodass sie nur nach Datenquelle gruppiert werden. Die Materialisierungspipeline, die Offlinetabelle und die Onlinetabelle werden erst gelöscht, wenn alle gruppierten Features gelöscht wurden. Wenn das letzte materialisierte Feature in einer Gruppe gelöscht wird, plant der Featurespeicher die zugeordneten Ressourcen für die automatische Bereinigung durch einen Hintergrundprozess. Siehe Hintergrundressourcenbereinigung.
Um materialisierte Features zu bereinigen, sehen Sie sich die Tabelle an, die einem materialisierten Feature zugeordnet ist. Jedes Feature in der Tabelle (eine pro Spalte) muss gelöscht werden, bevor Compute- und Delta-Tabellenressourcen bereinigt werden.
Verwenden Sie list_materialized_features(), um das materialized_feature-Argument abzurufen.
FeatureEngineeringClient.delete_materialized_feature(
    materialized_feature: MaterializedFeature,  # Required: The materialized feature to delete
) -> None
from databricks.feature_engineering import FeatureEngineeringClient

fe = FeatureEngineeringClient()

feature_names = [
    "main.feature_store.amount_sum_sliding_7d_1d",
    "main.feature_store.amount_sum_sliding_30d_1d",
    "main.feature_store.transaction_count_sliding_7d_1d",
    "main.feature_store.latest_transaction_amount",
    "main.feature_store.latest_user_tier",
]

for name in feature_names:
    mfs = fe.list_materialized_features(feature_name=name)   # required, keyword-only
    offline = [mf for mf in mfs if not mf.is_online]
    for mf in (offline or mfs):
        fe.delete_materialized_feature(materialized_feature=mf)
    fe.delete_feature(full_name=name)
Bereinigung der Hintergrundressource
Wenn Sie ein materialisiertes Feature löschen, entfernt Databricks die Featuremetadaten sofort. Die zugeordnete Infrastruktur (Tabellen, Pipelines und Einzelvorgänge) wird asynchron von einem Hintergrundprozess bereinigt.
Da mehrere materialisierte Features dieselben Tabellen und Pipelines gemeinsam nutzen können, werden diese freigegebenen Ressourcen erst entfernt, wenn jedes materialisierte Feature, das auf sie verweist, gelöscht wurde. Wenn das letzte materialisierte Feature, das eine Reihe von Tabellen teilt, gelöscht wird, löscht der Hintergrundprozess automatisch die folgenden Ressourcen:
- Die Offline-Delta-Tabellen, die die materialisierten Featuredaten enthalten
- Die Onlinetabellen, wenn die Features in einem Online-Store materialisiert wurden
- Die Materialisierungspipeline
- Der Orchestrierungsauftrag
Dieser Hintergrundprozess verwendet einen von Databricks verwalteten Systemdienstprinzipal, um diese Bereinigungsaktionen in Ihrem Auftrag auszuführen, einschließlich des Löschens von Tabellen, Pipelines und Einzelvorgängen in Ihrem Arbeitsbereich. Es ist keine Aktion Ihrerseits erforderlich. Die Bereinigung wird vollständig vom Feature Store verwaltet.
Note
Es kann eine kurze Verzögerung zwischen dem Löschen des letzten materialisierten Features in einer Gruppe und dem Entfernen der zugehörigen Tabellen und anderen Ressourcen geben.
Materialisierungsstatus anzeigen
Um den Materialisierungsstatus Ihrer Feature Views in der Databricks-Benutzeroberfläche anzuzeigen und Materialisierungsfehler zu debuggen, siehe Explore Feature Views im Unity-Katalog.
Validieren Sie die durchgängige Aktualität von RollingWindow
Note
Die Frischevalidierung verwendet den Lakebase Change Data Feed (CDF), der in der öffentlichen Vorschau verfügbar ist. Ein Workspace-Administrator muss die Vorschau des Lakebase Change Data Feed aktivieren, bevor Sie CDF aktivieren können.
Dieser Abschnitt gilt nur für RollingWindow Aggregationen. Batch-Funktionen legen die hier beschriebenen Metadaten zur Streaming-Aktualität nicht offen.
Das Streaming der RollingWindow-Elemente, die im Lakebase-Onlineshop verfügbar sind, enthalten Metadaten zur Aktualität pro Zeile. Mit CDF erfasst man jedes Update der Online-Tabelle in eine Delta-History-Tabelle im Unity-Katalog und misst die End-to-End-Frische, ohne eine zusätzliche Pipeline auszuführen. Die End-to-End-Aktualität ist die Verzögerung zwischen dem Zeitpunkt, zu dem ein Ereignis eingetreten ist, und dem Zeitpunkt, zu dem dessen aggregierter Wert für die Bereitstellung verfügbar wurde.
Wie RollingWindow-Funktionen Zeilen aussenden
Für ein RollingWindow Feature fasst der Wert jeder Entität die Ereignisse innerhalb eines festen Zeitfensters zusammen (zum Beispiel die Anzahl der Transaktionen in der letzten Stunde). Das Fenster gleitet kontinuierlich nach vorne, sodass in zwei Fällen eine Zeile in den Online-Shop geschrieben wird:
-
Datengetriebenes Update (
is_timer=false): Ein neues Ereignis erscheint und aktualisiert das Aggregat. Die Zeile spiegelt das jüngste Ereignis im Fenster wider. -
Ablauf des Fensters (
is_timer=true): es trifft kein neues Ereignis ein, aber die Zeit schreitet voran und die ältesten Ereignisse fallen aus dem Zeitfenster heraus, oder sie Veralten. Da diese Ereignisse nicht mehr in die Gesamtzahl einfließen, ändert sich der Wert (beispielsweise verringert sich die Anzahl), sodass die Funktion in regelmäßigen Abständen eine aktualisierte Zeile ausgibt. Die Zeile gibt den Zeitpunkt wieder, zu dem das älteste Ereignis verfallen ist, d. h. das Ende des Zeitfensters dieses Ereignisses.
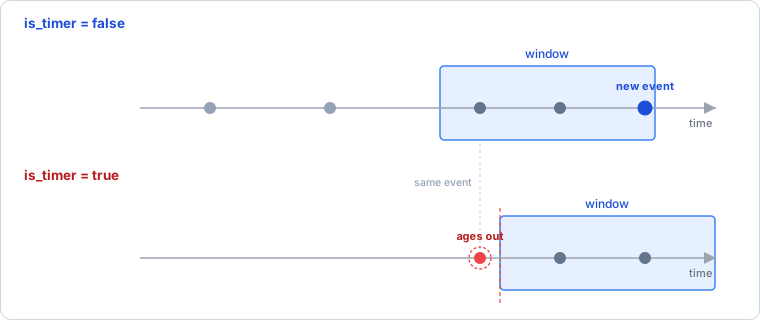
In beiden Fällen ist event_time der Zeitpunkt, an dem die Änderung, durch die die Zeile erzeugt wurde: Wenn ein neues Ereignis eintrifft oder das älteste Ereignis aus veraltet. Deshalb ist commit_time - event_time die Aktualität der Zeile, unabhängig davon, wie sie ausgegeben wurde.
Frische-Metadaten
Jede Streaming-Online-Zeile enthält folgende Spalten:
| Spalte | Description |
|---|---|
event_time |
Als die Änderung stattfand, die die Zeile verursachte. Bei einem datengetriebenen Update (is_timer = false), die aktuellste (maximale) Ereigniszeit im Fenster. Bei einem Fenster-Ablauf-Update (is_timer = true), der Zeitpunkt, zu dem das älteste Ereignis abläuft: die Zeit dieses Ereignisses plus die Fensterdauer. Wenn die Online-Tabelle Features mit unterschiedlichen Fensterdauern enthält, wird das abgelaufene Fenster verwendet. |
output_time |
Die Grenze des Streaming-Fensters (Grenzwert) bei Ausgabe. |
is_timer |
Wie die Zeile ausgegeben wurde: false = Ein neu eingetroffenes Ereignis hat die Gesamtsumme (datengesteuert) erhöht; true = Das Zeitfenster wurde zeitgesteuert verschoben, und die ältesten Daten wurden gelöscht (Ablauf des Zeitfensters). |
commit_time |
Als der Datensatz in den Lakebase Online-Shop geschrieben wurde. |
Wenn CDF aktiviert ist, wird jede Änderung an eine lb_<online_table>_history Delta-Tabelle mit CDF-Metadaten-Spalten angehängt. Die Spalte _pg_change_type (insert, update_preimage, update_postimage oder delete) kennzeichnet jeden Änderungstyp.
CDF auf der Online-Tabelle aktivieren
Warning
Verwenden Sie CDF, um die Aktualität über den gesamten Prozess hinweg zu überprüfen, beispielsweise beim Testen einer Pipeline oder beim Optimieren ihrer Konfiguration, und nicht, um die Aktualität in einem Produktions-Onlineshop kontinuierlich zu überwachen. CDF und REPLICA IDENTITY FULL verursachen zusätzliche Last auf der Lakebase-Instanz, hauptsächlich CPU zum Dekodieren von Änderungen und zusätzliches Write-Ahead-Log-Volumen. Der Overhead wächst mit der Anzahl der synchronisierten Tabellen und mit großen Spaltenwerten wie Arrays oder Maps. Wenn Sie CDF in einem Online-Shop aktivieren, der den Produktionsverkehr bedient, erhöhen Sie die maximale Anzahl an Recheneinheiten (CU), sodass Autoscaling über genügend Spielraum verfügt und die CPU-Auslastung sowie die Latenz beim Online-Betrieb überwacht werden können.
Lakebase CDF erfordert, dass für jede Quelltabelle die Replikat-Identität auf
FULLgesetzt wird, damit Aktualisierungen mit vollständigen Vorher-Nachher-Zeilenabbildern erfasst werden. Setzen Sie es auf die Online-Tabelle:ALTER TABLE <schema>.<online_table> REPLICA IDENTITY FULL;Starten Sie Lakebase CDF für den Online-Shop, und wählen Sie dabei das Quellschema sowie einen Zielkatalog und ein Zielschema im Unity Catalog aus. Für Einrichtungsdetails siehe Lakebase Change Data Feed.
CDF erstellt lb_<online_table>_history im Zielschema.
Um das Erfassen von Änderungen zu stoppen, siehe Lakebase CDF deaktivieren. Das Deaktivieren von CDF stoppt den Feed für alle Schemata im Projekt. Nachdem du CDF deaktiviert hast, kannst du die Replik-Identität der Online-Tabelle zurücksetzen, um das zusätzliche Write-Ahead-Logbuch zu entfernen:
ALTER TABLE <schema>.<online_table> REPLICA IDENTITY DEFAULT;
Aktualität berechnen
Aktualität ist commit_time - event_time sowohl für datengetriebene als auch für Fenster-Ablauf-Zeilen. Fügen Sie is_timer ein, damit Sie die beiden Ausgabetypen vergleichen können und die Abfrage auf den Zeitraum beschränken, den Sie auswerten möchten.
SELECT
  event_time,
  commit_time,
  is_timer,
  (unix_micros(commit_time) - unix_micros(event_time)) / 1000 AS feature_freshness_ms
FROM <dest_catalog>.<dest_schema>.lb_<online_table>_history
WHERE _pg_change_type IN ('insert', 'update_postimage')
  AND commit_time >= (
    SELECT max(commit_time) - INTERVAL 1 DAY
    FROM <dest_catalog>.<dest_schema>.lb_<online_table>_history
  );
feature_freshness_ms ist die Verzögerung in Millisekunden vom Ereignis bis zum Schreibvorgang in den Online-Shop. Dies ist die Aktualität des zum Bereitstellen verfügbaren Werts.
Note
Wenn du CDF in einer Online-Tabelle aktivierst, die bereits Zeilen hat, kopiert der anfängliche Schnappschuss jede bestehende Zeile als ein insert in die Verlaufstabelle. Jede kopierte Zeile behält das event_time und commit_time seit dem letzten Schreibvorgang dieser Entität, sodass ihr Aktualitätswert korrekt ist, aber der Snapshot liefert genau eine Stichprobe pro Entität. Um nur Schreibvorgänge zu messen, die vom Feed erfasst werden, warten Sie, bis sich der Status der Tabelle auf der Registerkarte Lakebase CDF von Snapshotting zu Streaming ändert, notieren Sie die Zeit und verwenden Sie sie als untere Grenze statt max(commit_time) - INTERVAL 1 DAY. Eine Schemaänderung an der Online-Tabelle löst einen weiteren vollständigen Snapshot aus, wodurch die bereits erfassten Einträge erneut geschrieben werden. Filtere nicht alle insert Zeilen heraus, denn der erste Schreibvorgang für jede neue Entität ist ebenfalls ein insert.
Interpretieren der Ergebnisse
- Verfolgen Sie sowohl p50 als auch p99 von
feature_freshness_ms, und vergleichen Sie datengetriebene (is_timer = false) Zeilen mit Fensterablauf-(is_timer = true)-Zeilen. - Rechnen Sie mit einem kleinen periodischen Anstieg beim Batch-Übergang im Echtzeitmodus (standardmäßig 5 Minuten), wenn die Pipeline kurzzeitig pausiert, um einen Checkpoint zu erstellen und festzuschreiben. Dies ist typischerweise im Standardintervall vernachlässigbar.
- Beobachte den seltenen Long Tail (das Maximum, jenseits von p99). Sie spiegelt den Aufholprozess der Pipeline wider und nicht den stationären Zustand, insbesondere nach einem Neustart, wie etwa einem Wartungsneustart, wenn die Pipeline gepufferte Ereignisse verarbeitet. Messen Sie die Steady-State-Frische über ein Zeitfenster, das Neustarts ausschließt, und bewerten Sie die Neustartspitzen separat.
Einschränkungen
Stapelverarbeitungsfunktionen
- Pipelines zur Batch-Materialisierung werden als serverlose Lakeflow-Pipelines ausgeführt.
- Rolling-Window-Features im Batchbetrieb können nicht materialisiert werden, mit Ausnahme des reinen Online-Spezialfalls
Last, der in Aktuelle Werte mit begrenzter Aktualität materialisieren beschrieben wird. Für Offline-Training oder Batch-Inferenz werden Rolling-Window-Features für jede Point-in-Time-Abfrage auf Grundlage der Quelldaten berechnet. -
ColumnSelectionFeatures können nur in Online-Stores materialisiert werden. -
RequestSource,FeatureViewSource, undCustomUDFMerkmale können nicht materialisiert werden. Siehe On-Demand-Funktionen und Materialisierung. - Materialisierte Features können nur im Arbeitsbereich gelöscht werden, in dem sie erstellt wurden.
- Nur der Benutzer, der eine materialisierte Funktion erstellt hat, kann sie löschen, unabhängig davon, ob Unity Catalog Rechte auf der Funktion oder ihrem übergeordneten Schema gelten.
- Bei materialisierten Aggregationsfeatures kann das online materialisierte Feature nicht direkt gelöscht werden. Löschen Sie das gekoppelte offline materialisierte Feature, und die Änderung wird auf beide übertragen.
- Für materialisierte Aggregationsfeatures, die vor dem 20. April 2026 erstellt wurden, produziert die Materialisierungspipeline weiterhin neue Featurewerte, bis alle materialisierten Features in der Pipeline gelöscht wurden, wodurch die Ressourcenbereinigung ausgelöst wird. Zum Erstellen einer aktualisierten Pipeline, die das Löschen pro Feature unterstützt, löschen Sie das Feature und materialisieren Sie es erneut.
- Für materialisierte
ColumnSelectionFeatures produziert die Materialisierungspipeline weiterhin neue Featurewerte, bis alle materialisierten Features in der Pipeline gelöscht wurden, wodurch die Ressourcenbereinigung ausgelöst wird.
Streaming-Funktionen
- Streaming-Features können nur in Online-Stores materialisiert werden. Eine Offline-Materialisierung ist nicht erforderlich, da Streaming-Features während des Trainings so konzipiert sind, dass sie für jeden Datenpunkt aus historischen Ereignissen neu berechnet werden, um eine Genauigkeit im Millisekundenbereich zu erreichen.
- Streamingfeatures können nicht mit Batchfeatures in einem einzigen
materialize_featuresAufruf gemischt werden. -
compute_featuresunterstützt keine Streamingfunktionen. - Der Arbeitsbereich muss sich in einer Region befinden, die Lakebase-Instanzen unterstützt.
- Kafka-Nachrichten können JSON, Avro oder Protobuf verwenden. Für Schema-Anforderungen und Schema-Registry-Einschränkungen siehe Schema-Registry.
- Nur
RollingWindowundSawtoothWindowwerden für Streaming-Aggregationsfunktionen unterstützt.TumblingWindowundSlidingWindowsollten mit Batch-Features verwendet werden. Siehe Zeitfenster für Streaming-Funktionen. - Für Streamingfunktionen werden nur
Min,First,FirstDistinct,LastN,FirstN,Last,LastDistinct,Max,StddevPop,Sum,AvgundCountAggregatfunktionen unterstützt. - Spaltenauswahlfunktionen aus Streamingquellen unterstützen keine Nachrichten in falscher Reihenfolge. Das neueste Ereignis im Kafka-Datenstrom wird angezeigt, auch wenn der Wert der Zeitserienspalte vor einem zuvor empfangenen Ereignis liegt.
- Streaming-Pipelines werden zweimal pro Woche neu gestartet. Jeder Neustart kann zu Verarbeitungsverzögerungen und Startzeiten von bis zu 1 Minute führen. Ohne Neustarts beträgt die p99-Aktualität 200 ms.
- Streaming-Funktionen können nicht mit
backfill_featuresrückwirkend aufgefüllt werden. Um historische Daten zu einem Stream zum Training hinzuzufügen, konfigurieren Sie eine Abgleichswarteschlange für den Datenstrom. - Eine
RollingWindow-Funktion im Online-Shop deckt nur Ereignisse ab, die nach Materialisierungsbeginn eintreten, sodass ihre Werte erst wenn der gesamtewindow_durationverstrichen ist vollständig sind. EinSawtoothWindowFeature berechnet seine historischen Werte aus der Aufnahmetabelle des Streams, wenn die Materialisierung beginnt. Die Materialisierung berechnet diese Werte nicht erneut, wenn du später die Daten in der Datenaufnahmetabelle korrigierst. - Nur Databricks Online Feature Store wird unterstützt.
- Pipelines für die Streaming-Materialisierung werden als serverlose Lakeflow-Pipelines ausgeführt.