Muistiinpano
Tämän sivun käyttö edellyttää valtuutusta. Voit yrittää kirjautua sisään tai vaihtaa hakemistoa.
Tämän sivun käyttö edellyttää valtuutusta. Voit yrittää vaihtaa hakemistoa.
Koskee:✅ SQL-analytiikan päätepiste ja Microsoft Fabric -varasto
Tärkeää
Tämä ominaisuus on esikatseluvaiheessa.
Fabric tietovaraston tietoklusterointi järjestää datan nopeamman kyselysuorituskyvyn ja vähentyneen laskentakulutuksen takaamiseksi. Tämä opas käy läpi vaiheet taulujen luomiseksi tietoryhmittelyllä, aina klusteroitujen taulukoiden luomisesta niiden tehokkuuden tarkistamiseen.
Ennakkovaatimukset
- Microsoft Fabric -vuokraajatili, jolla on aktiivinen tilaus.
- Varmista, että sinulla on Microsoft Fabric -työtila: Luo työtila.
- Varmista, että olet jo luonut varaston. Uuden varaston luomiseksi katso kohdasta Luo varasto Microsoft Fabricissa.
- Perusymmärrys T-SQL:stä ja datan kyselyistä.
Mallitietojen tuominen
Tämä opetusohjelma käyttää NY Taxi -näyteaineistoa. Tuoda NY Taxi -tiedot varastoosi. Käytä Load Sample Data to tietovarasto -opastusopasta .
Luo taulukko, jossa datan klusterointi
Tätä opetusta varten tarvitsemme kaksi kopiota NYTaxi-taulukosta: tavallisen kopion taulusta, joka on tuotu tutoriaalista, ja kopion, joka käyttää datan klusterointia. Käytä seuraavaa komentoa luodaksesi uuden taulukon CREATE TABLE AS SELECT (CTAS) avulla, joka perustuu alkuperäiseen NYTaxi-taulukkoon:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Note
Esimerkki olettaa NY Taxi -aineiston taulukon nimen Load Sample data to tietovarasto -opetusohjelmassa. Jos käytit eri nimeä taulullesi, säädä komento korvaamaan nyctlc sen taulun nimellä.
Tämä komento luo tarkan kopion alkuperäisestä NYTaxi-taulukosta, mutta sarakkeelle on klusteroitu lpepPickupDatetime data. Seuraavaksi käytämme tätä saraketta kyselyihin.
Tietojen kysely
Suorita kysely NYTaxi-taulukossa ja toista sama kysely NYTaxi_With_DataClustering-taulukossa vertailua varten.
Note
Tässä analyysissä on hyödyllistä tarkastella molempien ajojen kylmävälimuistin suorituskykyä – eli ilman Fabric tietovaraston välimuistiominaisuuksia. Siksi suorita jokainen kysely täsmälleen kerran ennen kuin katsot tuloksia Query Insightsissa.
Käytämme kyselyä, joka toistuu usein varastossa. Tämä kysely laskee keskimääräisen lipun vuosittain päivien 2008-12-31 ja 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Note
Tässä kyselyssä käytetty tunnistevaihtoehto on hyödyllinen, kun vertaamme taulukon kyselytietoja Regular myöhemmin Query Insights -näkymien avulla, joka käyttää datan klusterointia.
Seuraavaksi toistamme täsmälleen saman kyselyn, mutta taulukon versiolla, joka käyttää datan klusterointia:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
Toinen kysely käyttää tunnistetta Clustered , jotta voimme myöhemmin tunnistaa tämän kyselyn Query Insightsin avulla.
Tarkista datan klusteroinnin tehokkuus
Klusteroinnin asennuksen jälkeen voit arvioida sen tehokkuutta Query Insightsin avulla. Query Insights in Fabric tietovarasto kerää historialliset kyselyjen suoritustiedot ja kokoaa sen toiminnallisiksi oivalluksiksi, kuten pitkään jatkuneiden tai usein suoritettavien kyselyiden tunnistamiseksi.
Tässä tapauksessa käytämme Query Insightsia vertaillaksemme skannattujen tietojen eroja tavallisten ja klusteroitujen tapausten välillä.
Käytä seuraavaa kyselyä:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Tämä kysely tuo yksityiskohtia näkymästä exec_requests_history . Lisätietoja löytyy queryinsights.exec_requests_history (Transact-SQL).
Kysely suodattaa tulokset seuraavilla tavoilla:
- Hae vain rivejä, jotka sisältävät
NYTaxikomennon nimen tekstin (kuten testikyselyissä käytettiin) - Hae vain rivejä, joissa etikettiarvo oli joko säännöllinen tai klusteroitu
Note
Kyselytietojen saattaminen Kyselyn Insightsiin voi kestää muutaman minuutin. Jos Query Insights -kyselysi ei anna tuloksia, yritä uudelleen muutaman minuutin kuluttua.
Tämän kyselyn aikana havaitsemme seuraavat tulokset:

Molemmilla kyselyillä on 6 rivimäärää ja samankaltaiset lähetysajat. Kysely Clustered osoittaa total_elapsed_time_ms vuosilta 1794, allocated_cpu_time_ms 1676 ja data_scanned_remote_storage_mb 77,519. Kysely Regular näyttää total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600 ja data_scanned_remote_storage_mb 177 700. Nämä luvut osoittavat, että vaikka molemmat kyselyt antoivat samat tulokset, versio Clustered käytti noin 36% vähemmän prosessoriaikaa kuin versio Regular ja skannasi noin 56% vähemmän dataa levyllä. Välimuistia ei käytetty kummassakaan kyselyssä. Nämä ovat merkittäviä tuloksia, jotka auttavat vähentämään kyselyjen suoritusaikaa ja kulutusta sekä tekevät sarakkeesta lpepPickupDatetime vahvan ehdokkaan datan klusterointiin.
Note
Tämä on pieni taulukko, jossa on noin 76 miljoonaa riviä ja 2GB datatilavuutta. Vaikka tämä kysely palauttaa vain kuusi riviä aggregaatiossaan (yksi jokaiselta vuodelta tällä alueella), se skannaa noin 8,3 miljoonaa riviä ennen tulosten yhdistämistä annetussa päivämäärävälissä. Todelliset tuotantotiedot suuremmilla aineistoilla voivat tuottaa merkittävämpiä tuloksia. Tulokset voivat vaihdella kapasiteetin koon, välimuistissa olevien tulosten tai samanaikaisuuden mukaan kyselyjen aikana.
Valitse klusterointisarakkeet työkuormastasi
Tuotantotauluissa käytä havaittuja kyselykuvioita sen sijaan, että arvaisit, mitkä sarakkeet ryhmitellään. Taidon operaatiokyky sqldw-cli analysoi Query Insights -historiaa, järjestää toistuvat kyselykuviot etäskannatun datan perusteella ja tunnistaa predikaateissa käytetyt WHERE sarakkeet.
Ennen kuin aloitat, asenna Skills for Fabric, varmista että varastossa on viimeisimmät kyselyaktiivisuudet ja varmista, että sinulla on Contributor workspace -rooli tai korkeampi. Sitten avaa GitHub Copilot CLI ja käytä tällaista kehotteen:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
Taito tunnistaa kyselykuviot, joilla on suurin vaikutus skannaukseen, poimii taulukot ja suodatussarakkeet näistä kyselyistä sekä järjestää klusterointiehdokkaat. Tarkista suositukset näiden ohjeiden avulla:
- Suosi sarakkeita, jotka suodattavat toistuvasti suuria taulukoita ja käyttävät keski- tai korkeita kardinaliteettiarvoja, kuten päivämääriä tai tunnisteita.
- Suosi sarakkeita, joita käytetään valikoivassa vaihteluvälissä tai yhtäsuuruuspredikaatteissa lausekkeessa
WHERE. - Älä valitse sarakkeita vain siksi, että ne näkyvät tasa-arvoliitosehdoissa. Nämä olosuhteet eivät hyödy datan klusterointiin.
- Käytä enintään neljää klusterointisarakkea, äläkä lisää enempää sarakkeita kuin työkuorma vaatii.
Esimerkiksi ajatellaan verkkokauppavarastoa, jossa Sales.SalesOrder on 1,5 miljardia riviä ja Sales.OrderLine 6 miljardia riveä. Toistuvien kyselyjen analysoinnin jälkeen taito saattaa palauttaa seuraavat suositukset:
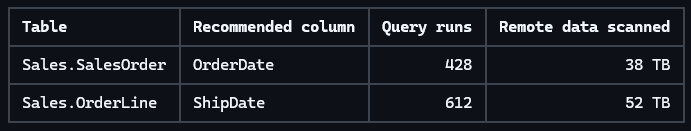
Päivämääräsarakkeet ovat vahvoja ehdokkaita, koska ne suodattavat suurimmat taulukot, tukevat yleisiä vaihteluvälejä ja tarjoavat enemmän tiedostojen ohittamisen mahdollisuuksia kuin matalan kardinaalisuuden sarakkeet kuten OrderStatus tai SalesRegion.
Toimintakyky sqldw-cli on vain luku -ominaisuus. Se suosittelee sarakkeita, mutta ei luo tai korvaa taulukoita. Kun olet tarkastellut suosituksen, käytä CTAS:ia luodaksesi klusteroidun kopion taulukosta:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Vertaa klusteroituja ja ei-klusteroituja työkuormia varmistaaksesi vaikutuksen. Kun olet vahvistanut klusteroidun taulun, nimeä alkuperäinen taulukko uudelleen ja sitten nimeä klusteroitu taulukko alkuperäiseen nimeen:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Alkuperäinen taulukko on edelleen saatavilla palautettavaksi Sales.SalesOrder_old . Varmista riippuvaiset työkuormat ja uusi taulukko ennen alkuperäisen taulukon poistamista. Kun et enää tarvitse rollback-kopiota, pudota se:
DROP TABLE Sales.SalesOrder_old;