Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
S’applique à : ✅ Entrepôt dans Microsoft Fabric
Cet article décrit les méthodes pour migrer de Azure Synapse Analytics pools SQL dédiés vers Microsoft Fabric Data Warehouse.
Conseil / Astuce
Pour plus d’informations sur la stratégie et la planification de votre migration, voir Planification de la migration : Azure Synapse Analytics pools SQL dédiés à Fabric Data Warehouse.
Une expérience automatisée pour la migration à partir de pools SQL dédiés Azure Synapse Analytics est disponible à l’aide de l’assistant de migration Fabric pour Data Warehouse. Le reste de cet article contient davantage d’étapes de migration manuelle.
Le tableau suivant résume les méthodes de migration du schéma de données (DDL), du code de la base de données (DML) et des données. La colonne Option renvoie aux détails de chaque scénario.
| Numéro d’option | Choix | Ce qu'il fait | Compétence ou préférence | Scénario |
|---|---|---|---|---|
| 1 | Usine de données | Conversion de schéma (DDL) Extraction de données Ingestion des données |
ADF/Pipeline | Migration tout-en-un simplifiée d’un seul schéma (DDL) et de données. Recommandé pour les tables de dimension. |
| 2 | Usine de données avec partition | Conversion de schéma (DDL) Extraction de données Ingestion des données |
ADF/Pipeline | Utilisation d'options de partitionnement pour augmenter le parallélisme de lecture/écriture offrant un débit dix fois supérieur à celui de l'option 1, recommandée pour les tables de faits. |
| 3 | Data Factory avec code accéléré | Conversion de schéma (DDL) | ADF/Pipeline | Convertissez et migrez d’abord le schéma (DDL), puis utilisez CETAS pour extraire et COPY/Data Factory pour ingérer des données afin d’obtenir des performances d’ingestion globales optimales. |
| 4 | Code accéléré de procédures stockées | Conversion de schéma (DDL) Extraction de données Évaluation du code |
T-SQL | Utilisateur SQL qui se sert de l’IDE avec un contrôle plus précis sur les tâches sur lesquelles il souhaite travailler. Utilisez COPY/Data Factory pour ingérer des données. |
| 5 | Extension de projet SQL Database pour Visual Studio Code | Conversion de schéma (DDL) Extraction de données Évaluation du code |
Projet SQL | Projet SQL Database pour le déploiement avec intégration de l’option 4. Utilisez COPY ou Data Factory pour ingérer des données. |
| 6 | CRÉER UNE TABLE EXTERNE EN SÉLECTIONNANT (CETAS) | Extraction de données | T-SQL | Extraction de données rentable et hautement performante dans Azure Data Lake Storage (ADLS) Gen2. Utilisez COPY/Data Factory pour ingérer des données. |
| 7 | Migrer à l’aide de dbt | Conversion de schéma (DDL) Conversion de code de base de données (DML) |
dbt | Les utilisateurs dbt existants peuvent utiliser l’adaptateur Fabric dbt pour convertir leurs DDL et DML. Vous devez ensuite migrer des données à l’aide d’autres options figurant dans ce tableau. |
Choisir une charge de travail pour la migration initiale
Lorsque vous déterminez par où commencer dans le projet de migration du pool SQL dédié Synapse vers Fabric Data Warehouse, choisissez un domaine de charge de travail dans lequel vous pouvez :
- Prouver la viabilité de la migration vers Fabric Data Warehouse en apportant rapidement les bénéfices du nouvel environnement. Commencez petit et simple, et préparez-vous à plusieurs petites migrations.
- Laisser à votre personnel technique interne le temps d’acquérir une expérience suffisante avec les processus et outils qu’il utilisera pour migrer vers d’autres zones.
- Créer un modèle pour les migrations futures spécifiques à l'environnement source Synapse et aux outils et processus en place pour aider.
Conseil / Astuce
Créez un inventaire des objets à migrer, et documentez le processus de migration du début à la fin afin de pouvoir le répéter pour d’autres pools SQL dédiés ou charges de travail.
Le volume de données migrées lors d’une migration initiale doit être suffisamment important pour démontrer les capacités et les avantages de l’environnement Fabric Data Warehouse, mais pas trop important pour démontrer rapidement la valeur. La valeur typique se situe dans la plage de 1 à 10 téraoctets.
Migration avec Fabric Data Factory
Cette section décrit les options Data Factory pour les utilisateurs familiers avec Azure Data Factory et les pipelines Synapse. L’interface glisser-déposer offre un moyen simple de convertir DDL et de migrer des données.
Fabric Data Factory peut effectuer les tâches suivantes :
- Convertir le schéma (DDL) dans la syntaxe de Fabric Data Warehouse.
- Créez le schéma (DDL) sur Fabric Data Warehouse.
- Migrez les données vers Fabric Data Warehouse.
Option numéro 1. Migration de schéma et de données - Assistant Copie de données et activité ForEach de copie
Cette méthode utilise l’assistant Data Factory Copy pour se connecter au pool SQL dédié source, convertir la syntaxe DDL du pool dédié SQL en Fabric, et copier les données en Fabric Data Warehouse. Vous pouvez sélectionner une ou plusieurs tables cibles (pour le jeu de données TPC-DS, il y a 22 tables). Cela génère l’activité ForEach qui permet de parcourir en boucle la liste des tables sélectionnées dans l’interface utilisateur et de générer 22 threads d’activité Copy parallèles.
- 22
SELECTrequêtes (une pour chaque table sélectionnée) sont générées et exécutées dans le pool SQL dédié. - Assurez-vous d’avoir la DWU et la classe de ressources appropriées pour permettre l’exécution des requêtes générées. Dans ce cas, vous avez besoin d’un minimum de DWU1000 avec
staticrc10pour permettre à un maximum de 32 requêtes de gérer 22 requêtes envoyées. - Copier les données directement du pool SQL dédié vers Fabric Data Warehouse avec Data Factory nécessite un stage. Le processus d’ingestion comporte deux phases :
- La première phase extrait les données du pool SQL dédié dans ADLS. Cette phase s’appelle la staging.
- La deuxième phase intègre les données en étapes dans Fabric Data Warehouse. La majeure partie du temps d’ingestion est passée dans la phase de mise en scène, donc la mise en scène a un effet significatif sur la performance.
Utilisation recommandée
L’utilisation de l’assistant de copie pour générer une activité ForEach offre une interface simple pour convertir DDL et ingérer des tables sélectionnées du pool SQL dédié en Fabric Data Warehouse en une seule étape.
Cependant, cette option n’offre pas un débit global optimal. La mise en scène et la nécessité de paralléléliser les lectures et écritures pendant la phase source-stage sont les principales sources de latence. Utilisez cette option uniquement pour les tables de dimensions.
Option 2. Migration DDL/Données - Pipeline utilisant l'option de partitionnement
Pour améliorer le débit lorsque vous chargez des tables de faits volumineuses avec un pipeline Fabric, utilisez une activité de copie pour chaque table de faits et activez le partitionnement. Cette configuration offre les meilleures performances pour l’activité de copie.
Utilisez les partitions physiques de la table source lorsque disponibles. Si la table n’est pas partitionnée physiquement, spécifiez une colonne de partition ainsi que les valeurs minimales et maximales pour le partitionnement dynamique. Dans la capture d’écran suivante, les options Source du pipeline spécifient une plage de partitions dynamique basée sur la ws_sold_date_sk colonne.

Le partitionnement peut augmenter le débit de préparation. Considérez les conseils suivants lors de la configuration :
- Selon la plage de partitions, l’opération peut générer plus de 128 requêtes et utiliser tous les emplacements de concurrence du pool SQL dédié.
- Vous devez effectuer une montée en charge jusqu’à un minimum de DWU6000 pour que toutes les requêtes puissent s’exécuter.
- Par exemple, pour la table
web_salesTPC-DS, 163 requêtes ont été soumises au pool SQL dédié. À DWU6000, 128 requêtes ont été exécutées tandis que 35 requêtes étaient en file d’attente. - La partition dynamique sélectionne automatiquement une partition par intervalles. Dans ce cas, il s’agit d’une plage de 11 jours pour chaque requête SELECT envoyée au pool SQL dédié. Par exemple:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Utilisation recommandée
Pour les tables de faits, utilisez Data Factory avec l’option de partitionnement pour augmenter le débit.
Cependant, les lectures parallèles nécessitent d’adapter le pool SQL dédié à une DWU supérieure afin qu’il puisse exécuter les requêtes d’extraction. Le partitionnement améliore le débit par dix par rapport à ne pas utiliser de partitionnement. Vous pouvez augmenter le DWU pour un débit accru, mais un pool SQL dédié permet un maximum de 128 requêtes actives.
Pour plus d’informations sur la correspondance entre Synapse DWU et Fabric, consultez Blog : Mise en correspondance des pools SQL dédiés Azure Synapse avec la puissance de calcul de Fabric Data Warehouse.
Option 3. Migration DDL - Assistant de copie des données pour chaque activité de copie
Les deux options précédentes conviennent aux bases de données plus petites . Si vous avez besoin d’un débit plus élevé, utilisez cette alternative :
- Extraire les données du pool SQL dédié vers ADLS pour réduire la surcharge de staging.
- Utilisez soit Data Factory, soit la commande COPY pour ingérer les données dans votre entrepôt.
Utilisation recommandée
Vous pouvez continuer à utiliser Data Factory pour convertir votre schéma (DDL). En utilisant l’assistant Copier les données, vous pouvez sélectionner la table spécifique ou Toutes les tables. Par conception, cette méthode migre le schéma en une seule étape, en extrayant le schéma sans aucune ligne en utilisant la fausse condition, TOP 0 dans l’instruction requête.
L’exemple de code suivant couvre la migration de schéma (DDL) avec Data Factory.
Exemple de code : Migration de schéma (DDL) avec Data Factory
Vous pouvez utiliser Fabric Pipelines pour migrer facilement vos DDL (schémas) pour des objets de table depuis n’importe quelle source Azure SQL Database ou pool SQL dédié. Ce pipeline migre le schéma (DDL) des tables de pool SQL dédiées à la source vers Fabric Data Warehouse.

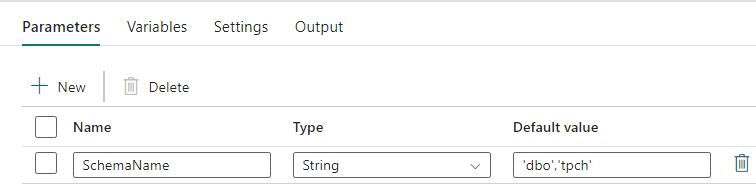
Conception de pipeline : paramètres
Ce pipeline accepte un paramètre SchemaName, que vous utilisez pour spécifier quels schémas migrer. Le schéma par défaut est dbo.
Dans le champ valeur par défaut, entrez la liste séparée par des virgules des schémas de table indiquant les schémas à migrer : 'dbo','tpch' pour fournir deux schémas, dbo et tpch.
Conception de pipeline : activité Recherche
Créez une activité LookUp et définissez la connexion pour qu’elle pointe vers votre base de données source.
Sous l’onglet Paramètres :
Réglez Type de stockage de données sur Externe.
Connection est votre pool SQL dédié à Azure Synapse. Le type de connexion correspond à Azure Synapse Analytics.
Le paramètre Utiliser la requête est défini sur Requête.
Construis le champ de requête en utilisant une expression dynamique, afin de pouvoir utiliser le paramètre
SchemaNamedans une requête qui retourne une liste de tables sources cibles. Sélectionnez Requête puis sélectionnez Ajouter du contenu dynamique.Cette expression au sein de l’activité LookUp génère une instruction SQL pour interroger les vues système afin de récupérer la liste des schémas et tables. Il fait référence au
SchemaNameparamètre permettant le filtrage sur les schémas SQL. La sortie de cette expression est un tableau de schémas et tables SQL que l’activité ForEach utilise en entrée.Utilisez le code suivant pour retourner la liste de toutes les tables utilisateur avec leur nom de schéma.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

Conception de pipeline : boucle ForEach
Pour la boucle ForEach, configurez les options suivantes sous l’onglet Paramètres :
- Désactivez Sequential pour permettre l’exécution simultanée de plusieurs itérations.
- Définissez le paramètre Nombre de lots sur
50, en limitant le nombre maximal d’itérations simultanées. - Utilisez du contenu dynamique dans le champ Items pour référencer la sortie de l’activité LookUp. Utilisez l’extrait de code suivant :
@activity('Get List of Source Objects').output.value

Conception de pipeline : activité Copy au sein de la boucle ForEach
Au sein de l’activité ForEach, ajoutez une activité Copy. Cette méthode utilise le langage d’expression dynamique au sein des pipelines pour construire une instruction SELECT TOP 0 * FROM <TABLE> afin de migrer uniquement le schéma, sans les données, vers un entrepôt de données.
Sous l’onglet Source :
- Réglez Type de stockage de données sur Externe.
- Connection est votre pool SQL dédié à Azure Synapse. Le type de connexion correspond à Azure Synapse Analytics.
- Définissez Utiliser la requête sur Requête.
- Dans le champ Requête , collez la requête de contenu dynamique et utilisez cette expression qui retourne zéro ligne, mais inclut le schéma de la table :
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

Sous l’onglet Destination :
- Définissez Type de magasin de données sur Espace de travail.
- Définissez le type de stockage de données Workspace sur Data Warehouse et définissez le Data Warehouse sur l’entrepôt.
- Le schéma et le nom de la table de destination sont définis à l’aide du contenu dynamique.
- Schéma fait référence au champ de l’itération en cours,
SchemaNameavec le extrait :@item().SchemaName - Références de table
TableNameavec l’extrait suivant :@item().TableName
- Schéma fait référence au champ de l’itération en cours,

Conception de pipeline : Récepteur
Pour Récepteur, pointez vers votre entrepôt et référencez le nom du schéma source et de la table.
Lorsque vous exécutez ce pipeline, vous voyez votre entrepôt se remplir avec chacune des tables de votre source, selon le schéma correct.
Migration en utilisant des procédures stockées dans le pool SQL dédié Synapse
Cette option utilise des procédures stockées pour effectuer la migration vers Fabric Data Warehouse.
Vous pouvez obtenir les exemples de code sur microsoft/fabric-migration sur GitHub.com. Ce code est partagé en open source. N’hésitez donc pas à apporter votre contribution pour soutenir la communauté.
Ce que les procédures stockées Fabric Migration peuvent faire :
- Convertir le schéma (DDL) dans la syntaxe de Fabric Data Warehouse.
- Créez le schéma (DDL) sur Fabric Data Warehouse.
- Extraire des données du pool SQL dédié Synapse vers ADLS.
- Signalez la syntaxe Fabric non prise en charge pour les codes T-SQL (procédures stockées, fonctions, vues).
Utilisation recommandée
Cette option est idéale pour vous si vous :
- connaissent bien T-SQL ;
- Je souhaite utiliser un environnement de développement intégré pour le développement T-SQL.
- Vous souhaitez un contrôle plus précis sur les tâches que vous réalisez.
Vous pouvez exécuter la procédure stockée propre à la conversion de schéma (DDL), l’extraction de données ou l’évaluation de code T-SQL.
Pour la migration des données, utilisez soit COPY INTO, soit Fabric Data Factory pour intégrer les données dans votre entrepôt.
Migration à l’aide de projets SQL Database
Fabric Data Warehouse prend en charge l’extension SQL Database Projects disponible dans Visual Studio Code.
Cette extension est disponible dans Visual Studio Code. Cette fonctionnalité permet des capacités de contrôle de source, de test de base de données et de validation de schéma.
Pour plus d’informations sur le contrôle de sources, voir Aperçu du développement et du déploiement.
Utilisation recommandée
Utilisez cette option si vous préférez utiliser SQL Database Project pour votre déploiement. Cette option intègre les procédures stockées de migration Fabric dans le projet de base de données SQL pour offrir une expérience de migration fluide.
Un projet SQL Database permet de :
- Convertir le schéma (DDL) dans la syntaxe de Fabric Data Warehouse.
- Créez le schéma (DDL) sur Fabric Data Warehouse.
- Extraire des données du pool SQL dédié Synapse vers ADLS.
- Marquer la syntaxe non prise en charge pour les codes T-SQL (procédures stockées, fonctions, vues).
Pour la migration des données, utilisez soit COPY INTO , soit Data Factory pour ingérer les données dans votre entrepôt.
L’équipe Microsoft Fabric CAT fournit des scripts PowerShell pour extraire, créer et déployer le code de schéma (DDL) et de base de données (DML) via un projet de base de données SQL. Pour un guide, consultez microsoft/fabric-migration sur GitHub.
Pour plus d’informations sur les projets SQL Database, consultez Prise en main de l’extension Projets SQL Database et Génération d’un projet de base de données à partir de la ligne de commande.
Migration de données avec CETAS
La commande T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) fournit la méthode la plus rentable et optimale pour extraire des données des pools SQL dédiés Azure Synapse vers Azure Data Lake Storage (ADLS) Gen2.
Ce que la commande CETAS peut faire :
- Extraire des données dans ADLS.
- Cette option vous oblige à créer le schéma (DDL) dans votre entrepôt avant d’ingérer les données. Considérez les options décrites dans cet article pour migrer le schéma (DDL).
Les avantages de cette option sont les suivants :
- La migration ne soumet qu’une seule requête par table sur le pool SQL dédié Synapse source. Cette requête n’occupe pas tous les créneaux de simultanéité et ne bloque pas les processus ETL de production du client ni les requêtes exécutées simultanément.
- Vous n’avez pas besoin de passer à DWU6000, car un seul emplacement de concurrence est utilisé pour chaque table, donc vous pouvez utiliser des DWU plus faibles.
- L’extraction s’exécute en parallèle sur tous les nœuds de calcul, et cette fonctionnalité améliore les performances.
Utilisation recommandée
Utilisez CETAS pour extraire les données dans ADLS sous forme de fichiers Parquet. Les fichiers Parquet offrent l’avantage d’un stockage efficace des données grâce à une compression par colonnes qui nécessite moins de bande passante pour transiter sur le réseau. Étant donné que Fabric stocke les données au format Delta Parquet, l’ingestion des données est 2,5 fois plus rapide qu’avec le format de fichier texte, car aucune conversion au format Delta n’est nécessaire pendant l’ingestion.
Pour augmenter le débit CETAS :
- Ajoutez des opérations CETAS parallèles, ce qui augmente l’utilisation des emplacements d’accès concurrentiel, mais autorise un débit plus élevé.
- Mettez à l’échelle la DWU sur le pool SQL dédié Synapse.
Migration par le biais de dbt
Cette section décrit l’option dbt pour les clients qui utilisent déjà la dbt dans leur environnement dédié de pool SQL Synapse.
Ce que peut faire dbt :
- Convertir le schéma (DDL) dans la syntaxe de Fabric Data Warehouse.
- Créez le schéma (DDL) sur Fabric Data Warehouse.
- Convertir le code de base de données (DML) en syntaxe Fabric.
Le framework dbt génère les DDL et DML (scripts SQL) à la volée à chaque exécution. En utilisant des fichiers modèles exprimés sous SELECT forme d’instructions, dbt traduit instantanément le DDL/DML vers n’importe quelle plateforme cible en modifiant le profil (chaîne de connexion) et le type d’adaptateur.
Utilisation recommandée
Le cadre DBT utilise une approche axée sur le code. Migrez les données en utilisant les options listées dans ce document, telles que CETAS ou COPY/Data Factory.
En utilisant l’adaptateur dbt pour Microsoft Fabric Data Warehouse, vous pouvez migrer des projets DBT existants ciblant différentes plateformes comme Azure Synapse pools SQL dédiés, Snowflake, Databricks, Google BigQuery ou Amazon Redshift vers un entrepôt avec un simple changement de configuration.
Pour débuter un projet DBT ciblant Fabric Data Warehouse, consultez le tutoriel : Configurez la dbt pour Fabric Data Warehouse. Ce document liste également une option pour se déplacer entre différents entrepôts et quais.
Ingestion de données dans Fabric Data Warehouse
Pour l’ingestion dans Fabric Data Warehouse, utilisez COPY INTO ou Fabric Data Factory, selon vos préférences. Les deux méthodes sont les options recommandées et les plus performantes, car elles ont un débit de performance équivalent, à condition que les fichiers soient déjà extraits dans Azure Data Lake Storage (ADLS) Gen2.
Concevez votre procédé pour des performances maximales en tenant compte des facteurs suivants :
- Avec Fabric, il n'y a pas de contention de ressources lors du chargement simultané de plusieurs tables de l'ADLS vers Fabric Data Warehouse. Par conséquent, il n’y a aucune dégradation des performances lors du chargement de threads parallèles. Le débit maximal d’ingestion est limité uniquement par la puissance de calcul de votre capacité Fabric.
- La gestion des charges de travail Fabric assure la séparation des ressources allouées à la charge et à la requête. Il n’y a pas de contention de ressources lorsque les requêtes et le chargement des données s’exécutent simultanément.
Contenu connexe
- Assistant de migration Fabric pour l'entrepôt de données
- Créer un entrepôt dans Microsoft Fabric
- Instructions sur les performances de l’entrepôt de données Fabric
- Sécurité dans Fabric Data Warehouse
- Blog : Mise en correspondance des pools SQL dédiés Azure Synapse avec la capacité de calcul de Fabric Data Warehouse
- Vue d’ensemble de la migration de Microsoft Fabric