Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Azure Monitor fournit un ensemble de vues dans le portail Azure qui combinent les données de performances et de journal collectées à partir de votre cluster Kubernetes pour vous aider à analyser son intégrité et ses performances. Cet article décrit les différentes vues disponibles et comment interagir avec et interpréter les données qu’ils présentent.
Affichage multicluster
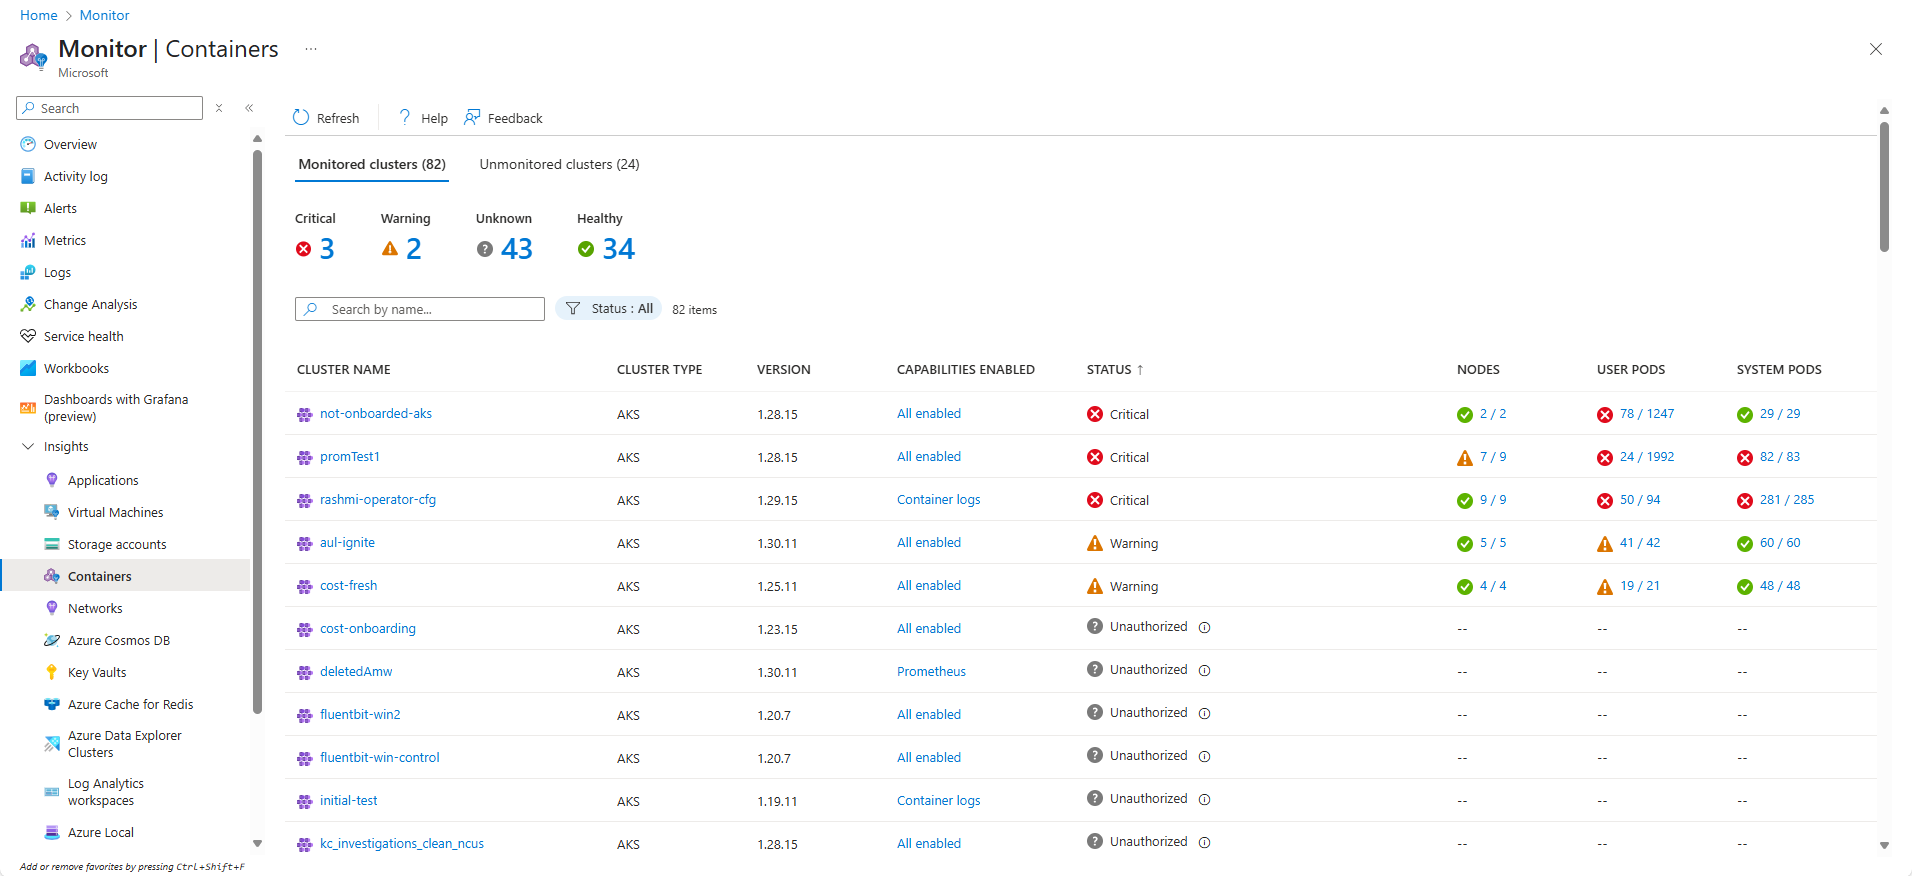
Pour ouvrir la vue multi-cluster, sélectionnez Containers dans le menu Insights du menu Monitor dans le portail Azure. Cette vue affiche l’état d’intégrité de tous les clusters Kubernetes surveillés déployés sur des groupes de ressources dans vos abonnements. Cette vue vous permet d’identifier rapidement les clusters qui sont dans un état critique ou défectueux et vous aide également à activer et à configurer la surveillance de tous les clusters de votre environnement. Pour plus d’informations, consultez Activer la surveillance des clusters AKS .
Remarque
Azure Stack (préversion) et Non-Azure (préversion) ne sont plus pris en charge dans cette vue.
Sélectionnez la colonne Nœuds pour ouvrir l’onglet Nœuds dans la vue à cluster unique pour ce cluster. Ouvrez l’onglet Contrôleurs du cluster avec un filtre approprié en sélectionnant les pods utilisateur ou la colonne Pods système .
Le tableau suivant décrit les différents états de santé affichés dans cette vue. L'état de santé calcule l'état global du cluster comme étant le pire des trois états. Si l’un des trois états est Inconnu, l’état global du cluster indique Inconnu.
| Statut | Descriptif |
|---|---|
| Healthy | Aucun problème n’est détecté pour la machine virtuelle et fonctionne comme nécessaire. |
| Avertissement | Un ou plusieurs problèmes sont détectés qui doivent être résolus ou la condition de santé peut devenir critique. |
| Critique | Un ou plusieurs problèmes critiques sont détectés qui doivent être résolus pour restaurer l’état opérationnel normal comme prévu. |
| Non autorisé | L'utilisateur ne dispose pas des autorisations requises pour lire les données dans l'espace de travail ou la règle de collecte de données collectant les données. |
| Introuvable | L’espace de travail, le groupe de ressources ou l’abonnement qui contient l’espace de travail a été supprimé. |
| Activer les règles d’enregistrement | Activez les règles d’enregistrement Prometheus pour déverrouiller des données de performances plus élevées et des visualisations Prometheus. |
| Mal configuré | Nous avons rencontré un problème. |
| Erreur | Une erreur s’est produite lors de la tentative de lecture des données à partir de l’espace de travail. |
| Pas de données | Les données n’ont pas été rapportées à l’espace de travail depuis les 30 dernières minutes. |
| Inconnu | Si le service n’a pas pu établir de connexion avec le nœud ou le pod, l’état passe à un état inconnu. |
| En attente | La configuration de la surveillance pour les clusters avec Arc prend généralement environ 5 minutes. Si le cluster est déconnecté de Azure, ce processus peut être retardé. |
| En attente pendant X heures | La configuration de surveillance du cluster avec Arc prend plus de temps que prévu. |
| Échec | Échec de la configuration de la surveillance pour le cluster activé avec Arc. |
Le tableau suivant fournit une répartition du calcul pour le contrôle des états d’intégrité pour un cluster surveillé sur la vue multicluster.
| Cluster supervisé | Statut | Disponibilité |
|---|---|---|
| Pod utilisateur | Healthy Avertissement Critique Inconnu |
100 % 90 - 99 % <90 % Non signalé dans les 30 dernières minutes |
| Pod système | Healthy Avertissement Critique Inconnu |
100 % N/A 100 % Non signalé dans les 30 dernières minutes |
| Nœud | Healthy Avertissement Critique Inconnu |
>85 % 60 - 84 % <60 % Non signalé dans les 30 dernières minutes |
Affichage de cluster unique
Pour ouvrir l’affichage de cluster unique, sélectionnez un cluster dans l’affichage multi-cluster ou sélectionnez Surveiller dans le menu d’un cluster. Cette vue fournit plusieurs onglets qui vous permettent d’explorer l’intégrité et les performances du cluster sélectionné.
Options
| Choix | Descriptif |
|---|---|
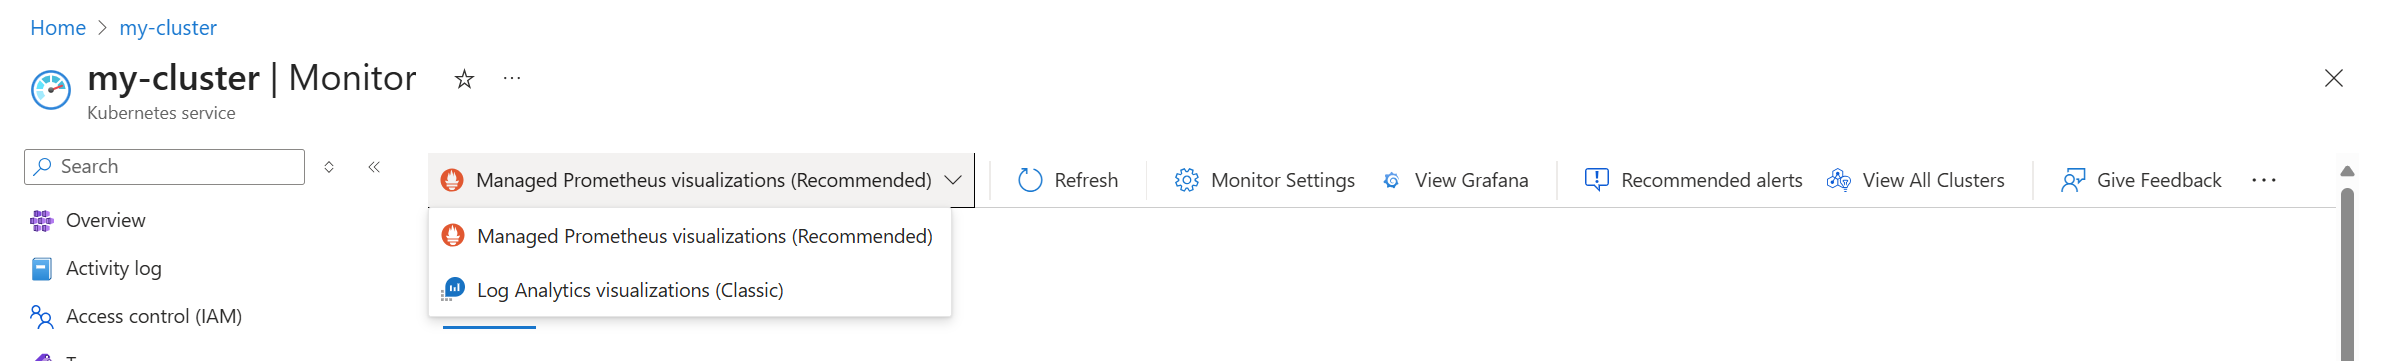
| Visualisation | Vous permet de sélectionner la source de données utilisée pour remplir la vue. Visualisations Prometheus managées est le paramètre préféré qui utilise les métriques Prometheus stockées dans un espace de travail Azure Monitor. Celles-ci sont activées lorsque vous activez Managed Prometheus pour le cluster. Log Analytics visualisations utilise des données de performances stockées dans un espace de travail Log Analytics. Vous ne collectez peut-être pas ces données si vous ne collectez pas les données de performances dans votre profil de journalisation. Cette option ne sera pas disponible si Managed Prometheus n’est pas activé pour le cluster. |
| Actualiser | Actualise les données dans la vue. |
| Surveiller les paramètres | Ouvre les paramètres de configuration de surveillance du cluster. Pour plus d’informations, consultez Activer la surveillance des clusters AKS . |
| Afficher Grafana | Affiche la liste des instances de Managed Grafana qui sont liées à l’espace de travail Azure Monitor du cluster. Vous pouvez ouvrir des tableaux de bord pour l’instance ou afficher la configuration de l’instance. |
| Alertes recommandées | Configurez les alertes recommandées pour le cluster. Pour plus d’informations, consultez Créer des alertes recommandées pour les clusters Kubernetes . |
| Afficher tous les clusters | Ouvrez la vue multicluster. |
Filtrage des données
Chacun des onglets de la vue à cluster unique fournit des options pour filtrer les données présentées. Chaque onglet a un filtre pour l’intervalle de temps des données collectées. Les ongletsNœuds, Contrôleurs et Conteneurs vous permettent d’ajouter des données de filtre ou par nœud ou espace de noms en sélectionnant Ajouter un filtre.
Onglet Overview
L’onglet Vue d’ensemble fournit un ensemble de vignettes montrant l’intégrité et les performances de ce cluster. Plusieurs de ces vignettes peuvent être désactivées si vous n’avez pas activé certaines fonctionnalités de surveillance. Dans ce cas, la vignette offre une option permettant de lancer le processus d’intégration du cluster. Pour plus d’informations, consultez Enable Kubernetes monitoring using the Azure portal.
Les onglets Nœuds, Contrôleurs et Conteneurs
Les onglets Nœuds, Contrôleurs et Conteneurs affichent une liste de ces ressources pour le cluster. Les onglets sont désactivés si vous ne collectez pas de données de performances pour le cluster. Dans ce cas, l’onglet offre une option permettant de lancer le processus d’intégration du cluster. Pour plus d’informations, consultez Enable Kubernetes monitoring using the Azure portal.
Statut
Les icônes du champ État indiquent l’état en ligne de l’élément, comme décrit dans le tableau suivant.
| Icône | Statut |
|---|---|

|
|

|
Waiting or Paused (En attente ou en pause) |

|
Last reported running but hasn’t responded more than 30 minutes (Dernière exécution signalée, mais pas de réponse depuis plus de 30 minutes) |

|
Successfully stopped or failed to stop (Réussite ou échec de l’arrêt) |

|
Statut Échec |
Sélectionner la métrique
Les onglets Nœuds, Contrôleurs et Conteneurs incluent une option permettant de sélectionner la métrique utilisée pour les valeurs de l’affichage.

Pour passer en revue l’utilisation de la mémoire, dans la liste déroulante Métriques , sélectionnez Mémoire RSS ou Jeu de travail mémoire. La mémoire RSS est prise en charge uniquement pour Kubernetes version 1.8 et ultérieure. Sinon, vous affichez les valeurs de Min % en tant que naN %, qui est une valeur de type de données numérique qui représente une valeur non définie ou non répérée.
Le jeu de travail de mémoire affiche à la fois la mémoire résidente et la mémoire virtuelle (y compris le cache) et représente l'ensemble de ce que l'application utilise. La mémoire RSS affiche uniquement la mémoire principale, qui n’est qu’une mémoire résidente. Cette métrique montre la capacité réelle de la mémoire disponible.
- La mémoire résidente ou la mémoire principale est la quantité réelle de mémoire de l’ordinateur disponible pour les nœuds du cluster.
- La mémoire virtuelle est réservée à l’espace disque (cache) utilisé par le système d’exploitation pour échanger des données de la mémoire vers le disque en cas de sollicitation de la mémoire, puis la récupérer en mémoire si nécessaire.
Sélectionner le calcul des métriques
Le sélecteur de centile définit la façon dont la métrique est agrégée sur l’intervalle de temps sélectionné. Le titre de la colonne agrégée change pour correspondre à l’option sélectionnée.

Colonne Tendance
Lorsque vous pointez sur le graphique à barres sous la colonne Tendance , chaque barre affiche l’utilisation du processeur ou de la mémoire, selon la métrique sélectionnée, dans un exemple de période de 15 minutes. Après avoir sélectionné le graphique de tendances à l’aide d’un clavier, utilisez la combinaison Alt + Pg. préc ou Alt + Pg. suiv pour parcourir chaque barre individuellement. Vous obtenez les mêmes détails que si vous survoliez la barre.

Dans l’exemple suivant, pour le premier nœud de la liste, aks-nodepool1-, la valeur des conteneurs est 25. Il s’agit du cumul du nombre de conteneurs déployés.

Volet de propriétés
Sélectionnez n’importe quel élément pour ouvrir un volet de propriétés qui affiche les propriétés de l’élément sélectionné. Lorsqu’un nœud Linux est sélectionné, la section Capacité de disque local affiche également l’espace disque disponible et le pourcentage utilisé pour chaque disque présenté au nœud. Dans ce volet, vous pouvez également afficher les journaux de conteneur Kubernetes (stdout/stderror), les événements et les métriques de pod en sélectionnant l’onglet Événements en direct en haut du volet. Pour plus d’informations sur cette fonctionnalité, consultez Comment afficher les journaux Kubernetes, les événements et les métriques de pod en temps réel.
Afficher les données du journal
Pour afficher les données de journal pour la ressource sélectionnée en fonction des recherches de journal prédéfinies, sélectionnez View Events in Log Analytics dans le volet de propriétés. Pour plus d’informations sur ces données et requêtes de journal, consultez Comment interroger les journaux de conteneurs.
Onglet Nœuds
Le tableau suivant décrit les colonnes de l’onglet Nœuds .
| Colonne | Descriptif |
|---|---|
| Nom | Nom de l’hôte. |
| Statut | Vue Kubernetes de l’état du nœud. |
| Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | Pourcentage moyen du nœud basé sur le centile durant la période spécifiée. |
| Min, Avg (Moy), 50th (50e), 90th (90e), 95th (95e), Max | Valeur réelle moyenne des nœuds basée sur le centile durant la période spécifiée. La valeur moyenne est mesurée à partir de la limite de processeur/mémoire définie pour un nœud. Pour les pods et les conteneurs, il s’agit de la valeur moyenne indiquée par l’hôte. |
| Conteneurs | Nombre de conteneurs. |
| Durée de bon fonctionnement | Indique le temps écoulé depuis le démarrage ou le redémarrage d’un nœud. |
| Contrôleur | Uniquement pour les conteneurs et les pods. Indique le contrôleur dans lequel l’élément réside. Tous les pods ne sont pas dans un contrôleur. Certains peuvent donc afficher N/A. |
| Tendance Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | La tendance du graphique à barres indique la métrique de centile en pourcentage du contrôleur. |
La hiérarchie de lignes de l’onglet Nœuds suit le modèle objet Kubernetes. Développez un nœud pour afficher ses pods. Si plusieurs conteneurs sont regroupés dans un pod, ils sont affichés comme la dernière ligne de la hiérarchie. Vous pouvez également voir le nombre de charges de travail non associées à un pod qui sont actuellement exécutées sur l’ordinateur hôte si le processeur ou la mémoire de l’hôte sont très sollicités.

Windows Server conteneurs sont affichés après tous les nœuds Linux de la liste. Lorsque vous développez un nœud Windows Server, vous pouvez afficher un ou plusieurs pods et conteneurs qui s’exécutent sur le nœud. Une fois qu’un nœud est sélectionné, le volet Propriétés affiche les informations de version.

Azure Container Instances nœuds virtuels qui exécutent le système d’exploitation Linux sont affichés après le dernier nœud de cluster AKS dans la liste. Lorsque vous développez un nœud virtuel Container Instances, vous pouvez afficher un ou plusieurs pods et conteneurs Container Instances qui s’exécutent sur le nœud. Les métriques ne sont pas collectées et signalées pour les nœuds, uniquement pour les pods.

À partir d’un nœud développé, vous pouvez explorer le pod ou le conteneur qui s’exécute sur le nœud jusqu’au contrôleur pour afficher les données de performances filtrées pour ce contrôleur. Sélectionnez la valeur sous la colonne Contrôleur pour le nœud spécifique.

L’affichage d’entrée Autres processus est destiné à vous aider à comprendre clairement la cause racine de l’utilisation élevée des ressources sur votre nœud. Ces informations vous aident à faire la distinction entre l’utilisation des processus conteneurisés par rapport aux processus non conteneurisés. Il s’agit de processus non conteneurisés qui s’exécutent sur votre nœud et qui incluent les éléments suivants :
- Processus Kubernetes autogérés ou gérés non-containerisés
- Les processus d’exécution des conteneurs
- Kubelet
- Processus système s’exécutant sur votre nœud
- Autres charges de travail non Kubernetes s’exécutant sur du matériel de nœud ou une machine virtuelle
La valeur d’autres processus est Total usage from CAdvisor - Usage from containerized process.
Onglet Contrôleurs
L’onglet Contrôleurs vous permet de consulter l'état de performance de vos contrôleurs, des contrôleurs de nœud virtuel et des pods de nœud virtuel non connectés à un contrôleur.

La hiérarchie de ligne commence par un contrôleur. Développer un contrôleur permet d’afficher un ou plusieurs pods. Développez un pod : vous voyez que la dernière ligne affiche le conteneur lié à un pod. À partir d’un contrôleur développé, vous pouvez explorer jusqu’au nœud en cours d’exécution pour afficher les données de performances filtrées pour ce nœud. Les pods de Container Instances qui ne sont pas connectés à un contrôleur sont répertoriés en dernier dans la liste.

Sélectionnez la valeur sous la colonne Nœud du contrôleur spécifique.

Le tableau suivant décrit les colonnes de l’onglet Contrôleurs .
| Colonne | Descriptif |
|---|---|
| Nom | Nom du contrôleur. |
| Statut | L'état de cumul des conteneurs une fois leur exécution terminée. L’icône d’état affiche un nombre basé sur ce que fournit le pod. Elle montre les deux pires états. Lorsque vous pointez sur un état, elle affiche l’état de rollup de tous les pods du conteneur. S’il n’existe pas d’état prêt, la valeur d’état s’affiche (0) . |
| Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | Moyenne cumulée du pourcentage moyen de chaque entité pour la métrique et le centile sélectionnés. |
| Min, Avg (Moy), 50th (50e), 90th (90e), 95th (95e), Max | Cumul de la performance moyenne du processeur ou de la mémoire du conteneur pour le centile sélectionné. La valeur moyenne est mesurée à partir de la limite Processeur/Mémoire définie pour un pod. |
| Conteneurs | Nombre total de conteneurs pour le contrôleur ou pod. |
| Redémarrages | Cumul du nombre de redémarrages à partir des conteneurs. |
| Durée de bon fonctionnement | Indique le temps écoulé depuis le démarrage d’un conteneur. |
| Nœud | Uniquement pour les conteneurs et les pods. Indique le contrôleur dans lequel l’élément réside. |
| Tendance Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | La tendance du graphique à barres indique la métrique de centile du contrôleur. |
Onglet Conteneurs
L'onglet Conteneurs vous permet de voir l'état de performance de vos conteneurs.

À partir d’un conteneur, vous pouvez accéder à un pod ou un nœud pour afficher les données de performance filtrées pour cet objet. Sélectionnez la valeur sous la colonne Pod ou Node pour le conteneur spécifique.
Le tableau suivant décrit les colonnes de l’onglet Conteneurs .
| Colonne | Descriptif |
|---|---|
| Nom | nom du conteneur. |
| Statut | État du conteneur. |
| Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | Cumul du pourcentage moyen de chaque entité pour la métrique et le centile sélectionnés. |
| Min, Avg (Moy), 50th (50e), 90th (90e), 95th (95e), Max | Cumul de la performance moyenne du processeur ou de la mémoire du conteneur pour le centile sélectionné. La valeur moyenne est mesurée à partir de la limite Processeur/Mémoire définie pour un pod. |
| Pod | Conteneur dans lequel se trouve le pod. |
| Nœud | Nœud sur lequel se trouve le conteneur. |
| Redémarrages | Indique le temps écoulé depuis le démarrage d’un conteneur. |
| Durée de bon fonctionnement | Indique le temps écoulé depuis le démarrage ou le redémarrage d’un conteneur. |
| Tendance Min %, Avg % (Moy %), 50th % (50e %), 90th % (90e %), 95th % (95e %), Max % | La tendance du graphique à barres indique la métrique de centile en pourcentage du conteneur. |
Étapes suivantes
- Consultez Créer des alertes de performances avec Container Insights pour découvrir comment créer des alertes pour une utilisation élevée du processeur et de la mémoire pour prendre en charge vos processus et procédures devOps ou opérationnels.
- Consultez les exemples de requêtes de journal pour voir les requêtes et exemples prédéfinis pour évaluer ou personnaliser les alertes, visualiser ou analyser vos clusters.