Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta. Aucun réglage d’espace de travail n’est nécessaire pour l’activer. Installez l’interface en ligne de commande Agent Bricks pour commencer.
La ligne de commande Agent Bricks (databricks-agentbricks) est un outil en ligne de commande Azure Databricks destiné aux développeurs qui créent et déploient des agents personnalisés en code.
Agent Bricks CLI est une approche orientée code pour créer des agents personnalisés depuis le terminal. La CLI Agent Bricks génère la structure de base d’un projet à l’aide d’un framework intégré fondé sur les bonnes pratiques de Databricks. Il peut ensuite exécuter le projet localement pour les tests et le déployer sur l’exécution de l’agent Azure Databricks. La CLI permet de passer d’un répertoire vide à un agent déployé sans avoir à câbler le temps d’exécution, les outils, la mémoire et les ressources gérées à la main. Pour d’autres moyens de créer des agents personnalisés, y compris le flux de travail basé sur une application, voir Exécuter des agents sur Databricks Apps en utilisant le serveur d’agents hérité.
Prerequisites
La Databricks CLI, installée et disponible dans votre variable PATH.
Python 3.10 ou supérieur, avec
pip.Installer la CLI Agent Bricks :
pip install databricks-agentbricks
Le cycle de vie de la CLI des Agent Bricks
La CLI Agent Bricks génère la structure d’un répertoire local contenant le code d’agent déployable à partir d’un modèle de cadre applicatif, avec l’environnement d’exécution, les tests et, en option, une interface de chat déjà configurés. Vous écrivez la logique applicative (modèle, outils et invites), et la CLI s’occupe de l’exécution locale et de son déploiement sur l’infrastructure Azure Databricks.
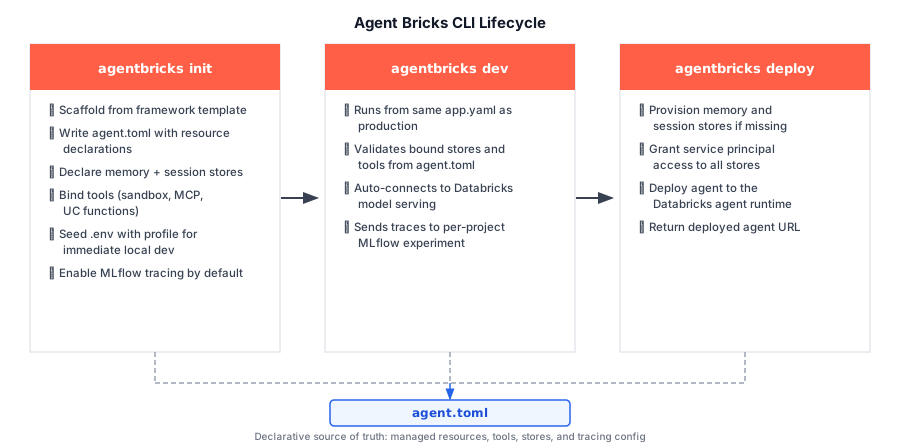
agent.tomlest la source déclarative de vérité pour toutes les ressources gérées par Azure Databricks dont votre agent dépend : les liaisons d’outils (bac à sable de données, services du protocole de contexte de modèle géré (MCP), fonctions du catalogue Unity), ainsi que les ressources mémoire, session et traçage.
agentbricks deploy Il le lit pour provisionner et câbler tout, donc c’est le fichier, et non le code de configuration manuscrit, qui est déployé.
Les trois commandes qui passent un agent d’un répertoire vide à la production :
-
agentbricks initgénère la structure du projet à partir d’un modèle intégré et peut, en option, initialiser un fichier.envavec un profil Databricks afin que le projet puisse être exécuté immédiatement. -
agentbricks devexécute l’agent localement avec le service de déploiement de modèles d’Azure Databricks afin que vous puissiez le tester avant de le déployer. -
agentbricks deployprovisionne les ressources déclarées dansagent.tomlet déploie l’agent vers l’exécution de l’agent Azure Databricks.
Note
Vous pouvez aussi ajouter des outils et associer des stockages de mémoire et de session à tout moment, pas seulement lors de l’initialisation. Utilisez agentbricks tools add, agentbricks memory bind, et agentbricks sessions bind pour mettre à jour la configuration de votre agent entre chacune de ces étapes.
Capacités de la CLI d’Agent Bricks
| Capacité | Description |
|---|---|
| Accès aux modèles | La ligne de ligne de commande Agent Bricks prévoit automatiquement l’accès au modèle afin que votre agent puisse appeler un modèle servi par Azure Databricks sans gérer les identifiants ou les points de terminaison. Consultez API Databricks Foundation Model. |
| Mémoire gérée | Mémoires à long terme qu’un agent peut enregistrer et rechercher, partitionnées par acteur et stockées dans des magasins de données gérés. Utilisez la mémoire pour conserver les faits et préférences entre les sessions, et utilisez agentbricks memory pipeline pour distiller les souvenirs d’un stockage de session. Voir mémoire de l’agent et pipelines de mémoire de l’agent. |
| Sessions gérées | Les transcriptions de conversations sont conservées dans des espaces de stockage de sessions gérés et partitionnées par acteur, avec prise en charge de la duplication des sessions en copies indépendantes. Voir sessions de l’agent. |
| Tools | Fonctionnalités gérées par Azure Databricks déclarées dans agent.toml : un bac à sable Unity Catalog à périmètre restreint, un service MCP géré par Azure Databricks, ou une fonction Unity Catalog. Les outils Python personnalisés sont écrits directement dans le code du projet. Voir MCPs. |
| Tracing | Le traçage MLflow, activé par défaut, achemine les traces de chaque exécution vers une expérience MLflow propre à chaque projet pour le débogage et la surveillance. Voir aperçu du traçage. |
| Deployment | Déploie un agent dans l’environnement d’exécution des agents d’Azure Databricks, accorde au principal de service de l’agent l’accès aux magasins associés et gère le cycle de vie du déploiement. |
Créer un nouvel agent
Étape 1 : Authentifier avec OAuth et enregistrer un profil
La CLI Agent Bricks utilise l’authentification de la CLI Databricks. Authentifiez votre espace de travail avec OAuth (utilisateur-vers-machine) et enregistrez les identifiants comme un profil nommé.
Pour lancer le flux OAuth, exécutez ce qui suit, en remplaçant l’hôte par l’URL de votre espace de travail. La commande ouvre un navigateur pour finaliser la connexion, puis écrit le profil sur ~/.databrickscfg:
databricks auth login --host https://<your-workspace-url> --profile <profile>
Pour définir ce profil comme référence par défaut de la CLI afin que les commandes ultérieures puissent les --profileomettre, exécutez ce qui suit :
agentbricks login --profile <profile>
agentbricks login Valide les identifiants du profil. S’ils sont absents ou rejetés, le CLI relance databricks auth login et réessaie.
Étape 2 : Créer la structure du projet d’agent
Échafaudez un nouveau projet d’agent, puis passez --framework pour choisir le modèle. Cet exemple utilise le modèle LangGraph, qui inclut une application de chat navigateur :
agentbricks init --framework langgraph my-agent
cd my-agent
La CLI fournit un modèle groupé par framework et --framework sélectionne celui à partir de lequel s’appuyer : langgraph pour LangGraph ou openai pour le SDK OpenAI Agents. La CLI écrit les ressources gérées du projet et les liaisons d’outils dans agent.toml, et les informations de provenance du modèle dans .agentbricks/project.toml. Pour générer le backend uniquement API sans l’application de chat, ajoutez --disable-chat-app.
Étape 3 : Joindre les espaces de stockage de session et de mémoire gérés
Liez les magasins gérés pour que votre agent puisse conserver l’historique des conversations et la mémoire à long terme. Chaque commande enregistre le nom du magasin et agent.toml crée le magasin s’il n’existe pas.
Pour associer un stockage de session et un stockage en mémoire, exécutez ce qui suit :
agentbricks sessions bind my-agent-sessions
agentbricks memory bind my-agent-memory
Étape 4 : Visualiser le traçage
Le traçage est activé par défaut.
agentbricks init lie une expérience MLflow par défaut /Shared/agentbricks_traces/<project> , et agentbricks dev envoie agentbricks deploy les traces de chaque exécution vers celle-ci.
Pour afficher la liste des traces une fois que votre agent en a généré, exécutez la commande suivante :
agentbricks tracing list
Pour lier une expérience MLflow spécifique, exécutez agentbricks tracing bind --experiment-id <experiment-id>. Pour désactiver le tracé, exécutez agentbricks tracing unbind.
Étape 5 : Faites passer l’agent localement
Faites tourner l’agent sur votre machine pour le tester avant de déployer.
agentbricks dev
Cela lance un serveur local sur le port 8000 en utilisant la même commande et le même environnement que l’exécution de l’agent Azure Databricks. L’interface de ligne de commande Agent Bricks connecte l’agent au service de modèles d’Azure Databricks pour qu’il puisse appeler le modèle localement. Le modèle définit un modèle par défaut sur la valeur MODEL dans agent/agent.py. Pour utiliser un modèle différent, modifie cette valeur. Envoyez des requêtes à http://localhost:8000 pour interagir avec l’agent.
Étape 6 : Déployer l’agent
Déploie l’agent dans l’exécution de l’agent Azure Databricks. L’interface CLI approvisionne les magasins associés, accorde au principal de service de l’agent l’accès à ceux-ci et effectue le déploiement. L’agent déployé porte le nom agent-bricks-<name>.
agentbricks deploy my-agent
À la fin du déploiement, la CLI renvoie l’URL du déploiement. Ouvrez cette URL pour interagir avec votre agent en direct, qui est automatiquement connecté au service du modèle Azure Databricks. Pour gérer le déploiement par la suite, utilisez les agentbricks deployments commandes, telles que agentbricks deployments logs et agentbricks deployments stop.
Amenez un agent existant
Si vous avez déjà construit un agent avec LangGraph ou le SDK OpenAI Agents, utilisez l’indicateur --existing pour le déplacer vers la CLI Agent Bricks et DurableAgentServer. La CLI ne réécrit pas votre code. Au lieu de cela, il prépare des instructions de migration qu’un agent de codage, tel que Claude Code ou Codex, suit pour convertir le projet.
Étape 1 : Préparer la migration
Depuis le répertoire de projets de l’agent, préparez la migration. Passez le cadre utilisé par l’agent : langgraph pour LangGraph ou openai pour le SDK OpenAI Agents.
agentbricks init --framework langgraph --existing .
La CLI écrit un agent-bricks-migrate/ répertoire contenant les instructions de migration, un prompt pour votre agent de codage, et un projet de référence généré à partir des modèles de la CLI. Cela ajoute aussi des compétences dans .claude/skills/ et .agent/skills/ qui orientent les agents de codage vers les instructions. La commande ne modifie pas le code de votre application, les dépendances ou le fichier .env, et ne crée aucune ressource dans votre espace de travail.
Étape 2 : Convertir le projet avec votre agent de codage
Collez l’invite depuis agent-bricks-migrate/ dans votre agent de codage. L’agent de codage convertit le projet pour utiliser agent.toml et un point d’entrée DurableAgentServer, puis vérifie la conversion.
Étape 3 : Vérifiez la conversion
Exécutez agentbricks doctor dans le répertoire du projet :
agentbricks doctor .
agentbricks doctor inspecte les fichiers du projet sans exécuter son code ni contacter Azure Databricks. L’opération réussit lorsque le projet possède un agent.toml valide, commence DurableAgentServer avec un gestionnaire d’invocation, et appelle l’adaptateur pour son infrastructure. Un échec du rapport signifie que la conversion n’est pas terminée.
Étape 4 : Nettoyer, lancer et déployer
Supprimez agent-bricks-migrate/ ainsi que les deux skills qui y mènent, et ne les incluez pas dans vos commits. Ensuite, exécuter l’agent avec agentbricks dev et le déployer avec agentbricks deploy.
Considérations
-
--existingprend en charge LangGraph et le SDK OpenAI Agents avecDurableAgentServer. Il ne prend pas en charge--server custom. - Passer l’agent à un stockage de session géré ne déplace pas son historique de conversation existant. Les instructions de migration vous demandent de décider comment gérer les conversations précédentes.
- Les
--disable-chat-appoptions ,--memory-store, et--session-storefaçonnent le projet de référence. Ils ne créent pas de ressources.
Ajouter des outils MCP
Si vous construisez votre agent avec la CLI Agent Bricks, ajoutez un service MCP intégré system.ai à votre projet avec agentbricks tools add mcp. La commande vérifie que le service existe dans votre espace de travail et enregistre l’outil dans agent.toml. L’agent se connecte à l’outil à l’exécution, donc vous n’écrivez aucun code de connexion.
Pour lister les services MCP que vous pouvez ajouter, exécutez la commande suivante :
agentbricks tools list --kind mcp
Les exemples suivants ajoutent des services intégrés courants :
# Answer analytics questions across your workspace with Genie One.
agentbricks tools add mcp system.ai.genie_one_mcp

# Run SQL on a SQL warehouse.
agentbricks tools add mcp system.ai.dbsql

# Connect to third-party applications.
agentbricks tools add mcp system.ai.slack
agentbricks tools add mcp system.ai.github
Par défaut, un outil s’exécute avec les permissions de l’utilisateur qui a envoyé la requête à votre agent. Pour l’exécuter comme principal de service de l’application, ajoutez --auth app. Pour Google Drive, Gmail, Google Calendar et Microsoft 365, chaque utilisateur effectue une connexion OAuth unique avant le premier appel. Voir Applications connectées.
Pour examiner ou retirer des outils, exécuter agentbricks tools list ou agentbricks tools remove mcp <service>.
Pour d’autres outils, voir les pages suivantes :
- Tous les services intégrés et ce qu’ils font : MCP fournis par Databricks.
- Vos propres serveurs MCP externes : serveurs MCP externes.
- Le catalogue Unity fonctionne comme un ensemble d’outils : créer des outils agents à l’aide des fonctions de Unity Catalog.
- Un seul Genie Agent sélectionné : serveur MCP Genie Agent.
agent.toml Référence
agent.toml est la source de référence déclarative pour les ressources gérées par Azure Databricks que votre agent utilise.
agentbricks init le crée, agentbricks tools add, agentbricks memory bind, agentbricks sessions bind, et agentbricks tracing bind le met à jour, puis agentbricks deploy le lit pour provisionner des ressources et accorder l’accès. Vous pouvez aussi le modifier directement.
| Section ou champ | Description |
|---|---|
schema_version |
La version du format agent.toml. Les projets générés utilisent 1. |
[agent]
framework
|
Le modèle de cadre : langgraph ou openai. |
[agent]
server
|
Le serveur agent : agentbricks pour DurableAgentServer, ou custom pour votre propre serveur. |
[memory_store]
name
|
Le stockage de mémoire managée que l’agent utilise. |
[session_store]
name
|
Le stockage de session géré utilisé par l’agent. |
[tracing]
experiment_name
|
L’expérience MLflow pour les traces. Supprimez la section pour désactiver le tracé. |
[[tools]] |
Une liaison d’outil. Chaque outil possède une id, une valeur auth de user ou app, et un source qui identifie l’outil, ainsi qu’un policy facultatif. |
[auth.user] |
Demandez l’autorisation de l’utilisateur pour les outils que vous écrivez en code : required et additional_api_scopes. Voir la demande d’autorisation de l’utilisateur. |
L’exemple suivant est le fichier que agentbricks init génère pour un agent LangGraph nommé my-agent:
schema_version = 1

[agent]
framework = "langgraph"
server = "agentbricks"

[memory_store]
name = "my-agent-memory"

[session_store]
name = "my-agent-session"

[tracing]
experiment_name = "/Shared/agentbricks_traces/my-agent"
L’exemple suivant montre des liaisons d’outils que agentbricks tools add génère : un service MCP intégré, un agent Genie, et un bac à sable limité à une seule table :
[[tools]]
id = "web_search"
auth = "user"
source = { kind = "mcp", service = "system.ai.web_search" }

[[tools]]
id = "genie_agent"
auth = "user"
source = { kind = "genie_agent", space_id = "<space-id>" }

[[tools]]
id = "sandbox"
auth = "user"
source = { kind = "sandbox", service = "system.ai.sandbox" }
policy = { downscope = [{ resource = "table:samples.nyctaxi.trips", permission = "read_only" }] }
Les outils qui appellent une fonction du catalogue Unity utilisent source = { kind = "uc_function", function = "<catalog>.<schema>.<function>" } et supportent uniquement auth = "app".
Référence de commande
Pour consulter la référence complète et à jour des commandes, incluant toutes les commandes et tous les indicateurs, consultez le README de l’interface en ligne de commande Agent Bricks sur GitHub.
Ressources additionnelles
- Outils pour les agents et services MCP : MCP.
- Concepts de mémoire d’agent et API : Mémoire d’agent.
- Concepts et API des sessions d’Agent : sessions d’Agent.
- Distillez l’historique des sessions en mémoire à long terme : pipelines de mémoire d’agent.
- MLflow Tracking pour les agents : aperçu du traçage.