Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Vous pouvez interagir avec les fichiers de l’espace de travail stockés dans Azure Databricks par programmation. Cela permet d’effectuer des tâches telles que :
- Stockage de petits fichiers de données avec des notebooks et du code.
- Écriture de fichiers journaux dans des répertoires synchronisés avec Git.
- Importation de modules à l’aide de chemins relatifs.
- Création ou modification d’un fichier de spécification d’environnement.
- Écriture de la sortie à partir de notebooks.
- Écriture de la sortie à partir de l’exécution de bibliothèques telles que Tensorboard.
Vous pouvez créer, modifier, renommer et supprimer par programmation des fichiers d’espace de travail dans Databricks Runtime 11.3 LTS et versions ultérieures. Cette fonctionnalité est prise en charge pour les notebooks dans Databricks Runtime 16.2 et versions ultérieures, ainsi que pour l’environnement serverless version 2 et ultérieures.
Remarque
Pour désactiver l’écriture dans les fichiers d’espace de travail, définissez la variable d’environnement WSFS_ENABLE_WRITE_SUPPORT=false du cluster. Pour en savoir plus, voir Variables d’environnement.
Remarque
Dans Databricks Runtime 14.0 et versions ultérieures, le répertoire de travail actuel (CWD) par défaut pour le code exécuté localement est le répertoire contenant le notebook ou le script en cours d’exécution. Il s’agit d’un changement de comportement de Databricks Runtime 13.3 LTS et versions antérieures. Consultez Quel est le répertoire de travail actuel par défaut ?.
Sur le calcul sans serveur, le répertoire de travail n’est pas garanti, donc utilisez des chemins absolus pour référencer les fichiers. Consultez Limitations de l'informatique sans serveur.
Lire les emplacements des fichiers
Utilisez des commandes de l’interpréteur de commandes pour lire les emplacements des fichiers, par exemple dans un référentiel ou dans le système de fichiers local.
Pour déterminer l’emplacement des fichiers, entrez les informations suivantes :
%sh ls
-
Les fichiers ne sont pas dans un dépôt : La commande retourne le système
/databricks/driverde fichiers . -
Les fichiers se trouvent dans un référentiel : la commande renvoie un référentiel virtualisé tel que
/Workspace/Repos/name@domain.com/public_repo_2/repos_file_system.
Lire des fichiers d’espace de travail de données
Vous pouvez lire automatiquement de petits fichiers de données tels que les fichiers .csv ou .json à partir du code dans vos cahiers. L’exemple suivant utilise Pandas pour interroger les fichiers stockés dans un répertoire/data relatif à la racine du dépôt de projet :
import pandas as pd
df = pd.read_csv("./data/winequality-red.csv")
df
Vous pouvez utiliser Spark pour lire des fichiers de données. Vous devez fournir à Spark le chemin d’accès complet.
- Les fichiers de l’espace de travail dans les dossiers Git utilisent le chemin d’accès
file:/Workspace/Repos/<user-folder>/<repo-name>/path/to/file. - Les fichiers Espace de travail de votre répertoire personnel utilisent le chemin :
file:/Workspace/Users/<user-folder>/path/to/file.
Vous pouvez copier le chemin d’accès absolu ou relatif d’un fichier à partir du menu déroulant à côté du fichier :
menu déroulant fichier 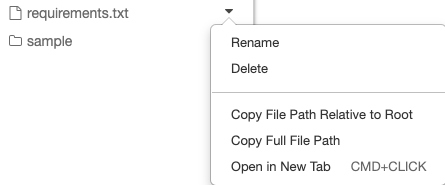
L’exemple ci-dessous montre l’utilisation de {os.getcwd()} pour obtenir le chemin complet.
import os
spark.read.format("csv").load(f"file:{os.getcwd()}/my_data.csv")
Remarque
Dans les espaces de travail où la racine et les montages DBFS sont désactivés, vous pouvez également utiliser dbfs:/Workspace pour accéder aux fichiers d’espace de travail avec les utilitaires Databricks. Cela nécessite Databricks Runtime 13.3 LTS ou versions ultérieures. Consultez Désactiver l’accès à la racine DBFS et aux points de montage dans vos espaces de travail Azure Databricks existants.
Pour en savoir plus sur les fichiers sur Azure Databricks, consultez Utiliser des fichiers sur Azure Databricks.
Créer, mettre à jour et supprimer des fichiers et des répertoires par programmation
Vous pouvez manipuler par programmation des fichiers d’espace de travail dans Azure Databricks, comme vous utilisez des fichiers dans n’importe quel système de fichiers standard.
Remarque
Dans Databricks Runtime 16.2 et versions ultérieures, ainsi que dans l’environnement sans serveur 2 et plus, les interactions programmatiques avec les fichiers sont toutes disponibles également pour les carnets de notes. Pour plus d’informations sur la conversion d’un fichier en bloc-notes, consultez Convertir un fichier en bloc-notes.
Remarque
Le répertoire parent d’un fichier doit déjà exister avant que vous n’écriviez dessus. Azure Databricks met les écritures de fichiers en mémoire tampon et les vide dans l’espace de travail de façon asynchrone ; par conséquent, l’écriture dans un chemin dont le répertoire parent est absent échoue avec AsyncFlushFailedException après l’appel d’écriture plutôt qu’au moment où vous effectuez cet appel. Créez d’abord le répertoire parent, comme montré dans l’exemple suivant.
Les exemples suivants utilisent des packages et des fonctionnalités Python standard pour créer et manipuler des fichiers et des répertoires.
import os

# Create a new directory

os.mkdir('dir1')

# Create a new file and write to it

with open('dir1/new_file.txt', "w") as f:
    f.write("new content")

# Append to a file

with open('dir1/new_file.txt', "a") as f:
    f.write(" continued")

# Delete a file

os.remove('dir1/new_file.txt')

# Delete a directory

os.rmdir('dir1')
import shutil

# Copy a dashboard

shutil.copy("my-dashboard.lvdash.json", "my-dashboard-copy.lvdash.json")

# Move a query to a shared folder

shutil.move("test-query.dbquery","shared-queries/")
Résoudre les noms d’assets en double
Dans certains cas, un dossier d’espace de travail peut déjà contenir des assets portant le même nom. Par exemple, deux requêtes SQL peuvent toutes deux porter le nom My query. Cela peut se produire lorsque les assets ont été créés avant que l’unicité du nom ne soit pleinement appliquée.
Lorsqu’un dossier contient des noms d’assets en double, l’accès par fichier au dossier échoue, bien que les assets eux-mêmes restent intacts. Vous verrez peut-être des erreurs telles que :
-
Name not unique on network(OSError: [Errno 76])—par exemple, lorsque vous exécutezlsou utilisez d’autres commandes dans le terminal web, ou lorsque vous listez le dossier depuis un carnet. -
File name conflictouRESOURCE_CONFLICT: Duplicate entities detected in the directory—par exemple, lors des opérations de dossier Git.
Remarque
Les noms en double n’affectent pas les assets eux-mêmes. Vous pouvez toujours ouvrir et utiliser chaque asset depuis le navigateur de l’espace de travail. Seules les commandes qui atteignent le dossier via le système de fichiers — comme le terminal web, WSFS ou les opérations de dossier Git — sont affectées.
Pour trouver des assets avec des noms en double, exécutez le carnet suivant. Il scanne un dossier et ses sous-dossiers et liste les assets portant le même nom. Le carnet de notes est en lecture seule et ne renomme ni ne supprime aucune ressource.
Trouver des ressources de l’espace de travail en double
Obtenir un ordinateur portable
Pour résoudre les noms en double à l’aide de l’interface de l’espace de travail :
- Dans le navigateur d’espace de travail, ouvrez chaque dossier identifié par le bloc-notes.
- Renommer ou supprimer les éléments en double jusqu’à ce que chaque élément du dossier ait un nom unique.
Une fois que tous les noms d’assets dans le dossier sont uniques, l’accès basé sur les fichiers fonctionne à nouveau.