Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Databricks AI Search (anciennement Databricks Vector Search) est une solution de recherche intégrée à la plateforme Databricks Data + AI et intégrée à ses outils de gouvernance et de productivité. Il alimente les fonctionnalités de recherche pour les applications d’IA telles que les systèmes RAG, les systèmes de recommandation et la reconnaissance d’images et de vidéos, en trouvant les représentations vectorielles les plus proches d’une requête.
La recherche vectorielle est un type de recherche optimisé pour la récupération d’incorporations. Les incorporations sont des représentations mathématiques du contenu sémantique des données, généralement du texte ou des données d’image. Les incorporations sont générées par un modèle de langage volumineux et constituent un composant clé de nombreuses applications IA qui dépendent de la recherche de documents ou d’images similaires les uns aux autres.
Avec Databricks AI Search, vous créez un index AI Search à partir d’une table source, qui peut être une table Delta Lake, une table de streaming ou une table gérée utilisant Iceberg v3 ou supérieur. L’index inclut des données incorporées avec des métadonnées. Vous pouvez ensuite interroger l’index à l’aide d’une API REST pour identifier les vecteurs les plus similaires et retourner les documents associés. Vous pouvez structurer l’index pour qu’il se synchronise automatiquement lorsque la table source sous-jacente est mise à jour.
La recherche IA prend en charge les éléments suivants :
- Recherche de similarité de mot clé hybride.
- Recherche de mots clés en texte intégral (bêta) sur n’importe quel point de terminaison ou index de recherche en texte intégral dédié (bêta) sur les points de terminaison optimisés pour le stockage.
- Filtrage.
- Reclassement.
- Listes de contrôle d’accès (ACL) pour gérer les points de terminaison de recherche IA.
- Synchronisez uniquement les colonnes sélectionnées.
- Enregistrez et synchronisez les incorporations générées.
Comment fonctionne la recherche IA ?
AI Search utilise l’algorithme HNSW (Hierarchical Navigable Small World) pour ses recherches du plus proche voisin approximatif (ANN) et la métrique de distance L2 pour mesurer la similarité des vecteurs d’incorporation. Si vous souhaitez utiliser la similarité cosinus, vous devez normaliser vos incorporations de points de données avant de les alimenter dans l’algorithme de recherche vectorielle. Lorsque les points de données sont normalisés, le classement produit par la distance L2 est identique au classement produit par la similarité cosinus.
Ai Search prend également en charge la recherche hybride de similarité des mots clés, qui combine la recherche incorporée basée sur des vecteurs avec des techniques de recherche basées sur des mots clés traditionnelles. Cette approche trouve des correspondances de mots exacts dans la requête tout en utilisant également une recherche par similarité basée sur des vecteurs pour capturer les relations sémantiques et le contexte de la requête.
En intégrant ces deux techniques, la recherche par similarité de mot clé hybride récupère non seulement les documents qui contiennent les mots clés exacts, mais aussi ceux qui sont conceptuellement similaires, fournissant des résultats de recherche plus complets et pertinents. Cette méthode est particulièrement utile dans les applications RAG où les données sources contiennent des mots clés uniques tels que des références SKU ou des identificateurs qui ne sont pas bien adaptés à une recherche par similarité pure.
Pour plus d’informations sur l’API, consultez la référence Python SDK et interroger un index de recherche IA.
Calcul de recherche de similarité
Le calcul de recherche de similarité utilise la formule suivante :
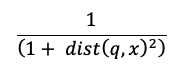
où dist est la distance euclidienne entre la requête q et l’entrée d’index x:
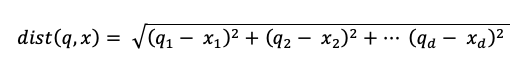
Algorithme de recherche par mot clé
Les scores de pertinence sont calculés en utilisant Okapi BM25. Toutes les colonnes de texte ou de chaîne sont recherchées, y compris le texte source incorporé et les colonnes de métadonnées au format texte ou chaîne. La fonction de tokenisation se fractionne aux limites du mot, supprime la ponctuation et convertit tout le texte en minuscules.
Combinaison de la recherche par similarité et de la recherche par mots clé
Les résultats de la recherche par similarité et de la recherche par mots clés sont combinés en utilisant la fonction de fusion de classement réciproque (RRF, Mutual Rank Fusion).
RRF rescoree d’abord chaque document de chaque méthode à l’aide des scores :
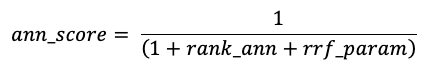
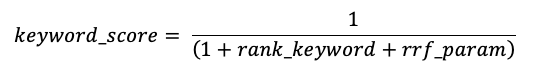
rrf_param contrôle l’importance relative des documents mieux classés et moins bien classés. D’après la littérature, rrf_param est réglé à 60.
Les scores sont normalisés afin que le score le plus élevé soit 1 à l’aide du facteur de normalisation suivant :
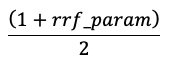
Le score final pour chaque document est calculé comme suit :
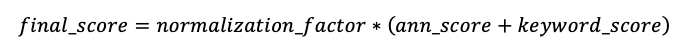
Les documents avec les scores finaux les plus élevés sont retournés.
Options de fourniture des incorporations vectorielles
Pour créer un index de recherche IA dans Databricks, vous devez d’abord décider comment fournir des incorporations vectorielles. Databricks prend en charge trois options.
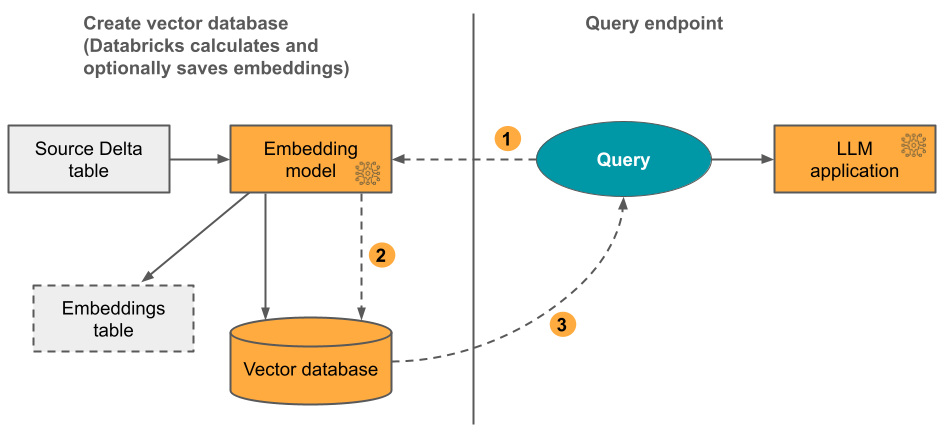
Option 1 : Index delta sync avec incorporations calculées par Databricks
Avec cette option, utilisez une source contenant des données au format textuel. Les types de sources pris en charge incluent les tables Delta Lake, les tables de streaming ou les tables gérées utilisant Iceberg v3 ou version. Databricks calcule les incorporations à l’aide d’un modèle que vous spécifiez et enregistre éventuellement les incorporations dans une table du catalogue Unity. À mesure que la source est mise à jour, l’index reste synchronisé avec celle-ci.
Le diagramme suivant illustre ce processus :
- Calculer les incorporations de requêtes. La requête peut inclure des filtres de métadonnées.
- Effectuer une recherche de similarités pour identifier les documents les plus pertinents.
- Retourner les documents les plus pertinents et les ajouter à la requête.
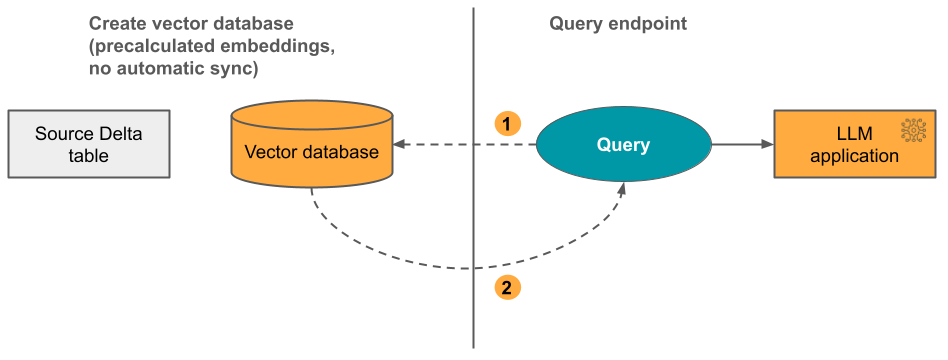
Option 2 : Delta Sync Index avec des incorporations autogéées
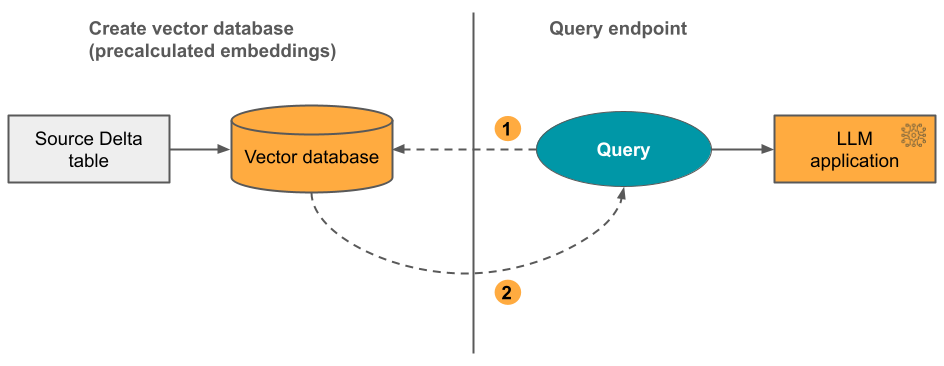
Avec cette option, utilisez une source contenant des embeddings pré-calculés. Les types de sources pris en charge incluent les tables Delta Lake, les tables de streaming ou les tables gérées utilisant Iceberg v3 ou version. À mesure que la source est mise à jour, l’index reste synchronisé avec celle-ci.
Remarque
Il n’est pas possible de convertir un index incorporé auto-managé en index managé Databricks. Si vous décidez ultérieurement d’utiliser des incorporations managées, vous devez créer un index et recompiler des incorporations.
Le diagramme suivant illustre ce processus :
- La requête se compose d’incorporations et peut inclure des filtres de métadonnées.
- Effectuer une recherche de similarités pour identifier les documents les plus pertinents. Retourner les documents les plus pertinents et les ajouter à la requête.
Option 3 : Index d’accès vectoriel direct
Avec cette option, vous devez mettre à jour manuellement l’index à l’aide de l’API REST lorsque la table incorporée change.
Le diagramme suivant illustre ce processus :
Option 4 : Index de recherche en texte intégral sur les points de terminaison optimisés pour le stockage (bêta)
Avec cette option, vous créez un index Delta Sync sur un point de terminaison optimisé pour le stockage sans colonnes incorporées. L’index prend en charge la recherche en texte intégral basée sur des mots clés à l’aide du scoring BM25, sans nécessiter d’incorporations vectorielles. Cela est utile pour rechercher des termes, des identificateurs ou des mots clés exacts dans les données de texte.
Remarque
Vous pouvez également utiliser query_type="FULL_TEXT" pour effectuer des recherches par mot clé sur des index de recherche IA existants sur des points de terminaison standard et optimisés pour le stockage. Cette option consiste à créer un index dédié qui ne contient aucun embedding.
Les index de recherche en texte intégral dédiés sont disponibles uniquement sur les points de terminaison optimisés pour le stockage et nécessitent un mode de synchronisation déclenché. Pour obtenir des instructions, consultez Créer un index de recherche en texte intégral (bêta).
Options de point de terminaison
La recherche IA fournit les options suivantes pour vous permettre de sélectionner la configuration du point de terminaison qui répond aux besoins de votre application.
Remarque
QPS élevé est disponible uniquement pour les points de terminaison standard.
-
Les points de terminaison standard ont une capacité de 320 millions de vecteurs à la dimension 768.
- Avec des points de terminaison standard, vous pouvez utiliser des QPS élevés pour prendre en charge un débit soutenu élevé. Consultez Augmenter le débit du point de terminaison AI Search pour des QPS élevés.
- Les points de terminaison optimisés pour le stockage disposent d’une plus grande capacité (plus d’un milliard de vecteurs à la dimension 768) et fournissent une indexation 10-20 fois plus rapide. Les requêtes sur les points de terminaison optimisés pour le stockage ont une latence légèrement accrue d’environ 250 msec. La tarification de cette option est optimisée pour le plus grand nombre de vecteurs. Pour plus de détails sur les tarifs, consultez la page de tarification AI Search. Pour plus d’informations sur la gestion des coûts de recherche d’IA, consultez le guide de gestion des coûts de recherche d’IA.
Vous spécifiez le type de point de terminaison lorsque vous créez le point de terminaison.
Consultez également les limitations des points de terminaison optimisés pour le stockage.
Guide pratique pour configurer la recherche IA
Pour utiliser la recherche IA, vous devez créer les éléments suivants :
Point de terminaison de recherche IA. Ce point de terminaison fournit l’index de recherche par IA. Vous pouvez interroger et mettre à jour le point de terminaison à l’aide de l’API REST ou du kit de développement logiciel (SDK). Pour obtenir des instructions, consultez Créer un point de terminaison de recherche IA .
Les points d'accès s'adaptent automatiquement pour prendre en charge la taille de l’index ou le nombre de requêtes simultanées. Les points de terminaison diminuent automatiquement lorsqu’un index est supprimé.
Index de recherche IA. Avec un indice de recherche IA, vous pouvez utiliser des recherches en temps réel de voisins approximatifs (ANN) sur une table ou une vue source. Les types de sources pris en charge incluent les tables Delta Lake, les tables de streaming ou les tables gérées utilisant Iceberg v3 ou version. L’objectif de la recherche est d’identifier les documents similaires à la requête. Les index de recherche d’IA figurent dans Unity Catalog et sont gouvernés par celui-ci. Pour obtenir des instructions, consultez Créer un index de recherche IA .
De plus, si vous choisissez Databricks pour calculer les incorporations, vous pouvez utiliser un point de terminaison d’API Foundation Model préconfiguré ou créer un point de terminaison de service de modèles pour servir le modèle d’incorporation de votre choix. Pour obtenir des instructions, consultez API Foundation Model de paiement par jeton ou Créer des points de terminaison de service de modèles de base.
Pour interroger le point de terminaison de service du modèle, vous devez utiliser l’API REST ou le kit de développement logiciel (SDK) Python. Votre requête peut définir des filtres basés sur n’importe quelle colonne de la table source. Pour plus d’informations, consultez Utiliser des filtres sur les requêtes, la référence de l’API ou la référence du kit de développement logiciel (SDK) Python.
Requirements
- Espace de travail avec Unity Catalog activé
- Le calcul serverless est activé. Pour obtenir des instructions, consultez Se connecter à l'informatique sans serveur.
- Pour les extrémités standards, la table source doit utiliser un flux de données de changement. Consultez Utiliser le flux de données modifiées sur Azure Databricks. Les tables avec suivi de lignes activé utilisent automatiquement un flux de données de changement, sans nécessiter de configuration manuelle. Cela s’applique aux tables Delta Lake et aux tables gérées utilisant Iceberg v3 ou plus.
- Pour créer un index de recherche IA, vous devez disposer CREATE TABLE de privilèges sur le schéma de catalogue où l’index sera créé.
L’autorisation de créer et de gérer des points de terminaison de recherche IA est configurée à l’aide de listes de contrôle d’accès. Consultez les ACL du point de terminaison AI Search.
la protection et l’authentification des données
Databricks implémente les contrôles de sécurité suivants pour protéger vos données :
- Chaque demande de chaque client adressée à AI Search est isolée logiquement, authentifiée et autorisée.
- La recherche IA chiffre toutes les données au repos (AES-256) et en transit (TLS 1.2+).
AI Search prend en charge deux modes d’authentification : les principaux de service et les jetons d’accès personnels (PAT). Pour les applications de production, Databricks recommande d’utiliser des principaux de service, qui peuvent avoir des performances par requête jusqu’à 100 msec plus rapides par rapport aux jetons d’accès personnels.
Jeton du principal de service. Un administrateur peut générer un jeton de principal de service et le transmettre au Kit de développement logiciel (SDK) ou à l’API. Consultez Utiliser des principaux de service. Pour les cas d’utilisation en production, Databricks recommande d’utiliser un jeton de principal de service.
# Pass in a service principal
vsc = AISearchClient(workspace_url="...",
        service_principal_client_id="...",
        service_principal_client_secret="..."
        )
Jeton d’accès personnel. Vous pouvez utiliser un jeton d’accès personnel pour vous authentifier auprès d’AI Search. Consultez jeton d’authentification d’accès personnel. Si vous utilisez le Kit de développement logiciel (SDK) dans un environnement de notebook, le SDK génère automatiquement un jeton PAT pour l’authentification.
# Pass in the PAT token
client = AISearchClient(workspace_url="...", personal_access_token="...")
Les clés gérées par le client (CMK) sont prises en charge sur les points de terminaison créés à partir du 8 mai 2024.
Surveiller l’utilisation et les coûts
Pour plus d’informations sur la surveillance de l’utilisation et des coûts associés aux index et points de terminaison de recherche IA, consultez le guide de gestion des coûts de recherche IA.
Vous pouvez également interroger l’utilisation par stratégie d’utilisation. Consultez les stratégies d’utilisation de la recherche IA.
Limites de taille des ressources et des données
Le tableau suivant récapitule les limites de taille des ressources et des données pour les points de terminaison et les index de recherche IA :
| Ressource | Granularité | Limite |
|---|---|---|
| Points de terminaisons AI Search | Par espace de travail | 500 |
| Intégrations (index de synchronisation Delta) | Par point de terminaison standard | ~ 320 000 000 à 768 dimensions d’intégration ~ 160 000 000 à 1536 dimensions d’intégration ~ 80 000 000 à 3072 dimensions d’intégration (mise à l’échelle approximativement linéairement) |
| Incorporations (index d’accès vectoriel direct) | Par point de terminaison standard | ~ 2 000 000 à 768 dimensions d’intégration |
| Embeddings (point de terminaison optimisé pour le stockage) | Par point de terminaison optimisé pour le stockage | ~ 1 000 000 000 à 768 dimensions d’intégration |
| Dimension d’incorporation | Par index | 4096 |
| Indexes | Par point de terminaison | 50 |
| Columns | Par index | 50 |
| Columns | Types pris en charge : octets, court, entier, long, float, double, booléen, chaîne, timestamp, date, tableau, struct, map | |
| Champs de métadonnées | Par index | 50 |
| Nom de l’index | Par index | 128 caractères |
Les limites suivantes s’appliquent à la création et à la mise à jour des index de recherche IA :
| Ressource | Granularité | Limite |
|---|---|---|
| Taille de ligne pour l’index Delta Sync | Par index | 100 Ko |
| Intégration de la taille de la colonne source dans l’index Delta Sync | Par index | 32764 octets |
| Limite de taille de requête upsert en bloc pour l’index Direct Vector | Par index | 10 Mo |
| Limite de taille des requêtes de suppression en bloc pour l’index Direct Vector | Par index | 10 Mo |
Les limites suivantes s’appliquent à l’API de requête.
| Ressource | Granularité | Limite |
|---|---|---|
| Longueur du texte de requête | Par requête | 32764 caractères |
| Jetons dans le cadre de l’utilisation de la recherche hybride | Par requête | 1024 mots ou 2 octets |
| Conditions de filtre | Par clause de filtre | 1024 éléments |
| Nombre maximal de résultats retournés (recherche approximative du voisin le plus proche) | Par requête | 10 000 |
| Nombre maximal de résultats retournés (recherche de similarité de mot clé hybride) | Par requête | 200 |
| Nombre maximal de résultats retournés (recherche en texte intégral) | Par requête | 10 000 |
| Taille de la réponse | Par requête | 10 Mo |
Limitations
- Les colonnes de type struct et map présentent les limitations suivantes :
- Les champs d’une struct doivent correspondre à des valeurs primitives.
- Les tableaux et cartes ne peuvent pas être imbriqués à l’intérieur des structs.
ARRAY<STRUCT>n’est pas pris en charge. - Les maps doivent être des colonnes de premier niveau avec des clés de type chaîne de caractères et des valeurs primitives.
- Le nom de colonne
_idest réservé. Si votre table source a une colonne nommée_id, renommez-la avant de créer un index RECHERCHE IA. - Les autorisations au niveau de la ligne et de la colonne ne sont pas prises en charge. Vous pouvez toutefois implémenter vos propres listes de contrôle (ACL) au niveau de l’application à l’aide de l’API de filtre.
- Vous ne pouvez pas cloner un index dans un autre espace de travail. Vous pouvez effectuer des requêtes inter-espaces de travail à l’aide du Kit de développement logiciel (SDK) Databricks ou de l’API REST.
- La capacité d’index est provisionnée en fonction de la taille de la table source au moment de la création de l’index. Commencer avec une table source de petite taille limite la croissance de l’index et peut entraîner des erreurs dues à l’épuisement de capacité. Par conséquent, dimensionnez la table source pour qu’elle corresponde à votre volume de données attendu avant de créer l’index.
Limitations des points de terminaison optimisés pour le stockage
Les limitations de cette section s’appliquent uniquement aux points de terminaison optimisés pour le stockage.
- Le mode de synchronisation continue n’est pas pris en charge.
- La synchronisation des colonnes n'est pas prise en charge.
- La dimension d’incorporation doit être divisible par 16.
- La mise à jour incrémentielle est partiellement prise en charge. Chaque synchronisation doit reconstruire certaines parties de l’index de recherche IA.
- Pour les index managés, les incorporations précédemment calculées sont réutilisées si la ligne source n’a pas changé.
- Vous devriez anticiper une réduction significative du temps nécessaire pour une synchronisation, de bout en bout, par rapport aux points de terminaison habituels. Les jeux de données avec 1 milliard d’incorporations doivent effectuer une synchronisation en moins de 8 heures. Les jeux de données plus petits prennent moins de temps pour la synchronisation.
- Les espaces de travail conformes à FedRAMP ne sont pas pris en charge.
- Pour utiliser un modèle d’incorporation personnalisé pour un index Delta Sync managé, la requête AI pour les modèles personnalisés et la préversion des modèles externes doivent être activées. Consultez Gérer les préversions d’Azure Databricks pour découvrir comment activer les préversions.
- Les points de terminaison optimisés pour le stockage prennent en charge jusqu’à 1 milliard d’incorporations de vecteurs de 768 dimensions. Si vous avez un cas d’utilisation à grande échelle, contactez votre équipe de compte.