Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
L’API Prompt est une API web expérimentale qui vous permet d’inviter un petit modèle de langage (SLM) intégré à Microsoft Edge à partir du code JavaScript de votre site web ou de votre extension de navigateur. Utilisez l’API d’invite pour générer et analyser du texte ou créer une logique d’application basée sur l’entrée de l’utilisateur, et découvrez des moyens innovants d’intégrer les fonctionnalités SLM dans votre application web.
Contenu détaillé :
- Disponibilité de l’API Prompt
- Alternatives et avantages de l’API Prompt
- Modèle d’instruction d’Aion
- Activer l’API d’invite
- Voir un exemple fonctionnel
- Utiliser l’API d’invite
- Envoyer des commentaires
- Voir aussi
Disponibilité de l’API Prompt
L’API d’invite est disponible en tant qu’aperçu pour les développeurs dans Microsoft Edge. Vous pouvez tester l’API d’invite de l’une des manières suivantes :
- Localement dans Microsoft Edge, sur votre appareil uniquement.
- Sur votre site de production, en vous inscrivant à un essai d’origine.
Consultez Activer l’API d’invite, ci-dessous.
L’API d’invite est destinée à vous aider à découvrir les cas d’usage et à comprendre les défis liés aux SLM intégrés. L’API d’invite fournit des fonctionnalités d’invite à usage général, tandis que les API expérimentales associées sont conçues pour des tâches spécifiques basées sur l’IA, telles que le résumé, l’aide à la rédaction, la prise de décision et la traduction. Pour en savoir plus sur ces API, consultez :
- Résumer, écrire et réécrire du texte avec les API d’assistance à l’écriture
- Classifier du texte avec l’API Décisions
- Corriger les fautes de grammaire, d’orthographe et de ponctuation dans le texte avec l’API Correcteur
- Détecter des langues avec l’API Détecteur de langue
- Traduire du texte avec l’API Translator
Alternatives et avantages de l’API Prompt
Pour tirer parti des fonctionnalités d’IA dans les sites web et les extensions de navigateur, vous pouvez également utiliser les méthodes suivantes :
Envoyez des requêtes réseau aux services d’IA basés sur le cloud, tels que les solutions d’IA Azure.
Exécutez des modèles IA locaux à l’aide de l’API Web Neural Network (WebNN) ou du runtime ONNX pour le Web.
L’API d’invite utilise un SLM qui s’exécute sur le même appareil où les entrées et les sorties du modèle sont utilisées (c’est-à-dire localement). Cela présente les avantages suivants par rapport aux solutions basées sur le cloud :
Coût réduit : L’utilisation d’un service d’IA cloud n’implique aucun coût.
Indépendance du réseau : Au-delà du téléchargement initial du modèle, il n’y a pas de latence réseau lors de l’invite du modèle, et peut également être utilisé lorsque l’appareil est hors ligne.
Confidentialité améliorée : Les données entrées dans le modèle ne quittent jamais l’appareil et ne sont pas collectées pour entraîner les modèles d’IA.
L’API d’invite utilise un modèle de langage fourni par Microsoft Edge et intégré au navigateur, ce qui présente des avantages supplémentaires par rapport aux solutions locales personnalisées telles que celles basées sur WebGPU, WebNN ou WebAssembly :
Coût unique partagé : Le modèle fourni par le navigateur est téléchargé la toute première fois que l’API est appelée et partagé sur tous les sites web qui s’exécutent dans le navigateur, ce qui réduit les coûts de réseau pour les développeurs et les utilisateurs.
Utilisation simplifiée pour les développeurs web : Le modèle intégré peut être exécuté à l’aide d’API web simples et ne nécessite pas d’expertise en IA/ML ni d’infrastructures tierces.
Modèle d’instruction d’Aion
Dans Microsoft Edge, l’API Invite utilise le modèle Aion Instruct, qui est intégré au navigateur. Aion Instruct est un petit modèle de langage à paramètres 2,3B qui excelle dans les tâches textuelles. Pour en savoir plus sur le modèle, voir la carte du modèle microsoft/Aion-1.0-Instruct-2.3B, à Hugging Face.
Clause d’exclusion de responsabilité
Comme d’autres modèles de langage de cette taille, Aion Instruct peut potentiellement se comporter de manière peu fiable, inexacte, injuste ou offensante. Vous devez prendre en compte les risques liés à la transmission de contenu non fiable au modèle et valider la source et l’intégrité du contenu avant d’utiliser le contenu comme entrée de modèle. Pour plus d’informations, consultez Biais, risques et limitations, dans microsoft/Aion-1.0-Instruct-2.3B, à Hugging Face.
Configuration matérielle requise
La préversion du développeur d’API d’invite est destinée à fonctionner sur des appareils dotés de fonctionnalités matérielles qui produisent des sorties SLM avec une qualité et une latence prévisibles. L’API d’invite est actuellement limitée aux éléments suivants :
Systèmes d’exploitation :
- Windows 10 ou 11.
- macOS 13.3 ou version ultérieure.
- 64 bits (x64) Linux avec pilotes GPU Vulkan et Microsoft Edge 159 ou version ultérieure.
Stockage : Au moins 20 Go disponibles sur le volume qui contient votre profil Edge. Si le stockage disponible tombe en dessous de 5 Go, le modèle est supprimé pour garantir que les autres fonctionnalités du navigateur disposent de suffisamment d’espace pour fonctionner.
GPU : 3 Go de VRAM ou plus.
Réseau : Forfait de données illimité ou connexion illimitée. Le modèle n’est pas téléchargé si vous utilisez une connexion limitée.
Pour case activée si votre appareil prend en charge l’aperçu du développeur de l’API Prompt, consultez Activer l’API Prompt ci-dessous et case activée la classe de performances de votre appareil.
En raison de la nature expérimentale de l’API d’invite, vous pouvez observer des problèmes sur des configurations matérielles spécifiques. Si vous rencontrez des problèmes sur des configurations matérielles spécifiques, faites-nous part de vos commentaires en ouvrant un nouveau problème dans le référentiel MSEdgeExplainers.
Disponibilité du modèle Aion Instruct
Un téléchargement initial du modèle Aion Instruct est requis la première fois qu’un site Web appelle une API qui nécessite un modèle sur l’appareil. Pour surveiller le téléchargement du modèle, utilisez l’option lors de la monitor création d’une nouvelle session Prompt API. Pour en savoir plus, consultez Suivre la progression du téléchargement du modèle, ci-dessous.
Le modèle n’est pas disponible dans les conditions suivantes :
- Si l’option IA sur l’appareil est désactivée sous Paramètres>, Copilot et IA.
- Si les stratégies d’entreprise GenAILocalFoundationalModelSettings ou ComponentUpdatesEnabled sont configurées pour bloquer le téléchargement du modèle.
- Si l’appareil ne répond pas aux exigences matérielles, d’espace disque ou de réseau.
Considérations pour Edge Canary, Dev et Beta
Dans Microsoft Edge Canary, Dev et Beta, l’option IA sur l’appareil est désactivée par défaut sous Paramètres>Copilot et IA, afin d’éviter de télécharger le modèle séparément pour chaque canal.
Si vous activez l’indicateur d’API d’invite dans edge://flags, l’option IA sur l’appareil est automatiquement activée dans Canary, Dev et Beta. Consultez Tester l’API d’invite localement, ci-dessous.
Si vous effectuez des tests à l’aide d’un jeton d’essai d’origine dans Canary, Dev ou Beta, sans l’indicateur activé, activez manuellement l’option IA sur l’appareil sous Paramètres>Copilot et IA pour télécharger le modèle. Consultez Activer l’API d’invite pour vos utilisateurs en s’inscrivant à un essai d’origine, ci-dessous.
Activer l’API d’invite
Pour utiliser l’API Prompt dans Microsoft Edge, vous pouvez la tester localement ou vous inscrire à un essai d’origine pour l’activer sur votre site web de production. Les sections ci-dessous fournissent des instructions pour les deux approches.
Tester l’API Prompt localement
Pour tester l’API d’invite sur votre appareil uniquement :
Vérifiez que vous utilisez Microsoft Edge version 158 ou ultérieure.
Dans Microsoft Edge, ouvrez un nouvel onglet ou une nouvelle fenêtre, puis accédez à
edge://flags.Dans la zone de recherche, en haut de la page, entrez API d’invite.
La page est filtrée pour afficher l’indicateur correspondant.
Sous API d’invite, sélectionnez Activé :

Si vous le souhaitez, pour enregistrer localement les informations qui peuvent être utiles pour les problèmes de débogage, activez également l’indicateur Activer sur l’appareil les journaux de débogage du modèle IA .
Redémarrez Edge.
Pour case activée si votre appareil répond à la configuration matérielle requise pour l’aperçu développeur de l’API d’invite, ouvrez un nouvel onglet, accédez à
edge://on-device-internals, puis case activée la valeur de classe de performances de l’appareil.Si la classe de performances de votre appareil est Moyenne ou supérieure, l’API d’invite devrait être prise en charge sur votre appareil.
Si vous remarquez des problèmes avec ces modèles, créez un problème dans le dépôt MSEdgeExplainers.
Activez l’API d’invite pour vos utilisateurs en vous inscrivant à un essai d’origine
Vous pouvez essayer l’API Prompt sur votre propre site en direct pendant une période limitée à l’aide d’une version d’évaluation d’origine. Lors de l’utilisation de la version d’évaluation d’origine de l’API Prompt, les utilisateurs de Microsoft Edge qui visitent votre site peuvent exécuter du code qui utilise l’API Prompt.
Pour en savoir plus sur les versions d’évaluation d’origine dans Microsoft Edge, consultez Tester les API et fonctionnalités expérimentales à l’aide des versions d’évaluation d’origine.
Pour vous inscrire à la version d’évaluation d’origine de l’API Prompt, suivez les étapes de la page Inscription à une version d’évaluation d’origine et sélectionnez la version d’évaluation d’origine de l’API Demander.
Voir un exemple fonctionnel
Pour voir l’API d’invite en action et examiner le code existant qui utilise l’API :
Activez l’API d’invite, comme décrit ci-dessus.
Dans Edge, ouvrez un onglet ou une fenêtre et accédez au terrain de jeu API Prompt.
Dans la navigation des playgrounds IA intégrés à gauche, Demander est sélectionné.
Dans la bannière d’informations en haut, cochez la case status : elle indique initialement Téléchargement du modèle, veuillez patienter :

Une fois le modèle téléchargé, la bannière d’informations indique API et le modèle prêts, indiquant que l’API et le modèle peuvent être utilisés :

Si le téléchargement du modèle ne démarre pas, redémarrez Microsoft Edge et réessayez.
L’API d’invite est uniquement prise en charge sur les appareils qui répondent à certaines configurations matérielles requises. Pour plus d’informations, consultez la section Configuration matérielle requise ci-dessus.
Vous pouvez également modifier les valeurs des paramètres d’invite, par exemple :
- Prompt de l’utilisateur
- Invite système
- Schéma de contrainte de réponse
- > Paramètres supplémentairesInstructions d’invite N-shot
Cliquez sur le bouton Inviter , en bas de la page.
La réponse est générée dans la section de réponse de la page :
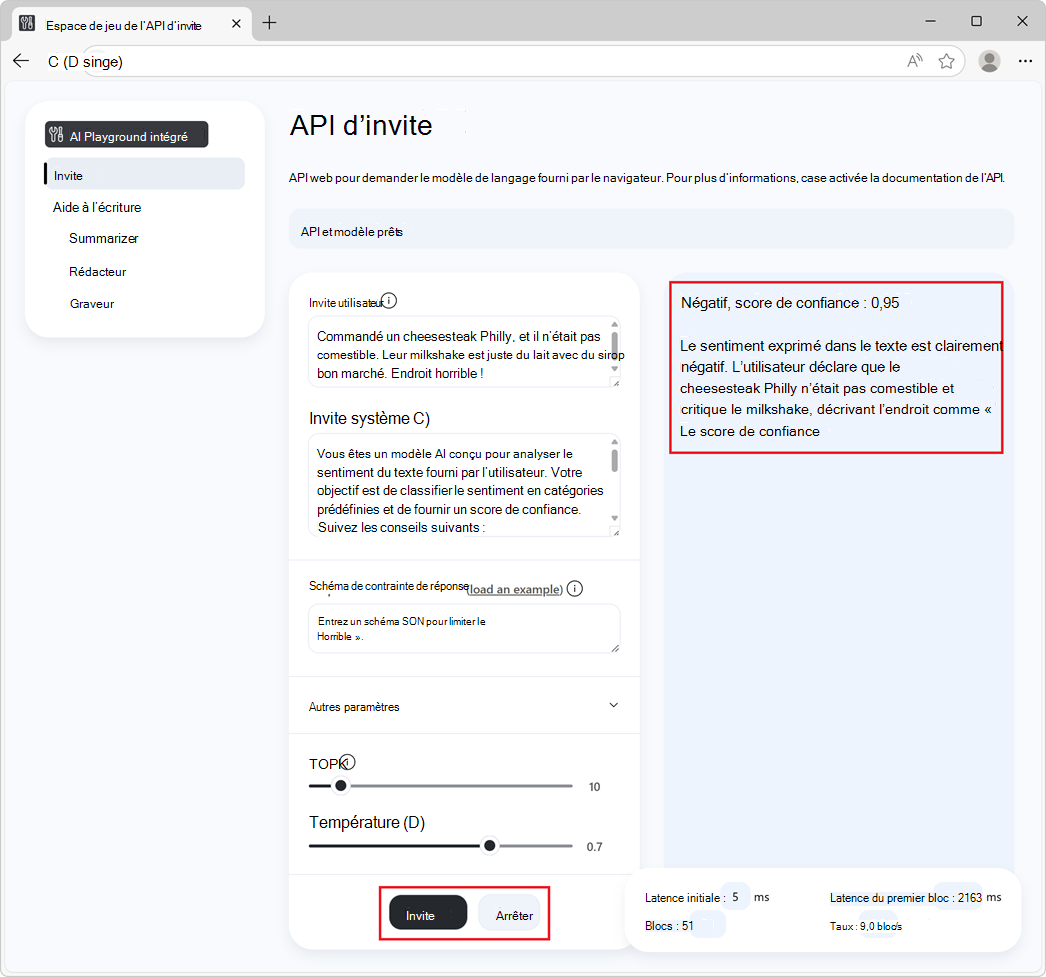
Pour arrêter de générer la réponse, à tout moment, cliquez sur le bouton Arrêter .
Voir aussi :
- /built-in-ai/ : code source et fichier Lisez-moi pour les terrains de jeu IA intégrés, y compris le terrain de jeu API Prompt.
Utiliser l’API d’invite
Vérifier si l’API est activée
Avant d’utiliser l’API dans le code de votre site web ou de votre extension, case activée que l’API est activée en testant la présence de l’objet LanguageModel :
if (!LanguageModel) {
  // The Prompt API is not available.
} else {
  // The Prompt API is available.
}
Vérifier si le modèle peut être utilisé
L’API d’invite ne peut être utilisée que si l’appareil prend en charge l’exécution du modèle, et une fois que le modèle de langage et l’environnement d’exécution du modèle ont été téléchargés par Microsoft Edge.
Pour case activée si l’API peut être utilisée, utilisez la méthode :LanguageModel.availability()
const availability = await LanguageModel.availability();

if (availability == "unavailable") {
  // The model is not available.
}

if (availability == "downloadable" || availability == "downloading") {
  // The model can be used, but it needs to be downloaded first.
}

if (availability == "available") {
  // The model is available and can be used.
}
Créer une session
La création d’une session indique au navigateur de charger le modèle de langage en mémoire afin qu’il puisse être utilisé. Avant de pouvoir demander le modèle de langage, créez une session à l’aide de la méthode :create()
// Create a LanguageModel session.
const session = await LanguageModel.create();
Pour personnaliser la session de modèle, vous pouvez transmettre des options à la create() méthode :
// Create a LanguageModel session with options.
const session = await LanguageModel.create(options);
Les options disponibles sont les suivantes :
monitor, pour suivre la progression du téléchargement du modèle.initialPrompts, pour donner au modèle un contexte sur les invites qui seront envoyées au modèle et pour établir un modèle d’interactions utilisateur/assistant que le modèle doit suivre pour les invites futures.
Ces options sont documentées ci-dessous.
Surveiller la progression du téléchargement du modèle
Pour suivre la progression du téléchargement du modèle, utilisez l’option monitor . Ceci est utile lorsque le modèle n’a pas encore été entièrement téléchargé sur l’appareil sur lequel le modèle sera utilisé, pour informer les utilisateurs de votre site web qu’ils doivent attendre.
// Create a LanguageModel session with the monitor option to monitor the model
// download.
const session = await LanguageModel.create({
  monitor: m => {
    // Use the monitor object argument to add an listener for the
    // downloadprogress event.
    m.addEventListener("downloadprogress", event => {
      // The event is an object with the loaded and total properties.
      if (event.loaded == event.total) {
        // The model is fully downloaded.
      } else {
        // The model is still downloading.
        const percentageComplete = (event.loaded / event.total) * 100;
      }
    });
  }
});
Fournir au modèle une invite système
Pour définir une invite système, qui est un moyen de donner au modèle des instructions à utiliser lors de la génération de texte en réponse à une invite, utilisez l’option initialPrompts .
L’invite système que vous fournissez lors de la création d’une session est conservée pendant toute l’existence de la session, même si la fenêtre contextuelle déborde en raison d’un trop grand nombre d’invites.
// Create a LanguageModel session with a system prompt.
const session = await LanguageModel.create({
  initialPrompts: [{
    role: "system",
    content: "You are a helpful assistant."
  }]
});
Placer l’invite n’importe { role: "system", content: "You are a helpful assistant." } où ailleurs qu’en position 0 dans initialPrompts rejette avec un TypeError.
Invite N-shot avec initialPrompts
L’option initialPrompts vous permet également de fournir des exemples d’interactions utilisateur/assistant que vous souhaitez que le modèle continue à utiliser lorsque vous y êtes invité.
Cette technique est également connue sous le nom d’invite N-shot et est utile pour rendre les réponses générées par le modèle plus déterministes.
// Create a LanguageModel session with multiple initial prompts, for N-shot
// prompting.
const session = await LanguageModel.create({
  initialPrompts: [
    { role: "system", content: "Classify the following product reviews as either OK or Not OK." },
    { role: "user", content: "Great shoes! I was surprised at how comfortable these boots are for the price. They fit well and are very lightweight." },
    { role: "assistant", content: "OK" },
    { role: "user", content: "Terrible product. The manufacturer must be completely incompetent." },
    { role: "assistant", content: "Not OK" },
    { role: "user", content: "Could be better. Nice quality overall, but for the price I was expecting something more waterproof" },
    { role: "assistant", content: "OK" }
  ]
});
Clonez une session pour recommencer la conversation avec les mêmes options
Clonez une session existante pour inviter le modèle sans la connaissance des interactions précédentes, mais avec les mêmes options de session.
Le clonage d’une session est utile lorsque vous souhaitez utiliser les options d’une session précédente, mais sans influencer le modèle avec les réponses précédentes.
// Create a first LanguageModel session.
const firstSession = await LanguageModel.create({
  initialPrompts: [{
    role: "system",
    content: "You are a helpful assistant."
  }]
});

// Later, create a new session by cloning the first session to start a new
// conversation with the model, but preserve the first session's settings.
const secondSession = await firstSession.clone();
Demander le modèle
Pour demander le modèle, après avoir créé une session de modèle, utilisez les session.prompt() méthodes ou session.promptStreaming() .
Attendez la réponse finale
La prompt méthode retourne une promesse qui se résout une fois que le modèle a fini de générer du texte en réponse à votre invite :
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model and wait for the response to be generated.
const result = await session.prompt(promptString);

// Use the generated text.
console.log(result);
Afficher les jetons au fur et à mesure qu’ils sont générés
La promptStreaming méthode renvoie immédiatement un objet de flux. Utilisez le flux pour afficher les jetons de réponse au fur et à mesure de leur génération :
// Create a LanguageModel session.
 const session = await LanguageModel.create();

// Prompt the model.
 const stream = session.promptStreaming(myPromptString);

// Use the stream object to display tokens that are generated by the model, as
// they are being generated.
for await (const chunk of stream) {
  console.log(chunk);
}
Vous pouvez appeler les prompt méthodes et promptStreaming plusieurs fois au sein du même objet de session pour continuer à générer du texte basé sur des interactions précédentes avec le modèle au sein de cette session.
Contraindre la sortie du modèle à l’aide d’un schéma JSON ou d’une expression régulière
Pour rendre le format des réponses du modèle plus déterministe et plus facile à utiliser de manière programmatique, utilisez l’option responseConstraint lorsque vous demandez le modèle.
L’option responseConstraint accepte un schéma JSON ou une expression régulière :
Pour que le modèle réponde avec un objet JSON à chaînes qui suit un schéma donné, définissez
responseConstraintle schéma JSON que vous souhaitez utiliser.Pour que le modèle réponde avec une chaîne qui correspond à une expression régulière, définissez
responseConstraintcette expression régulière.
L’exemple suivant montre comment faire en sorte que le modèle réponde à une invite avec un objet JSON qui suit un schéma donné :
// Create a LanguageModel session, with a system prompt.
const session = await LanguageModel.create({
  initialPrompts: [
    {
      role: "system",
      content: "You are an AI model designed to analyze the sentiment of user-provided text. Your goal is to classify the sentiment into predefined categories and provide a confidence score. Follow these guidelines:\n\n- Identify whether the sentiment is positive, negative, or neutral.\n- Provide a confidence score (0-1) reflecting the certainty of the classification.\n- Ensure the sentiment classification is contextually accurate.\n- If the sentiment is unclear or highly ambiguous, default to neutral.\n\nYour responses should be structured and concise, adhering to the defined output schema."
    }
  ]
});

// Define a JSON schema for the Prompt API to constrain the generated response.
const schema = {
  "type": "object",
  "required": ["sentiment", "confidence"],
  "additionalProperties": false,
  "properties": {
    "sentiment": {
      "type": "string",
      "enum": ["positive", "negative", "neutral"],
      "description": "The sentiment classification of the input text."
    },
    "confidence": {
      "type": "number",
      "minimum": 0,
      "maximum": 1,
      "description": "A confidence score indicating certainty of the sentiment classification."
    }
  }
}
;

// Prompt the model, by providing the JSON schema in the responseConstraint
// option.
const response = await session.prompt(
  "Ordered a Philly cheesesteak, and it was not edible. Their milkshake is just milk with cheap syrup. Horrible place!",
  { responseConstraint: schema }
);
L’exécution du code ci-dessus retourne une réponse qui contient un objet JSON à séquences, tel que :
{"sentiment": "negative", "confidence": 0.95}
Vous pouvez ensuite utiliser la réponse dans votre logique de code en l’analysant à l’aide de la JSON.parse() fonction :
// Parse the JSON string generated by the model and extract the sentiment and
// confidence values.
const { sentiment, confidence } = JSON.parse(response);

// Use the values.
console.log(`Sentiment: ${sentiment}`);
console.log(`Confidence: ${confidence}`);
Envoyer plusieurs messages par invite
En plus des chaînes, les prompt méthodes et promptStreaming acceptent également un tableau d’objets utilisé pour envoyer plusieurs messages avec des rôles personnalisés. Les objets que vous envoyez doivent être de la forme { role, content }, où role est soit user ou assistant, et content est le message.
Par exemple, pour fournir plusieurs messages utilisateur et un message d’assistant dans la même invite :
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model by sending multiple messages at once.
const result = await session.prompt([
  { role: "user", content: "First user message" },
  { role: "user", content: "Second user message" },
  { role: "assistant", content: "The assistant message" }
]);
Arrêter la génération de texte
Pour abandonner une invite avant la résolution de la promesse renvoyée par session.prompt() ou avant la fin du flux retourné par session.promptStreaming() , utilisez un AbortController signal :
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Create an AbortController object.
const abortController = new AbortController();

// Prompt the model by passing the AbortController object by using the signal
// option.
const stream = session.promptStreaming(myPromptString , {
  signal: abortController.signal
});

// Later, perhaps when the user presses a "Stop" button, call the abort()
// method on the AbortController object to stop generating text.
abortController.abort();
Détruire une session
Détruisez la session pour faire savoir au navigateur que vous n’avez plus besoin du modèle de langage, afin que le modèle puisse être déchargé de la mémoire.
Vous pouvez détruire une session de deux manières différentes :
- En utilisant la
destroy()méthode. - En utilisant un
AbortControllerfichier .
Détruire une session en utilisant la méthode destroy()
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Later, destroy the session by using the destroy method.
session.destroy();
Détruire une session à l’aide d’un AbortController
// Create an AbortController object.
const controller = new AbortController();

// Create a LanguageModel session and pass the AbortController object by using
// the signal option.
const session = await LanguageModel.create({ signal: controller.signal });

// Later, perhaps when the user interacts with the UI, destroy the session by
// calling the abort() function of the AbortController object.
controller.abort();
Tenir compte du filigrane de contenu généré par l’IA
À partir de la version 158 de Microsoft Edge, le texte généré par l’API Prompt inclut un filigrane invisible, qui indique que le texte est généré par l’IA. Si votre site web ou votre extension traite le texte généré, assurez-vous que votre code tient compte du filigrane lorsque vous rendez, analysez ou convertissez la réponse.
Pour en savoir plus sur le schéma de filigrane, voir Modèle de filigranedans Filigrane dans les API de texte Windows AI.
Le filigrane n’est pas appliqué aux réponses générées à l’aide de l’option responseConstraint . Voir Contraindre la sortie du modèle à l’aide d’un schéma JSON ou d’une expression régulière, ci-dessus.
Avant de supprimer le filigrane inséré automatiquement, tenez compte des éléments suivants : Il vous incombe de vous assurer que votre site web ou extension répond à toutes les exigences applicables en matière de marquage du contenu généré par l’IA.
Envoyer des commentaires
L’aperçu du développeur et l’essai d’origine de l’API d’invite sont destinés à vous aider à découvrir les cas d’usage des modèles de langage fournis par le navigateur.
Nous souhaitons en savoir plus sur :
- Plage de scénarios pour lesquels vous envisagez d’utiliser l’API d’invite.
- Tout problème avec l’API d’invite.
- Tout problème avec le modèle Aion Instruct.
- Tout problème d’interopérabilité de l’API Prompt entre différents navigateurs et modèles.
- Si de nouvelles API spécifiques aux tâches seraient utiles.
Pour envoyer des commentaires sur vos scénarios et les tâches que vous souhaitez accomplir, ajoutez un commentaire au problème de commentaires de l’API d’invite.
Si vous remarquez des problèmes lors de l’utilisation de l’API à la place, signalez-les sur le dépôt.
Vous pouvez également contribuer à la discussion sur la conception de l’API Prompt au dépôt du groupe de travail Web Machine Learning du W3C.
Voir aussi
- Spécification du brouillon d’API d’invite
- webmachinelearning/prompt-api Référentiel GitHub
- /built-in-ai/ : code source et fichier Lisez-moi pour les terrains de jeu IA intégrés, y compris le terrain de jeu API Prompt.
- Résumer, écrire et réécrire du texte avec les API d’assistance à l’écriture
- Classifier du texte avec l’API Décisions
- Corriger les fautes de grammaire, d’orthographe et de ponctuation dans le texte avec l’API Correcteur
- Détecter des langues avec l’API Détecteur de langue
- Traduire du texte avec l’API Translator