Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A szinkronizált táblák lehetővé teszik a lakehouse-adatok kiszolgálását a Lakebase Postgresen keresztül. A Unity Catalog-táblák a Postgresbe szinkronizálódnak, így az alkalmazások közvetlenül, alacsony késéssel kérdezhetik le a lakehouse-adatokat. Ezt a folyamatot általában fordított ETL-nek nevezzük. A lakehouse elemzésre és bővítésre van optimalizálva, míg a Lakebase olyan üzemeltetési számítási feladatokhoz lett kialakítva, amelyek gyors keresési stílusú lekérdezéseket és tranzakciós konzisztenciát igényelnek.
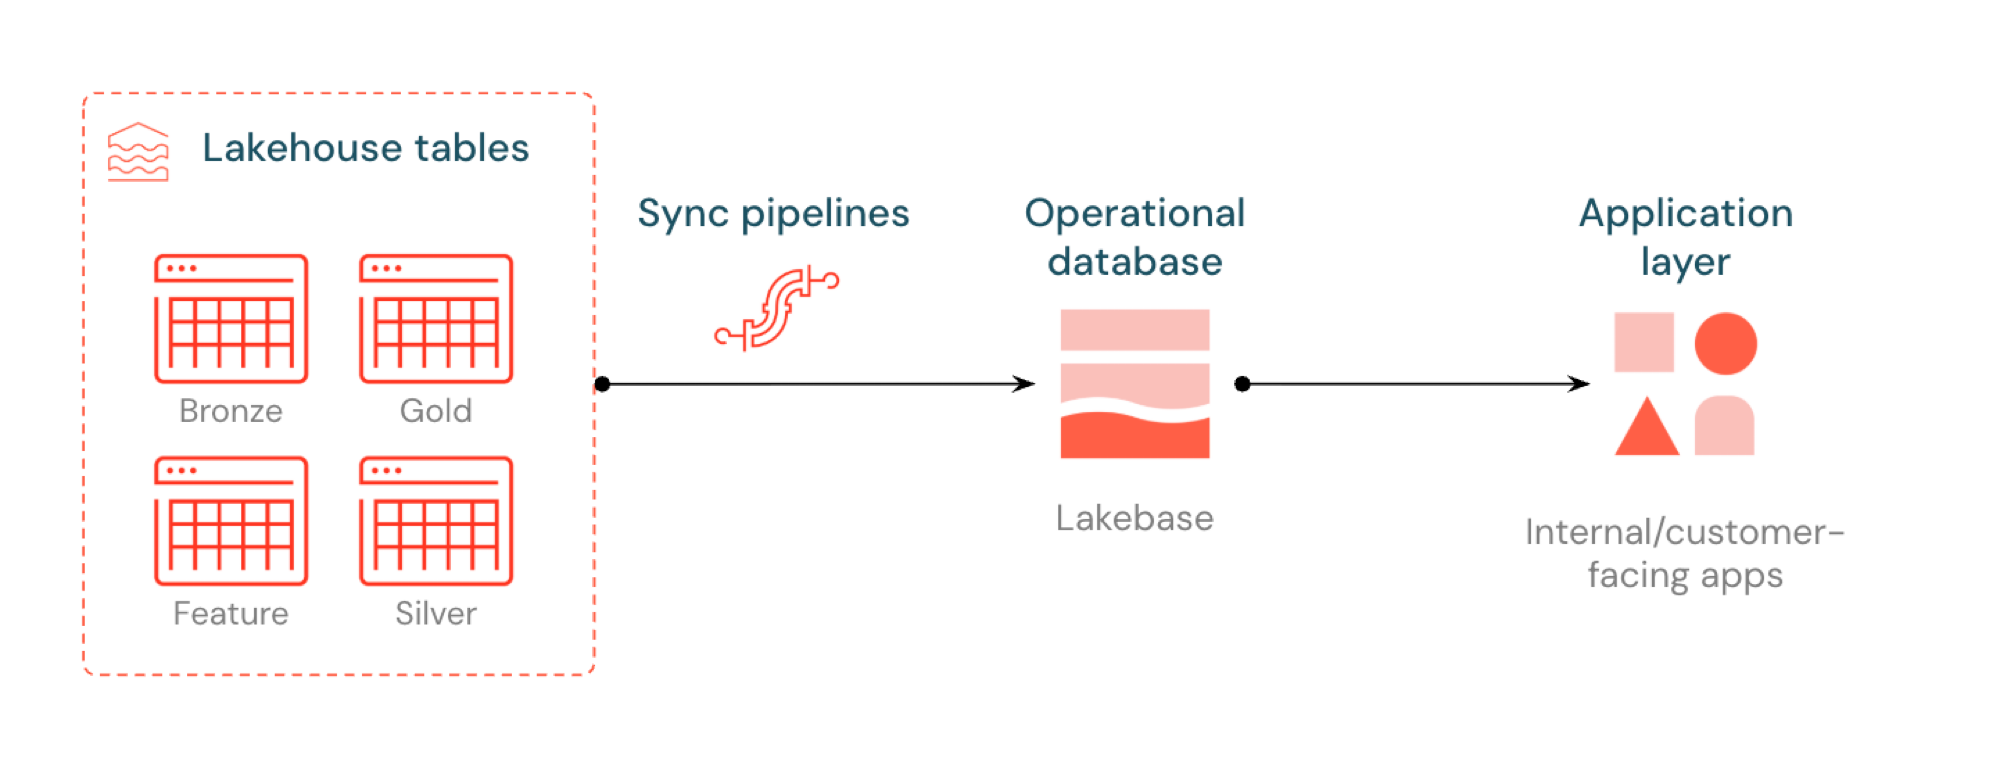
Mik azok a szinkronizált táblák?
A szinkronizált táblák segítségével elemzési szintű adatokat szolgáltathat a Unity Catalogból a Lakebase Postgresen keresztül, így elérhetővé válik az alacsony késésű lekérdezéseket és teljes ACID-tranzakciókat igénylő alkalmazások számára. Áthidalják az elemzési tárolók és az operatív rendszerek közötti szakadékot azáltal, hogy az adatok készen állnak a valós idejű alkalmazásokban való használatra.
Támogatott források
A szinkronizált táblák a következő Unity Catalog-forrástípusokat támogatják:
- Kezelt és külső Delta-táblák
- Felügyelt és külső Iceberg táblázatok
- Nézetek és materializált nézetek
Hogyan működik?
A Databricks szinkronizált táblái létrehoznak egy felügyelt másolatot a Unity Catalog adatairól a Lakebase-ben. Szinkronizált tábla létrehozásakor a következőt kapja:
- Szinkronizált tábla a Unity Katalógusban, amely a szinkronizálási folyamatra hivatkozik
- Postgres-tábla a Lakebase-ben (írásvédett, az alkalmazások által lekérdezhető)
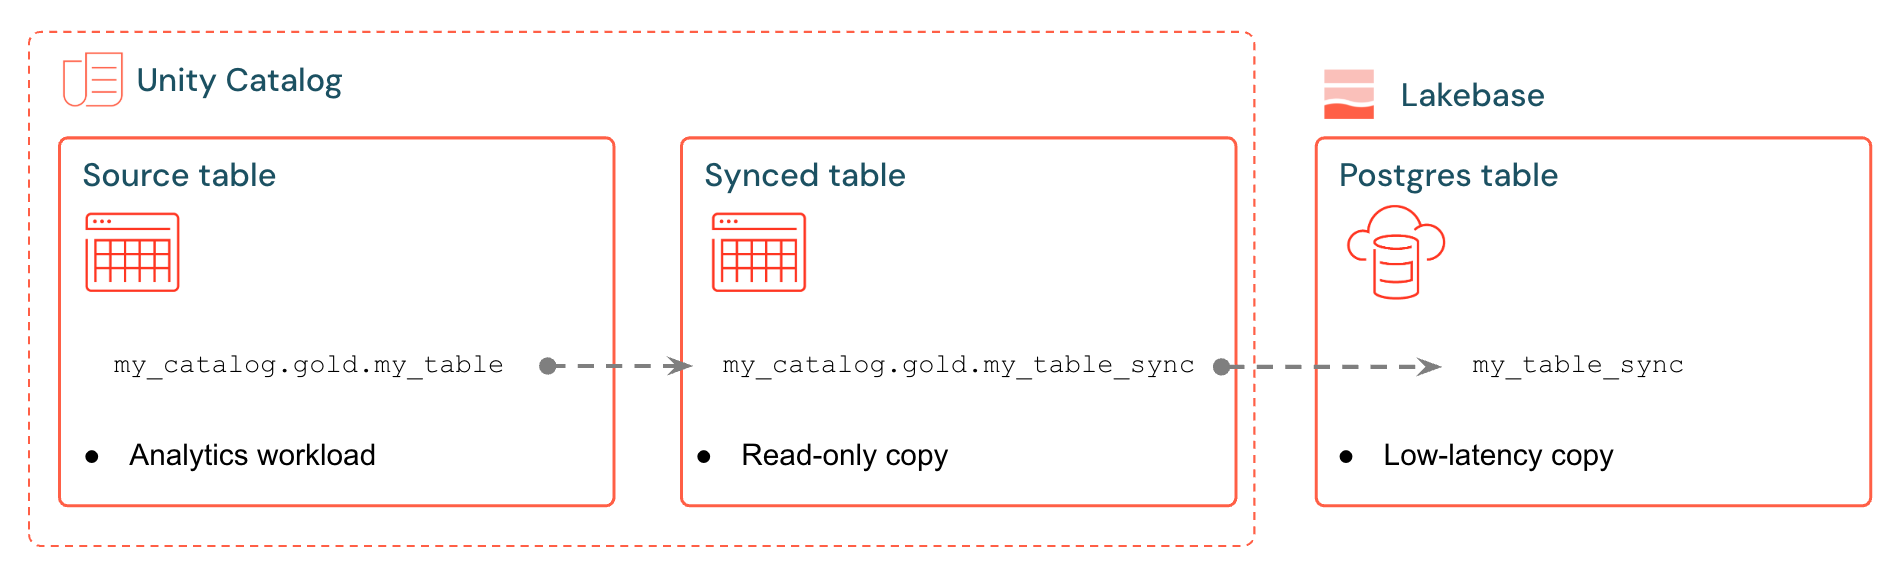
Például szinkronizálhatja az aranytáblákat, a mérnöki funkciókat vagy az ML-kimeneteket egy új szinkronizált táblába analytics.gold.user_profilesanalytics.gold.user_profiles_synced. A Postgresben a Unity Catalog sémaneve a Postgres-séma neve lesz, így ez a következőképpen gold.user_profiles_syncedjelenik meg:
SELECT * FROM gold.user_profiles_synced WHERE user_id = 12345;
Az alkalmazások standard Postgres-illesztőprogramokkal csatlakoznak, és saját működési állapotuk mellett lekérdezik a szinkronizált adatokat.
Figyelmeztetés
Bár a szinkronizált táblák közvetlenül módosíthatók a Postgresben, Azure Databricks szigorúan csak olvasási lekérdezések futtatását javasolja az adatintegritás forrással való védelme érdekében. A szinkronizált táblákon végzett támogatott műveletekről a Postgres szinkronizált tábláiban engedélyezett műveletek című témakörben olvashat.
A szinkronizálási folyamatok felügyelt Lakeflow-folyamatokkal folyamatosan frissítik a Unity Catalog szinkronizált táblát és a Postgres-táblát a forrástábla módosításaival. Minden szinkronizálás legfeljebb 16 kapcsolatot használhat a Lakebase-adatbázishoz.
A Lakebase Postgres akár 1000 egyidejű kapcsolatot támogat tranzakciós garanciával, így az alkalmazások beolvashatják a bővített adatokat, miközben ugyanabban az adatbázisban lévő beszúrásokat, frissítéseket és törléseket is kezelik.
Szinkronizálási módok
Az alkalmazás igényeinek megfelelően válassza ki a megfelelő szinkronizálási módot:
| Mód | Leírás | Mikor érdemes használni? | Teljesítmény |
|---|---|---|---|
| pillanatkép- | Az összes adat egyszeri másolata | A forrás > ciklusonként a sorok 10%-át módosítja | 10-szer hatékonyabb, ha 10% forrásadatot módosít > |
| Kiváltott | Ütemezett frissítések, amelyek igény szerint vagy időközönként futnak | A forrássorok ismert ütemben változnak. A beszúrásokat, frissítéseket és törléseket minden frissítéskor propagálják. | Jó költség/késés egyenleg. Költséges, ha 5 perces időközöket futtat < |
| Folyamatos | Valós idejű streamelés másodperces késéssel | A módosításoknak közel valós időben kell megjelennie a Lakebase-ben | Legalacsonyabb késés, legmagasabb költség. Minimum 15 másodperces időközök |
A forráskövetelmény a szinkronizálási módtól függ:
-
Snapshot minden adatot másol, így a forrásnak csak támogatnia
SELECT *kell . -
Triggered és Continuous esetén a sorszintű módosítások inkrementálisan kerülnek alkalmazásra, ezért a forrásnak változási adatfolyamot kell biztosítania. Engedélyezze a forrás írási idejű változtatási adatfolyamát , vagy használja az automatikus adatfolyamot. Ha egy Triggered vagy Continuous forrásnak nincs változásadat-hírcsatornája, a felhasználói felületen figyelmeztetés jelenik meg a futtatáshoz szükséges pontos
ALTER TABLEparanccsal.
Az automatikus változási adatfolyam (Public Preview) olvasási időben számolja a sorszintű változásokat, ahelyett, hogy írási idejű változásadatadatot igényelne a forráson. Ez lehetővé teszi, hogy több forrástípus, beleértve az Apache Jégberg-táblákat és a materializált nézeteket szinkronizálja Triggered vagy Continuous módban. Az Automatikus adatváltás által támogatott forrástípusokért lásd az Automatikus adatfolyam dokumentációját.
A szinkronizált táblákhoz tartozó automatikus módosítási adatcsatorna előzetes verzióban érhető el. Amíg előnézetben van, teljesíts két extra lépést:
Engedélyezze az előnézetet. Egy munkaterület-admin lehetővé teszi az automatikus adatfolyam váltását az Előnézetek oldaláról a munkaterület beállításaiban.
Állítsd be a pipeline csatornát előnézetre. Amikor létrehozod a szinkronizált táblát, állítsd a folyamatcsatornát a következőre:
PREVIEW. Ez az opció jelenleg csak az API-n keresztül érhető el:{ "spec": { "new_pipeline_spec": { "pipeline_channel": "PREVIEW" } } }
Példák az alkalmazási helyzetekre
Szinkronizált táblákat használhat adatkiszolgáló használati esetekhez, például:
- Személyre szabási motorok, amelyek friss felhasználói profilokat szolgálnak ki a Databricks Appsben
- A lakehouse-ban kiszámított modell-előrejelzéseket vagy funkcióértékeket kiszolgáló alkalmazások
- Ügyféloldali irányítópultok, amelyek valós időben szolgálják ki a KPI-ket
- Csalásészlelési szolgáltatások, amelyek azonnali művelethez szolgálnak ki kockázati pontszámokat
- Támogatási eszközök, amelyek gazdagított ügyfélrekordokat szolgálnak ki a Lakehouse-adatokból
Szinkronizált tábla létrehozása
Előfeltételek
A következők szükségesek:
- Egy Databricks-munkaterület, amelyen engedélyezve van a Lakebase.
- Egy Lakebase-projekt (lásd : Projekt létrehozása).
- Szinkronizálandó Unity-katalógustábla.
- Szinkronizált táblák létrehozásához szükséges engedélyek. A használt sémákon USE_SCHEMA és CREATE_TABLE kell.
Triggered vagy Continuous módok esetén a forrásnak változási adatfolyamot kell biztosítania. Vagy engedélyezzük az írási idejű változási adatfolyamot egy jogosult Delta forrástáblán, vagy használjunk automatikus változásadatfolyamot olyan forrásokhoz, mint az Apache Iceberg táblák és a materializált nézetek. Az automatikus változási adatfolyam Public Preview módban van, és a Sync módokban leírt extra beállítást igényli.
A Delta forrástáblán írható idejű változásadatadat engedélyezéséhez futassuk:
ALTER TABLE your_catalog.your_schema.your_table
SET TBLPROPERTIES (delta.enableChangeDataFeed = true)
A kapacitástervezés és az adattípusok kompatibilitását lásd : Adattípusok, kompatibilitás és kapacitástervezés.
UI
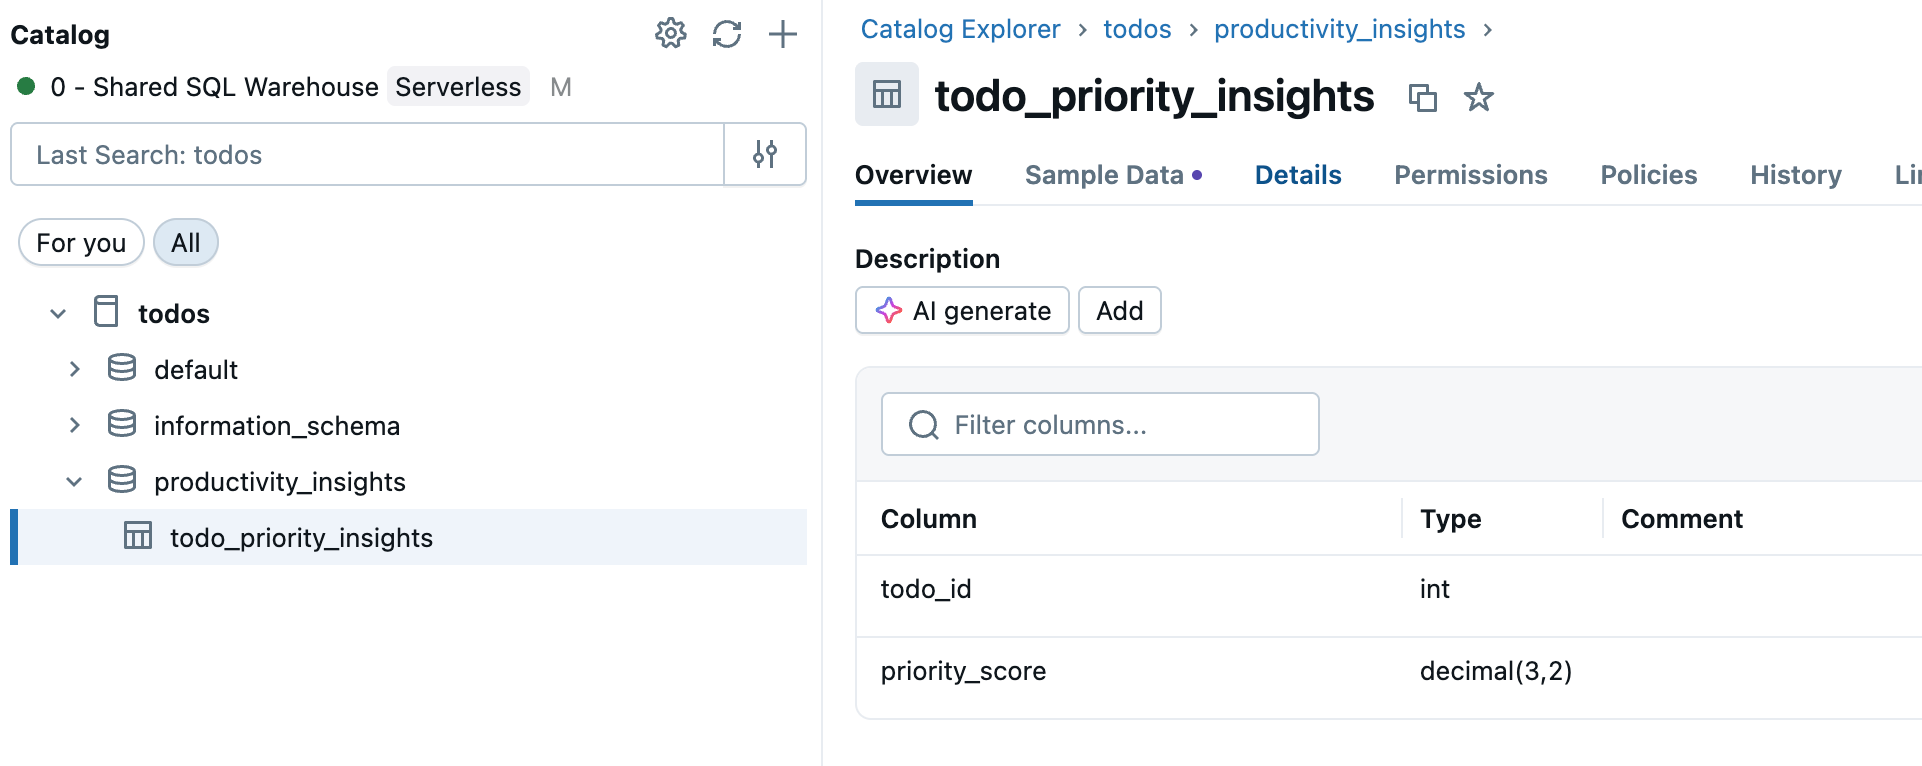
Nyissa meg a katalógust a munkaterület oldalsávjában, és válassza ki a szinkronizálni kívánt Unity Catalog-táblát.
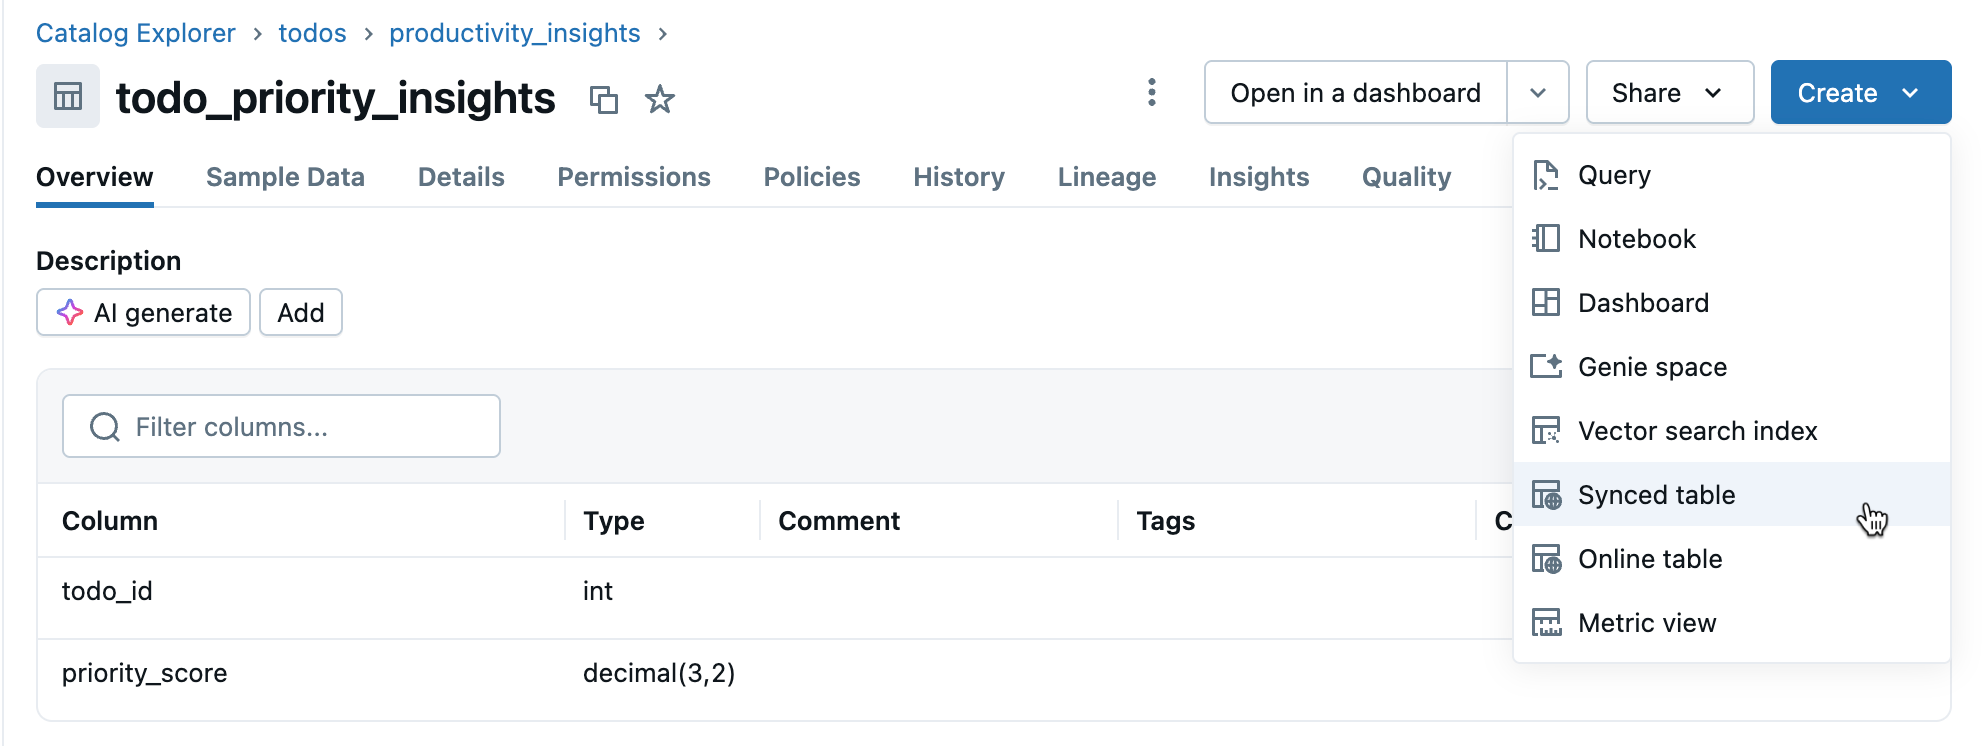
Kattintson aSzinkronizált tábla> gombra a táblázat részletei nézetben.
A Szinkronizált tábla létrehozása párbeszédpanelen:
A katalógus- és sémalisták csak olyan Unity Catalog-sémákat tartalmaznak, amelyekben az aktuális felhasználó USE_SCHEMA és CREATE_TABLE jogosultságokkal rendelkezik. Ha nem látja a várt sémát, erősítse meg engedélyeit a katalógus rendszergazdájával.
Tábla neve: Adja meg a szinkronizált tábla nevét (a rendszer ugyanabban a katalógusban és sémában hozza létre, mint a forrástábla). Ez létrehoz egy Unity Catalog-szinkronizált táblát és egy lekérdezhető Postgres-táblát is.
Adatbázis típusa: Válassza a Lakebase Kiszolgáló nélküli (Automatikus skálázás) lehetőséget.
Szinkronizálási mód: Válassza a Pillanatkép, az Aktivált vagy a Folyamatos lehetőséget az igényeinek megfelelően (lásd a fenti szinkronizálási módokat ).
Konfigurálja a projekt, az ág és az adatbázis kiválasztását.
Ellenőrizze, hogy az elsődleges kulcs helyes-e (általában automatikusan észlelhető).
Fontos
Az elsődleges kulcs oszlopai nem null értékűek a szinkronizált táblában. Az elsődleges kulcsoszlopokban null értékű sorok nem lesznek szinkronizálva.
(Nem kötelező) Ha két sor ugyanazt az elsődleges kulcsot tudja megosztani a forrástáblában, válasszon egy időzítési kulcsot a deduplikáció konfigurálásához. Idősorkulcs megadásakor a szinkronizált tábla csak azokat a sorokat tartalmazza, ahol az egyes elsődleges kulcsok legújabb időbélyegkulcs-értéke szerepel. Az időzítőkulcs nélküli meghibásodási mód esetén lásd: Duplikált kulcsok.
Ha a "Triggered" vagy "Continuous" módot választotta, és még nem engedélyezte a Change Data Feed-et, egy figyelmeztetés jelenik meg, amely megadja a futtatandó pontos parancsot. Az adattípus-kompatibilitással kapcsolatos kérdésekért tekintse meg az adattípusokat és a kompatibilitást.
Kattintson a Létrehozás gombra a szinkronizált tábla létrehozásához.
A szinkronizált tábla figyelése a katalógusban. Az Áttekintés lapon látható a szinkronizálás állapota, a konfiguráció, a folyamat állapota és az utolsó szinkronizálási időbélyeg. Manuális frissítéshez használja a Szinkronizálás parancsot .
parancssori felület
databricks postgres create-synced-table my-catalog.sales.orders \
  --json '{
    "spec": {
      "source_table_full_name": "main.sales.orders",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["order_id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true
    }
  }'
A SYNCED_TABLE_ID pozícióargumentum a formátumot catalog.schema.tablehasználja. Postgresben a {table} táblát a {schema} sémában hozzák létre, azzal az adatbázissal, amelyet a postgres_database segítségével állít be (ebben az esetben mydb). A parancs alapértelmezés szerint megvárja, amíg a művelet befejeződik. Az összes elérhető beállításért tekintse meg a databricks postgres create-synced-table című témakört.
Python SDK
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import (
    SyncedTable,
    SyncedTableSyncedTableSpec,
    SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy,
)

w = WorkspaceClient()

synced_table = w.postgres.create_synced_table(
    synced_table=SyncedTable(spec=SyncedTableSyncedTableSpec(
        source_table_full_name="main.sales.orders",
        branch="projects/my-project/branches/production",
        primary_key_columns=["order_id"],
        scheduling_policy=SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy.SNAPSHOT,
        postgres_database="mydb",
        create_database_objects_if_missing=True,
    )),
    synced_table_id="my-catalog.sales.orders",
).wait()

print(f"Synced table created: {synced_table.name}")
Az synced_table_id a catalog.schema.table formátumot használja, és a Unity Catalog szinkronizált táblanévvé válik. Postgresben a {table} táblát a {schema} sémában hozzák létre, azzal az adatbázissal, amelyet a postgres_database segítségével állít be (ebben az esetben mydb).
Java SDK
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.*;
import java.util.List;

WorkspaceClient w = new WorkspaceClient();

SyncedTable syncedTable = w.postgres().createSyncedTable(
    new CreateSyncedTableRequest()
        .setSyncedTableId("my-catalog.sales.orders")
        .setSyncedTable(new SyncedTable()
            .setSpec(new SyncedTableSyncedTableSpec()
                .setSourceTableFullName("main.sales.orders")
                .setBranch("projects/my-project/branches/production")
                .setPrimaryKeyColumns(List.of("order_id"))
                .setSchedulingPolicy(SyncedTableSyncedTableSpecSyncedTableSchedulingPolicy.SNAPSHOT)
                .setPostgresDatabase("mydb")
                .setCreateDatabaseObjectsIfMissing(true))))
    .waitForCompletion();

System.out.println("Synced table created: " + syncedTable.getName());
göndörít
curl -X POST "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables?synced_table_id=my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \
  -H "Content-Type: application/json" \
  -d '{
    "spec": {
      "source_table_full_name": "main.sales.orders",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["order_id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true
    }
  }'
Ez egy hosszú ideig futó műveletet ad vissza. A visszaadott name mező lekérdezése a következőig done: true: . Lásd a hosszú ideig futó műveleteket. A hitelesítés beállításához tekintse meg a Hitelesítés című témakört.
Későbbi szinkronizálások ütemezése vagy aktiválása
A kezdeti pillanatkép automatikusan fut a létrehozáskor. Pillanatkép- és aktivált mód esetén a későbbi szinkronizálásokat explicit módon kell aktiválni. A folyamatos mód önkiszolgáló.
Adatbázistábla szinkronizálási folyamatának feladata
A Lakeflow-feladatok adatbázistábla-szinkronizálási folyamatfeladata munkafolyamat-lépésként futtat egy szinkronizált táblafolyamatot. Konfigurálja a feladatot táblafrissítési eseményindítóval vagy ütemezéssel.
Trigger a forrástábla frissítésekor
A feladat a forrás Unity Catalog-tábla frissítésekor aktiválódik. Aktivált mód esetén a rendszer csak az új módosításokat alkalmazza növekményesen, közel valós idejű frissességet biztosítva a folyamatos mód mindig aktuális költsége nélkül.
- Az oldalsávon kattintson a Munkafolyamatok elemre.
- Kattintson a Feladat létrehozása gombra, vagy nyisson meg egy meglévő feladatot.
- A Feladatok lapon kattintson a + Másik tevékenységtípus hozzáadása elemre.
- A Betöltés és átalakítás területen válassza az Adatbázistábla szinkronizálási folyamata lehetőséget.
- A Pipeline mezőben válassza ki a szinkronizált táblához társított pipeline-t.
- Az Ütemezések és eseményindítók csoportban kattintson az Eseményindító hozzáadása elemre.
- Eseményindító típusként válassza a Táblafrissítés lehetőséget.
- A Táblák területen válassza ki a figyelendő unity katalógus forrástáblát.
- Kattintson a Mentés lehetőségre.
Eseményindító ütemezés szerint
Rögzített ütemben futtatja a szinkronizálást. Kiválóan alkalmas Pillanatkép módhoz, ahol az éjszakai vagy heti teljes frissítés általában a leghatékonyabb minta.
- A fenti 1–5. lépést követve adjon hozzá adatbázistábla-szinkronizálási folyamatfeladatot egy feladathoz.
- Az Ütemezések és eseményindítók csoportban kattintson az Eseményindító hozzáadása elemre.
- Válassza az Ütemezett elemet az eseményindító típusaként.
- Állítsa be a cron ütemezését és időzónáját, majd kattintson a Mentés gombra.
Szinkronizálás állapotának ellenőrzése
A szinkronizált táblák aktuális állapotának és utolsó szinkronizálási idejének ellenőrzése:
UI
A Katalógusban lépjen a szinkronizált táblára, és válassza az Áttekintés lapot. Megjeleníti az aktuális szinkronizálási állapotot, a folyamat állapotát és az utolsó szinkronizálási időbélyeget.
Python SDK
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

table = w.postgres.get_synced_table("synced_tables/my-catalog.sales.orders")
print(f"State: {table.status.detailed_state}")
print(f"Last sync: {table.status.last_sync_time}")
print(f"Message: {table.status.message}")
Java SDK
import com.databricks.sdk.WorkspaceClient;
import com.databricks.sdk.service.postgres.SyncedTable;

WorkspaceClient w = new WorkspaceClient();

SyncedTable table = w.postgres().getSyncedTable("synced_tables/my-catalog.sales.orders");
System.out.println("State: " + table.getStatus().getDetailedState());
System.out.println("Last sync: " + table.getStatus().getLastSyncTime());
System.out.println("Message: " + table.getStatus().getMessage());
göndörít
curl "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables/my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
Adattípusok és kompatibilitás
A Unity Catalog adattípusai Postgres-típusokra vannak leképezve szinkronizált táblák létrehozásakor. Az összetett típusok (TÖMB, MAP, STRUCT) JSONB-ként vannak tárolva a Postgresben.
| Forrásoszlop típusa | Postgres oszloptípus |
|---|---|
| BIGINT | BIGINT |
| BINARY | BYTEA |
| BÓLÉ | BÓLÉ |
| DATE | DATE |
| DECIMÁLIS(p;s) | NUMERIKUS |
| DUPLA | DUPLA PONTOSSÁG |
| FLOAT | VALÓDI |
| INT | INTEGER |
| INTERVALLUM | INTERVALLUM |
| SMALLINT | SMALLINT |
| STRING | szöveg |
| TIMESTAMP | IDŐBÉLYEG IDŐZÓNÁVAL |
| TIMESTAMP_NTZ | IDŐBÉLYEG IDŐZÓNA NÉLKÜL |
| TINYINT | SMALLINT |
| TÖMB<elemtípus> | JSONB |
| MAP<keyTípus,értékTípus> | JSONB |
| STRUCT<mezőNév:fieldType[, ...]> | JSONB |
Megjegyzés:
A FÖLDRAJZI, GEOMETRIAI, VARIANT- és OBJEKTUMtípusok nem támogatottak.
Egyedi típus leképezések
Amikor szinkronizált táblát hozol létre, felülírhatod az alapértelmezett Delta-to-Postgres típusú leképezést bizonyos oszlopok esetén .type_overrides
Megjegyzés:
Az vector és halfvec típusokhoz vektorkiterjesztés szükséges a célállomás adatbázisban. A szinkronizált tábla létrehozása nem telepít bővítményeket, ezért telepítsünk egyet, mielőtt létrehoznád a szinkronizált táblát. Használd a lakebase_vector-t, amely hozzáadja az ANN vektorkeresést a Lakebase Search-en keresztül, és a pgvectort telepíti függőségként:
CREATE EXTENSION IF NOT EXISTS lakebase_vector CASCADE;
Az vector és halfvec típus használatához Lakebase Search nélkül telepítsük a pgvectort önállóan .CREATE EXTENSION IF NOT EXISTS vector; A varchar típus nem igényel hosszabbítást.
| Forrásoszlop típusa | Postgres típus | Size | Definíció (pg_type) |
Példa használati esetre |
|---|---|---|---|---|
ARRAY<FLOAT>, ARRAY<DOUBLE> |
vector(n) |
Beágyazási dimenzió | PG_SPECIFIC_TYPE_VECTOR |
Tárold a beágyazásokat JSONB helyett vector formátumban, készen a lakebase_vector használatával végzett hasonlóságkereséshez |
ARRAY<FLOAT>, ARRAY<DOUBLE> |
halfvec(n) |
Beágyazási dimenzió | PG_SPECIFIC_TYPE_HALFVEC |
Félprecíziós beágyazások, körülbelül feleakkora tárhelyigénnyel, mint a vector |
STRING |
varchar(n) |
Maximális hossz | PG_SPECIFIC_TYPE_VARCHAR |
Leképezés hosszkorlátozott varchar típusra az alapértelmezett TEXT helyett |
Megjegyzés:
size minden, a táblázatban szereplő típus esetében kötelező. Az érvényes tartományok:
-
vectoréshalfvec: 1-től 16 000-ig, a beágyazási dimenziók száma. -
varchar: 1-től 10 485 760-ig, a maximális karakterhossz.
Az egyedi típusú leképezések konfigurálhatók az API, a CLI és a Databricks SDK-kon keresztül, amikor szinkronizált táblát hozol létre.
Egy forrástábla main.docs.chunks(id BIGINT, title STRING, embedding ARRAY<FLOAT>) esetén az alábbiak a Postgresben title értéket varchar(256) értékre, illetve embedding értéket vector(1024) értékre képezik le:
databricks postgres create-synced-table main.docs.chunks_pg \
  --json '{
    "spec": {
      "source_table_full_name": "main.docs.chunks",
      "branch": "projects/my-project/branches/production",
      "primary_key_columns": ["id"],
      "scheduling_policy": "SNAPSHOT",
      "postgres_database": "mydb",
      "create_database_objects_if_missing": true,
      "type_overrides": [
        { "column_name": "title", "pg_type": "PG_SPECIFIC_TYPE_VARCHAR", "size": 256 },
        { "column_name": "embedding", "pg_type": "PG_SPECIFIC_TYPE_VECTOR", "size": 1024 }
      ]
    }
  }'
A felülbírálás nélkül a(z) titleTEXT lenne, a(z) embedding pedig JSONB lenne.
Érvénytelen karakterek kezelése
Bizonyos karakterek, például null bájtok (0x00) engedélyezettek a Unity Catalog STRING, ARRAY, MAP vagy STRUCT oszlopaiban, de a Postgres TEXT vagy JSONB oszlopokban nem támogatottak. Ez szinkronizálási hibákat okozhat a következő hibákkal:
ERROR: invalid byte sequence for encoding "UTF8": 0x00
ERROR: unsupported Unicode escape sequence DETAIL: \u0000 cannot be converted to text
- Az első hiba akkor fordul elő, ha egy null bájt jelenik meg egy legfelső szintű karakterlánc oszlopban, amely közvetlenül a Postgresre térképez.
- A második hiba akkor fordul elő, ha egy komplex típusban (
STRUCT,ARRAYvagyMAP) beágyazott karakterláncban nullértékű bájt jelenik meg, amelyet a rendszerJSONBformában szerializál. Az összes sztring a szerializálás során PostgresTEXT-re kerül átalakításra, ahol\u0000nem engedélyezett.
Megoldások:
Sztringmezők megtisztítása: Szinkronizálás előtt távolítsa el a nem támogatott karaktereket. Null bájtok a karakterlánc oszlopokban:
SELECT REPLACE(column_name, CAST(CHAR(0) AS STRING), '') AS cleaned_column FROM your_tableKonvertálás BINÁRIS értékre: Olyan KARAKTERLÁNC-oszlopok esetén, ahol a nyers bájtok megőrzése szükséges, konvertálja bináris típussá.
Kapacitástervezés
A szinkronizált táblák implementálásának tervezésekor vegye figyelembe az alábbi erőforráskövetelményeket:
- Kapcsolathasználat: Minden szinkronizált tábla legfeljebb 16 kapcsolatot használ a Lakebase adatbázisodhoz, amelyek beleszámítanak a projekt kapcsolati korlátjába.
- Méretkvóta: Az összes szinkronizált táblázat összes logikai adata beleszámít az ág adatbázis-tárolási kvótájába. Ha nagyobb kvótára van szüksége, lépjen kapcsolatba a Databricks ügyfélszolgálatával. Az egyes táblákhoz nincs kvóta, de a Databricks azt javasolja, hogy frissítésre szoruló táblák esetén ne lépje túl az 1 TB-ot.
- Teljes frissítés mérete: Teljes frissítés indításakor a Postgres régi verziója nem törlődik, amíg az új szinkronizálás be nem fejeződik. A frissítés során a két verzió ideiglenesen beleszámít a logikai adatbázis méretkvótába.
- Táblák forrásonként: Egyetlen forrástábla legfeljebb 20 szinkronizált táblával rendelkezhet.
-
Elnevezési követelmények: Az adatbázis-, séma- és táblanevek csak alfanumerikus karaktereket és aláhúzásjeleket (
[A-Za-z0-9_]+) tartalmazhatnak. - Forrásazonosító útmutató: Kerülje a nagybetűk vagy speciális karakterek használatát az oszlop- vagy táblanevekben a unity katalógus forrástáblájában. Ha megtartja őket, ezeket az azonosítókat idéznie kell, amikor a Postgresben hivatkozik rájuk.
- Sémafejlődés: Csak az additív sémamódosítások (például oszlopok hozzáadása) támogatottak az aktivált és a folyamatos üzemmódok esetében.
- Tábladefiníció megváltoztatása: A szinkronizált tábla definíciójának frissítése nincs támogatott semmilyen interfészen keresztül (UI, SDK-k, CLI, REST API, Terraform vagy DAB-ok). Az elsődleges kulcs vagy idősor kulcs megváltoztatásához, vagy nem additív séma módosításához töröld a szinkronizált táblát, és hozz létre egy újat.
- Duplikált kulcsok: Ha két sor azonos elsődleges kulccsal rendelkezik a forrástáblában, a szinkronizálási folyamat meghiúsul, hacsak nem konfigurálja a deduplikációt időzókulcs használatával.
- API-idempotencia: A szinkronizált tábla API-k idempotensek, ezért próbálkozzon újra az átmeneti hibákkal az időben történő műveletek biztosítása érdekében.
- Frissítési sebesség: Lakebase esetében a szinkron pipeline támogatja a folyamatos és triggerelt írásokat körülbelül 150 sor/másodpercen kapacitásegységenként (CU), valamint a snapshot írásokat akár 2000 sor/másodpercenként.
Szinkronizált táblákon engedélyezett műveletek a Postgresben
Azure Databricks csak a következő műveleteket javasolja a Postgresben szinkronizált táblák esetében a véletlen felülírások vagy adatkonkonzisztenciák elkerülése érdekében:
- Írásvédett lekérdezések
- Indexek létrehozása
- A táblázat elvetése (a szinkronizált tábla Unity-katalógusból való eltávolítása után szabadítson fel helyet)
Bár a Szinkronizált táblák más módon is módosíthatók a Postgresben, ez zavarja a szinkronizálási folyamatot.
Tulajdonjog és engedélyek
A szinkronizált táblákat nem a létrehozó felhasználó, hanem a belső databricks_writer_<dbid> szerepkör birtokolja, mert a szinkronizálási folyamat kezeli azt (lásd : Postgres-szerepkörök). A csak tulajdonosi parancsok, például a sorszintű biztonság konfigurálása, nem futtathatók közvetlenül szinkronizált táblákon.
Megjegyzés:
Ez kivétel az általános Postgres-szabály alól, ahol a saját maga által létrehozott objektumok a Azure Databricks identitás tulajdonában vannak, ha a bejelentkezése szerepkörként szerepel a Postgresben. A folyamat szinkronizált táblákat hoz létre az Ön nevében.
Hozzáférés a szinkronizált táblát létrehozó felhasználóhoz
Szinkronizált tábla létrehozásakor a Azure Databricks identitása automatikusan hozzáférést kap a használathoz. Nincs szükség databricks_superuser műveletre. Identitása a következő jogosultságokat kapja a szinkronizált táblában:
| Objektum | Kiváltságok | Alkalmazás célja |
|---|---|---|
| Szinkronizált tábla | \ |
A táblázat olvasása vagy törlése |
| Schema |
USAGE, CREATE |
Használja a sémát, és hozzon létre objektumokat, például indexeket |
Nincs jogosultsága a INSERT vagy a UPDATE elemhez. A pipeline kezeli a tábla adatait, ezért a közvetlen módosításokat a következő frissítés felülírja.
DELETE és TRUNCATE csak törölje a táblázatot. A következő frissítés újra feltölti a táblát a forrásból.
Ez a hozzáférés a szinkronizált táblára vonatkozó Unity Catalog-engedélyekből származik, és a Unity Catalogban van kezelve. A módosításhoz frissítse a felhasználó Unity Catalog-engedélyeit. Ezt nem lehet REVOKE közvetlenül Postgresben egy Azure Databricks-identitásból.
Megjegyzés:
Ez a hozzáférés a szinkronizált táblát létrehozó identitáshoz van kötve. A folyamat Run as identitásának módosítása nem rendeli hozzá újra a folyamatot. Ha másik tulajdonosi identitást szeretne használni, hozza létre újra a szinkronizált táblát azzal az identitással.
Szinkronizált táblahozzáférés kezelése
A szinkronizált tábla létrehozása után a szinkronizált táblázatot a databricks_superuser Postgresből olvashatja. A databricks_superuser rendelkezik pg_read_all_data, amely lehetővé teszi, hogy ez a szerepkör minden táblából beolvasható. Emellett rendelkezik pg_write_all_data jogosultsággal, amely lehetővé teszi, hogy ez a szerepkör minden táblába írhasson. Ez azt jelenti, hogy egy databricks_superuser szinkronizált táblába is írhat a Postgresben. A Lakebase támogatja ezt az írási viselkedést abban az esetben, ha sürgős módosításokat kell végrehajtania a céltáblában. Az Azure Databricks azonban inkább azt javasolja, hogy a javításokat a forrástáblában végezze el.
Ezeket
databricks_superusera jogosultságokat más felhasználóknak is megadhatja:GRANT USAGE ON SCHEMA synced_table_schema TO user;GRANT SELECT ON synced_table_name TO user;A
databricks_superuserjogosultságok visszavonhatók:REVOKE USAGE ON SCHEMA synced_table_schema FROM user;REVOKE {SELECT | INSERT | UPDATE | DELETE} ON synced_table_name FROM user;
Szinkronizált táblaműveletek kezelése
Kezelheti databricks_superuser , hogy mely felhasználók végezhetnek adott műveleteket egy szinkronizált táblán. A szinkronizált táblák támogatott műveletei a következők:
CREATE INDEXALTER INDEXDROP INDEXDROP TABLE
A rendszer minden más DDL-műveletet megtagad a szinkronizált táblák esetében.
Ha további felhasználóknak szeretné biztosítani ezeket a jogosultságokat, databricks_superuser először létre kell hoznia egy bővítményt a következőn databricks_auth:
CREATE EXTENSION IF NOT EXISTS databricks_auth;
databricks_superuser Ezután hozzáadhat egy felhasználót egy szinkronizált tábla kezeléséhez:
SELECT databricks_synced_table_add_manager('"synced_table_schema"."synced_table"'::regclass, '[user]');
Eltávolíthat databricks_superuser egy felhasználót a szinkronizált táblák kezeléséből:
SELECT databricks_synced_table_remove_manager('[table]', '[user]');
Az databricks_superuser összes vezetőt megtekintheti:
SELECT * FROM databricks_synced_table_managers;
Szinkronizált tábla törlése
Ha töröl egy szinkronizált táblát a Unity Catalogból, a megfelelő Postgres-táblát is törli.
UI
A Katalógusban keresse meg a szinkronizált táblát, kattintson a  menüre, és válassza a Törlés lehetőséget.
Python SDK
from databricks.sdk import WorkspaceClient

w = WorkspaceClient()

w.postgres.delete_synced_table("synced_tables/my-catalog.sales.orders").wait()
Java SDK
import com.databricks.sdk.WorkspaceClient;

WorkspaceClient w = new WorkspaceClient();

w.postgres().deleteSyncedTable("synced_tables/my-catalog.sales.orders").waitForCompletion();
göndörít
curl -X DELETE "https://your-workspace.cloud.databricks.com/api/2.0/postgres/synced_tables/my-catalog.sales.orders" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
Tudj meg többet
| tevékenység | Leírás |
|---|---|
| Projekt létrehozása | Lakebase-projekt beállítása |
| Csatlakozás az adatbázishoz | A Lakebase csatlakozási lehetőségeinek megismerése |
| Adatbázis regisztrálása a Unity Katalógusban | A Lakebase-adatok láthatóvá tétele a Unity Katalógusban egységes szabályozási és forrásközi lekérdezésekhez |
| Unity Catalog-integráció | Az irányítás és az engedélyek ismertetése |
Katalógusintegráció
- Katalógus duplikálása: Ha egy különálló adatbáziskatalógusként is regisztrált Postgres-adatbázist megcélzó standard katalógusban létrehoz egy szinkronizált táblát, a szinkronizált tábla megjelenik a Unity Katalógusban a standard és az adatbáziskatalógusok alatt is.
Egyéb lehetőségek
A nem Databricks-rendszerekbe való adat-szinkronizálásra vonatkozóan a Partner Connect fordított ETL-megoldások, mint például a Census vagy a Hightouch, nyújtanak megoldást.