Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A rugalmas feldolgozás (előzetes verzió) 50% kedvezményt biztosít a normál feldolgozáshoz képest olyan számítási feladatok esetében, amelyek lassabb válaszidőt és esetenként elérhetetlen erőforrásokat képesek elviselni. Egy adott Responses API- vagy Chat Completions API-kéréshez a Flex feldolgozást úgy választhatja ki, hogy a flex értékét service_tier értékre állítja.
Flex-feldolgozás használata neminteraktív és alacsonyabb prioritású munkákhoz, például modellértékelésekhez, adatbővítéshez, dokumentumelemzéshez és aszinkron alkalmazás-munkafolyamatokhoz. A késésre érzékeny vagy kapacitásérzékeny számítási feladatokhoz használja inkább a standard feldolgozást, a prioritás-feldolgozást vagy a kiosztott átviteli sebességet.
Important
A Flex-feldolgozás bevezetésével a beállított service_tierflex kérelmek csak akkor lesznek feldolgozva, ha a kiválasztott modell támogatja a Flex-feldolgozást. A nem támogatott modell HTTP 400-as hibát ad vissza invalid_request_error, és nem áll át Standard feldolgozásra. A rugalmas feldolgozás nem rendelkezik késési SLA-val vagy szolgáltatási SLA-val.
Prerequisites
Azure-előfizetés. Készíts egyet ingyen.
Egy Azure OpenAI-erőforrás egy támogatott modellel, amelyet a Global Standard üzembe helyezési típussal helyeznek üzembe.
Az erőforrásvégpont és egy API-kulcs vagy Microsoft Entra ID hitelesítő adatok. A cikkben szereplő példák a környezeti változóban
AZURE_OPENAI_API_KEYtárolt API-kulcsot használják.Olyan számítási feladat, amely képes elviselni a változó késést és az átmeneti erőforrás-elérhetetlen válaszokat.
Python 3.10-et vagy újabb verziót, valamint az OpenAI Python csomagot a Python példákhoz:
pip install --upgrade openai
Flex-kérelem küldése
Állítsa a(z) service_tier értékét flex értékre minden olyan kérésben, amelynek Flex-feldolgozást kell használnia. Az model érték a Azure modell üzembe helyezésének neve.
Python
Az alábbi példa egy Flex-kérést küld a Válaszok API használatával:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
A válasz tartalmazza a létrehozott elemzést és a kérést feldolgozó szolgáltatási szintet.
Referencia:Responses API
REST
Az alábbi példa ugyanezt a kérést közvetlenül a Válaszok API-nak küldi el:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Annak ellenőrzéséhez, hogy melyik réteg dolgozza fel a kérést, ellenőrizze a service_tier mezőt egy sikeres válaszban.
Referencia:Responses API REST-referencia
Feldolgozási lehetőség kiválasztása
A rugalmas, a standard és a prioritási feldolgozás szolgáltatásszint-választási lehetőségek az online API-kérésekhez. A Batch és a lefoglalt átviteli kapacitás külön telepítési és vásárlási lehetőségek.
| Lehetőség | A kijelölés menete | Késés és rendelkezésre állás | Költségmodell | Legjobb a számára |
|---|---|---|---|---|
| Rugalmas feldolgozás | Állítsa a kérelmi szintű service_tier értékét erre: flex. |
Változó késés. A kérelmek HTTP 429-et adhatnak vissza, ha a Flex-kapacitás nem érhető el. | 50% kedvezmény a standard tokendíjakhoz képest. A gyorsítótárazott tokenekre vonatkozó kedvezmények is érvényesek. | Értékelések, bővítés, offline elemzés és késéstűrő háttérmunka. |
| Normál feldolgozás | Állítsa a kérési szintű service_tier értékét erre: default, vagy használja a telepítéshez konfigurált Standard szintet. |
Ajánlott online feldolgozás általános számítási feladatokhoz. | Standard tokenenkénti díj. | Változó forgalmú fejlesztési, tesztelési és üzemi munkaterhelések. |
| Prioritás feldolgozása | Konfigurálja a prioritást a telepítésnél, vagy állítsa a kérési szintet service_tier értékre priority. |
Alacsonyabb és egyenletesebb latencia, meghatározott célértékkel a támogatott modellekhez. | Elsőbbségi tokenenkénti díj. | Késésre érzékeny online alkalmazások fenntartott kapacitásra vonatkozó kötelezettségvállalás nélkül. |
| Batch | Aszinkron kötegelt feladat elküldése Batch-telepítéshez. | Az eredmények várhatóan 24 órán belül elkészülnek. Nincs valós idejű késleltetési célérték. | Kedvezményes kötegdíj. | Nagy méretű offline feladatok, amelyek nem igényelnek azonnali választ. |
| Kiosztott átviteli sebesség | Hozzon létre egy kiépített üzembe helyezést, és vásároljon vagy foglaljon le kiosztott átviteli egységeket (PTU-kat). | Fenntartott kapacitás kiszámítható átviteli sebességgel és késéssel. | Óránkénti PTU-számlázás vagy Azure foglalás. | Nagy volumenű, üzletileg kritikus éles munkaterhelések. |
Válassza a Flex-feldolgozást, ha az alábbi feltételek teljesülnek:
- A számítási feladatok hosszabb és változó feldolgozási időt is képesek elviselni.
- A kiszámítható késéssel szemben az alacsonyabb költségeket részesíti előnyben.
- Az alkalmazás újra megpróbálhatja az átmeneti hibákat, vagy átirányíthatja a sikertelen kéréseket a Standard feldolgozáshoz.
- A kiválasztott modell- és kérelemkörnyezet támogatott.
Ne használja a Flex-feldolgozást, ha az alábbi feltételek bármelyike érvényes:
- Egy felhasználó interaktív választ vár.
- A kérésnek szigorú késési célon belül kell befejeződnie.
- Az alkalmazás nem tudja tolerálni vagy újrapróbálkozza az átmeneti HTTP 429-válaszokat.
- Fenntartott feldolgozási kapacitásra vagy kiszámítható átviteli sebességre van szükség.
A rugalmas feldolgozás a következő jellemzőkkel rendelkezik:
-
Kérelemszintű kiválasztás: Állítsa a(z)
service_tierértékétflexértékre minden olyan kérésben, amelynek Flex-feldolgozást kell használnia. - Nincs külön üzembe helyezés: Standard- és Flex-kérelmek küldése ugyanarra a globális standard üzemelő példányra, és válassza ki a réteget kérésenként.
- Támogatott API-k: Használja a Válasz API-t vagy a Csevegés befejezése API-t.
- Szinkron válasz: Az API-hívás szinkron marad, annak ellenére, hogy a számítási feladat végrehajtása hosszabb időt vehet igénybe. A rugalmas feldolgozás nem ugyanaz, mint a Batch API.
- Kapacitásfüggő rendelkezésre állás: A kérések HTTP 429-et adhatnak vissza, ha a Flex-kapacitás nem érhető el.
-
Nincs automatikus visszaállás a Standard módra: Az alkalmazásnak kifejezetten újra kell próbálkoznia úgy, hogy a(z)
service_tierértékétdefaultértékre állítja, ha a Standard feldolgozás elfogadható. - Megosztott kvóta: A Rugalmas és a Standard kérelmek a globális standard üzembe helyezéshez hozzárendelt kvótát használják.
- Ugyanaz a modell kimeneti minősége: A Flex ugyanazt a mögöttes modellt használja, mint a Standard. A feldolgozási szint nem a modell minőségét, hanem a késést, a rendelkezésre állást és az árat módosítja.
Note
A Flex bemeneti és kimeneti jogkivonatai 50% kedvezményt kapnak a megfelelő standard jogkivonat-arányokhoz képest. A jogosult, gyorsítótárazott bemeneti tokenekre is érvényes a gyorsítótárazott tokenekre vonatkozó kedvezmény. Az aktuális díjszabásért lásd Azure OpenAI-díjszabást.
Támogatott modellek áttekintése
A Flex-feldolgozás bevezetésekor csak korlátozott számú modell érhető el.
gpt-5.6-sol az első támogatott modell. Az alábbi táblázat a támogatott modelleket sorolja fel. Microsoft további modelleket ad hozzá, amint a támogatás elérhetővé válik.
| Modell | Version | Üzembe helyezés típusa | Régiónkénti elérhetőség |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-6-sol |
2026-09-22 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-6-luna |
2026-09-22 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-6-astra |
2026-09-03 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-5.6-sol |
2026-07-09 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-5.6-luna |
2026-07-09 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
gpt-5.6-terra |
2026-07-09 |
Global Standard | Minden Azure régió, ahol a Global Standard elérhető |
Flex-kérés elküldése előtt ellenőrizze ezt a táblázatot. Ne feltételezzük, hogy egy modell vagy egy új modellverzió támogatja a Flex-feldolgozást, mert támogatja a standard vagy prioritásos feldolgozást. Egy nem támogatott modell HTTP 400-et ad vissza. Az alkalmazás megzavarásának elkerülése érdekében alkalmazásszintű tartalékot kell alkalmazni a Standard feldolgozásra, ha a standard díjszabás és a teljesítmény elfogadható.
Visszalépés a standard feldolgozásra
A Rugalmas feldolgozás nem irányítja át automatikusan a kérést a Standardra, ha a Rugalmas kapacitás nem áll rendelkezésre. Ha a kérés teljesítése fontosabb, mint a Flex díjszabásának megőrzése, próbálkozzon újra a kérés beállításával service_tierdefault.
Az alábbi példa egy befejezést előnyben részesítő szabályzatot használ. Először megkísérli a Flex feldolgozását, majd a HTTP 429-válaszok után újrapróbálkozásokat tesz a Standard feldolgozással:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
A Standardra való visszalépés megváltoztatja a kérelem díjszabását és teljesítményjellemzőit. Ezt a mintát csak akkor használja, ha a számítási feladat elfogadja a standard díjszabást.
A HTTP 429-válasz jelezheti a nem elérhető Flex-kapacitást vagy a kvótakorlátot. Mivel a Flex és a Standard feldolgozás közös kvótát használ, a Standard-kérés is meghiúsulhat, ha az eredeti választ a kvótakorlát okozta. Alkalmazzon újrapróbálkozási korlátokat, és kezeljen egy második RateLimitError elemet az alkalmazásában. Amikor a szolgáltatás visszaadja a Flex-specifikus hibaazonosítót, azzal korlátozhatja a kapacitással kapcsolatos válaszokra való visszalépést.
A legalacsonyabb költséget előnyben részesítő munkaterhelések esetén a tartalék megoldásra váltás előtt próbálja újra a Flex-feldolgozást exponenciális késleltetéssel. A befejezési időt rangsoroló számítási feladatok esetében az első Flex-kapacitáshiba után térjen vissza a Standardra.
Referencia:RateLimitError
Flex-hibák kezelése
Az állandó kéréshibák megkülönböztetése az átmeneti kapacitáshibáktól.
| HTTP-állapot | Hiba | A probléma oka | Ajánlott kezelés |
|---|---|---|---|
| 400 | invalid_request_error |
A kiválasztott modell, modellverzió, környezet hossza, API vagy kéréskonfiguráció nem támogatja a Flex-feldolgozást. | Ne próbálkozzon újra ugyanazt a kérést változatlanul. Válasszon egy támogatott modellt vagy kontextushosszt, vagy próbálja újra úgy, hogy a(z) service_tier értékét kifejezetten default értékre állítja. |
| 408 | Kérés-időtúllépés | A kérés nem fejeződik be a konfigurált ügyfél- vagy szolgáltatás-időtúllépésen belül. A Rugalmas kérelmek hosszabb időt is igénybe vehetnek, mint a Standard kérések. | Használjon hosszabb ügyféloldali időkorlátot. Próbálkozzon újra a korlátozott exponenciális visszalépéssel. Ha a befejezési idő fontosabb, mint a Flex díjszabása, próbálkozzon újra a Standard használatával. |
| 429 | Az erőforrás nem érhető el, vagy a sebesség korlátozott | A rugalmas kapacitás átmenetileg nem érhető el, vagy a kérelem túllépte a vonatkozó sebességkorlátot. A rugalmas kapacitás előre meghatározható, ezért az ideiglenes elérhetetlenség nagyobb valószínűséggel van a csúcsidőben. | Ha a kérés túllépte a korlátot, növelje a Global Standard üzembe helyezés korlátját további kvóta hozzárendelésével. A Flex és a Standard megosztja ezt a kvótát. Ha az előfizetés nem rendelkezik elegendő kvótával egy nagy átviteli sebességű számítási feladathoz, kérjen kvótanövelést. Ha a Flex-kapacitás átmenetileg nem érhető el, próbálkozzon újra exponenciális visszalépéssel és véletlenszerű késleltetéssel, ütemezze a késleltetést tűrő feladatokat csúcsidőn kívüli időszakokra, például hétköznap éjszakára vagy hétvégére, vagy próbálkozzon újra úgy, hogy a(z) service_tier értékét default értékre állítja. Vegye figyelembe a(z) Retry-After elemet, ha jelen van. |
| 500, 502, 503 vagy 504 | Átmeneti szolgáltatáshiba | Egy ideiglenes szolgáltatással vagy átjáróval kapcsolatos probléma megakadályozta a befejezést. | Próbálkozzon újra a korlátozott exponenciális visszalépéssel. Ne küldjön korlátlan számú újrapróbálkozást. |
| 401 vagy 403 | Hitelesítési vagy engedélyezési hiba | A hitelesítő adatok hiányoznak, érvénytelenek, lejártak, vagy nem rendelkeznek hozzáféréssel az erőforráshoz. | Javítsa ki a hitelesítő adatokat vagy a szerepkör-hozzárendelést. Ne próbálkozzon újra, amíg a konfiguráció nem változik. |
| 404 | Az üzembe helyezés nem lelhető fel | Az üzembe helyezés neve vagy végpontja helytelen. | Ellenőrizze, hogy egyezik-e model az üzembe helyezés nevével, és hogy az alap URL-cím a megfelelő Azure OpenAI-erőforrásra mutat-e. |
Note
Az a Flex-kérelem, amelyet a rendszer azért utasít el, mert nem áll rendelkezésre feldolgozási kapacitás, nem kerül kiszámlázásra. Előfordulhat azonban, hogy kisebb rendelkezésre álló sebességkorlát-kvótát tapasztal, mert a Flex- és a Standard-kérések a Global Standard-telepítéshez rendelt kvótán osztoznak.
Használjon exponenciális visszalépést véletlenszerű jitterrel a HTTP 408, 429 és átmeneti 5xx válaszokhoz. Állítsa be a maximális újrapróbálkozások számát és a maximális késleltetést, hogy a sikertelen kérések ne maradjanak kötetlen újrapróbálkozások ciklusában.
- Tartsa meg a(z)
Retry-Afterelemet, ha a válasz tartalmazza. - Ellenkező esetben várjon egy exponenciálisan növekvő késleltetést véletlenszerű jitterrel.
- Csak akkor próbálkozzon újra a Flexel, ha a késés elfogadható marad a számítási feladat számára.
- Ha az újrapróbálkozás költségvetése kimerült, és az alkalmazás lehetővé teszi a magasabb standard költséget, térjen vissza a Standardra.
- Adjon vissza explicit hibát, ha sem a késleltetett Flex-feldolgozás, sem a Standard tartalékmegoldás nem felel meg az alkalmazás követelményeinek.
Ne próbálkozzon újra újra ugyanazt a nem támogatott Flex-kérést. Az újrapróbálkozások csak a modell, a környezet hossza, az API-konfiguráció vagy a szolgáltatási szint módosítása után lesznek sikeresek.
Használat és költségek figyelése
Az Azure Monitor metrikáinak használatával hasonlítsa össze a Flex és a Standard forgalmát ugyanazon az üzembe helyezésen. Kövesse nyomon az alkalmazásában a kérések mennyiségét, a tokenfelhasználást, a késleltetést, a hibákat, valamint annak arányát, hogy a Flex-kérések milyen arányban váltanak vissza Standardra.
Jelentkezzen be a Azure portalra.
Nyissa meg a Azure OpenAI-erőforrást, és válassza a Metrikák lehetőséget.
Adja hozzá a Azure OpenAI-kérelmek metrikát. Hozzáadhat Azure OpenAI-késést, Azure OpenAI-használatot és hibametrikákat is.
Adjon hozzá egy szűrőt, amelyben a ServiceTierRequest egyenlő
flex.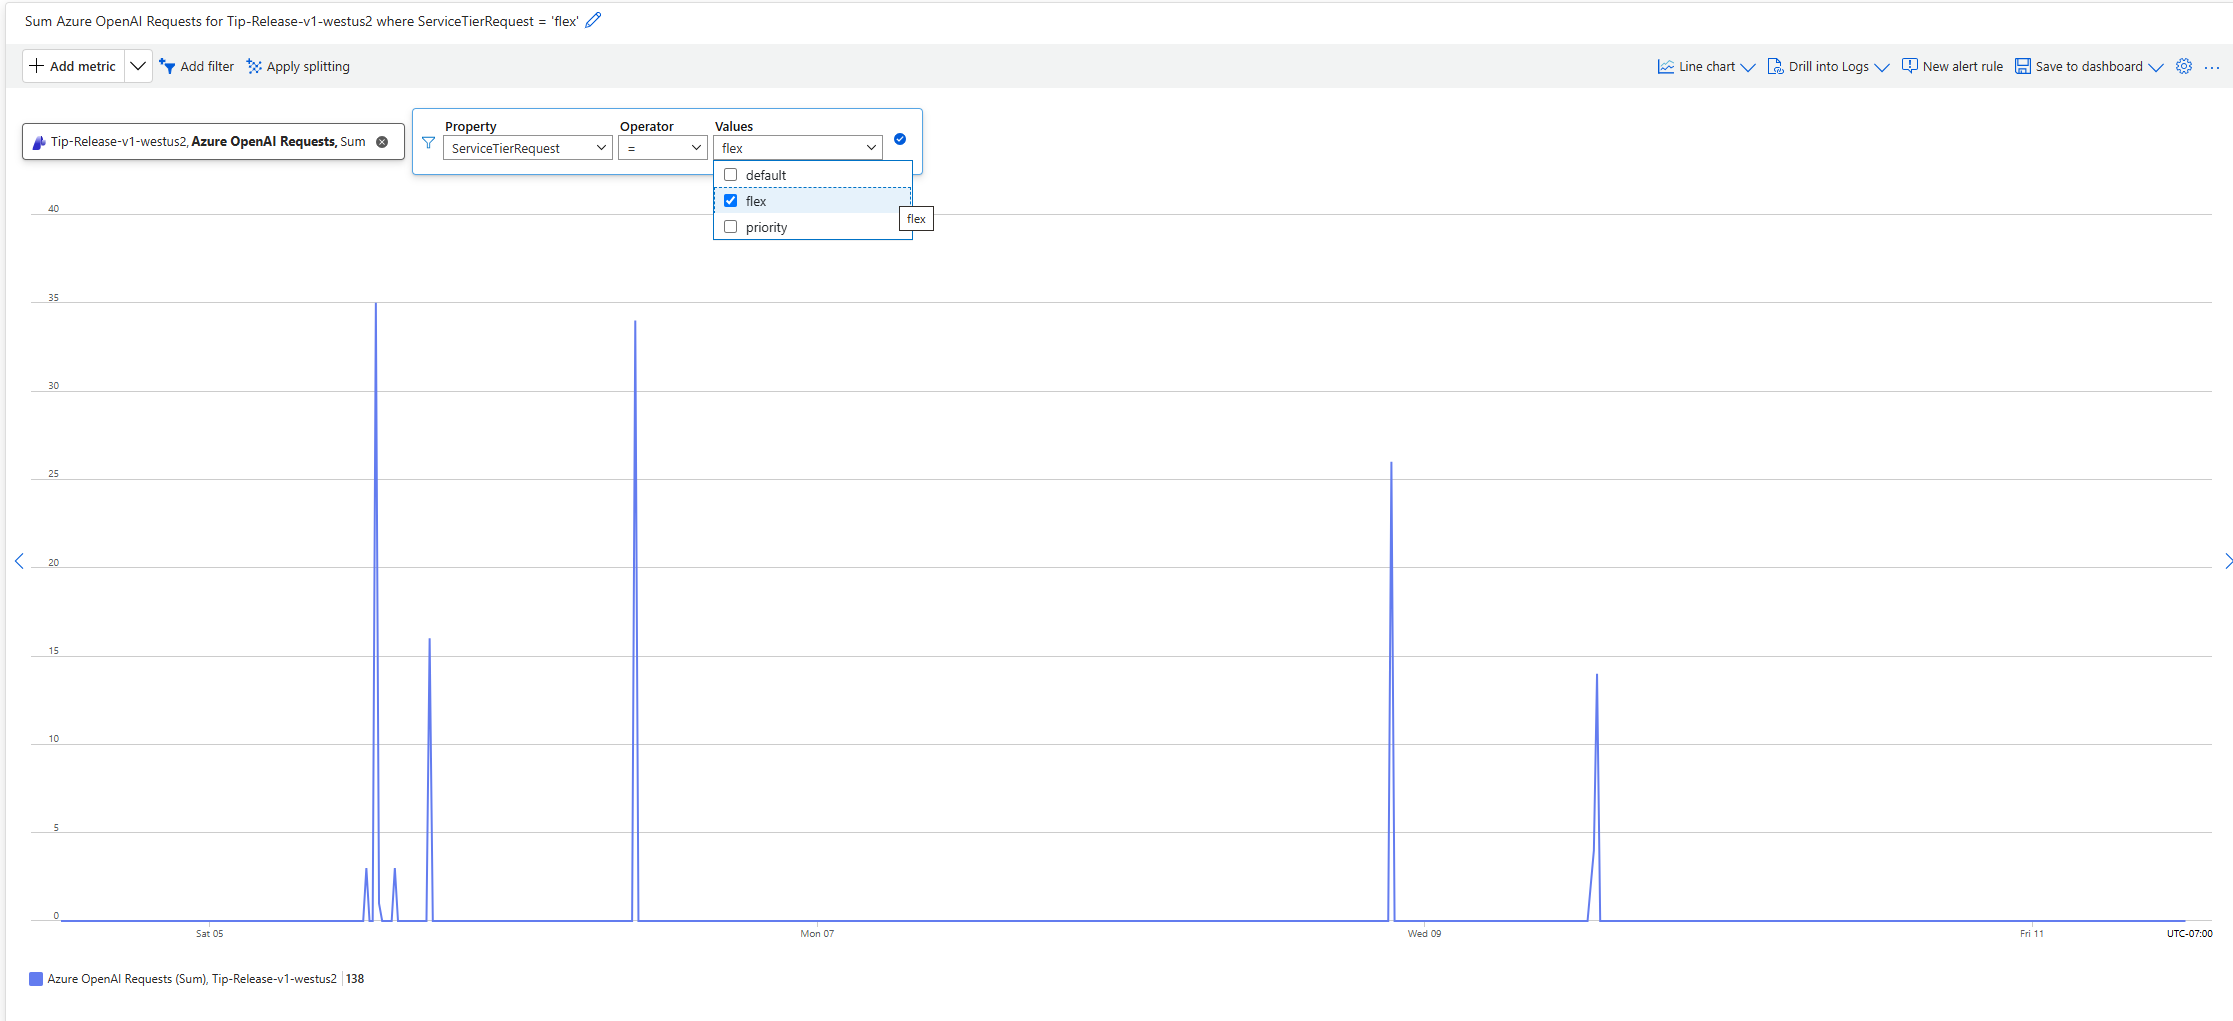
Riasztások létrehozása tartós HTTP 429-válaszokhoz, megnövekedett hibaarányokhoz és késéshez, amelyek túllépik a számítási feladat újrapróbálkozási költségvetését.
Kövesse nyomon a következő jeleket az egyes számítási feladatokhoz:
| Szignál | Miért fontos? |
|---|---|
| Flex kérelmek száma | Az alacsonyabb költségű feldolgozáshoz irányított bevezetést és forgalmat jeleníti meg. |
| A Flex-kérelmek sikeres aránya | Azt mutatja be, hogy a Flex-kapacitás milyen gyakran fogadja és teljesíti a kéréseket. |
| HTTP 429 sebesség | Azokat az időszakokat jeleníti meg, amikor a Rugalmas kapacitás vagy az üzembehelyezési kvóta korlátozott. |
| Alapértelmezett visszaállási szám és arány | Az alkalmazás által vezérelt visszaállás megbízhatósági előnyeit és többletköltségét jeleníti meg. |
| Bemeneti tokenek, gyorsítótárazott bemeneti tokenek és kimeneti tokenek | Támogatja a költség-hozzárendelést, és ellenőrzi a gyors gyorsítótárazás hatását. |
| Végpontok közötti késés | Segít meghatározni, hogy a számítási feladatok megfelelnek-e a Flexnek. |
HTTP 400 invalid_request_error darabszám |
Azonosítja a nem támogatott modelleket, modellverziókat, környezethosszokat vagy kéréskonfigurációkat. |
A modelltelepítések figyelésével kapcsolatos további információkért lásd: Monitor Azure OpenAI.
A Flex használata dedikált Flex-mérőkön kerül elszámolásra, így megkülönböztethető a Standard használattól. A Cost Analysis használatával áttekintheti a Flex-jogkivonat költségeit erőforrás és üzembe helyezés szerint.
- A Azure portálon nyissa meg a Cost Management + Billing>Cost Analysis szolgáltatást.
- Szűrjön az üzembe helyezést tartalmazó előfizetésre, erőforráscsoportra vagy Azure OpenAI-erőforrásra.
- Csoportosítson vagy szűrjön Meter szerint a Flex használatnak a Standard használattól való elkülönítéséhez.
- Adjon hozzá egy számlázási címkeszűrőt , válassza ki az üzembe helyezést, és válassza ki az üzembe helyezés nevét.
- Hasonlítsa össze a Rugalmas költségmegtakarítást a standard tartalék költségekkel és a számítási feladat teljesítési követelményeivel.
A Flex bemeneti és kimeneti tokenek ára a megfelelő Standard díjak 50%-a. A gyors gyorsítótárazás tovább csökkentheti a jogosult gyorsítótárazott bemeneti jogkivonatok költségeit. Az a Flex-kérelem, amelyet a rendszer azért utasít el, mert nem áll rendelkezésre feldolgozási kapacitás, nem kerül kiszámlázásra.
Alkalmazza az éles üzem bevált módszereit
- Állítson be hosszabb időkorlátot. A Rugalmas kérelmek hosszabb időt is igénybe vehetnek, mint a Standard kérések. Kezdje a munkaterhelésének megfelelő ügyféloldali időkorláttal, például 15 perccel, és tesztelje reprezentatív promptokkal.
- Használjon korlátozott számú újrapróbálkozást. Korlátozza az újrapróbálkozási kísérleteket és a teljes eltelt időt.
- Jitter hozzáadása. Véletlenszerűen szúrja be a visszalépési késéseket, hogy elkerülje a szinkronizált újrapróbálkozási csúcsokat.
- Tegye egyértelművé a tartalékmegoldást. Állítsa a(z)
service_tierértékét erre:default, ahelyett hogy implicit működésre hagyatkozna. - A feldolgozott szint nyomon követése. Rögzítse a válasz
service_tierértékét a késleltetési, állapot-, tokenfelhasználási és költségadatokkal. - Interaktív és háttérbeli forgalom elkülönítése. A felhasználói kérésekhez Standard, Priority vagy lefoglalt teljesítményt használjon, kivéve, ha elfogadható a Flex változó késleltetése.
- A duplikált munka szabályozása. Győződjön meg arról, hogy az alkalmazás nem küldi el többször ugyanazt a logikai feladatot az ügyféloldali időtúllépések után.
- A hibakezelési útvonalak tesztelése. Ellenőrizze a HTTP 400, 408, 429 és átmeneti 5xx válaszok kezelését, mielőtt rugalmas feldolgozást használ az éles munkafolyamatokban.
- Tekintse át a modelltámogatást a frissítések előtt. A helyettesítő modell vagy modellverzió nem örökli automatikusan a Flex-támogatást.
A szolgáltatási szint felülbírálása egy kérésfejléccel
A kérés fejlécét x-ms-service-tier akkor használja, ha egy átjárónak, proxynak vagy központosított útválasztási rétegnek ki kell választania a szolgáltatási szintet a kérelem törzsének vizsgálata vagy módosítása nélkül. A fejléc csökkentheti az áttelepítés során szükséges módosítások számát azon alkalmazások esetében, amelyek már egy kérésfejlécen keresztül választanak OpenAI-szolgáltatási szintet.
A fejléc a következő értékeket fogadja el:
| Fejléc értéke | Kért feldolgozási szint |
|---|---|
flex |
Flex |
priority |
Priority |
default |
Standard |
auto |
Priority |
Ha a fejléc jelen van és érvényes, elsőbbséget élvez a service_tier kérelem törzsében lévő értékkel szemben.
| Fejlécbeviteli mező | Törzsbemenet kérése | Viselkedés és kimenet |
|---|---|---|
| A fejléc hiányzik | Érvényes service_tier érték |
A kérelem törzse kiválasztja a szintet. A sikeres válasz a feldolgozott szintet a(z) service_tier elemben adja meg. |
| Érvényes fejlécérték | Bármely érték vagy kihagyás | A fejléc kiválasztja a kért szintet. A sikeres válasz a feldolgozott szintet a(z) service_tier elemben adja meg. |
| Nem támogatott fejlécérték | Bármely érték vagy kihagyás | A kérés HTTP 400-et ad vissza. A szolgáltatás nem a kérelem törzsében szereplő értéket használja tartalékként. |
Ez a példa a Flex-feldolgozást kéri a fejlécen keresztül. A fejléc felülírja a default kérelem törzsében lévő értéket:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
A felülbíráló fejléc nem biztosít automatikus tartalékmegoldást. Érvénytelen fejlécérték vagy olyan szint, amelyet a kijelölt üzemelő példány nem támogat, HTTP 400-et ad vissza.