Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Fontos
A nem angol nyelvű fordítások csak a kényelem érdekében érhetők el. A végleges verzióhoz tekintse meg EN-US a dokumentum verzióját .
Mi az az átláthatósági megjegyzés?
Az AI-rendszerek nem csak a technológiát, hanem a felhasználókat is magukban foglalják, a felhasználókat, akiket érint majd, és a környezet, amelyben üzembe helyezik. A célnak megfelelő rendszer létrehozásához ismerni kell a technológia működését, képességeit és korlátait, valamint a legjobb teljesítmény elérését.
Microsoft transparencia-megjegyzéseket nyújt, amelyek segítenek megérteni az AI-technológia működését. Ebbe beletartoznak azok a választási lehetőségek, amelyeket a rendszertulajdonosok tehetnek, amelyek befolyásolhatják a rendszer teljesítményét és viselkedését, valamint az egész rendszerre való gondolkodás fontosságát, beleértve a technológiát, az embereket és a környezetet. A saját rendszer fejlesztésekor vagy üzembe helyezésekor használhat átláthatósági megjegyzéseket, vagy megoszthatja őket azokkal a személyekkel, akiket a rendszer használni fog vagy érint.
Az átláthatósági megjegyzések a mesterséges intelligencia alapelveinek gyakorlati alkalmazásához Microsoft szélesebb körben tett erőfeszítések részét képezik. További információért tekintse meg Microsoft MI-alapelveit.
A dokumentumintelligencia alapjai
Bevezetés
A dokumentumintelligencia api-k készletén keresztül érhető el, és lehetővé teszi a fejlesztők számára, hogy egyszerűen kinyerjék a dokumentumaikból a szöveget, a struktúrát és a mezőket. Olyan funkciókból áll, mint:
- Szövegkinyeréshez olvassa el.
- Elrendezés és általános dokumentumok szerkezeti elemzésekhez, valamint általános ke-értékekhez és entitásokhoz, például nevekhez, helyekhez és dolgokhoz.
- Előre összeállított modellek adott dokumentumtípusokhoz, például számlákhoz, nyugtákhoz, névjegykártyákhoz, W2-khez és azonosítókhoz.
- Egyéni modellek a dokumentumtípusokhoz tartozó modellek létrehozásához.
A Dokumentumintelligencia egy vagy több nyelvet és területi beállításokat támogat az egyes funkciókhoz, a támogatott nyelvekről szóló cikkben leírtak szerint.
Kulcskifejezések
| Kifejezés | Meghatározás |
|---|---|
| Olvasni | Ez a funkció képekből és dokumentumokból kinyeri a szövegsorokat, szavakat és azok helyét, valamint egyéb információkat, például az észlelt nyelveket. |
| Elrendezés | Ez a funkció kinyeri a szöveget, a kijelölési jeleket és a táblázat szerkezetét (a szöveghez társított sor- és oszlopszámokat). Lásd : Dokumentumintelligencia-elrendezés. |
| Általános dokumentumok | Elemezheti a dokumentumokat, és értékeket társíthat a felderített táblák kulcsaihoz és bejegyzéseihez. További információt a Dokumentumintelligencia általános dokumentumai című témakörben talál. |
| Előre összeállított modellek | Az előre összeállított modellek az egyedi űrlaptípusok dokumentumspecifikus modelljei. Ezek a modellek használat előtt nem igényelnek egyéni betanítást. Az előre összeállított számlamodell például a számlákból kinyeri a kulcsmezőket. További információ: Dokumentumintelligencia előre összeállított számlamodell. |
| Egyéni modellek | A Dokumentumintelligencia lehetővé teszi az űrlapokra és dokumentumokra szabott egyéni modellek betanítása. Ez a modell kinyeri a szöveget, a kulcs-érték párokat, a kijelölési jeleket és a táblázatadatokat. Az egyéni modellek emberi visszajelzéssel fejleszthetők az emberi felülvizsgálat alkalmazásával, a címkék frissítésével és a modell API-val történő újratanításával. |
| Megbízhatósági érték | Az Elemzési eredmények lekérése művelet 0 és 1 közötti megbízhatósági értékeket ad vissza az összes kinyert szóhoz és kulcs-érték leképezéshez. Ez az érték azt jelzi, hogy a szolgáltatás hányszor nyeri ki helyesen a szót 100-ból, vagy megfelelően megfelelteti a kulcs-érték párokat. Egy olyan szó, amelyet becslések szerint az esetek 82%-ában helyesen kinyerhető, 0,82-es megbízhatósági értéket ad. |
| Bővítményfunkciók | A Dokumentumintelligencia számos bővítményfunkciót kínál az eredmények kibővítéséhez, hogy további elemeket is tartalmazzon a dokumentumokból. Egyes bővítményfunkciók többletköltséggel járnak, és a dokumentum kinyerésének forgatókönyvétől függően engedélyezhetők és letilthatók. Jelenleg nagyfelbontású képek, képletek, stílusbetűtípusok, vonalkódok, nyelvek, kulcsérték-párok és lekérdezési mezők kinyerési képességeit kínáljuk. További információ: Dokumentumintelligencia-bővítmények. |
Képességek
Rendszer viselkedése
Azure Dokumentumintelligencia az Öntödei eszközökben egy felhőalapú öntödei eszköz, amely optikai karakterfelismerés (OCR), Text Analytics és az Öntödei eszközökből származó egyéni szöveg használatával készült. Az egyéni modellek jelenleg Azure OpenAI szolgáltatás GPT-3.5-ös modelljét használják. Az OCR betűtípus- és kézzel írt szöveges dokumentumok kinyerésére szolgál. A Dokumentumintelligencia OCR használatával észleli és kinyeri az AI által támogatott űrlapokból és dokumentumokból származó információkat, hogy több struktúrát és információt biztosítson a szöveg kinyeréséhez.
Használati esetek
Tervezett felhasználások
A Dokumentumintelligencia olyan funkciókat tartalmaz, amelyek lehetővé teszik a különböző iparágakból származó ügyfelek számára, hogy adatokat nyerjenek ki a dokumentumaikból. A következő forgatókönyvek példák a megfelelő használati esetekre:
Fizetendő számlák: A vállalat az előre elkészített számlamodellek és egyéni űrlapok használatával hatékonyabbá teheti a számlaadat-bejegyzést emberi ellenőrzéssel. Az előre összeállított számlamodell kinyerheti a kulcsmezőket, például a számla végösszegét és a szállítási címet.
Biztosítási űrlap feldolgozása: Az ügyfél egyéni űrlapok használatával betanított modellekkel kinyerhet egy kulcs-érték párot a biztosítási űrlapokon, majd a folyamat pontosságának és hatékonyságának javítása érdekében az adatokat az üzleti folyamatba folyamozza. Egyedi űrlapjaikhoz az ügyfelek létrehozhatják saját modelljüket, amely az egyéni űrlapok használatával nyeri ki a legfontosabb értékeket. Ezek a kinyert értékek ezután végrehajtható adatokká válnak a vállalaton belüli különböző munkafolyamatokhoz.
Banki űrlapfeldolgozás: A bankok az előre összeállított azonosítómodell és egyéni űrlapok használatával felgyorsíthatják az "ügyfél megismerése" dokumentáció adatbevitelét, vagy felgyorsíthatják a jelzálogcsomagok adatbevitelét. Ha egy bank megköveteli ügyfelei számára, hogy személyes azonosítást küldjenek egy folyamat részeként, az előre összeállított azonosító modell képes kinyerni a kulcsértékeket, például a nevet és a dokumentumszámot, felgyorsítva az adatbevitel teljes idejét.
Robotfolyamat-automatizálás (RPA): Az egyéni kinyerési modell használatával az ügyfelek különböző típusú dokumentumokból nyerhetnek ki konkrét adatokat. A kinyert kulcs-érték pár ezután különböző rendszerekbe, például adatbázisokba vagy CRM-rendszerekbe is beírható az RPA-n keresztül, a manuális adatbevitel lecserélésével. Az ügyfelek egyéni besorolási modellel is kategorizálhatják a dokumentumokat a tartalmuk alapján, és megfelelő helyen helyezhetik el őket. Ezért az egyéni modellből kinyert rendszerezett adatkészlet alapvető első lépés lehet a nagy mennyiségű dokumentumot rendszeresen kezelő vállalkozások RPA-forgatókönyveinek dokumentálásához.
Egyéb használati esetek kiválasztásakor megfontolandó szempontok
A használati eset kiválasztásakor vegye figyelembe a következő tényezőket:
Körültekintően fontolja meg az emberi felülvizsgálat alkalmazását bizalmas adatok vagy forgatókönyvek esetén: Fontos, hogy egy ember is szerepeljen a hurokban a manuális felülvizsgálathoz, ha nagy tétű forgatókönyvekkel (például valaki következményi jogait érintő) vagy bizalmas adatokkal foglalkozik. A gépi tanulási modellek nem tökéletesek. Fontolja meg, hogy mikor érdemes manuális felülvizsgálati lépést megadni bizonyos munkafolyamatokhoz. Például a beléptetési kikötőben, például a repülőtereken végzett személyazonosság-ellenőrzésnek magában kell foglalnia az emberi felügyeletet.
Körültekintően vegye figyelembe az előnyök odaítélésére vagy elutasítására való használatot: a doc intelligence nem az előnyök odaítélésére vagy elutasítására lett tervezve vagy értékelve, és az ilyen helyzetekben való használat nem várt következményekkel járhat. Ezek a forgatókönyvek a következők:
- Orvosi biztosítás: Ebbe beletartozna az egészségügyi nyilvántartások és orvosi előírások használata a biztosítási jutalomra vagy megtagadásra vonatkozó döntések alapjául.
- Hiteljóváhagyások: Ide tartoznak az új hitelekre vagy a meglévők refinanszírozására vonatkozó kérelmek.
Gondosan vegye figyelembe a támogatott dokumentumtípusokat és területi beállításokat: Az előre összeállított modellek előre definiált listát tartalmaznak a támogatott mezőkről, és meghatározott területi beállításokhoz vannak létrehozva. A legjobb eredmény érdekében gondosan ellenőrizze a hivatalosan támogatott területi beállításokat és dokumentumtípusokat. Lásd például a Dokumentumintelligencia előre beállított nyugtaformátumait.
-
Jogi és szabályozási megfontolások: A szervezeteknek értékelnie kell a lehetséges konkrét jogi és szabályozási kötelezettségeket bármely Öntödei eszköz és megoldás használatakor, amely nem feltétlenül megfelelő minden iparágban vagy forgatókönyvben való használatra. Ezenkívül az Öntödei eszközöket vagy megoldásokat nem a vonatkozó szolgáltatási feltételekben és a vonatkozó magatartási kódexekben tiltott módon tervezték és nem használhatják.
Korlátozások
Technikai korlátozások, működési tényezők és tartományok
Előre összeállított modellre vonatkozó korlátozások
A Dokumentumintelligencia előre összeállított modelljei adott dokumentumtípusok feldolgozására szolgálnak, és több ezer űrlapon vannak előre betanolva. Ez a funkció lehetővé teszi a fejlesztők számára, hogy percek alatt megkezdődjenek és eredményekhez jussanak, betanítási adatok és címkézés nélkül. Az előre összeállított modellek esetében fontos megjegyezni a bemeneti követelmények listáját, a támogatott dokumentumtípusokat és a területi beállításokat az egyes előre összeállított modellekhez az optimális eredmények érdekében. Tekintse meg például az előre összeállított számlabeviteli követelményeket.
Egyéni modell korlátozásai
A Dokumentumintelligencia egyéni modelljei a saját betanítási adataidat használva képezhetők ki, így a modell az adott űrlapokhoz és dokumentumokhoz igazodik. Ez a képesség nagymértékben függ az adatok címkézésétől, valamint a megadott betanítási adatkészlet típusától. Egyéni modellek esetén fontos figyelembe venni a betanítási adatkészletek méretének, a dokumentumoldal korlátainak és az egyes dokumentumtípusokhoz szükséges minták minimális számának korlátait. Az egyéni modellek jelenleg Azure OpenAI Service GPT-3.5-ös modelljét használják. Az Azure OpenAI-modellekről további információt a Azure OpenAI átláthatósági megjegyzésében talál.
A Szolgáltatáskorlátok lap további információt tartalmaz a Dokumentumintelligencia szolgáltatás kvótáiról és az összes tarifacsomagra vonatkozó korlátozásokról. Emellett modellkorlátozásokat és ajánlott eljárásokat tartalmaz a modellhasználathoz és a kérések korlátozásának elkerüléséhez.
Funkciótámogatás
A Document Intelligence-modellek által elvégezhető különböző műveletek listáját az Analysis features (Elemzési funkciók) táblázat tartalmazza.
Rendszerteljesítmény
Pontosság
A szöveg alapszintű sorokból és szavakból, valamint olyan entitásokból áll, mint a nevek, az árak, az összegek, a vállalatnevek és a termékek a dokumentum megértési szintjén.
Word szintű pontosság
Az OCR egyik népszerű pontossági mértéke a szóhibaarány (WER), azaz hogy hány szó jelent meg hibásan a feldolgozott eredményekben. Minél alacsonyabb a WER, annál nagyobb a pontosság.
A WER a következőképpen van definiálva:
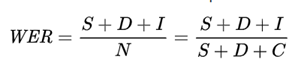
Ahol:
| Kifejezés | Meghatározás | Példa |
|---|---|---|
| S | Helytelen szavak ("helyettesítő") száma a kimenetben. | A "Velvet" úgy lesz észlelve, mint "Veivet", mert az "l" "i"-ként kerül észlelésre. |
| D | Hiányzó ("törölt") szavak száma a kimenetben. | A "Cégnév: Microsoft" szöveg esetében a Microsoft nem lesz kinyerve, mert kézzel írt vagy nehezen olvasható. |
| I | Nem létező ("beszúrt") szavak száma a kimenetben. | A "Department" helytelenül három szóra van szegmentálva, mint "Dep artm ent". Ebben az esetben az eredmény egy törölt szó és három beszúrt szó. |
| C | A kimenetben helyesen kinyert szavak száma. | Minden helyesen kinyert szó. |
| N | A hivatkozásban szereplő összes szó száma (N=S+D+C), kivéve az I-t, mert ezek a szavak hiányoznak az eredeti hivatkozásból, és helytelenül jelezték előre a jelen állapotot. | Tekintsünk egy képet a következő mondattal: "Microsoft, amelynek székhelye Redmond, WA, bejelentette egy Velvet nevű új termék piacra dobását a pénzügyi részlegek számára." Feltételezzük, hogy az OCR kimenete " , székhelye Redmond, WA bejelentette az új terméket Velvet a pénzügyi részlegek számára." Ebben az esetben S (Velvet) = 1, D (Microsoft) = 1, I (dep artm ents) = 3, C (11) és N = S + D + C = 13. Ezért a WER = (S + D + I) / N = 5 / 13 = 0,38 vagy 38% (a 100-ból). |
Megbízhatósági érték használata
A korábbi szakaszban leírtak szerint a szolgáltatás megbízhatósági értéket biztosít az OCR-kimenet minden előrejelzett szóhoz. Az ügyfelek ezt az értéket arra használják, hogy egyéni küszöbértékeket kalibráljanak a tartalmukhoz és a forgatókönyveikhez, hogy a tartalmat egyenesen feldolgozzák vagy továbbíthassák az emberi folyamatba. Az eredményként kapott mérések határozzák meg a forgatókönyv-specifikus pontosságot.
Az OCR rendszerteljesítmény-következményei az OCR-technológia alkalmazási forgatókönyveitől függően eltérőek lehetnek. Áttekintünk néhány példát, hogy szemléltetjük ezt a koncepciót.
- Orvosi eszközök megfelelősége: Ebben az első példában egy nemzetközi gyógyszeripari vállalatnak, amely számos szabadalmat, eszközt, gyógyszert és kezelést tartalmazó termékportfólióval rendelkezik, elemeznie kell az FDA-kompatibilis termékcímkék adatait és az elemzési eredmények dokumentumait. Előfordulhat, hogy a vállalat az alacsony megbízhatósági küszöböt részesíti előnyben az ember a folyamatba való bevonásához, mivel a helytelenül kinyert adatok költsége jelentős hatással lehet a fogyasztókra és a szabályozó ügynökségektől származó bírságokra.
- Kép- és dokumentumfeldolgozás: Ebben a második példában egy vállalat végzi a biztosítási és hiteligénylési kérelmek feldolgozását. Az OCR-t használó ügyfél előnyben részesítheti a közepes megbízhatósági érték küszöbértékét, mivel az automatizált szövegkinyerés más információbemenetekkel és az alkalmazások holisztikus áttekintéséhez szükséges emberi lépésekkel van kombinálva.
- Tartalommoderálás: A szállítóktól nagy mennyiségben importált e-kereskedelmi katalógusadatok nagy mennyisége esetén az ügyfél nagy pontosságú megbízhatósági érték küszöbértéket részesít előnyben, mert még a tévesen megjelölt tartalom kis százaléka is sok többletterhelést okozhat az emberi felülvizsgálati csapatok és beszállítók számára.
Dokumentum- és entitásszintű pontosság
A dokumentum szintjén például számla vagy nyugta esetén a teljes dokumentum egyetlen karakterének hibája jelentéktelen lehet. Ha azonban ez a hiba a kifizetett összeget ábrázoló szövegben szerepel, előfordulhat, hogy a teljes számla vagy nyugta helytelenként lesz megjelölve.
Egy másik hasznos metrika az entitáshibák aránya (EER). A helytelenül kinyert entitások (például nevek, árak, összegek és telefonszámok) százalékos aránya egy vagy több dokumentum megfelelő entitásainak teljes számából. Például összesen 30 10 nevet képviselő szó esetén a 30-ból 2 helytelen szó 0,06 (6%) WER-nek felel meg. Ha azonban a 10 névből 2 helytelen, akkor a név EER 0,20 (20%), ami sokkal magasabb, mint a WER.
A WER és az EER mérése hasznos gyakorlat a dokumentumok pontosságának teljes körű megismeréséhez.
Ajánlott eljárások a rendszer teljesítményének javításához
Vegye figyelembe a korlátozásokkal és a teljesítménnyel kapcsolatos alábbi szempontokat:
A szolgáltatás támogatja a képeket és a dokumentumokat. Az oldalak, a képméretek, a papírméretek és a fájlméretek megengedett korlátjaiért lásd : Mi az a dokumentumintelligencia?.
- Számos változó befolyásolhatja azon OCR-eredmények pontosságát, amelyektől a dokumentumintelligencia függ. Ezek a változók magukban foglalják a dokumentumvizsgálat minőségét, felbontását, kontrasztját, fényviszonyait, forgását és szöveges attribútumait, például a méretet, a színt és a sűrűséget. Javasoljuk például, hogy a kép legalább 50 x 50 képpont legyen. Tekintse meg a termék specifikációit, és tesztelje a szolgáltatást az ön dokumentumain, hogy ellenőrizze a helyzetnek való megfelelést.
- Figyelje meg az egyes szolgáltatásokra vonatkozó korlátozásokat a jelenleg támogatott bemenetekre, nyelvekre és területi beállításokra, valamint a dokumentumtípusokra vonatkozóan. Tekintse meg például az elrendezés által támogatott nyelveket.
Ajánlott eljárások az egyéni modell minőségének javításához
A Document Intelligence egyéni modell használatakor saját betanítási adatokat kell megadnia, hogy a modell betanítsa az adott űrlapokat és dokumentumokat. Az alábbi lista az egyéni űrlapmodell-típus használatával osztja meg a modellminőség javításához szükséges kezdőtippeket.
- A kitöltött űrlapok esetében olyan példákat használjon, amelyekben az összes mező ki van töltve.
- Olyan valós értékeket tartalmazó űrlapokat használjon, amelyeket az egyes mezőkhöz elvár.
- Ha az űrlapképek minősége alacsonyabb, használjon nagyobb adatkészletet (például legalább 10-15 képet).
A teljes útmutatót és bemeneti követelményeket az egyéni modell betanítási adatkészletének összeállítása című témakörben találja.
A dokumentumintelligencia kiértékelése
A dokumentumintelligencia teljesítménye attól függően változik, hogy milyen valós megoldásokat valósít meg. Az optimális teljesítmény biztosítása érdekében az ügyfeleknek saját értékeléseket kell végezniük. A szolgáltatás megbízhatósági értéket biztosít a 0 és 1 közötti tartományban minden kinyert szóhoz és kulcs-érték leképezéshez. Az ügyfeleknek próbaüzemet vagy koncepcióigazolást kell futtatniuk a használati esetüknek megfelelően, hogy megismerjék a megbízhatósági értékek tartományát és a dokumentumintelligencia kinyerési minőségét. Ezután meg tudják becsülni az eredmények megbízhatósági értékének küszöbértékét, hogy egyenes feldolgozásra (STP) küldjenek, vagy egy ember véleményezhesse őket. Az ügyfél például 0,80-nál nagyobb vagy egyenlő megbízhatósági értékekkel küldhet eredményeket az egyenes feldolgozáshoz, és emberi felülvizsgálatot alkalmazhat a 0,80-nál kisebb megbízhatósági értékekkel rendelkező eredményekre.
A dokumentumintelligencia kiértékelése és integrálása a használatra
Microsoft szeretne segíteni a Dokumentumintelligencia-t használó megoldások felelős fejlesztésében és üzembe helyezésében. Elvi megközelítést alkalmazunk annak érdekében, hogy fenntartsuk a személyes autonómiát és méltóságot, figyelembe véve az AI-rendszerek méltányosságát, megbízhatóságát és biztonságát, az adatvédelem és biztonság, a befogadás, az átláthatóság és az emberi elszámoltathatóság szempontjait. Ezek a szempontok összhangban vannak a felelős AI fejlesztése iránti elkötelezettségünkkel.
Amikor készen áll az AI-alapú termékek vagy szolgáltatások üzembe helyezésére, az alábbi tevékenységek segítenek a sikeres üzembe helyezésben:
A következő műveletek ismertetése: A dokumentumintelligencia képességeinek és korlátainak teljes körű felmérése. Ismerje meg, hogyan fog az adott forgatókönyvben és kontextusban teljesíteni. Ha például az előre összeállított számlamodellt használja, tesztelje az üzleti folyamatok valós számláit, hogy elemezze és mérje össze az eredményeket a meglévő folyamatmetrikáival.
A magánszemély magánélethez való jogának tiszteletben tartása: Csak jogszerű és igazolható célból gyűjtsön adatokat és információkat magánszemélyektől. Csak olyan adatokat és információkat használjon fel, amelyek használatához Ön hozzájárult.
Jogi felülvizsgálat: Szerezze be a megfelelő jogi felülvizsgálatot, különösen akkor, ha bizalmas vagy nagy kockázatú alkalmazásokban tervezi használni. Ismerje meg, hogy milyen korlátozásokon belül kell dolgoznia, és hogy milyen felelősséget kell vállalnia a jövőben felmerülő problémák megoldásáért.
Ember a folyamatban: Tartsa fenn az emberi jelenlétet a folyamat során, és építse be az emberi felügyeletet következetes mintázatként. Ez azt jelenti, hogy az AI-alapú termék vagy szolgáltatás folyamatos emberi felügyeletét, valamint az emberek döntéshozatali szerepének fenntartását kell biztosítani. Győződjön meg arról, hogy valós idejű emberi beavatkozást végezhet a megoldásban a károk megelőzése érdekében. Az emberi beavatkozás lehetővé teszi a helyzetek kezelését, amikor a dokumentum-intelligencia nem működik megfelelően.
Biztonsági: Győződjön meg arról, hogy a megoldás biztonságos, és hogy megfelelő vezérlőkkel rendelkezik a tartalom integritásának megőrzéséhez és a jogosulatlan hozzáférés megakadályozásához.
Javaslatok az adatvédelem megőrzésére
A sikeres adatvédelmi megközelítés lehetővé teszi az egyének számára az információk megadását, valamint vezérlőket és védelmet biztosít az adatvédelem megőrzéséhez.
- Ha a Dokumentumintelligencia egy személyazonosításra alkalmas adatok (PII) beépítésére tervezett megoldás része, alaposan gondolja át, hogy rögzíthetők-e az adatok, és hogyan. Kövesse az adatvédelemre és a bizalmas adatokra vonatkozó nemzeti és regionális előírásokat.
- Az adatvédelmi vezetőknek figyelembe kell venniük a kinyert szöveg és értékek megőrzési szabályzatait, valamint a dokumentumok alapjául szolgáló dokumentumokat vagy képeket. A megőrzési szabályzatok az egyes alkalmazások rendeltetéséhez lesznek kötve.
További információ a felelős AI-ről
- Microsoft MI-alapelvek
- Microsoft felelős AI-erőforrások
- Microsoft Azure tanfolyamok a felelős mesterséges intelligenciáról