Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
A Azure AI Keresés semantic ranker egy olyan funkció, amely mérhetően javítja a keresési relevanciát, ha Microsoft nyelvértési modelljeit használja a keresési eredmények újraírására. A szemantikai rangsorolót az agentikus lekérésbe is beépítették. Ez a cikk egy magas szintű bevezetés a szemantikai rangsoroló viselkedésének és előnyeinek megértéséhez.
A szemantikai rangsoroló egy prémium szolgáltatás, amelyet használat alapján számlázunk ki, de ingyenesen használhatja, az ingyenes szint szolgáltatási korlátainak függvényében. Ezt a cikket a háttérhez ajánljuk, de ha inkább az első lépéseket szeretné elvégezni, kövesse az alábbi lépéseket.
Mi az a szemantikai rangsor?
A szemantikai rangsoroló olyan lekérdezésoldali képességek gyűjteménye, amelyek javítják a szövegalapú lekérdezések, a vektoros lekérdezések szöveges része és a hibrid lekérdezések kezdeti BM25-rangsorolt vagy RRF-rangsorolt keresési eredményeinek minőségét. A szemantikai rangsorolás háromféleképpen bővíti a lekérdezés-végrehajtási folyamatot:
Először is mindig másodlagos rangsort ad hozzá egy kezdeti eredményhalmazhoz, amelyet a BM25 vagy a Reciprocal Rank Fusion (RRF) használatával pontoznak. Ez a másodlagos rangsor többnyelvű, mélytanulási modelleket használ, amelyek a Microsoft Bing technológiáján alapulnak a szemantikailag legrelevánsabb eredmények népszerűsítése érdekében.
Másodszor, visszaadja a feliratokat, és opcionálisan válaszokat nyer ki a válaszban, amelyeket megjeleníthet egy keresési oldalon a felhasználó keresési élményének javítása érdekében.
Harmadszor, ha engedélyezi a lekérdezés újraírását, az egy kezdeti lekérdezési sztringet több szemantikailag hasonló lekérdezési sztringre bontja ki.
A másodlagos rangsorolás és a "válaszok" a lekérdezési válaszra vonatkoznak. A lekérdezés újraírása a lekérdezési kérelem része.
A szemantikai rangsoroló a következő képességekkel rendelkezik:
| Képesség | Leírás |
|---|---|
| L2 rangsorolás | A lekérdezés kontextusát vagy szemantikai jelentését használja egy új relevanciapont kiszámításához az előre megadott eredményekhez. |
| Szemantikai feliratok és kiemelések | Szó szerinti mondatokat és kifejezéseket nyer ki olyan mezőkből, amelyek a legjobban összefoglalják a tartalmat, és kiemeli a főbb részeket a könnyű vizsgálat érdekében. Az eredményeket összegző feliratok akkor hasznosak, ha az egyes tartalommezők túl sűrűek a keresési eredmények oldalához. A kiemelt szöveg kiemeli a legrelevánsabb szavakat és kifejezéseket, hogy a felhasználók gyorsan megállapíthassák, miért tekintették relevánsnak a megfelelést. |
| Szemantikai válaszok | Egy szemantikai lekérdezésből visszaadott opcionális és extra alstruktúra. Közvetlen választ ad egy kérdésnek tűnő lekérdezésre. Megköveteli, hogy egy dokumentumnak a válasz jellemzőivel rendelkező szöveggel kell rendelkeznie. |
| Lekérdezés újraírása | A szöveges lekérdezések vagy a vektoros lekérdezések szöveges részének használatával a szemantikai rangsoroló a lekérdezés legfeljebb 10 variánsát hozza létre, esetleg kijavíthatja az elírásokat vagy a helyesírási hibákat, vagy újraformázhatja a lekérdezést a létrehozott szinonimák használatával. Az újraírt lekérdezés a keresőmotoron fut. Az eredményeket BM25 vagy RRF módszerrel értékeli, majd a szemantikai rangsoroló újraértékeli. |
A szemantikai rangsoroló működése
A szemantikai rangsoroló lekérdezést és eredményeket használ, majd elküldi őket a Microsoft által üzemeltetett nyelvértelmező modelleknek. Jobb találatokat keres.
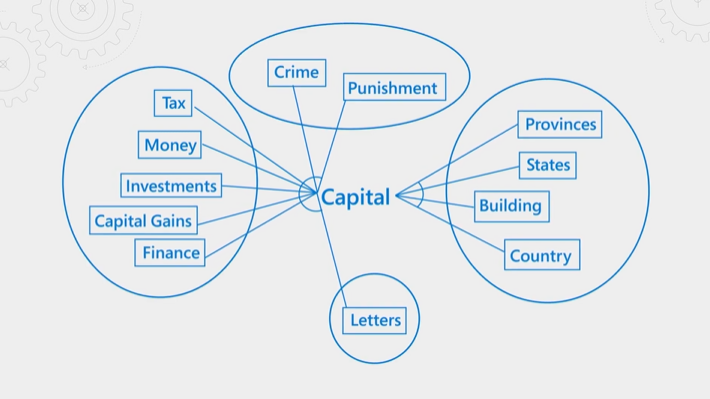
Az alábbi ábra a koncepciót ismerteti. Vegye figyelembe a "tőke" kifejezést. Különböző jelentéssel rendelkezik attól függően, hogy a kontextus pénzügyi, jogi, földrajzi vagy nyelvtani. A nyelvi megértés révén a szemantikai rangsoroló észleli a kontextust, és előlépteti a lekérdezési szándéknak megfelelő eredményeket.
A szemantikai rangsorolás sok erőforrást és időt használ. A lekérdezési művelet várt késésén belüli feldolgozás befejezéséhez a rendszer összevonja és csökkenti a szemantikai rangsoroló bemeneteit. Ez a megközelítés segít a lehető leggyorsabban végrehajtani az újrarankálási lépést.
A szemantikai rangsor három lépésből áll:
- Bemenetek gyűjtése és összegzése
- Pontozza az eredményeket a szemantikai rangsorolóval
- Újra értékelt eredmények, feliratok és válaszok kimenete
Hogyan gyűjti és összegzi a rendszer a bemeneteket?
A szemantikai rangsorolásban a lekérdezési alrendszer a keresési eredményeket adja át az összegzési és rangsorolási modellek bemeneteként. Mivel a rangsorolási modellek bemeneti méretkorlátokkal rendelkeznek, és intenzíven dolgoznak fel, a keresési eredményeknek méretezve és strukturálva kell lenniük (összegezve) a hatékony kezelés érdekében.
A szemantikai rangsoroló egy szöveges lekérdezésből származó BM25-rangsorolt eredménnyel kezdődik, vagy egy vektorból vagy hibrid lekérdezésből származó RRF-rangsorolt eredménnyel . Az újrangsorolási gyakorlat csak szöveget használ. Még akkor is, ha az eredmények több mint 50 találatot tartalmaznak, csak az első 50 találat halad a szemantikai rangsorolás felé. A szemantikai rangsorolás általában tájékoztató és leíró mezőket használ.
A keresési eredményekben található dokumentumok esetében az összegző modell legfeljebb 2000 tokent fogad el, ahol egy token körülbelül 10 karakterből áll. A modell a szemantikai konfigurációban felsorolt "cím", "kulcsszavak" és "tartalom" mezőkből állít össze bemeneteket.
A rendszer levágja a túlzottan hosszú karakterláncokat, hogy a teljes hossz megfeleljen az összefoglalási lépés bemeneti követelményeinek. Ez a vágási gyakorlat miatt fontos mezőket hozzáadni a szemantikai konfigurációhoz prioritási sorrendben. Ha nagyon nagy méretű dokumentumokat tartalmaz szöveges mezőkkel, a rendszer semmit sem hagy figyelmen kívül a maximális korlát után.
Szemantikai mező Tokenkorlát "cím" 128 token "kulcsszavak" 128 token tartalom fennmaradó tokenek Az összegző kimenet egy összegző szöveg minden dokumentumhoz, amely az egyes mezők legrelevánsabb információit tartalmazza. A rendszer összegző sztringeket küld a rangsorolónak a pontozáshoz, valamint a gépi olvasási szövegértési modelleknek a feliratokhoz és válaszokhoz.
2024 novemberétől a szemantikai rangsorolónak átadott generált összegző sztringek maximális hossza 2048 token. Korábban 256 token volt.
Az eredmények pontszámának ismertetése
A rendszer az eredményeket a felirat és az összefoglaló karakterlánc minden más tartalma alapján értékeli, amely kitölti a 2048 karakter hosszúságot.
A rendszer a megadott lekérdezéshez képest kiértékeli a feliratok fogalmi és szemantikai relevanciáját.
A rendszer egy @search.rerankerScore-t rendel minden dokumentumhoz a dokumentum szemantikai relevanciája alapján az adott lekérdezéshez. A pontszámok 4 és 0 között (magastól alacsonyig) terjednek, ahol a magasabb pontszám nagyobb relevanciát jelez.
Pontszám Jelentése 4.0 A dokumentum rendkívül releváns, és teljes mértékben megválaszolja a kérdést, bár a szakasz a kérdéstől független további szöveget tartalmazhat. 3.0 A dokumentum releváns, de nem tartalmaz olyan részleteket, amelyek teljessé tennék. 2.0 A dokumentum kissé releváns; részben vagy csak a kérdés bizonyos aspektusaira válaszol. 1.0 A dokumentum a kérdéshez kapcsolódik, és egy kis részét megválaszolja. 0.0 A dokumentum irreleváns. A rendszer pontszám szerint csökkenő sorrendben listázza az egyezéseket, és tartalmazza őket a lekérdezési válasz adatforgalmában. A hasznos adatok tartalmazzák a válaszokat, az egyszerű szöveget és a kiemelt feliratokat, valamint azokat a mezőket, amelyeket lekérdezhetőként jelölt meg, vagy amelyeket egy kijelölési záradékban megadott.
Megjegyzés
Bármely adott lekérdezés esetében a @search.rerankerScore eloszlása az infrastruktúra szintjén lévő feltételek miatt enyhe eltéréseket mutathat. A modellfrissítések rangsorolása hatással lehet a terjesztésre is. Ezen okok miatt, ha egyéni kódot ír a minimális küszöbértékekhez, vagy beállítja a vektoros és hibrid lekérdezések küszöbértéktulajdonságát , ne tegye túl részletessé a korlátokat.
Szemantikai rangsoroló kimenetei
Az összesítő sztringben a gépi olvasási szövegértési modellek a leginkább reprezentatív részeket találják meg.
A kimenetek a következők:
A dokumentum szemantikai felirata . Minden felirat egyszerű szöveges és kiemelt verzióban érhető el, és dokumentumonként gyakran kevesebb, mint 200 szó.
Nem kötelező szemantikai válasz, feltéve, hogy megadta a
answersparamétert, a lekérdezés kérdésként jelent meg, és egy szakasz található a hosszú sztringben, amely valószínűleg választ ad a kérdésre.
A feliratok és válaszok mindig szó szerinti szövegként jelennek meg az indexből. Ebben a munkafolyamatban nincs olyan generatív AI-modell, amely új tartalmat hoz létre vagy állít össze.
Szemantikai képességek és korlátozások
Mit tehet a szemantikai rangsoroló:
Az eredeti lekérdezés szándékához szemantikusan közelebb álló egyezések előléptetése.
Sztringek keresése, melyek feliratként és válaszként használhatók. A válasz feliratokat és válaszokat ad vissza, amelyeket megjeleníthet egy keresési eredményoldalon.
Amit a szemantikai rangsoroló nem tud elvégezni, az az, hogy újrafuttatja a lekérdezést a teljes korpuszon, hogy szemantikailag releváns eredményeket találjon. A szemantikai rangsorolás a meglévő eredményhalmazt irányítja át, amely az alapértelmezett rangsorolási algoritmus által elért 50 legjobb eredményből áll. Emellett a szemantikai rangsoroló nem tud új információkat vagy sztringeket létrehozni. A nyelvi modellek feliratokat és válaszokat nyernek ki a tartalomból, így ha az eredmények nem tartalmaznak válaszszerű szöveget, akkor nem hoznak létre egyet.
Bár a szemantikai rangsorolás nem minden esetben előnyös, bizonyos tartalmak jelentősen kihasználhatják képességeiket. A szemantikai rangsoroló nyelvi modelljei az információban gazdag és prózaként strukturált kereshető tartalmakon működnek a legjobban. A leíró tartalmakat tartalmazó tudásbázisok, online dokumentációk vagy dokumentumok a szemantikai rangsoroló képességek által nyújtott legnagyobb hasznot élvezhetik.
Az alapul szolgáló technológia a Bing és a Microsoft Research szolgáltatásból származik, és bővítményfunkcióként integrálva van a Azure AI Keresés infrastruktúrába. A szemantikai rangsoroló kutatásával és AI-befektetésekkel kapcsolatos további információkért lásd: Hogyan támogatja a Bing AI az Azure AI Keresés-et (Microsoft Research Blog).
Az alábbi videó áttekintést nyújt a képességekről.
A szemantikai rangsoroló szinonimatérképeket használ
Ha engedélyezi a keresési index egy mezőjéhez társított szinonimatérképek támogatását, és ezt a mezőt belefoglalja a szemantikai rangsoroló konfigurációjába, a szemantikai rangsoroló automatikusan alkalmazza a konfigurált szinonimákat az újraküldési folyamat során.
Rendelkezésre állás és díjszabás
A szemantikai rangsoroló egyes régiókban érhető el. Használható önálló funkcióként vagy az ügynöki lekérés beépített összetevőjeként. Minden funkció számlázása külön történik.
A szemantikus rangsoroló egy alapértelmezett ingyenes csomagot kínál havi ingyenes kérelemkerettel, valamint egy normál csomagot a használatalapú fizetéshez, miután az ingyenes keret kimerült. További információ: Szemantikai rangsoroló számlázásának engedélyezése vagy letiltása.
A szemantikai rangsorolóra vonatkozó költségek akkor merülnek fel, ha a lekérdezési kérések tartalmazzák queryType=semantic, és a keresési karakterlánc nem üres (például search=pet friendly hotels in New York). Ha a keresési sztring üres (search=*), akkor sem kell fizetnie, még akkor sem, ha a queryType szemantikai értékre van állítva.
Első lépések
(Nem kötelező) Váltson a normál számlázási csomagra az ingyenes havi kvótán túli használathoz.
Lekérdezések beállítása szemantikai feliratok és kiemelések visszaadásához.
(Nem kötelező) Szemantikai válaszokat ad vissza.