Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A Data Factory a Microsoft Fabricben segít megoldani az egyik legkeményebb kihívást: a szétszórt adatokat hasznos megállapításokká alakítani.
A szervezet adatai számos különböző helyen találhatók: adatbázisokban, fájlokban, felhőszolgáltatásokban és örökölt rendszerekben. Ez a változatosság megnehezíti, hogy teljes képet kapj az üzletedről. A Data Factory több mint 170 adatforráshoz csatlakozik, beleértve a többfelhős környezeteket és a hibrid beállításokat a helyszíni átjárókkal. Segítségével nagy léptékben helyezheti át és alakíthatja át az adatokat olyan formátumokká, amelyek jól használhatók elemzésekhez és döntéshozatalhoz.
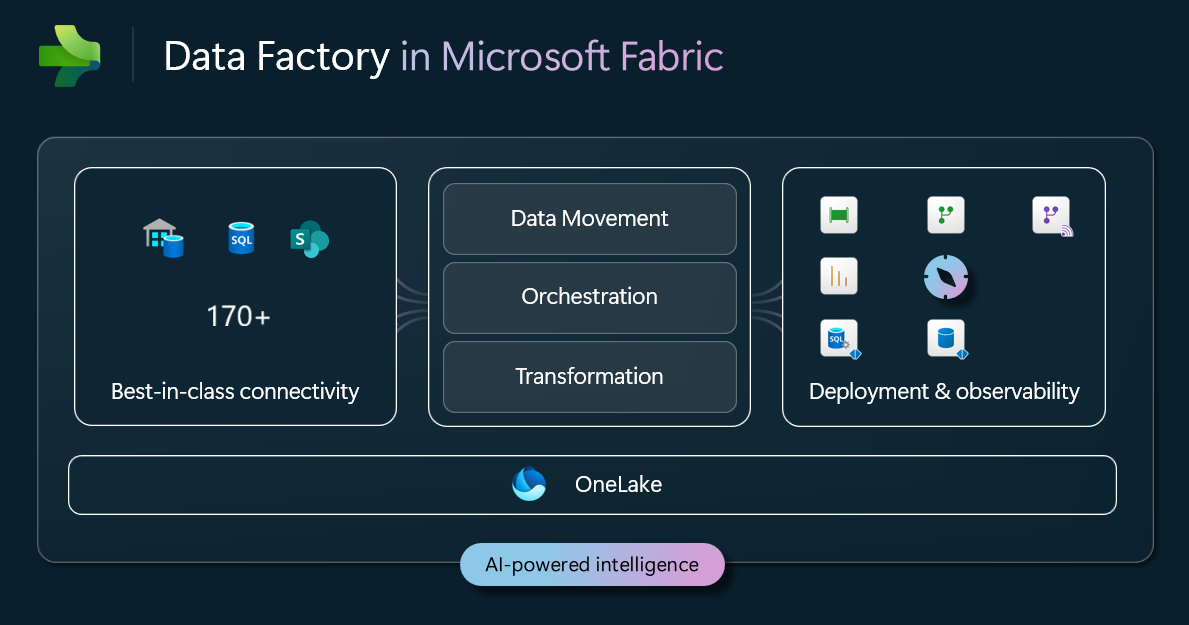
A Data Factory diagramja a Microsoft Fabricben, amely az adatáthelyezésen, vezénylésen és átalakításon keresztül a Fabric elemzési és adatfejlesztési eszközeihez kapcsolódó összekötőket mutatja be. Ez mind a Fabric OneLake tetején helyezkedik el, és az egész rendszert átszövi a mesterséges intelligencia alapú intelligencia.
Akár üzleti felhasználó vagy, aki az első adatanalitikai stratégiáját fejleszti, akár fejlesztőként, aki összetett munkafolyamokat dolgoz ki, megtalálod a megfelelő eszközöket, amelyek:
- Adatok összehozása
- Tisztítsd meg
- Készítse fel elemzésre a Lakehouse-ban vagy az Adattárházban
- Adat-munkafolyamatok automatizálása
Mi az adatintegráció?
Az adatintegráció a stratégiai adatok összekapcsolásának folyamata, amely lehetővé teszi az adatok elérését és elemzését. Ez minden olyan üzlet kulcsfontosságú része, amely adatvezérelt döntéseket szeretne hozni.
Az adatok számos módon integrálhatók, de az egyik leggyakoribb stratégia az ETL. Az ETL a kinyerés, átalakítás, betöltés rövidítése. Számos különböző forrásból származó információkat vesz fel, elemezhető formátummá alakítja át, és betölti egy közös célrendszerbe elemzés vagy jelentéskészítés céljából. Amikor ETL-folyamatot implementál a vállalat adatplatformján, az javítja az adatkonzisztenciát, a minőséget és az akadálymentességet.
Az egyes fázisok a következők:
- Kinyerés: Beolvassa az adatokat a forrásokból, és áthelyezi egy központi tárolóhelyre. A források lehetnek adatbázisok, fájlok, API-k, webhelyek stb.
- Átalakítás: Megtisztítja, bővíti és átalakítja az adatokat egy könnyen elemezhető formátumba. Előfordulhat például, hogy egy SQL-adatbázis értékesítési adatait szeretné összevetni a beolvasott, korábbi értékesítési dokumentumokkal. Az adatok kinyerése után minden forrásból át kell alakítania az adatokat, hogy az azonos formátumú legyen, ellenőrizze a sérüléseket vagy ismétlődéseket, és egyesítse az adatokat egyetlen adatkészletben.
- Betöltés: Az átalakított adatokat egy célrendszerbe, például adattárházba vagy data lake-be írja. A célrendszerben futtathat lekérdezéseket és jelentéseket az adatokon.
ETL vagy ELT?
Amikor adatokkal dolgozol, az számít, hogyan mozgaszol és alakítod át, és minden szervezetnek más igényei vannak. Például vegyük az ETL-t (Extract, Transform, Load) és az ELT (Extract, Load, Transform) jelleget. Minden módszernek megvannak az erősségei, amelyek a teljesítmény, skálázhatóság és költségek igényeitől függenek.
ETL: Alakítsa át az adatokat, mielőtt betöltené őket a célhelyre. Ez a módszer jól működik, amikor az adatokat tisztítani, szabványosítani vagy gazdagítani kell az adatok mozgása során. A Data Factory Adatfolyam Gen2 használatával például nagy léptékű átalakításokat alkalmazhat az adatok raktárba vagy Lakehouse-ba való betöltése előtt.
ELT: Először töltse be a nyers adatokat, majd alakítsa át a tárolási helyre. Ez a megközelítés olyan elemzési motorokat használ, mint a Fabric OneLake, a Spark Notebooks vagy az SQL-alapú eszközök. Az ELT jól működik a nagy adathalmazok modern, felhőalapú számítással történő kezeléséhez.
A Fabric Data Factory mindkettőt támogatja. Ön megteheti:
- Klasszikus ETL-folyamatok létrehozása az azonnali adatminőség és -felkészültség érdekében
- Az ELT-munkafolyamatok használatával kihasználhatja az integrált számítási és tárolási lehetőségeket a nagy léptékű átalakításokhoz
- Mindkét megközelítés kombinálása ugyanabban a megoldásban a rugalmasság érdekében
A Data Factory hatékony adatintegrációs megoldás
A Data Factory egy helyről csatlakozik az adatokhoz, áthelyezi, átalakítja és összehangolja az adatáthelyezési és átalakítási feladatokat. Ön dönti el, hogy melyik stratégia működik a legjobban az ön vállalkozása számára, és a Data Factory biztosítja az ehhez szükséges eszközöket.
Csatlakozás az adatokhoz: Akár a helyszínen, akár a felhőben, akár többfelhős környezetben, a Data Factory csatlakozik az adatforrásokhoz és a célhelyekhez. Számos adatforrást támogat, többek között adatbázisokat, adattavakat, fájlrendszereket, API-kat és egyebeket. A támogatott adatforrások és célhelyek teljes listájáért tekintse meg az elérhető összekötőket .
Adatok áthelyezése: A Data Factory számos módszert kínál az adatok forrásról célhelyre való áthelyezésére, illetve a meglévő adatokhoz való könnyű hozzáférést az igényeinek megfelelően.
- Másolási feladat – Előnyben részesített megoldás az egyszerűsített adatáthelyezéshez több kézbesítési stílus natív támogatásával, beleértve a tömeges másolást, a növekményes másolást és az adatrögzítés (CDC) replikációját. Emellett rugalmasságot kínál arra, hogy sokféle forgatókönyvet kezelj, sokféle forrástól sokféle célállomásig – mindezt intuitív, könnyen használható élmény révén.
- Másolási tevékenység – Az adatok áthelyezése egyik helyről a másikra bármilyen léptékben, széles körű testreszabással, számos forrás és cél támogatása, valamint a párhuzamos másolás manuális vezérlése a jobb teljesítmény érdekében.
- Tükrözés – Az üzemeltetési adatbázis közel valós idejű másolatának létrehozása a Microsoft Fabric OneLake-ben, az elemzés és a jelentéskészítés megkönnyítése érdekében.
Az adatáthelyezési döntési útmutató segítségével kiválaszthatja a forgatókönyvéhez megfelelő adatáthelyezési módszert.
Átalakítás: A Data Factory olyan tevékenységeket biztosít, amelyek összekapcsolják Önt az egyéni átalakítási szkriptekkel vagy a hatékony adatfolyam-tervezővel.
- Folyamattevékenységek – Fabric notebook, HDInsight-művelet, Spark feladatmeghatározás, tárolt eljárás, SQL-szkriptek stb. Ezek a tevékenységek lehetővé teszik egyéni kódok vagy szkriptek futtatását az adatok átalakításához.
- Adatfolyam Gen2 – Átalakíthatja az adatokat egy több mint 300 átalakítást tartalmazó, alacsony kódszámú felülettel. Illesztéseket, összesítéseket, adattisztítást, egyéni átalakításokat és sok mást is végrehajthat.
- dbt-feladat – A Microsoft Fabric adatbázis-feladata lehetővé teszi az SQL-alapú adatátalakításokat közvetlenül a Fabricben. Egyszerű, kód nélküli beállítást biztosítanak a dbt-modellek létrehozásához, teszteléséhez és üzembe helyezéséhez a Fabric-adattárház tetején.
Vezénylés: A Data Factory lehetővé teszi olyan folyamatok létrehozását, amelyek több adatmozgatást, átalakítást és egyéb tevékenységet futtathatnak egyetlen munkafolyamatban.
- Ütemezze a folyamatokat, hogy meghatározott időpontokban fussanak, vagy események alapján aktiválják őket.
- A folyamatok olyan vezérlési folyamatlogikát is tartalmazhatnak, mint a hurkok és a feltételes folyamatok, amelyek összetett munkafolyamatokat kezelnek, és az összes adatfeldolgozást egy egyszerű, alacsony kódszámú folyamattervező felhasználói felületén vezénylik.
- Ha inkább kódban szeretné kifejezni a vezénylési folyamatokat, a Fabric Data Factory integrálva van az Apache Airflow-ral, hogy DAG-kat hozzon létre a Python használatával történő vezényléshez.
MI-alapú adatintegráció
Az AI megjelenik a Data Factory-ben, hogy kevesebb erőfeszítéssel többet érj el. A Data Factory Copilot lehetővé teszi, hogy természetes nyelv segítségével tervezd, szerkesztheted és kezeld a pipeline-okat és adatfolyamokat. Beírhatja az egyszerű angol nyelvű utasításokat, és a Copilot munkaszintű ETL-lépésekké alakítja őket.
A Copilot a meglévő adatfolyam-lekérdezéseket és folyamatokat is összegzi, így gyorsan megértheti, hogy mit tesznek. Ha hibákba ütközik, a Copilot elmagyarázza, hogy mi történt, és javasolja a javítás módját.
További részletekért lásd: Copilot in Fabric a Data Factory számítási feladatban.
Mire van szüksége az első lépésekhez?
- Aktív előfizetéssel rendelkező Microsoft Fabric-bérlői fiók. Ha nem rendelkezik ilyen fiókkal, létrehozhat egy ingyenes fiókot.
- A Microsoft Fabric használatára engedélyezett munkaterület. Megtudhatja, hogyan hozhat létre munkaterületet.
Mi a teendő, ha már használja a Azure Data Factory?
A Data Factory a Microsoft Fabricben az Azure Data Factory következő generációja, amely a legösszetettebb adatintegrációs kihívások egyszerűbb megközelítéssel való kezelésére készült.
Tekintse meg a két szolgáltatás közötti főbb különbségeket ismertető összehasonlító útmutatót, hogy a vállalata számára megfelelő döntést hozhassa.
Ha készen áll a migrálásra, kövesse a Azure Data Factory és Azure Synapse folyamatok migrálási útmutatóját.
Mi az a Fabric Data Factory Pipeline SLA?
A Fabric pipeline-i SLA egyenértékű az Azure Data Factory pipeline-i SLA-val: "A Microsoft garantálja, hogy legalább 99,9 százalékban sikeresen feldolgozza a Data Factory erőforrásai elleni műveletek végrehajtására irányuló kéréseket. Azt is garantálja, hogy minden tevékenységi futtatás legalább 99,9 százalékban négy percen belül induljon a tervezett végrehajtási időktől. Olvasd el a teljes Data Factory szolgáltatási szintű megállapodást (SLA)."
Kapcsolódó tartalom
További információkért és a Microsoft Fabric használatának megkezdéséhez kövesse az alábbi útmutatókat:
- Irányított Data Factory-tesztkörnyezet – a Data Factory bemutatója a Fabricben
- Mihez csatlakozhat? - a Data Factory összes elérhető forrása és célja
- Végponttól végpontig Data Factory oktató – Kövesd ezt az útmutatót az egész ETL folyamaton, az adatfelvételtől az átalakításig és a célállomásba való betöltésig.