Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
A következőkre vonatkozik: SQL ServerAzure SQL DatabaseFelügyelt Azure SQL-példánySQL-adatbázis a Microsoft Fabricben
Az SQL Server adatbázismotor különböző adattárolási architektúrák lekérdezéseit dolgozza fel, például helyi táblákat, particionált táblákat és több kiszolgáló között elosztott táblákat. A következő részek bemutatják, hogyan dolgozza fel a Database Engine a lekérdezéseket, és hogyan optimalizálja a lekérdezések újrahasználatát a végrehajtási terv gyorsítótárázásán keresztül.
A cikkben szereplő kódminták a AdventureWorks2025, AdventureWorksDW2025, vagyis AdventureWorksLT2025 mintaadatbázist használják, amelyet letölthetsz az Azure Data SQL Samples Repository GitHub repository-jából.
Végrehajtási módok
A SQL Server adatbázismotor két különböző feldolgozási módon képes feldolgozni Transact-SQL (T-SQL) utasításokat:
- Soros üzemmód végrehajtása
- Kötegelt üzemmód végrehajtása
Soros üzemmód végrehajtása
Sor módú végrehajtás egy lekérdezésfeldolgozási módszer, amelyet sortároló tábláknál és indexeknél használnak, ahol az adatokat sorformátumban tárolják. Amikor egy lekérdezést végrehajtanak, és hozzáfér a sortároló táblákban és indexekben lévő adatokhoz, a végrehajtó fa operátorok és a gyermek operátorok minden szükséges sort olvasnak az objektumsémában megadott összes oszlopon keresztül. Minden olvasott sorból a Database Engine lekéri azokat az oszlopokat, amelyek az eredményhalmazhoz szükségesek, amelyekre egy SELECT utasítás, JOIN predikátum vagy szűrőpredikátum hivatkozik.
Megjegyzés:
A sormód végrehajtása nagyon hatékony OLTP forgatókönyvekben, de előfordulhat, hogy kevésbé hatékony nagy mennyiségű adat szkennelésekor, például Data Warehousing forgatókönyvekben.
Kötegelt üzemmód végrehajtása
A batch módú végrehajtás egy lekérdezésfeldolgozási módszer, amely több sort együtt dolgoz fel (innen ered a batch kifejezés). A köteg minden oszlopa vektorként van tárolva egy külön memóriaterületen, így a kötegelt mód feldolgozása vektoralapú. A kötegelt módú feldolgozás olyan algoritmusokat is használ, amelyek optimalizáltak a fejlett utasításkészletekre és a megnövelt memóriaátvitelre a modern processzorokban.
A kötegelt módú végrehajtást eredetileg a columnstore tárolóformátum köré integrálták és optimalizálták. Az SQL Server 2019-től (15.x) és az Azure SQL Database-ben a batch mód végrehajtása nem igényel columnstore indexeket. További információt a kötegelt üzemmódról a sor-tárolón talál.
A kötegelt módú feldolgozás tömörített adatokon működik, amikor lehetséges, és megszünteti azt az csereoperátort, amit a sormód végrehajtása használ. Az eredmény jobb párhuzamosság és gyorsabb teljesítmény.
Amikor egy lekérdezés batch módban fut és az oszloptároló indexekben lévő adatokhoz fér hozzá, a végrehajtó fa operátorok és a gyermek operátorok több sort együtt olvasnak oszlopszegmensekben. A Database Engine csak az eredményhez szükséges oszlopokat olvassa el, amelyekre egy SELECT utasítás, JOIN predikátum vagy szűrőpredikátum hivatkozik. További információért a columnstore indexekről lásd: Columnstore Index Architecture.
Megjegyzés:
A kötegelt módú végrehajtás nagyon hatékony adattárházi forgatókönyvekben, ahol nagy mennyiségű adatot tud olvasni és összesíteni.
SQL-utasítás feldolgozása
Egyetlen T-SQL utasítás feldolgozása a legegyszerűbb módja annak, hogy a Database Engine végrehajtsa a T-SQL utasításokat. Az alábbi lépések az alapvető folyamatot szemléltetik egy olyan SELECT utasítás feldolgozásával, amely csak helyi alaptáblákra hivatkozik (nézetek vagy távoli táblák nélkül).
Logikai operátorok elsőbbsége
Ha egy állításban több logikai operátort használunk, NOT kerül kiértékelésre először, majd AND, végül OR. Az aritmetikai és bitenkénti operátorokat a logikai operátorok előtt kezelik. További információért lásd: operátorprecedencia.
A következő példában a színfeltétel a 21-es termékmodellre vonatkozik, nem a 20-as termékmodellre, mert AND elsőbbséget élvez OR felett.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
A zárójelek használata, még akkor is, ha nem szükséges, javíthatja a lekérdezések olvashatóságát, és csökkentheti a hibázás esélyét az operátorprecedencia miatt. A következő példa olvashatóbb, mint az előző példa, és ugyanazt a jelentést viseli.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
A lekérdezés jelentésének megváltoztatásához zárójelek hozzáadásával kényszerítheti az OR első kiértékelését. Az alábbi lekérdezés csak a 20-21- és a 21-ik modellben lévő termékeket keresi meg, amelyek pirosak.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
SELECT utasítások optimalizálása
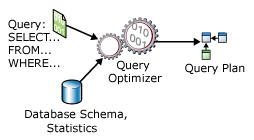
Az SELECT utasítás nem eljárási jellegű; nem tartalmazza azokat a lépéseket, amelyeket az adatbázis-kiszolgálónak a kért adatok lekéréséhez kell használnia. Ez a deklaratív viselkedés azt jelenti, hogy az adatbázis szervernek elemeznie kell az utasítást és az adatbázist, hogy meghatározza, mi a leghatékonyabb módja a kért adatok kinyerésének. Ezt a folyamatot lekérdezési terv optimalizálásának nevezik. Ezt a feladatot a Lekérdezési Optimalizáló végzi. A lekérdezésoptimalizáló bemenetét a lekérdezés, az adatbázisséma (objektumdefiníciók) és az objektumstatisztikák alkotják. A lekérdezésoptimalizáló kimenete egy lekérdezésvégrehajtási terv, amelyet néha lekérdezési tervnek vagy végrehajtási tervnek is neveznek. A végrehajtási terv tartalmát részletesebben leírjuk a Végrehajtási terv gyorsítótárázás és újrahasználat részében.
Az alábbi diagram szemlélteti a Query Optimizer bemeneteit és kimeneteit egyetlen SELECT utasítás optimalizálása során:
Egy SELECT állítás csak a következőket definiálja:
- Az eredményhalmaz formátuma. Ez többnyire a kiválasztási listában van megadva. Más záradékok, például
ORDER BYGROUP BYaz eredményhalmaz végső formájára is hatással vannak. - A forrásadatokat tartalmazó táblák. A
FROMzáradékban van megadva. - Hogyan kapcsolódnak a táblák logikailag az utasítás céljaihoz
SELECT. Ez a csatlakozási kifejezésben van definiálva, amely megjelenhet aWHEREklauzulában vagy aFROMutániONklauzulában. - Azok a feltételek, amelyeknek a forrástáblák sorainak meg kell felelniük ahhoz, hogy megfeleljenek az
SELECTutasításnak. Ezek vannak megadva aWHEREésHAVINGzáradékokban.
A lekérdezésvégrehajtási terv a következőket definiálja:
A forrástáblák elérésének sorrendje.
Általában az adatbázis-szerver sokféle sorrendben férhet hozzá az alaptáblákhoz, hogy felépítse az eredményhalmazt. Ha például az
SELECTutasítás három táblára hivatkozik, az adatbázis-kiszolgáló először hozzáférhetTableA, az adatokbólTableAkinyerheti az egyező sorokatTableB, majd az adatokbólTableBkinyerheti az adatokatTableC. A többi sorozat, amelyben az adatbázis-kiszolgáló hozzáférhet a táblákhoz, a következők:TableC,TableB,TableAvagy
TableB,TableA,TableCvagy
TableB,TableC,TableAvagy
\Az egyes táblák adatainak kinyerésére használt módszerek.
Általában különböző módszerek vannak az egyes táblák adatainak elérésére. Ha csak néhány sor szükséges bizonyos kulcsértékekkel, az adatbázis-szerver gyorsan meg tudja keresni a sorokat vagy egy kis indextartományt beolvasni. Ha a táblázat összes sora szükséges, az adatbázis-szerver képes átvizsgálni az egész táblát vagy indexet. Ha egy táblázat összes sora szükséges, de van egy index, amelynek kulcsoszlopai egy
ORDER BYrészét képezik, akkor a táblázatvizsgálat helyett végrehajtott indexvizsgálat elkerülhetővé teheti az eredményhalmaz külön rendezését. Ha egy tábla nagyon kicsi, a teljes beolvasás lehet a leghatékonyabb módszer a tábla szinte minden eléréséhez.A számítások kiszámításához használt módszerek, valamint az egyes táblák adatainak szűrése, összesítése és rendezése.
Amikor az adatokat táblázatokból érik el, különböző módszerek végeznek számításokat az adatokon, például skalárértékeket számítanak, valamint az adatokat összesítik és rendezik a lekérdezési szövegben meghatározott módon. Például egy
GROUP BYvagyWHEREzáradék használatakor, és hogyan szűrjük az adatokat, például egyHAVINGvagyORDER BYzáradék használatakor.
Egy végrehajtási terv potenciálisan sok lehetséges tervből való kiválasztásának folyamatát optimalizálásnak nevezzük. A Lekérdezésoptimalizáló az adatbázismotor egyik legfontosabb összetevője. Bár a lekérdezésoptimalizáló némi többletterheléssel jár a lekérdezés elemzése és egy terv kiválasztása során, ez a költség általában többszörösen megtérül, amikor a lekérdezésoptimalizáló hatékony végrehajtási tervet választ. Két építőipari vállalat például azonos tervrajzokat kaphat egy házhoz. Ha az egyik cég néhány napot tölt az elején a ház megépítésének megtervezésével, a másik pedig tervezés nélkül kezd építeni, akkor valószínűleg az a cég, amely időt szán a projekt megtervezésére, valószínűleg először fejezi be.
A Query Optimizer egy költségalapú optimalizáló. Minden lehetséges végrehajtási tervhez kapcsolódó költségek vannak a felhasznált számítási erőforrások mennyisége tekintetében. A Lekérdezésoptimalizálónak elemeznie kell a lehetséges terveket, és ki kell választania azt, amelyik a legalacsonyabb becsült költséggel jár. Néhány összetett állítás több ezer lehetséges végrehajtási tervvel rendelkezik. Ezekben az esetekben a Lekérdezésoptimalizáló nem elemzi az összes lehetséges kombinációt. Ehelyett összetett algoritmusokkal keres olyan végrehajtási tervet, amelynek költsége ésszerűen megközelíti a lehető legkisebb költséget.
A Lekérdezésoptimalizáló nem feltétlenül választja ki a legalacsonyabb becsült költségű végrehajtási tervet. Talál egy tervet ésszerű becsült költséggel az optimalizálásra rendelkezésre álló időn belül. Egy párhuzamos végrehajtási terv több erőforrást igényelhet, mint a sorozatos terv, miközben csökkenti a becsült eltelt időt.
Az SQL Server Query Optimizer statisztikákra támaszkodik, amikor megbecsüli a különböző módszerek erőforrás-költségeit egy táblából vagy indexből történő információ kinyerésére. Az oszlopokhoz és indexekhez statisztikákat tartanak fenn, és az alapul szolgáló adatok1 sűrűségéről tartalmaznak információkat. Ez az információ jelzi az adott indexben vagy oszlopban szereplő értékek szelektivitását. Az autókat ábrázoló táblázatban például sok autó ugyanazzal a gyártóval rendelkezik, de mindegyik autó egyedi járműazonosítóval (VIN) rendelkezik. A VIN indexe szelektívebb, mint a gyártó indexe, mivel a VIN sűrűsége alacsonyabb, mint a gyártóé. Ha az indexstatisztikák nem aktuálisak, előfordulhat, hogy a Lekérdezésoptimalizáló nem a legjobb választás a tábla aktuális állapotához. A sűrűségekről további információt a Statisztikák című témakörben talál.
1 A sűrűség az adatokban meglévő egyedi értékek eloszlását, vagy egy adott oszlop duplikált értékeinek átlagos számát határozza meg. A sűrűség csökkenésével az érték szelektivitása nő.
A Lekérdezésoptimalizáló azért fontos, mert lehetővé teszi az adatbázis szerver számára, hogy dinamikusan alkalmazkodjon az adatbázis változó feltételeihez fejlesztő vagy adatbázis-adminisztrátor bevonása nélkül. Ez a funkció lehetővé teszi a fejlesztők számára, hogy a lekérdezés végső eredményének leírására koncentráljanak. Bízhatnak a Query Optimizerben, hogy hatékony végrehajtási tervet készít az adatbázis állapotához minden alkalommal, amikor egy utasítás lekérdezési terve optimalizálásra kerül.
Megjegyzés:
Az SQL Server Management Studio háromféleképpen jelenítheti meg a végrehajtási terveket:
- A Becsült Végrehajtási Terv, amely a Query Optimizer által előállított összeállított terv.
- A tényleges végrehajtási terv, ami ugyanaz, mint a lefordított terv, plusz annak végrehajtási kontextusa. Ez a kontextus magában foglalja a futási idejű információkat is, amelyek a végrehajtás befejezése után elérhetők, például végrehajtási figyelmeztetések, vagy a Database Engine újabb verzióiban a végrehajtás során használt eltelt és CPU-időt.
- Az Live Query Statistics, ami ugyanaz, mint a lefordított terv, plusz annak végrehajtási kontextusa. Ez a kontextus tartalmazza a futási idejű információkat a végrehajtás során, és másodpercenként frissül. A futásidejű információk közé tartozik például az operátorokon áthaladó sorok tényleges száma.
SELECT utasítás feldolgozása
A Database Engine egyetlen SELECT utasítást az alábbi lépések követésével dolgozza fel:
- Az elemző megvizsgálja az
SELECTutasítást, és logikai egységekre bontja, például kulcsszavakra, kifejezésekre, operátorokra és azonosítókra. - Egy lekérdezésfa, amelyet néha szekvenciafának is neveznek, olyan logikai lépéseket ír le, amelyek szükségesek a forrásadatoknak az eredményhalmaz által előírt formátumba történő átalakításához.
- A Lekérdezésoptimalizáló elemzi a forrástáblákhoz való hozzáférés különböző módjait. Kiválasztja azokat a lépéseket, amelyek a leggyorsabban adják meg az eredményt, miközben kevesebb erőforrást használ. Frissíti a lekérdezési fát, hogy pontosan ezt a lépéssorozatot rögzítse. A lekérdezésfa végleges, optimalizált verzióját végrehajtási tervnek nevezzük.
- A relációs motor elkezdi végrehajtani a tervet. Ahogy az alaptáblákból származó adatokat igénylő lépéseket dolgozza fel, a szükséges sorhalmazokat kéri a tárolómotorból.
- A relációs motor feldolgozza a tárolómotorból visszaadott adatokat az eredményhalmazhoz meghatározott formátumba, és visszaadja az eredményhalmazt az ügyfélnek.
Konstans hajtogatás és kifejezés kiértékelése
Az adatbázismotor korai kiértékel néhány állandó kifejezést a lekérdezési teljesítmény javítása érdekében. Ez a Lekérdezésoptimalizáló által használt optimalizálási technika célja, hogy a kifejezéseket fordítási időben, nem pedig futásidőben egyszerűsítse. Ez magában foglalja az állandó kifejezések kiértékelését a lekérdezés-fordítás során, hogy az eredményül kapott végrehajtási terv hatékonyabb legyen. Ezt a folyamatot konstansösszevonásnak nevezik. Egy állandó egy T-SQL literális, például 3, 'ABC', '2025-12-31', 1.0e3, , vagy 0x12345678. Vegyük például ezt a lekérdezést:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Itt a 30 * 12 egy állandó kifejezés. A Database Engine ezt a kifejezést a kompilálás során értékeli, és belső módon újraírhatja a lekérdezést:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Összecsukható kifejezések
Az Database Engine konstansösszevonást alkalmaz a következő típusú kifejezésekkel:
- Olyan aritmetikai kifejezések, például
1 + 1és5 / 3 * 2, amelyek csak állandókat tartalmaznak. - Olyan logikai kifejezések, például
1 = 1és1 > 2 AND 3 > 4, amelyek csak állandókat tartalmaznak. - Beépített funkciók, amelyeket a Database Engine összevonhatónak tekint, beleértve a(z)
CASTésCONVERTelemeket. Általában egy belső függvény akkor hajtogatható, ha csak a bemeneteitől függ, és nem más kontextuális információktól, mint például aSETopciók, nyelvi beállítások, adatbázis-beállítások és titkosítási kulcsok. A nemdeterminisztikus függvények nem hajthatók össze. A determinisztikus beépített függvények összecsukhatók, néhány kivételtől eltekintve. - CLR felhasználó-definiált típusok determinisztikus módszerei és determinisztikus skáláárértékű CLR felhasználó által definiált függvények. További információkért lásd: CLR User-Defined függvények és metódusok konstans összevonása.
Megjegyzés:
A nagyméretű objektumtípusok kivételt képeznek. Ha az összehajtási folyamat kimeneti típusa egy nagy objektumtípus (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json vagy xml), akkor a Database Engine nem hajtja be a kifejezést.
Nem bontható kifejezések
Az összes többi kifejezéstípus nem összehajtható. A következő típusú kifejezések nem összevonhatók:
- Nem konkonzisztens kifejezések, például egy olyan kifejezés, amelynek eredménye egy oszlop értékétől függ.
- Olyan kifejezések, amelyek eredményei helyi változótól vagy paramétertől függenek, például
@x. - Nemdeterminista függvények.
- Felhasználó által definiált T-SQL függvények.
- Olyan kifejezések, amelyek eredményei a nyelvi beállításoktól függnek.
- Olyan kifejezések, amelyek eredményei a
SETlehetőségektől függnek. - Olyan kifejezések, amelyek eredményei a kiszolgáló konfigurációs beállításaitól függnek.
Példák összecsukható és nem cserélhető állandó kifejezésekre
Fontolja meg a következő lekérdezést:
Megjegyzés:
Az Azure SQL Database-ben és a Microsoft Fabric SQL-adatbázisában a USE utasítás nem érhető el. Ehelyett csatlakozz közvetlenül a tervezett adatbázishoz, és futtasd le a kódminta fennmaradó részét.
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Ha az PARAMETERIZATION adatbázisopció nincs FORCED értékre állítva ehhez a lekérdezéshez, akkor a(z) 117.00 + 1000.00 kifejezést a rendszer kiértékeli, majd az eredményére, 1117.00-ra cseréli, mielőtt a lekérdezést lefordítaná. A konstansösszevonás előnyei a következők:
- A kifejezést nem kell többször kiértékelni futásidőben.
- Az kifejezés értékét az értékelés után a lekérdezésoptimalizáló használja arra, hogy becslesse a lekérdezés
TotalDue > 117.00 + 1000.00azon részének eredményhalmazának méretét.
Másrészt, ha dbo.f egy felhasználó által definiált skaláris függvény, akkor a dbo.f(100) kifejezés nem kerül konstansként kiértékelésre, mert a Database Engine nem végez konstanskénti kiértékelést az olyan kifejezéseken, amelyek felhasználó által definiált függvényeket tartalmaznak, még akkor sem, ha azok determinisztikusak. További információért a paraméterezésről lásd: Kényszerített paraméterezés.
Kifejezés kiértékelése
Ezenkívül egyes kifejezések, amelyek nem állandó kihajtásúak, de amelyeket a fordítási időben ismert argumentumok befolyásolnak—függetlenül attól, hogy paraméterek vagy állandók—, az optimalizáló részét képező eredményhalmaz-méret (kardinalitás) becslő segítségével kerülnek kiértékelésre az optimalizálási folyamat során.
Pontosabban a következő beépített függvények és speciális operátorok kiértékelése fordításkor történik, ha az összes bemenet ismert: UPPER, , LOWER, RTRIM, DATEPART( YY only ), GETDATE, CASTés CONVERT. A következő operátorok fordításkor is kiértékelésre kerülnek, ha az összes bemenetük ismert:
- Számmetikai operátorok:
+,-,*,/, unáris- - Logikai operátorok:
AND,OR,NOT - Összehasonlító operátorok:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
A lekérdezésoptimalizáló nem értékel ki más függvényeket vagy operátorokat a számosság becslése során.
Példák a fordítási idő alatti kifejezések kiértékelésére
Fontolja meg ezt a tárolt eljárást:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Az eljárásban lévő SELECT utasítás optimalizálása során a Lekérdezésoptimalizáló megpróbálja kiértékelni a feltételhez OrderDate > @d + 1beállított eredménykészlet várt számosságát. A kifejezést @d + 1 nem hajtják össze konstansként, mert a @d egy paraméter. Az optimalizálási időben azonban a paraméter értéke ismert. Ez az érték lehetővé teszi a Lekérdezésoptimalizáló számára, hogy pontosan becslesse az eredményhalmaz méretét, ami segít egy jó lekérdezési tervet választani.
Most vegyünk egy, az előzőhöz hasonló példát, azzal a kivétellel, hogy a lekérdezésben egy helyi változó váltja fel a @d2 elemet, és a kifejezés kiértékelése nem a lekérdezésben, hanem egy @d + 1 utasításban történik.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Amikor a Database Engine-ben a MyProc2SELECT utasítás optimalizálásakor az @d2 értéke nem ismert. Ezért a Lekérdezésoptimalizáló alapértelmezett becslést használ a(z) OrderDate > @d2 szelektivitására (ebben az esetben 30 százalék).
Más nyilatkozatok feldolgozása
A SELECT utasítás feldolgozásának alapvető lépései más T-SQL utasításokra is vonatkoznak, például INSERT, UPDATE és DELETE. Mind a UPDATE, mind a DELETE utasításnak a módosítandó vagy törlendő sorok halmazára kell vonatkoznia. A sorok azonosításának folyamata ugyanaz a folyamat, amely az utasítás eredményhalmazához SELECT hozzájáruló forrássorok azonosítására szolgál. Mind a UPDATE, mind a INSERT utasítás tartalmazhat beágyazott SELECT utasításokat, amelyek megadják a frissítéshez vagy beillesztéshez szükséges értékeket.
Még az Adatdefiníciós Nyelv (DDL) utasítások is, mint CREATE PROCEDURE például vagy ALTER TABLE, egy sor relációs műveletre oldódnak a rendszerkatalógus táblákon, és néha (például ALTER TABLE ADD COLUMN) az adattáblákon.
Munkatáblák
A relációs motornak szüksége lehet egy munkatáblára egy T-SQL-utasításban meghatározott logikai művelet végrehajtásához. A munka-táblák belső táblázatok, amelyek köztes eredményeket tárolnak. A munkatáblák bizonyos GROUP BY, ORDER BYvagy UNION lekérdezésekhez jönnek létre. Például, ha egy ORDER BY klauzula olyan oszlopokra hivatkozik, amelyeket nem fed le semmilyen index, a relációs motornak lehet, hogy worktable-t kell generálnia, hogy az eredményhalmazt a kívánt sorrendbe rendezze. A munkatáblákat olyan várólistákként is használják, amelyek ideiglenesen egy lekérdezésterv egy részének végrehajtásának eredményét tartják. A munkatáblák a(z) tempdb-ban jönnek létre, majd automatikusan törlődnek, amikor már nincs rájuk szükség.
Felbontás megtekintése
A Database Engine lekérdezésfeldolgozója másképp kezeli az indexelt és nem indexelt nézeteket:
- Az adatbázis az indexelt nézet sorait ugyanabban a formátumban tárolja, mint egy tábla. Ha a lekérdezésoptimalizáló úgy dönt, hogy indexelt nézetet használ egy lekérdezési tervben, ugyanúgy kezeli az indexelt nézetet, mint egy alaptáblát.
- A rendszer csak a nem indexelt nézet definícióját tárolja, a nézet sorait nem. A Lekérdezésoptimalizáló a nézet definíciójának logikáját beépíti a végrehajtó tervbe, amelyet a nem indexelt nézetre hivatkozó T-SQL utasításhoz készít.
A Lekérdezésoptimalizáló az indexelt nézet használatának eldöntéséhez használt logikája hasonló ahhoz a logikához, amelyet egy tábla indexének használata eldöntéséhez használ. Ha az indexelt nézetben szereplő adatok lefedik a T-SQL utasítás egészét vagy részét, és a lekérdezésoptimalizáló megállapítja, hogy a nézeten lévő index az alacsony költségű hozzáférési útvonal, akkor az indexet választja annak megfelelően függetlenül attól, hogy a lekérdezés név szerint hivatkozik-e a nézetre.
Amikor egy T-SQL utasítás egy nem indexelt nézetre hivatkozik, a parser és a lekérdezésoptimalizáló elemzi mind a T-SQL utasítás, mind a nézet forrását, majd egyetlen végrehajtási tervvé alakítja őket. A T-SQL utasításnak és a nézetnek nincs külön végrehajtási terve.
Vegyük például a következő nézetet:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
E nézet alapján mindkét T-SQL állítás ugyanazokat a műveleteket végzi az alaptáblákon, és ugyanazokat az eredményeket adja:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
Az SQL Server Management Studio (SSMS) Showplan funkciója azt mutatja, hogy a relációs motor ugyanazt a végrehajtási tervet építi fel mindkét SELECT utasítás esetében.
Tippek használata nézetekkel
Ha egy lekérdezésben a nézetekre helyezel hinteket, azok ütközhetnek más hintekkel, amelyek akkor észlelhetők, amikor a nézet kitágul az alaptáblákhoz. Ha ez az ütközés bekövetkezik, a lekérdezés hibát ad vissza. Vegyük például az alábbi nézetet, amely a definíciójában egy táblázatos tippet tartalmaz:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Tegyük fel, hogy a következő lekérdezést adja meg:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
A lekérdezés meghiúsul, mert a Person.AddrState nézeten lévő SERIALIZABLE hint a nézet kibontásakor a nézetben lévő Person.Address és Person.StateProvince táblára is átterjed. A nézet kibontásával azonban a NOLOCK tipp is megjelenik a Person.Address-n. Mivel a SERIALIZABLE és a NOLOCK utasítások ütköznek, helytelen az eredményül kapott lekérdezés.
A TABLOCKX, READCOMMITTED, NOLOCK, REPEATABLEREAD és SERIALIZABLE táblázatjavaslatok ütköznek egymással, akárcsak a HOLDLOCK, TABLOCK, ROWLOCK, NOLOCK és PAGLOCK táblázatjavaslatok.
Az utalások beágyazott nézetek szintjein keresztül képesek propagálódni. Tegyük fel például, hogy egy lekérdezés egy HOLDLOCK nézetre alkalmazza a v1 utasítást. Ha a(z) v1-t kibővítjük, akkor látható, hogy ez a nézet v2 része a definíciójának.
v2 definíciója tartalmaz egy NOLOCK utalást az egyik alaptáblájára. Ez a tábla azonban a HOLDLOCK tippet örökli a v1 nézetre vonatkozó lekérdezésből. Mivel a NOLOCK és HOLDLOCK útmutatások ütköznek, a lekérdezés meghiúsul.
Amikor a FORCE ORDER tippet egy olyan lekérdezésben használod, amely egy nézetet tartalmaz, a nézet pozíciója a rendezett konstrukcióban határozza meg a táblák csatlakozási sorrendjét a nézeten belül. A következő lekérdezés például három táblából és egy nézetből választ:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
És View1 az alábbi példában látható módon van definiálva:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
A lekérdezési tervben az illesztés sorrendje: Table1, Table2, TableA, TableB, Table3.
Nézetek indexeinek megoldása
Mint bármely indexnél, a Database Engine csak akkor választja az indexelt nézetet a lekérdezési tervében, ha a Lekérdezésoptimalizáló úgy ítéli meg, hogy ez előnyös.
Bármely Database Engine kiadásban létrehozhatsz indexelt nézeteket. Néhány kiadásban a Lekérdezésoptimalizáló automatikusan figyelembe veszi az indexelt nézetet, míg más kiadásokban a NOEXPAND táblahintet kell használni. Az indexelt nézet automatikus használata a Query Optimizer által csak az SQL Server bizonyos kiadásaiban támogatott.
Megjegyzés:
Az Azure SQL Database és az Azure SQL Managed Instance támogatja az indexelt nézetek automatikus használatát a NOEXPAND tipp megadása nélkül.
A lekérdezésoptimalizáló indexelt nézetet használ, amikor az alábbi feltételek teljesülnek:
- Ezek a munkamenet-beállítások a következőkre
ONvannak beállítva:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- A
NUMERIC_ROUNDABORTsession opció értékeOFF. - A lekérdezésoptimalizáló talál egyezést a nézet index oszlopai és a lekérdezés elemei között, például:
- Keresési feltétel predikátumok a(z)
WHEREzáradékban - Csatlakozási műveletek
- Összesítő függvények
-
GROUP BYZáradékok - Táblahivatkozások
- Keresési feltétel predikátumok a(z)
- Az index használatának becsült költsége a lekérdezésoptimalizáló által figyelembe vett hozzáférési mechanizmusok legalacsonyabb költségével rendelkezik.
- A lekérdezésben hivatkozott minden táblának (akár közvetlenül, akár egy nézet kiterjesztésével az alapul szolgáló táblák eléréséhez) az indexelt nézetben lévő táblahivatkozásnak megfelelő táblával ugyanazt az utasításhalmazt kell alkalmazni a lekérdezésben.
Megjegyzés:
A READCOMMITTED tippek és READCOMMITTEDLOCK a tippek ebben a kontextusban mindig különböző tippeknek számítanak, függetlenül az aktuális tranzakcióelkülönítési szinttől.
A beállításokra és a SET táblamutatókra vonatkozó követelményeken kívül ezek ugyanazok a szabályok, amelyeket a Lekérdezésoptimalizáló használ annak meghatározására, hogy egy táblaindex lefedi-e a lekérdezést. Nem kell mást megadnod a lekérdezésben ahhoz, hogy a rendszer indexelt nézetet használjon.
A lekérdezésnek nem kell explicit módon hivatkoznia egy indexelt nézetre a FROM Lekérdezésoptimalizáló záradékában az indexelt nézet használatához. Ha a lekérdezés az indexelt nézetben is megtalálható alaptáblák oszlopaira mutató hivatkozásokat tartalmaz, és a Lekérdezésoptimalizáló úgy becsüli meg, hogy az indexelt nézetben a legalacsonyabb költségelérési mechanizmus érhető el, a Lekérdezésoptimalizáló az indexelt nézetet választja, hasonlóan ahhoz, ahogyan az alaptábla-indexeket választja, ha nem hivatkoznak rájuk közvetlenül egy lekérdezésben. A Lekérdezésoptimalizáló akkor választhatja a nézetet, ha az olyan oszlopokat tartalmaz, amelyekre a lekérdezés nem hivatkozik, feltéve, hogy a nézet a lekérdezésben megadott oszlopok egy vagy több oszlopának lefedésére a legkisebb költséggel járó lehetőséget kínálja.
A Lekérdezésoptimalizáló a záradékban FROM hivatkozott indexelt nézetet standard nézetként kezeli. A Lekérdezésoptimalizáló az optimalizálási folyamat elején kibontja a nézet definícióját a lekérdezésbe. Ezután végbemegy az indexelt nézetegyezés. Az indexelt nézet használható a Lekérdezésoptimalizáló által kiválasztott végső végrehajtási tervben, vagy ehelyett a terv a nézet által hivatkozott alaptáblák elérésével a szükséges adatokat is hasznosíthatja a nézetből. A Lekérdezésoptimalizáló a legalacsonyabb költségű alternatívát választja.
Javaslatok használata indexelt nézetekhez
A lekérdezési tipp használatával EXPAND VIEWS megakadályozhatja, hogy a nézetindexek egy lekérdezéshez legyenek használva, vagy a NOEXPAND táblamutatóval kényszerítheti az index használatát egy, a FROM lekérdezés záradékában megadott indexelt nézethez. Lehetővé kell azonban tenni, hogy a Lekérdezésoptimalizáló dinamikusan határozza meg az egyes lekérdezésekhez használandó legjobb hozzáférési módszereket. Korlátozza a EXPAND és NOEXPAND használatát azokra az esetekre, amikor a tesztelés kimutatta, hogy jelentősen javítják a teljesítményt.
A
EXPAND VIEWSbeállítás azt határozza meg, hogy a Lekérdezésoptimalizáló ne használjon nézetindexeket a teljes lekérdezéshez.Amikor egy nézethez megadod a
NOEXPANDelemet, a Lekérdezésoptimalizáló fontolóra veszi a nézeten meghatározott bármely index használatát.NOEXPANDa választhatóINDEX()záradékkal megadva a Lekérdezésoptimalizálót a megadott indexek használatára kényszeríti. Csak egy indexelt nézetre lehet megadniNOEXPAND, és nem indexelt nézetre nem lehet megadni. Az indexelt nézet automatikus használata a Query Optimizer által csak az SQL Server bizonyos kiadásaiban támogatott.Megjegyzés:
Az Azure SQL Database és az Azure SQL Managed Instance támogatja az indexelt nézetek automatikus használatát a
NOEXPANDtipp megadása nélkül.
Ha egy nézetet tartalmazó lekérdezésben sem NOEXPAND, sem EXPAND VIEWS nincs megadva, a nézet kibontásra kerül a mögöttes táblák eléréséhez. Ha a nézetet alkotó lekérdezés tartalmaz táblázatos tippeket, a rendszer propagálja ezeket a tippeket az alapul szolgáló táblákra. (Ezt a folyamatot részletesebben a View resolution oldalon magyarázzuk.) Ha a nézet mögöttes táblázatain található hint-ek halmaza azonos, a lekérdezés alkalmas indexelt nézethez igazításra. A legtöbb esetben ezek a tippek egyeznek, mert közvetlenül a nézetből öröklődnek. Ha azonban a lekérdezés nézetek helyett táblákra hivatkozik, és a közvetlenül ezeken a táblákon alkalmazott tippek nem azonosak, akkor az ilyen lekérdezések nem alkalmasak az indexelt nézetekkel való egyeztetésre. Ha a INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK, vagy XLOCK tippek a nézetbővítés után a lekérdezésben hivatkozott táblákra vonatkoznak, a lekérdezés nem jogosult indexelt nézetek illesztésére.
Ha egy INDEX ( index_val [ ,...n] ) alakú táblahivatkozás egy lekérdezés nézetére utal, és nem adja meg a NOEXPAND utasítást, a rendszer figyelmen kívül hagyja az indexrelációt. Egy adott index használatának megadásához használja a következőt NOEXPAND: .
Általában, amikor a Lekérdezésoptimalizáló egy indexelt nézetet párosít egy lekérdezéshez, a lekérdezésben a táblákon vagy nézeteken megadott tippeket közvetlenül az indexelt nézetre alkalmazza. Ha a lekérdezésoptimalizáló nem használja az indexelt nézetet, akkor a tippeket közvetlenül a nézetben hivatkozott táblákra terjeszti ki. További információért lásd: Felbontás megtekintése. Ez a propagálás nem vonatkozik az illesztési tippekre. A rendszer csak a lekérdezés eredeti helyén alkalmazza őket. A Lekérdezésoptimalizáló nem veszi figyelembe a csatlakozási tippeket, amikor a lekérdezéseket indexelt nézetekhez igazítja. Ha egy lekérdezésterv olyan indexelt nézetet használ, amely megfelel egy illesztésmutatót tartalmazó lekérdezés egy részének, akkor a rendszer nem használja az illesztésmutatót a tervben.
A tippek nem használhatók az indexelt nézetek definícióiban. Az Database Engine figyelmen kívül hagyja a tippeket az indexelt nézetdefiníciókban, amikor azokat karbantartja, vagy indexelt nézeteket használó lekérdezéseket futtat.
További információ: Táblázatjavaslatok.
Elosztott particionált nézetek feloldása
A Database Engine lekérdezésfeldolgozó optimalizálja az elosztott partíciós nézetek teljesítményét. Az elosztott particionált nézet teljesítményének legfontosabb szempontja a tagkiszolgálók között továbbított adatok mennyiségének minimalizálása.
Az Database Engine intelligens, dinamikus terveket készít, amelyek hatékonyan használják az elosztott lekérdezéseket a távoli tagtáblák adatainak eléréséhez:
- A lekérdezésfeldolgozó először az OLE DB használatával kéri le az ellenőrzőkényszer-definíciókat az egyes tagtáblákból. Ez a módszer lehetővé teszi a lekérdezésfeldolgozó számára, hogy leképezze a kulcsértékek eloszlását a tagtáblákban.
- A Lekérdezésfeldolgozó összehasonlítja a T-SQL utasítás
WHEREzáradékban megadott kulcstartományokat azzal a leképezéssel, amely megmutatja, hogyan oszlanak el a sorok a tagtáblákban. A lekérdezésfeldolgozó ezután egy lekérdezésvégrehajtási tervet épít, amely elosztott lekérdezéseket használ arra, hogy csak azokat a távoli sorokat tudja letölteni, amelyek a T-SQL utasítás teljesítéséhez szükségesek. A végrehajtási terv úgy van kialakítva, hogy a távoli tagtáblákhoz való hozzáférés, akár adatok, akár metaadatok esetében, késleltetve van, amíg az információ szükségessé nem válik.
Vegyük például azt a rendszert, amelyben a Customers rendszer egy táblát particionált a Server1 (CustomerID 1 és 3299999 között), a Server2 (CustomerID 3300000 és 6599999 közötti) és a Server3 (CustomerID 66000000 és 9999999 között).
Fontolja meg a Server1-en végrehajtott lekérdezéshez készült végrehajtási tervet:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
A lekérdezés végrehajtási terve kinyeri a 32000000 és 3299999 kulcsértékekkel rendelkező CustomerID sorokat a helyi tagtáblából, és elosztott lekérdezést ad ki a 3300000 és 3400000 közötti kulcsértékekkel rendelkező sorok lekéréséhez a Server2-ből.
A Database Engine Query Processor dinamikus logikát is beépíthet a lekérdezési végrehajtási tervekbe T-SQL utasításokhoz, amelyekben a kulcsértékek nem ismertek, amikor a tervet létre kell hozni. Vegyük például ezt a tárolt eljárást:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
A Database Engine nem tudja megjósolni, hogy a @CustomerIDParameter paraméter milyen kulcsértéket ad meg minden alkalommal, amikor az eljárás végrehajtódik. Mivel a kulcsértéket nem lehet megjósolni, a lekérdezésfeldolgozó sem tudja megjósolni, melyik tagtáblához kell hozzáférnie. Ennek kezelésére a Database Engine egy végrehajtási tervet épít, amely feltételes logikával, úgynevezett dinamikus szűrőkkel rendelkezik, hogy a bemeneti paraméter értéke alapján szabályozza, melyik tagtáblához fér hozzá a rendszer. Feltételezve, hogy a GetCustomer tárolt eljárást a Server1-en hajtották végre, a végrehajtási terv logikáját a következő kimenet szerint lehet megjeleníteni:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
A Database Engine néha ilyen típusú dinamikus végrehajtási terveket készít még paraméterezetlen lekérdezésekre is. A Lekérdezésoptimalizáló paraméterezni tudja a lekérdezést, hogy a végrehajtási terv újra felhasználható legyen. Ha a lekérdezésoptimalizáló paraméterezi a partíciós nézetre hivatkozó lekérdezést, akkor a lekérdezésoptimalizáló már nem feltételezheti, hogy a szükséges sorok egy meghatározott alaptáblából származnak. Ezután dinamikus szűrőket kell használnia a végrehajtási tervben.
Tárolt eljárás és eseményindító végrehajtása
A Database Engine csak a tárolt eljárások és triggerek forrását tárolja. A tárolt eljárás vagy eseményindító első végrehajtásakor a forrás egy végrehajtási tervbe lesz lefordítva. Ha a tárolt eljárást vagy eseményindítót ismét végrehajtja, mielőtt a végrehajtási terv elöregedik a memóriából, a relációs motor észleli a meglévő tervet, és újra felhasználja azt. Ha a terv kikerül a memóriából, új terv készül. Ez a folyamat hasonló ahhoz a folyamathoz, amelyet a Database Engine minden T-SQL-utasítás esetében követ. A tárolt eljárások és triggerek fő teljesítményelőnye a Database Engine esetében a dinamikus T-SQL adagokhoz képest, hogy a T-SQL utasításaik mindig ugyanazok. Ezért a relációs motor könnyen megfelel az összes meglévő végrehajtási tervnek. A tárolt eljárás- és triggercsomagok könnyen újra felhasználhatók.
A tárolt eljárások és eseményindítók végrehajtási tervét a rendszer a tárolt eljárást meghívó vagy az eseményindítót indító köteg végrehajtási tervétől elkülönítve hajtja végre. Ez a szétválasztás lehetővé teszi a tárolt eljárás és trigger végrehajtási tervek nagyobb újrahasznosítását.
Végrehajtási terv gyorsítótárazása és újrafelhasználása
A Database Engine memóriát használ mind a végrehajtási tervek, mind az adatpufferek tárolására. A végrehajtási tervekhez vagy adatpufferekhez elosztott memória százalékát dinamikusan állítják be, a rendszer állapotától függően. A memória azon része, amely végrehajtási terveket tárol, tervgyorsítótárnak nevezik.
Lekérdezési terv gyorsítótár-tárolói
A csomaggyorsítótár két tárolóval rendelkezik az összes lefordított csomaghoz:
- A Objektumtervek gyorsítótár-tárolója (OBJCP) a tartós objektumokhoz kapcsolódó tervekhez, például tárolt eljárásokhoz, függvényekhez és triggerekhez.
- Az SQL Plans gyorsítótár (SQLCP) az automatikusan paraméterezett, dinamikus vagy előkészített lekérdezésekhez kapcsolódó terveket tárolja.
Az alábbi lekérdezés információt nyújt e két gyorsítótár-tároló memóriahasználatáról:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
A lekérdezési terv gyorsítótárában két további tároló van, amelyek nem tárolnak végrehajtási terveket:
- A Bound Trees gyorsítótár-tároló (PHDR) a nézetekhez, korlátozásokhoz és alapértelmezésekhez tartozó tervek fordítása során használt adatstruktúrák gyorsítótára. Ezeket a szerkezeteket bound fáknak vagy algebrizer fáknak nevezik.
- Az Extended Stored Procedures gyorsítótár (XPROC), előre definiált rendszereljárásokhoz, mint például a sp_executesql vagy xp_cmdshell. Ezek a tárolt eljárások DLL-t használnak T-SQL utasítások helyett. A gyorsítótárazott struktúra csak a függvény nevét és annak a DLL-nek a nevét tartalmazza, amelyben az eljárás meg van valósítva.
Végrehajtási terv komponensei
A Database Engine végrehajtási tervei a következő fő összetevőkből állnak:
Lefordított végrehajtási terv (vagy lekérdezési terv)
A fordítási folyamat által létrehozott lekérdezési terv többnyire egy újra belépő, írásvédett adatstruktúra, amelyet tetszőleges számú felhasználó használ. A következő információk tárolására szolgál:
A logikai operátorok által leírt műveletet megvalósító fizikai operátorok.
Az operátorok sorrendje, amely meghatározza az adatok elérésének, szűrésének és összesítésének sorrendjét.
Az operátorok által feldolgozott becsült sorok száma.
Megjegyzés:
A lekérdezési terv információkat tárol a Kardinalitásbecsléshez használt statisztikai objektumokról is.
Milyen támogatási objektumokat kell létrehozni, például munkatáblákat vagy munkafájlokat a fájlban
tempdb.
A lekérdezési terv nem tárol semmilyen felhasználói kontextust vagy futtatóidejű információt. A Database Engine minden alkalommal meghatározza a munkaszálak számát, amikor lekér egy tervet a tervgyorsítótárból. Egy gyorsítótárazott párhuzamos terv soros módban is futhat.
Végrehajtási környezet
Minden felhasználó, aki jelenleg végrehajtja a lekérdezést, rendelkezik egy adatstruktúrával, amely tartalmazza a végrehajtásához specifikus adatokat, például paraméterértékeket. Ezt az adatstruktúrát végrehajtási kontextusnak nevezik. A végrehajtási környezet adatstruktúrái újra felhasználhatók, de a tartalmaik nem. Ha egy másik felhasználó ugyanazt a lekérdezést hajtja végre, az adatstruktúrák újrainicializálódnak az új felhasználó környezetével.
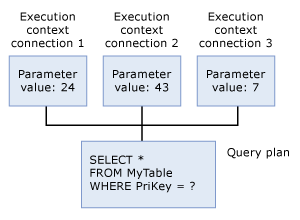
Tervek újbóli felhasználása azonos utasításokhoz
Amikor a Database Engine végrehajt bármilyen T-SQL utasítást, először átnézi a terv gyorsítótárát, hogy ellenőrizze, létezik-e végrehajtási terv ugyanahhoz a T-SQL utasításhoz. A T-SQL utasítás akkor minősül létezőnek, ha szó szerint pontosan megegyezik egy korábban lefuttatott, gyorsítótárazott tervvel rendelkező T-SQL utasítással, karakterről karakterre. A Database Engine minden meglévő végrehajtási tervet újrahasznosít, így megtakarítja a T-SQL állítás újrafordításának költségét. Ha nincs végrehajtási terv, a Database Engine új végrehajtási tervet generál a lekérdezéshez.
Megjegyzés:
A tervgyorsítótár nem őrzi meg tartósan a végrehajtási terveket bizonyos T-SQL utasításokhoz, például a sortárolón futó tömeges műveleti utasításokhoz vagy a nagy sztringliterálokat tartalmazó utasításokhoz. Ezek a tervek csak a lekérdezés futása alatt léteznek.
A Database Engine hatékony algoritmust használ, hogy megtalálja egy adott T-SQL utasításhoz tartozó meglévő végrehajtási terveket. A legtöbb rendszerben az a minimális erőforrás-mennyiség, amelyet ez a vizsgálat igényel, kisebb, mint az a megtakarított erőforrás-mennyiség, amely a meglévő tervek újrafelhasználásával érhető el minden egyes T-SQL-utasítás lefordítása helyett.
Az új T-SQL utasításoknak a tervgyorsítótárban lévő meglévő, nem használt végrehajtási tervekhez való illesztésére szolgáló algoritmusok megkövetelik, hogy minden objektumhivatkozás teljesen minősített legyen. Például tegyük fel, hogy ez Person az alapértelmezett séma a felhasználó számára, aki a következő SELECT utasításokat hajtja végre. Bár ez a példa nem követeli meg, hogy a Person táblát a végrehajtáshoz teljesen minősítve add meg, ez azt jelenti, hogy a második utasítás nem egyezik egy meglévő végrehajtási tervvel, de a harmadik utasítás igen:
Megjegyzés:
Az Azure SQL Database-ben és a Microsoft Fabric SQL-adatbázisában a USE utasítás nem érhető el. Ehelyett csatlakozz közvetlenül a tervezett adatbázishoz, és futtasd le a kódminta fennmaradó részét.
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Az alábbi SET beállítások bármelyikének módosítása egy adott végrehajtás esetén befolyásolja a tervek újrafelhasználásának lehetőségét, mivel a Database Engine konstanshajtogatást hajt végre, és ezek a beállítások befolyásolják az ilyen kifejezések eredményeit:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Több terv gyorsítótárazása ugyanazon lekérdezéshez
A lekérdezések és végrehajtási tervek egyedileg azonosíthatók az adatbázismotorban, hasonlóan az ujjlenyomathoz:
- A lekérdezési terv kivonata egy adott lekérdezés végrehajtási tervében kiszámított bináris kivonatérték, amely a hasonló végrehajtási tervek egyedi azonosítására szolgál.
- A lekérdezési hash egy bináris hash érték, amelyet egy lekérdezés T-SQL szövegén számítanak ki, és amelyet a lekérdezések egyedi azonosítására használnak.
A tervgyorsítótárból lekérheti a lefordított tervet egy plan handle segítségével. Ez az átmeneti azonosító csak addig marad állandó, amíg a terv a gyorstárban van. A tervleíró a teljes köteg lefordított tervéből származtatott kivonatérték. A lefordított terv azonosítója ugyanaz marad, még akkor is, ha a kötegben egy vagy több utasítást újrafordítanak.
Megjegyzés:
Ha egy batchhez fordítasz lekérdezési tervet egyetlen utasítás helyett, akkor a tervazonosítót és az utasításeltolásokat használhatod arra, hogy lekérd az egyes utasítások tervét a batchben.
A sys.dm_exec_requests DMV minden rekordhoz a statement_start_offset és statement_end_offset oszlopokat tartalmazza. Ezek az oszlopok egy jelenleg futó batch vagy persistant objektum éppen végrehajtott utasítására utalnak. További információért lásd: sys.dm_exec_requests.
A sys.dm_exec_query_stats DMV ezeket az oszlopokat is tartalmazza rekordonként. Ezek az oszlopok egy utasítás helyzetét jelölik egy tételben vagy perzisztens objektumban. További információért lásd: sys.dm_exec_query_stats.
A köteg tényleges T-SQL szövege a tervgyorsítótártól elkülönített külön memóriaterületen tárolódik, amelyet SQL Manager cache-nek (SQLMGR) neveznek. Az SQL Manager gyorsítótárából letöltheted a T-SQL szöveget egy lefordított tervhez SQL handle segítségével. Ez az átmeneti azonosító csak addig marad állandó, amíg legalább egy lekérdezési terv, amely hivatkozik rá, a lekérdezésiterv-gyorsítótárban marad. Az SQL handle egy hash érték, amely az egész tétel szövegéből származik, és garantáltan minden tételhez egyedi lesz.
Megjegyzés:
A lefordított tervhez hasonlóan a T-SQL szöveg is kötegenként tárolódik, beleértve a kommenteket is. Az SQL handle tartalmazza az egész batch szöveg MD5 hash-jét, és garantáltan egyedi minden köteg esetében.
Az alábbi lekérdezés információt nyújt az SQL Manager gyorsítótár memóriahasználatáról:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Az SQL handle és a plan handle-ek között egy-a-többhöz kapcsolat van. Ez az állapot akkor fordul elő, ha a lefordított tervek gyorsítótárkulcsa eltér. Ez a különbség az azonos köteg két futtatása közötti SET opciók változása miatt alakulhat ki.
Fontolja meg a következő tárolt eljárást:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Ellenőrizd, mit találsz a lekérdezési terv gyorsítótárában a következő lekérdezéssel:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Itt van az eredmények összessége.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Most a tárolt eljárást egy másik paraméterrel hajtsuk végre, további változtatások nélkül a végrehajtási kontextusban:
EXECUTE usp_SalesByCustomer 8;
GO
Ellenőrizd újra, mit találsz a tervgyorsítótárban. Itt van az eredmények összessége.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Figyeld meg, hogy az usecounts érték nő 2, ami azt jelenti, hogy ugyanazt a gyorsítótárazott tervet változtatás nélkül újra felhasználják, mert a végrehajtási kontextus adatstruktúráit újra felhasználják. Most módosítsd az SET ANSI_DEFAULTS opciót, és hajtsd végre a tárolt eljárást ugyanazzal a paraméterrel.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Ellenőrizd újra, mit találsz a tervgyorsítótárban. Itt van az eredmények összessége.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Figyelje meg, hogy most két bejegyzés található a sys.dm_exec_cached_plans DMV-kimenetben:
- Az
usecountsoszlop az első rekordban a(z)1értéket mutatja. Ez az érték aSET ANSI_DEFAULTS OFFegyszer végrehajtott tervet jelenti. - Az
usecountsoszlop a második rekordban a(z)2értéket mutatja. Ez az érték aSET ANSI_DEFAULTS ONvégrehajtott tervet jelöli, mivel kétszer hajtották végre. - A különböző
memory_object_addressegy másik végrehajtási terv bejegyzésre utal a tervgyorsítótárban.sql_handleAz érték azonban mindkét tétel esetében ugyanaz, mert ugyanarra a kötegre hivatkoznak.- Az olyan végrehajtás, amelyben a(z)
ANSI_DEFAULTSértékeOFF, újplan_handle-vel rendelkezik, és újra felhasználható olyan hívásokhoz, amelyek ugyanazzal aSETopciókészlettel rendelkeznek. Az új tervleíróra azért van szükség, mert a végrehajtási környezet újraindult a megváltozottSETbeállítások miatt. De ez a változás nem indít el újrafordítást: mindkét bejegyzés ugyanazra a tervre és lekérdezésre utal, amit ugyanazokquery_plan_hashésquery_hashértékek is bizonyítanak.
- Az olyan végrehajtás, amelyben a(z)
Ez azt jelenti, hogy két tervbejegyzés van a gyorsítótárban, amelyek ugyanahhoz a köteghez tartoznak. Kiemeli, mennyire fontos biztosítani, hogy a tervgyorsítótárat érintő SET beállítások azonosak legyenek, amikor ugyanazokat a lekérdezéseket ismételten végrehajtják. Ez a megközelítés optimalizálja a lekérdezési terv újrafelhasználását, és a lekérdezésiterv-gyorsítótár méretét a szükséges minimumon tartja.
Jótanács
Gyakori buktató, hogy a különböző ügyfelek eltérő alapértelmezett értékekkel rendelkezhetnek a SET beállításokhoz. Például az SQL Server Management Studio használatával létrejött kapcsolat automatikusan QUOTED_IDENTIFIER értékét ON értékre állítja, míg az SQLCMD a QUOTED_IDENTIFIER értékét OFF értékre állítja. Ugyanazoknak a lekérdezéseknek az ebből a két kliensből történő végrehajtása több tervet eredményez (ahogy az előző példában is leírták).
Végrehajtási tervek eltávolítása a tervtárból
A végrehajtási tervek a terv gyorsítótárában maradnak, amíg elég memória van a tároláshoz. Ha memórianyomás van, az SQL Server adatbázismotor költségalapú megközelítést alkalmaz annak eldöntésére, hogy mely végrehajtási terveket távolítson el a terv gyorsítótárából. Költségalapú döntéshez az SQL Server adatbázismotor növeli és csökkenti a jelenlegi költségváltozót minden végrehajtási terv esetében az alábbi tényezők alapján.
Amikor egy felhasználói folyamat végrehajtási tervet helyez be a gyorstárba, a felhasználói folyamat a jelenlegi költséget az eredeti lekérdezési fordítási költségnek állítja be. Az ad hoc végrehajtási tervek esetén a felhasználói folyamat nullára állítja be a jelenlegi költséget. Ezután minden alkalommal, amikor egy felhasználói folyamat hivatkozik egy végrehajtási tervre, visszaállítja a jelenlegi költséget az eredeti kompilálási költségre. Az ad hoc végrehajtási tervek esetén a felhasználói folyamat növeli a jelenlegi költséget. Az összes csomag esetében az aktuális költség maximális értéke az eredeti fordítási költség.
Ha memórianyomás van, az SQL Server adatbázismotor eltávolítja a végrehajtási terveket a terv gyorsítótárából. Annak meghatározásához, hogy mely terveket szeretné eltávolítani, az SQL Server adatbázismotorja ismételten megvizsgálja az egyes végrehajtási tervek állapotát, és eltávolítja a terveket, ha az aktuális költség nulla. Egy végrehajtási terv, amelynek jelenlegi költsége nulla, nem távolítódik el automatikusan, ha memórianyomás van. Csak akkor kerül eltávolításra, amikor az SQL Server adatbázismotor megvizsgálja a tervet, és a jelenlegi költség nulla. Végrehajtási terv vizsgálatakor az SQL Server adatbázismotor az aktuális költséget nullára küldi azáltal, hogy csökkenti az aktuális költséget, ha egy lekérdezés jelenleg nem használja a tervet.
Az SQL Server adatbázismotor folyamatosan vizsgálja a végrehajtási terveket, amíg elegendő tervet el nem távolít a memóriaigények kielégítéséhez. Bár a memóriaterhelés létezik, előfordulhat, hogy a végrehajtási terv költségei többször is növekednek és csökkennek. Amikor a memóriaterhelés már nem áll fenn, az SQL Server adatbázismotor leállítja a használaton kívüli végrehajtási tervek aktuális költségének csökkentését. Minden végrehajtási terv a terv cache-ben marad, még akkor is, ha a költségük nulla.
Az SQL Server adatbázismotorja az erőforrásmonitor és a felhasználói feldolgozó szálak segítségével szabadít fel memóriát a tervtárból a memóriára nehezedő nyomás enyhítése érdekében. Az erőforrás-figyelő és a felhasználói feldolgozószálak egyszerre vizsgálhatják a terveket, hogy csökkentsék a jelenlegi költséget minden használaton kívüli végrehajtási terv esetében. Az erőforrásmonitor eltávolítja a végrehajtási terveket a tervgyorsítótárból, ha globális memóriaterhelés áll fenn. Memóriát szabadít fel a rendszermemória, a folyamatmemória, az erőforráskészlet memóriájának és az összes gyorsítótár maximális méretének kényszerítéséhez.
Az összes gyorsítótár maximális mérete a pufferkészlet méretének függvénye, és nem haladhatja meg a kiszolgáló maximális memóriáját. További információért a maximális kiszolgálómemória konfigurálásáról lásd a(z) sp_configuremax server memory beállítását.
A felhasználói munkavégző szálak eltávolítják a végrehajtási terveket a terv gyorsítótárából, ha egyetlen gyorsítótár-memóriaterhelés áll fenn. Politikai szabályokat kényszerítenek ki az egyedi gyorsítótár maximális méretére és az egyedi gyorsítótár maximális bejegyzéseire.
Az alábbi példák azt szemléltetik, hogy mely végrehajtási tervek lesznek eltávolítva a tervgyorsítótárból:
- A végrehajtási tervre gyakran hivatkoznak, hogy a költsége soha ne legyen nulla. A terv a terv gyorsítótárában marad, és csak akkor távolítják el, ha memórianyomás van, és a jelenlegi költség nulla.
- Beszúrnak egy alkalmi végrehajtási tervet, és nem hivatkoznak rá újra, amíg nem lép fel memóriaterhelés. Mivel az ad hoc tervek jelenlegi nulla költséggel inicializálódnak, amikor az SQL Server adatbázismotor megvizsgálja a végrehajtási tervet, látja a nulla jelenlegi költséget, és eltávolítja a tervet a terv gyorsítótárából. Az ad hoc végrehajtási terv a terv gyorsítótárában marad, nulla aktuális költséggel, ha nincs memórianyomás.
Ha manuálisan szeretne eltávolítani egy csomagot vagy az összes csomagot a gyorsítótárból, használja a DBCC FREEPROCCACHE parancsot. Használhatod a DBCC FREESYSTEMCACHE-t is, hogy töröld bármilyen gyorsítótárt, beleértve a terv gyorsítótárt is. SQL Server 2016 (13.x) és újabb verziók esetén az ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE használatával törölheti az adatbázis hatókörébe tartozó eljárás-(terv-)gyorsítótárat.
Néhány konfigurációs beállítás megváltoztatása sp_configure és reconfigure révén szintén a tervek eltávolítását eredményezi a terv-gyorsítótárból. A konfigurációs beállítások listáját a DBCC FREEPROCCACHE cikk Megjegyzések szakaszában találja. Amikor ezt a konfigurációt módosítod, a következő információs üzenet kerül a hibanaplóba:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Végrehajtási tervek újrafordítása
Bizonyos adatbázisbeli változások hatástalanná vagy érvénytelenné tehetik a végrehajtási tervet. A Database Engine észleli ezeket a változásokat, és nem érvényesnek jelöli a tervet. Ezután újra létre kell készíteni egy új tervet a lekérdezést végrehajtó következő kapcsolathoz. A tervet érvénytelenítő feltételek a következők:
- Változások egy táblázatban vagy nézetben, amelyre a lekérdezés (
ALTER TABLEésALTER VIEW) hivatkozik. - Egyetlen eljárás módosítása, amely eltávolítaná az adott eljáráshoz tartozó összes tervet a gyorsítótárból (
ALTER PROCEDURE). - A végrehajtási terv által használt indexek módosítása.
- A végrehajtási terv által használt statisztikák frissítései, akár egy
UPDATE STATISTICSutasítás által kifejezetten, akár automatikusan generáltak. - A végrehajtási terv által használt index elvetése.
- Egy explicit hívás
sp_recompile. - A kulcsok nagy száma (lekérdezés által hivatkozott táblát módosító, más felhasználók által
INSERTvagyDELETEutasításokkal generált változások). - Az eseményindítókat tartalmazó táblák esetében, ha a beszúrt vagy törölt táblák sorainak száma jelentősen nő.
- Egy tárolt eljárás végrehajtása a
WITH RECOMPILEbeállítás használatával.
A legtöbb újrafordítás vagy az utasítás helyessége miatt, vagy a potenciálisan gyorsabb lekérdezés-végrehajtási tervek eléréséhez szükséges.
Amikor egy kötegen belüli utasítás újrafordítást indít el, csak azt az utasítást fordítják újra, nem az egész köteget. Ez a szabály érvényes akkor is, ha a köteg tárolt eljárás, trigger, ad hoc köteg vagy előkészített utasítás segítségével érkezik.
Az utasítás-szintű újrafordítás javítja a teljesítményt, mert a legtöbb esetben csak kis számú utasítás okoz újrafordítást és az ahhoz kapcsolódó járulékos többletterheket CPU-idő és zárolások tekintetében. Ezért ezek a hátrányok elkerülhetők a köteg azon többi utasítása esetén, amelyeket nem kell újrafordítani.
A sql_statement_recompile kiterjesztett esemény (XEvent) utasításszintű újrafordításokat jelent. Ez az XEvent akkor fordul elő, ha bármilyen köteg utasításszintű újrafordítást igényel. Ez a követelmény magában foglalja a tárolt eljárásokat, triggereket, ad hoc kötegeket és lekérdezéseket. A kötegek több interfészen keresztül is elküldhetők, például sp_executesql, dinamikus SQL-en, Prepare metódusokkal vagy Execute metódusokkal.
Az recompile_cause XEvent oszlopa sql_statement_recompile egy egész kódot tartalmaz, amely az újrafordítás okát jelzi. Az alábbi lista tartalmazza a lehetséges okokat:
- A kurzor beállításai megváltoztak
- Halasztott fordítás
-
FOR BROWSEengedély módosult -
OPTION (RECOMPILE)Kért - Paraméterezett terv törölve
- A particionált nézet megváltozott
- Az adatbázisverziót érintő terv módosult
- Módosult a lekérdezésértesítési környezet
- A Lekérdezéstárból hiányzik a terv
- A Lekérdezéstár-terv kényszerítése nem sikerült
- Módosult a lekérdezéstár kényszerítési tervszabályzata
- A távoli sorok halmaza megváltozott
- A séma megváltozott
-
SETbeállítás módosult - A statisztikák megváltoztak
- Ideiglenes tábla meg lett változtatva
Megjegyzés:
Amikor az AUTO_UPDATE_STATISTICS adatbázis-beállítást ON értékre állítja, a lekérdezések újrafordulnak, amikor olyan táblákat vagy indexelt nézeteket céloznak, amelyek statisztikái frissülnek, vagy amelyek kardinalitásai jelentősen megváltoznak az utolsó végrehajtás óta. Ez a viselkedés a szokásos, felhasználó által definiált táblákra, ideiglenes táblákra, valamint a DML-eseményindítók által létrehozott beszúrt és törölt táblákra vonatkozik.
A AUTO_UPDATE_STATISTICSOFF értékre állítása megállítja ezeket az újrafordításokat, de az elavult statisztikák általában jobban rontják a lekérdezések teljesítményét, mint az újrafordítások. További információért lásd az AUTO_UPDATE_STATISTICS opciót. A beillesztett és törölt DML INSTEAD OF triggertáblákat a(z) tempdb-ben hozták létre, így követik a AUTO_UPDATE_STATISTICS beállítását a(z) tempdb esetében.
Használj explicit paramétereket a lekérdezési terv újrahasználatához
A paraméterek használata, beleértve az elnevezett paramétereket az ADO.NET-alkalmazásokban, valamint a paraméterjelölőket az OLE DB- és ODBC-alkalmazásokban, növelheti a végrehajtási tervek újrafelhasználását.
Figyelmeztetés
Mindig ellenőrizze a felhasználói bemenetet tesztelési típus, hossz, formátum és tartomány alapján. További információért lásd: SQL-injektálás.
A következő két SELECT utasítás között az egyetlen különbség az összehasonlítandó értékek a feltételben WHERE.
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
A lekérdezések végrehajtási tervei között az egyetlen különbség az a tárolt érték, amelyet a ProductSubcategoryID oszlop összehasonlításához használnak. Bár a cél az, hogy a Database Engine mindig felismerje, hogy az utasítások lényegében ugyanazt a tervet generálják, és újra felhasználja a terveket, a Database Engine néha nem érzékeli ezt a hasonlóságot a bonyolult T-SQL utasításokban.
A konstansokat a T-SQL-utasítástól paraméterek segítségével elválasztva a relációs motor felismeri az ismétlődő végrehajtási terveket. Használja a paramétereket a következő módokon:
T-SQL-ben használd
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Ezt a módszert T-SQL szkriptekhez, tárolt eljárásokhoz vagy dinamikusan SQL utasításokat generáló triggerekhez ajánlják.
Az ADO.NET elnevezett
SqlClientparamétereket használ, például@Parm. Az OLE DB és az ODBC paramétermarkereket használ. A paraméterjelölők kérdőjelek (?), amelyek egy SQL-utasításban lévő állandót helyettesítenek, és egy programváltozóhoz kötöttek. Egy ODBC-alkalmazásban például a következőket teheti:Az
SQLBindParameterhasználatával köt egy egész szám változót egy SQL-utasítás első paraméterjelölőjéhez.Helyezze az egész számot a változóba.
Hajtsuk végre az utasítást, megadva a paraméterjelölőt (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Az SQL Server Native Client OLE DB Provider és az SQL Server Native Client ODBC-illesztőprogram
sp_executesqlutasításokat küld az SQL Servernek, amikor paraméterjelölőket használnak az alkalmazásokban.Írj tárolt eljárásokat, amelyek eredendően paramétereket használnak.
Ha nem építesz be kifejezetten paramétereket az alkalmazásaid tervezésébe, akkor a Query Optimizerra is támaszkodhatsz abban, hogy az egyszerű paraméterezés alapértelmezett működését használva automatikusan paraméterezzen bizonyos lekérdezéseket. Másik lehetőségként kényszerítheti a Lekérdezésoptimalizálót, hogy paraméterezze az adatbázis PARAMETERIZATION összes lekérdezését az ALTER DATABASE utasítás PARAMETERIZATION opcióját -ra állítva.
Egyszerű paraméterezés
A Database Engine-ben a paraméterek vagy paraméterjelölők használata a T-SQL utasításokban növeli a relációs motor képességét, hogy az új T-SQL utasításokat a meglévő, korábban lefordított végrehajtási tervekhez összerendelje.
Figyelmeztetés
Mindig ellenőrizze a felhasználói bemenetet tesztelési típus, hossz, formátum és tartomány alapján. További információért lásd: SQL-injektálás.
Ha egy T-SQL utasítást paraméterek nélkül hajtanak végre, a Database Engine belülről paraméterezi az utasítást, hogy növelje annak esélyét, hogy megfeleltessék egy meglévő végrehajtási tervnek. Ezt a folyamatot paraméterezésnek nevezik. Az alapértelmezett paraméterezés egyszerű beállítás, és bekapcsolhatod a kényszerített paraméterezést egy adatbázisban.
Vegye figyelembe ezt az állítást:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Az 1 értéket az utasítás végén megadhatod paraméterként. A relációs motor úgy építi fel a végrehajtási tervet ehhez a köteghez, mintha egy paramétert adnál meg az érték 1 helyett. Az egyszerű paraméterezés miatt a Database Engine felismeri, hogy a következő két állítás lényegében ugyanazt a végrehajtási tervet generálja, és az első tervet használja a második utasításhoz:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Komplex T-SQL utasítások feldolgozása során a relációs motor nehezen határozhatja meg, mely kifejezések paraméterezhetők. A relációs motor azon képességének növelése érdekében, hogy az összetett T-SQL utasításokat a meglévő, nem használt végrehajtási tervekhez tudja illeszteni, a paramétereket explicit módon adja meg a sp_executesql vagy paraméterjelölők használatával.
Megjegyzés:
Amikor az +, -, *, /, vagy % aritmetikai operátorokat használjuk az int, smallint, tinyint vagy bigint állandó értékek implicit vagy explicit átalakítására a float, real, decimal vagy numeric adattípusokra, a Database Engine speciális szabályokat alkalmaz a kifejezés eredményeinek típusának és pontosságának kiszámítására. Ezek a szabályok attól függően különböznek, hogy a lekérdezés paraméterezett-e. Ezért a lekérdezésekben lévő hasonló kifejezések bizonyos esetekben eltérő eredményeket eredményezhetnek.
Az egyszerű paraméterezés alapértelmezett viselkedése szerint a Database Engine a lekérdezések egy viszonylag szűk körét paraméterezi. Azonban megadhatja, hogy az adatbázis összes lekérdezése paraméteres legyen, bizonyos korlátozások figyelembevételével, ha a PARAMETERIZATION parancs lehetőségét a ALTER DATABASEFORCED értékre állítja. Ez a változás javíthatja azon adatbázisok teljesítményét, amelyeket nagy számú párhuzamos lekérdezés ér, azáltal, hogy csökkenti a lekérdezésfordítások gyakoriságát.
Másik lehetőségként megadhatja, hogy egyetlen lekérdezés és minden más, szintaktikailag egyenértékű, de csak a paraméterértékekben eltérő lekérdezés paraméterezhető legyen.
Jótanács
Amikor objektum-relációs leképezés (ORM) megoldást használsz, például az Entity Frameworköt (EF), az olyan alkalmazási lekérdezések, mint a kézi LINQ lekérdezésfák vagy bizonyos nyers SQL lekérdezések, lehet, hogy nincsenek paraméterezve. Ez a korlátozás befolyásolja a terv újrahasználatát és a lekérdezések nyomon követésének lehetőségét a Query Store-ban. További információ: EF-lekérdezések gyorsítótárazása és paraméterezése és EF Raw SQL-lekérdezések.
Kényszerített paraméterezés
Felülírhatod a Database Engine alapértelmezett egyszerű paraméterezési viselkedését azzal, hogy megadod, hogy az adatbázisban minden SELECT, INSERT, UPDATE és DELETE utasítás paraméterezhető legyen, bizonyos korlátozások mellett. Engedélyezze a kényszerített paraméterezést úgy, hogy a(z) FORCED utasításban a ALTER DATABASE beállítást PARAMETERIZATION értékre állítja. A kényszerített paraméterezés javíthatja bizonyos adatbázisok teljesítményét a lekérdezés-fordítások és újrafordítások gyakoriságának csökkentésével. A kényszerített paraméterezés előnyeit élvező adatbázisok általában azok, amelyek nagy mennyiségű egyidejű lekérdezést tapasztalnak olyan forrásokból, mint például az értékesítési pontok alkalmazásai.
Ha a(z) PARAMETERIZATION beállítást FORCED értékre állítod, bármely literális érték, amely egy SELECT, INSERT, UPDATE vagy DELETE utasításban jelenik meg, bármilyen formában is legyen megadva, a lekérdezés fordítása során paraméterré alakul. A kivételek a következő lekérdezési szerkezetekben megjelenő literálok:
-
INSERT...EXECUTENyilatkozatok. - Tárolt eljárások, eseményindítók vagy felhasználó által definiált függvények testén belüli utasítások. A Database Engine már újrahasználja a lekérdezési terveket ezekhez a rutinokhoz.
- Előkészített utasítások, amelyek már paraméterezve vannak a kliensoldali alkalmazásban.
- Az XQuery metódushívásokat tartalmazó utasítások, amelyekben a metódus olyan környezetben jelenik meg, amelyben az argumentumai általában paraméterezhetők, például egy
WHEREzáradék. Ha a metódus olyan környezetben jelenik meg, amelyben az argumentumai nem paraméterezhetők, az utasítás többi része paraméterezve lesz. - Utasítások egy T-SQL kurzorban. (
SELECTaz API-kurzorokon belüli utasítások paraméteresen vannak megadva.) - Elavult lekérdezésszerkezetek.
- Bármilyen utasítás, amely
ANSI_PADDINGvagyANSI_NULLSkontextusában fut, és ezek értékeOFF. - Olyan utasítások, amelyek több mint 2,097 literált tartalmaznak, jogosultak a paraméterezésre.
- Változókra hivatkozó utasítások, például
WHERE T.col2 >= @bb. - A lekérdezési
RECOMPILEtippet tartalmazó utasítások. - Állítások, amelyek egy
COMPUTEzáradékot tartalmaznak. - Állítások, amelyek egy
WHERE CURRENT OFzáradékot tartalmaznak.
A következő lekérdezési záradékok nincsenek paraméterezve. Ezekben az esetekben csak a záradékok nincsenek paraméterezve. Az ugyanazon lekérdezésen belüli egyéb záradékok is jogosultak lehetnek a kényszerített paraméterezésre.
- Bármely
SELECTállítás<select_list>ja. Ez a lista tartalmazzaSELECTaz allekérdezések listáit ésSELECTaINSERTutasításokon belüli listáit is. - Részlekérdezés
SELECTutasítások, amelyek egyIFutasításon belül jelennek meg. - Egy
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOvagyFOR XMLzáradékok egy lekérdezésben. - Argumentumok közvetlen vagy alexpresszióként, a
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLvagy bármelyFULLTEXToperátorhoz. - A
LIKEzáradék mintája és menekülési karakter argumentumai. - A
CONVERTzáradék stílusargumentuma. - Egész szám állandók egy
IDENTITYkódblokkon belül. - ODBC-bővítmény szintaxisával megadott állandók.
- Konstans módon összecsukható kifejezések, amelyek a
+,-,*,/és%operátorok argumentumai. Amikor a kényszerített paraméterezésre való jogosultságot vizsgáljuk, a Database Engine egy kifejezést konstansként kiértékelhetőnek tekint, ha az alábbi feltételek bármelyike igaz:- A kifejezésben nem jelennek meg oszlopok, változók vagy al lekérdezések.
- A kifejezés tartalmaz egy záradékot
CASE.
- A lekérdezési tipp klauzulák argumentumai, beleértve a
FASTlekérdezési tipp number_of_rows argumentumát, aMAXDOPlekérdezési tipp number_of_processors argumentumát, valamint a lekérdezési tippMAXRECURSIONargumentumát.
A paraméterezés az egyes T-SQL utasítások szintjén történik. Más szóval, a csomag egyes utasításai paraméterezve vannak. A lefordítás után egy paraméterezett lekérdezés annak a kötegnek a kontextusában fut le, amelyben eredetileg elküldték. Ha egy lekérdezés végrehajtási terve gyorsítótárazva van, akkor a(z) sys.syscacheobjects dinamikus felügyeleti nézet sql oszlopára hivatkozva megállapíthatod, hogy a lekérdezést paraméterezték-e. Ha egy lekérdezés paraméterezett, a paraméterek nevei és adattípusai megelőzik a beküldött köteg szövegét ebben az oszlopban, például (@1 TINYINT).
Megjegyzés:
A paraméternevek tetszőlegesek. A felhasználóknak vagy alkalmazásoknak nem szabad egy adott elnevezési sorrendre támaszkodniuk. Emellett a következő elemek változhatnak az SQL Server verziói és a kumulatív frissítéses (CU) frissítések között: paraméternevek, annak megválasztása, hogy mely literálok vannak paraméterezve, valamint a paraméterezett szöveg szóközei.
Paraméterek adattípusai
Amikor a Database Engine paraméterezi a literálisokat, a paraméterek a következő adattípusokra alakulnak át:
- Az egész szám literálisok, amelyek mérete egyébként az int adattípusba illeszkedne, az int-re paramétereznek. A nagyobb egész szám literálisok, amelyek olyan predikátumok részei, amelyek bármilyen összehasonlító operátort magukban foglalnak (beleértve
<,<=,!=,>,=,>=,!<,ANY,BETWEEN,ALL,<>,SOME,!>ésIN), numeric(38,0)-ra paramétereznek. A nagyobb literálisok, amelyek nem részei összehasonlító operátorokat tartalmazó predikátumoknak, numerikusra paramétereznek, amelynek pontossága éppen elég nagy ahhoz, hogy támogassa a méretét, és a skálája 0. - A rögzített pontú numerikus literálisok, amelyek predikátumok részei, és összehasonlító operátorokat alkalmaznak, olyan numerikusra paramétereznek, amelynek pontossága 38, és amelynek skálája éppen elég nagy ahhoz, hogy támogassa a méretét. Azok a fixpontos numerikus literálisok, amelyek nem részei összehasonlító operátorokat tartalmazó predikátumoknak, a numeric típusra paramétereződnek, amelynek pontossága és skálája éppen elég nagy ahhoz, hogy támogassa a méretüket.
- A lebegőpontos numerikus literálisok paraméterezése float(53) szerint történik.
- A nem Unicode-karakterlánc-literálisokat varchar(8000)-ra paraméterezi, ha a literális belefér 8 000 karakterbe, és varchar(max)-ra, ha 8 000 karakternél nagyobb.
- Az Unicode karakterlánc-literálok nvarchar(4000)-re paramétereződnek, ha a literál belefér 4000 Unicode-karakterbe, és nvarchar(max)-ra paramétereződnek, ha a literál 4000 karakternél nagyobb.
- A bináris literálisok varbinary(8000) típusként vannak paraméterezve, ha a literális belefér 8 000 bájtba. Ha nagyobb, mint 8 000 bájt, akkor varbinary(max) típusra konvertálódik.
- A pénzliterálok paramétere: money.
A kényszerített paraméterezés használatának irányelvei
Vegyük figyelembe a következő pontokat, amikor a(z) PARAMETERIZATION beállítást erre állítod: FORCED
- A kényszerített paraméterezés a lekérdezés literális állandóit paraméterekre változtatja a lekérdezés fordításakor. A Lekérdezésoptimalizáló ezért a lekérdezések optimálisnál rosszabb csomagjait is választhatja. A Lekérdezésoptimalizáló kevésbé valószínű, hogy egy indexelt nézethez vagy egy számított oszlop indexéhez hasonlítja a lekérdezést. A particionált táblákon és elosztott particionált nézetekben feltett lekérdezésekhez választhat optimálisnál rosszabb terveket. Ne használj kényszerített paraméterezést olyan környezetekben, amelyek erősen az indexelt nézetekre és a számítási oszlopok indexeire támaszkodnak. Általában csak tapasztalt adatbázis-szakemberek használhatják a
PARAMETERIZATION FORCEDopciót, miután megállapították, hogy az nem befolyásolja hátrányosan a teljesítményt. - Az egynél több adatbázisra hivatkozó elosztott lekérdezések akkor jogosultak a kényszerített paraméterezésre
PARAMETERIZATION, ha aFORCEDbeállítás abban az adatbázisban van beállítva, amelyben a lekérdezés fut. - A(z)
PARAMETERIZATIONbeállításFORCEDértékre állítása kiüríti egy adatbázis tervgyorsítótárából az összes lekérdezési tervet, kivéve azokat, amelyek éppen fordítás, újrafordítás vagy futtatás alatt állnak. A lekérdezések tervei, amelyek a beállításváltás alatt fordítás alatt állnak vagy futnak, paraméterezve jelennek meg, amikor a lekérdezés legközelebb lefut. - A
PARAMETERIZATIONbeállítása egy online művelet, amely nem igényel adatbázis-szintű exkluzív zárolásokat. - Jelenlegi beállítása a
PARAMETERIZATIONopció megmarad az adatbázis újra csatlakoztatása vagy visszaállításakor.
Felülírhatod a kényszerített paraméterezés viselkedését azzal, hogy megadod, hogy egyetlen lekérdezés esetén próbálják meg az egyszerű paraméterezést, valamint bármely más olyan lekérdezés esetén is, amely szintaktikailag egyenértékű, de csak a paraméterértékeiben tér el. Ezzel szemben megadhatja, hogy a kényszerített paraméterezés csak szintaktikailag egyenértékű lekérdezések halmazán kísérelhető meg, még akkor is, ha a kényszerített paraméterezés le van tiltva az adatbázisban. Ehhez használj plan guide-okat.
Megjegyzés:
Ha a PARAMETERIZATION opciót FORCED-re állítják, a hibaüzenetek jelentése eltérhet attól, amikor a PARAMETERIZATION opciót SIMPLE-re állítják: kényszerített paraméterezés esetén több hibaüzenet jelenthet meg, ahol kevesebb üzenet jelenne meg egyszerű paraméterezés esetén, és a hibák előfordulásának sorai helytelenül jelenthetők.
Ha a kényszerített paraméterezés engedélyezve van, az egyszerű paraméterezés továbbra is előfordulhat. A következő lekérdezés például nem paraméterezhető a kényszerített paraméterezés szabályai szerint:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Az egyszerű paraméterezési szabályok szerint azonban paraméterezhető. Ha a kényszerített paraméterezést megpróbálják alkalmazni, de sikertelen, akkor ezután is megpróbálják az egyszerű paraméterezést alkalmazni.
SQL-utasítások előkészítése
A Database Engine támogatja a T-SQL utasítások előkészítését a végrehajtás előtt. Ha egy alkalmazásnak többször is T-SQL utasítást kell végrehajtania, az adatbázis API-ját használhatja, hogy:
- A nyilatkozatot egyszer készítse elő. Ez a lépés a T-SQL utasítást egy végrehajtási tervbe fordítja.
- Hajtsa végre a lefordított végrehajtási tervet minden alkalommal, amikor végre kell hajtania az utasítást. Ez a megközelítés megakadályozza, hogy a T-SQL utasítást az első alkalom után minden végrehajtáskor újrafordítsák. Az utasítások előkészítését és végrehajtását API-függvények és metódusok vezérlik. Az SQL Server Native Client OLE DB Provider és az SQL Server Native Client ODBC-illesztőprogramja támogatják a T-SQL utasítások végrehajtásának előkészítési/végrehajtási modelljét. Előkészítési kérelem esetén vagy a szolgáltató vagy az illesztőprogram elküldi az utasítást az SQL Servernek az utasítás előkészítésére vonatkozó kéréssel. A Database Engine egy végrehajtási tervet fordít, és visszaadja az adott terv azonosítóját a szolgáltatónak vagy az illesztőprogramnak. Végrehajtási kérelem esetén a szolgáltató vagy az illesztőprogram kérést küld a kiszolgálónak a leíróhoz társított terv végrehajtására.
Az előkészített utasítások nem tudnak ideiglenes objektumokat létrehozni a Database Engine-ben. Az előkészített utasítások nem hivatkozhatnak olyan rendszer által tárolt eljárásokra, amelyek ideiglenes objektumokat, például ideiglenes táblákat hoznak létre. Ezeket az eljárásokat közvetlenül kell végrehajtani.
A prepare/execute modell túlzott használata ronthatja a teljesítményt. Ha egy utasítást csak egyszer hajtanak végre, a közvetlen végrehajtáshoz csak egy hálózati oda-vissza út szükséges a szerverhez. Egy csak egyszer végrehajtott T-SQL utasítás előkészítése és végrehajtása egy plusz hálózati oda-vissza utazást igényel: egy út az utasítás előkészítéséhez, egy út a végrehajtáshoz.
Az utasítás elkészítése hatékonyabb, ha paraméterjelölőket használ. Tegyük fel például, hogy egy alkalmazásnak időnként termékinformációkat kell lekérnie a AdventureWorksLT2025 mintaadatbázisból. Az alkalmazás kétféleképpen tudja elvégezni ezt a feladatot.
Az első megközelítéssel az alkalmazás minden kért termékhez külön lekérdezést tud végrehajtani:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
A második megközelítéssel az alkalmazás a következő műveleteket végzi:
Olyan állítást készít, amely tartalmaz egy paraméterjelölőt (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Programváltozót köt a paraméterjelölőhöz.
Minden alkalommal, amikor termékinformációra van szükség, kitölti a kötött változót a kulcsértékkel, és végrehajtja az utasítást.
A második megközelítés hatékonyabb, ha az utasítást háromnál többször hajtják végre.
A Database Engine-ben a prepare/execute modellnek nincs jelentős teljesítményelőnye a közvetlen végrehajtással szemben, mivel a Database Engine újrahasznosítja a végrehajtási terveket. A Database Engine hatékony algoritmusokkal rendelkezik, amelyek az aktuális T-SQL utasítást összeillesztik azokkal a végrehajtási tervekkel, amelyek ugyanazon T-SQL utasítás korábbi végrehajtásai során jöttek létre. Ha egy alkalmazás többször is futtat egy T-SQL utasítást paraméterjelölőkkel, a Database Engine újrahasználja az első végrehajtási tervet a második és az azt követő végrehajtásokhoz (kivéve, ha a terv kiöregszik a terv gyorsítótárából). A előkészítési/végrehajtási modell továbbra is az alábbi előnyökkel jár:
- Egy végrehajtási terv azonosító alapján történő megtalálása hatékonyabb, mint azok az algoritmusok, amelyeket egy T-SQL-utasítás meglévő végrehajtási tervekhez való megfeleltetésére használnak.
- Az alkalmazás szabályozhatja, mikor jön létre a végrehajtási terv, és mikor használják újra.
- Az előkészítési/végrehajtási modell más adatbázisokba is hordozható, beleértve az SQL Server korábbi verzióit is.
Paraméterérzékenység
A paraméterérzékenység, más néven paramétersniffing, olyan folyamatot jelent, amikor a Database Engine a fordítás vagy újrafordítás során észleli a jelenlegi paraméterértékeket, majd továbbítja azokat a Query Optimizernek, hogy hatékonyabb lekérdezés-végrehajtási terveket hozzon létre.
A paraméterértékek a következő kötegtípusok fordítása vagy újrafordítása során lesznek kiszúrva:
- Tárolt eljárások
- A lekérdezések beküldése a
sp_executesql-on keresztül történik - Előkészített lekérdezések
További információért a parameter sniffing problémáinak elhárításáról lásd:
- Paraméterérzékeny problémák kivizsgálása és megoldása
- Használj explicit paramétereket a csomag újrahasználatához
- Paraméterérzékeny csomag optimalizálása
- Lekérdezések hibaelhárítása paraméterérzékeny lekérdezések végrehajtási tervével kapcsolatos problémák esetén az Azure SQL Database-ben
- Lekérdezések hibaelhárítása paraméterérzékeny lekérdezések végrehajtási tervével kapcsolatos problémák esetén a felügyelt Azure SQL-példányban
Amikor egy lekérdezés a Database Engine-ben használja a OPTION (RECOMPILE) hintet, a Lekérdezésoptimalizáló paraméter- és helyi változókat fordítási idejű konstansokká alakít, amelyek konstansként kiértékelhetők és literálisokra lehet csökkenteni. Fordítás során az optimalizáló ismeri és használhatja a paraméterek és helyi változók aktuális futási idejű értékeit, ahogy azok közvetlenül az adott utasítás előtt léteznek. A OPTION (RECOMPILE) tipp lehetővé teszi az optimalizáló számára, hogy optimálisabb lekérdezési tervet generáljon, amely az adott értékekhez igazodik, és a futás során a legjobb indexeket használja ki. A paraméterek esetében ez a folyamat nem a kötegnek vagy a tárolt eljárásnak eredetileg átadott értékekre vonatkozik, hanem az értékekre, amelyek az újrafordítás idején érvényesek. Ezeket az értékeket módosíthatják az eljáráson belül, mielőtt elérnénk azt az állítást, amely tartalmazza RECOMPILE. Ez a viselkedés javíthatja a teljesítményt olyan lekérdezéseknél, amelyek nagyon változó vagy torz eloszlású bemeneti adatokkal dolgoznak, annak árán, hogy a lekérdezést minden végrehajtáskor le kell fordítani. Ez a költség magas lehet. Kerüld a RECOMPILE tipp használatát anélkül, hogy értékelnéd annak teljes terhelésre gyakorolt hatását.
Helyi változók és kardinalitásbecslések
Amikor egy lekérdezés helyi változókat használ, a Database Engine nem tud következtetni az értékükre a lekérdezés fordításakor, ezért a kardinalitást rendelkezésre álló statisztikák vagy heurisztika alapján becsüli. Ha léteznek statisztikák, általában a statisztikai hisztogram all Density ( más néven átlagos sűrűség) értékét használja a predikátumnak megfelelő sorok számának becslésére. Azonban, ha nincs statisztika az oszlophoz, a Database Engine heurisztikus becslésekhez folyamodik, például 10% szelektivitást feltételez az egyenlőségi predikátumokra, és 30%-ot az egyenlőtlenségekre és tartományokra. Ezek a becslések kevésbé pontos lekérdezési tervekhez vezethetnek. Íme egy példa egy helyi változót használó lekérdezésre.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
Ebben az esetben a Database Engine nem használja a 100 értéket a lekérdezés optimalizálásához. Általános becslést használ.
Párhuzamos lekérdezésfeldolgozás
A Database Engine párhuzamos lekérdezéseket biztosít a lekérdezések végrehajtásának és az indexműveletek optimalizálására olyan számítógépek számára, amelyeknek több mikroprocesszora (CPU) van. Mivel a Database Engine több operációs rendszerbeli munkaszál használatával párhuzamosan képes lekérdezési vagy indexműveletet végrehajtani, a művelet gyorsan és hatékonyan végződik.
Lekérdezésoptimalizálás során a Database Engine olyan lekérdezéseket vagy indexműveleteket keres, amelyek profitálhatnak a párhuzamos végrehajtásból. Ezekhez a lekérdezésekhez a Database Engine csereoperátorokat helyez be a lekérdezésvégrehajtási tervbe, hogy felkészítse a lekérdezést párhuzamos végrehajtásra. Az exchange operátor egy olyan lekérdezés-végrehajtási terv operátora, amely folyamatkezelést, adatterjesztést és folyamatvezérlést biztosít. Az exchange operátor altípusként tartalmazza a Distribute Streams, Repartition Streamsés Gather Streams a logikai operátorokat, amelyek közül egy vagy több egy párhuzamos lekérdezéshez tartozó lekérdezésterv Showplan kimenetében jelenhet meg.
Fontos
Bizonyos konstrukciók akadályozzák a Database Engine képességét, hogy a teljes végrehajtási terven vagy annak egyes részein párhuzamosságot alkalmazzon.
A párhuzamosságot gátló szerkezetek a következők:
| Épít | Leírás |
|---|---|
| Skaláris UDF-ek | További információért a skaláris, felhasználódefiniált függvényekről lásd: Felhasználói definiált függvények létrehozása. Az SQL Server 2019 (15.x) verziótól kezdve az SQL Server adatbázismotor képes beágyazni ezeket a funkciókat, és lehetővé teszi a párhuzamosság használatát a lekérdezésfeldolgozás során. További információért a skaláris UDF inliningről lásd: Intelligens lekérdezésfeldolgozás SQL adatbázisokban. |
| Távoli lekérdezés | A Remote Queryról további információt a következő témakörben talál: Logikai és fizikai showplan operátor hivatkozás. |
| Dinamikus kurzorok | További információért a kurzorokról lásd: DECLARE CURSOR. |
| Rekurzív lekérdezések | A rekurzióról további információt a következő témakörökben talál: Útmutatók a rekurzív közös táblakifejezések meghatározásához és használatához és Rekurzió a T-SQL-ben. |
| Többutas táblaértékelt függvények (MSTVF-ek) | Az MSTVF-ekkel kapcsolatos további információkért lásd a Felhasználó által definiált függvények létrehozása (adatbázismotor) című témakört. |
TOP kulcsszó |
További információkért lásd: TOP. |
A lekérdezés-végrehajtási terv tartalmazhatja a QueryPlan elem NonParallelPlanReason attribútumát, amely leírja, hogy miért nem használták a párhuzamosságot. Az attribútum értékei a következők:
| NonParallelPlanReason érték | Leírás |
|---|---|
MaxDOPSetToOne |
A maximális párhuzamossági fok erre van állítva: 1. |
EstimatedDOPIsOne |
A becsült párhuzamosság foka: 1. |
NoParallelWithRemoteQuery |
A párhuzamosság távoli lekérdezésekhez nem támogatott. |
NoParallelDynamicCursor |
Dinamikus kurzorokhoz nem támogatnak párhuzamos terveket. |
NoParallelFastForwardCursor |
A párhuzamos tervek nem támogatottak a gyors előrelépő kurzorok esetében. |
NoParallelCursorFetchByBookmark |
A párhuzamos tervek nem támogatottak a könyvjelzővel beolvasható kurzorok esetében. |
NoParallelCreateIndexInNonEnterpriseEdition |
A párhuzamos indexlétrehozás nem támogatott a nem enterprise kiadás esetén. |
NoParallelPlansInDesktopOrExpressEdition |
A párhuzamos tervek nem támogatottak a Desktop és az Express kiadás esetében. |
NonParallelizableIntrinsicFunction |
A lekérdezés nem párhuzamos belső függvényre hivatkozik. |
CLRUserDefinedFunctionRequiresDataAccess |
A párhuzamosság nem támogatott olyan CLR UDF-hez, amely adathozzáférést igényel. |
TSQLUserDefinedFunctionsNotParallelizable |
A lekérdezés olyan T-SQL felhasználó által definiált függvényre hivatkozik, amely nem párhuzamosítható. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
A táblaváltozós tranzakciók nem támogatják a párhuzamos beágyazott tranzakciókat. |
DMLQueryReturnsOutputToClient |
A DML-lekérdezés kimenetet ad vissza az ügyfélnek, és nem párhuzamosítható. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
A soros és párhuzamos tervek nem támogatott keveréke egyetlen online index építéshez. |
CouldNotGenerateValidParallelPlan |
A párhuzamos terv ellenőrzése sikertelen volt, és nem sikerült visszakerülni a sorosra. |
NoParallelForMemoryOptimizedTables |
A párhuzamosság nem támogatott a hivatkozott In-Memory OLTP-táblák esetében. |
NoParallelForDmlOnMemoryOptimizedTable |
A párhuzamosság nem támogatott az In-Memory OLTP-táblák DML-hez. |
NoParallelForNativelyCompiledModule |
A párhuzamos feldolgozás nem támogatott a natívan lefordított hivatkozott modulok esetében. |
NoRangesResumableCreate |
A tartomány generálása nem sikerült a folytatható létrehozási művelethez. |
Az exchange operátorok beillesztése után az eredmény egy párhuzamos lekérdezések végrehajtási terve. A párhuzamos lekérdezések végrehajtási terve több munkaszálat is használhat. A nem párhuzamos (soros) lekérdezések által használt sorozatvégrehajtási terv csak egy munkavégző szálat használ a végrehajtáshoz. A párhuzamos lekérdezés által használt munkafonalok tényleges számát a lekérdezési terv végrehajtásának inicializálása határozza meg, és a terv összetettségétől, valamint a párhuzamosság fokától függ.
A párhuzamossági fok (DOP) meghatározza a processzorok maximális számát, amelyeket párhuzamos feladat végrehajtásához lehet használni. A DOP nem jelzi a lekérdezés által használt worker szálak teljes számát. A DOP-korlát tevékenységenként van beállítva. Ez nem egy kérésenkénti vagy lekérdezési korlát. Ez azt jelenti, hogy egy párhuzamos lekérdezés végrehajtása során egyetlen kérelem több feladatot is létrehozhat, amelyek egy ütemezőhöz vannak rendelve. A MAXDOP által megadottnál több processzort lehet egyszerre használni a lekérdezés végrehajtásának bármely pontján, amikor különböző feladatokat egyszerre hajtanak végre. További információkért lásd a Szál- és feladatarchitektúra útmutatót.
A lekérdezésoptimalizáló nem használ párhuzamos végrehajtási tervet lekérdezéshez, ha az alábbi feltételek közül bármelyik érvényes:
A soros végrehajtási terv triviális, vagy nem haladja meg a párhuzamosság költségküszöbértékét.
A soros végrehajtási terv teljes becsült alstruktúra költsége alacsonyabb, mint bármely, az optimalizáló által feltárt párhuzamos végrehajtási tervé.
A lekérdezés skaláris vagy relációs operátorokat tartalmaz, amelyek nem futtathatók párhuzamosan. Bizonyos operátorok okozhatják, hogy a lekérdezési terv egy része soros módban fusson, vagy akár az egész terv soros módban fusson.
Megjegyzés:
Egy párhuzamos terv becsült részösszegköltsége alacsonyabb lehet, mint a párhuzamossági beállítás költségküszöbe. Más szóval, a soros végrehajtási terv becsült részfa-összköltsége meghaladta azt, és az alacsonyabb becsült részfa-összköltségű lekérdezési tervet választották.
A párhuzamossági fok (DOP)
A Database Engine automatikusan érzékeli a legjobb párhuzamossági fokot minden párhuzamos lekérdezés-végrehajtási vagy adatdefiníciós nyelvi (DDL) művelet esetén. Ezt az értéket a következő kritériumok alapján határozza meg:
Függetlenül attól, hogy az SQL Server egynél több mikroprocesszort vagy processzort tartalmazó számítógépen fut-e, például szimmetrikus többprocesszoros számítógépen (SMP). Csak az egynél több processzort használó számítógépek használhatnak párhuzamos lekérdezéseket.
Elegendő munkaszálak állnak-e rendelkezésre? Minden lekérdezési vagy indexelési művelethez bizonyos számú feldolgozószálat kell végrehajtani. A párhuzamos terv végrehajtásához több munkaszálra van szükség, mint egy soros tervre, és a szükséges munkaszálak száma a párhuzamosság mértékével nő. Ha a párhuzamos terv munkaszál-követelménye egy adott párhuzamossági fokra nem teljesül, az SQL Server adatbázismotor automatikusan csökkenti a párhuzamosság mértékét, vagy sorosan futtatja a párhuzamos tervet.
A végrehajtott lekérdezés- vagy indexművelet típusa. Az indexet létrehozó vagy újraépítendő indexműveletek, illetve a fürtözött indexek elvetése és a cpu-ciklusokat erősen használó lekérdezések a legjobb jelöltek a párhuzamos tervhez. Például a nagy táblák egyesítése, a nagy aggregációk és a nagy eredményhalmazok rendezése ideális jelöltek. Az alapvető lekérdezések, amelyek gyakran fordulnak elő tranzakciófeldolgozó alkalmazásokban, esetében a lekérdezés párhuzamos végrehajtásához szükséges extra koordináció felülmúlja a lehetséges teljesítménynövekedést. A párhuzamosság előnyeit élvező és a nem előnyös lekérdezések megkülönböztetéséhez az SQL Server adatbázismotor összehasonlítja a lekérdezés vagy indexelési művelet végrehajtásának becsült költségét a párhuzamossági érték költségküszöbével . A felhasználók megváltoztathatják a
5alapértelmezett értékét az sp_configure használatával, ha a megfelelő tesztelés megállapítja, hogy egy másik érték alkalmasabb a futó munkaterheléshez.Hogy elegendő számú sort kell-e feldolgozni. Ha a Lekérdezésoptimalizáló megállapítja, hogy a sorok száma túl alacsony, nem vezet be exchange operátorokat a sorok elosztásához. Így az operátorok végrehajtása soronként történik. Az operátorok soros tervben való végrehajtása elkerüli azokat a forgatókönyveket, amikor az indítási, terjesztési és koordinációs költségek meghaladják a párhuzamos operátor-végrehajtás által elért nyereséget.
Hogy elérhetők-e a jelenlegi statisztikák. Ha a párhuzamosság legmagasabb foka nem lehetséges, a párhuzamos terv elhagyása előtt alacsonyabb fokokat is figyelembe kell venni. Például, amikor egy nézeten klaszterelt indexet hozol létre, a statisztikák nem számíthatók ki, mert a klaszterelt index még nem létezik. Ebben az esetben az SQL Server adatbázismotorja nem tudja a legmagasabb fokú párhuzamosságot biztosítani az indexművelethez. Egyes operátorok, például a rendezés és a vizsgálat azonban továbbra is kihasználhatják a párhuzamos végrehajtás előnyeit.
Megjegyzés:
A párhuzamos indexműveletek csak az SQL Server Enterprise, Developer és Evaluation kiadásokban érhetők el.
A végrehajtás során az SQL Server adatbázismotorja határozza meg, hogy a rendszer jelenlegi számítási feladatai és a korábban ismertetett konfigurációs információk lehetővé teszik-e a párhuzamos végrehajtást. Ha a párhuzamos végrehajtás indokolt, az SQL Server adatbázismotorja határozza meg a feldolgozói szálak optimális számát, és elterjeszti a párhuzamos terv végrehajtását ezeken a munkaszálakon. Ha egy lekérdezési vagy indexelési művelet több feldolgozószálon kezdi meg a párhuzamos végrehajtást, a művelet befejezéséig ugyanazt a számú munkaszálat használja a rendszer. Az SQL Server adatbázismotorja minden végrehajtási terv lekérésekor újra megvizsgálja a munkaszál-döntések optimális számát a terv gyorsítótárából. Például egy gyorsítótárazott párhuzamos terv egyik végrehajtása sorosan futhat, ugyanannak a tervnek egy későbbi végrehajtása három worker szálat használhat, a harmadik pedig négy worker szálat használhat.
A párhuzamos lekérdezésvégrehajtási terv frissítési és törlési operátorait a rendszer sorosan hajtja végre, de egy WHEREUPDATE utasítás vagy DELETE utasítás záradéka párhuzamosan is végrehajtható. A tényleges adatváltozások ezután sorozatosan lesznek alkalmazva az adatbázisra.
Az adatbázis kompatibilitási szint 110-től kezdve a SELECT ... INTO utasítás párhuzamosan végrehajtható. A beillesztési operátorok egyéb formái ugyanúgy működnek, az előzőekben leírt módon.
A 130-as adatbázis-kompatibilitási szinttől kezdve az INSERT ... SELECT utasítás párhuzamosan futtatható halmokba vagy fürtözött oszloptár-indexekbe történő beszúráskor, valamint a TABLOCK hint használatával. A helyi ideiglenes táblákba (az # előtaggal jelölve) és a globális ideiglenes táblákba (előtagokkal azonosítva ## ) beillesztések is engedélyezettek párhuzamosságra a TABLOCK hint használatával. További információért lásd INSERT.
A statikus és a kulcskészlet-vezérelt kurzorok párhuzamos végrehajtási tervekkel tölthetők fel. A dinamikus kurzorok viselkedését azonban csak soros végrehajtással lehet biztosítani. A Lekérdezésoptimalizáló mindig létrehoz egy sorozatvégrehajtási tervet egy dinamikus kurzor részét képező lekérdezéshez.
A párhuzamossági fok felülbírálása
A párhuzamosság mértéke beállítja a párhuzamos terv végrehajtásához használni kívánt processzorok számát. Ezt a konfigurációt különböző szinteken állíthatod be:
Szerver szinten, a max degree of parallelism (
MAXDOP) szerverkonfigurációs beállítás használatával.A következőkre vonatkozik: SQL Server
Az SQL Server 2019 (15.x) automatikus ajánlásokat vezetett be a
MAXDOPszerver konfigurációs opció beállítására a telepítés során. A beállítási felhasználói felületen elfogadhatja az ajánlott beállításokat, vagy saját értéket adhat meg. További információ: Adatbázismotor konfigurációja – MaxDOP oldal.A munkaterhelési szint a
MAX_DOP.A következőkre vonatkozik: SQL Server
Adatbázis szinten, az
MAXDOPadatbázis-hatókörű konfiguráció használatával.Vonatkozik erre: SQL Server, Azure SQL Database és Azure SQL Managed Instance
Lekérdezés- vagy indexutasítás szintjén, a
MAXDOPvagyMAXDOPindexbeállítás használatával. Például aMAXDOPopcióval szabályozhatod, növelve vagy csökkentve az online indexművelethez dedikált processzorok számát. Így egyensúlyba hozhatod az indexművelet erőforrásait az egyidejű felhasználók erőforrásaival.Vonatkozik erre: SQL Server, Azure SQL Database és Azure SQL Managed Instance
A max degree of parallelism beállítás 0 értékre állítása (alapértelmezett) lehetővé teszi, hogy a Database Engine az összes elérhető processzort használja, legfeljebb 64 processzorig, a párhuzamos terv végrehajtása során. Bár a Database Engine 64 logikai processzort állít be futásidejű célként, ha az MAXDOP opció értéke 0, szükség esetén manuálisan is beállíthatsz egy másik értéket. A MAXDOP érték 0 értékre állítása lekérdezések és indexek esetén lehetővé teszi a Database Engine számára, hogy az adott lekérdezésekhez vagy indexekhez párhuzamos tervvégrehajtás során az összes rendelkezésre álló processzort használja, legfeljebb 64 processzorig.
MAXDOP nem minden párhuzamos lekérdezésre kényszerített érték, hanem inkább irányérték minden, párhuzamosításra alkalmas lekérdezéshez. Ez azt jelenti, hogy ha futásidőben nincs elég munkaszál, egy lekérdezés alacsonyabb fokú párhuzamossággal futhat, mint amit a MAXDOP szerverkonfigurációs beállítás megad.
Jótanács
További információkért lásd: a MAXDOP-ajánlásokat, amelyek útmutatást nyújtanak a MAXDOP kiszolgáló, adatbázis, lekérdezés vagy lekérdezési hint szintjén történő konfigurálásához.
Párhuzamos lekérdezési példa
A következő lekérdezés számolja a rendelések számát egy adott negyedévben, 2024. április 1-jétől kezdődően, és amelyben a rendelés legalább egy tételét az ügyfél a vállalt határidő után kapta meg. Ez a lekérdezés felsorolja az ilyen rendelések számát az egyes rendelési prioritások szerint csoportosítva és növekvő prioritási sorrendben rendezve.
Ez a példa elméleti tábla- és oszlopneveket használ.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Tegyük fel, hogy a következő indexek vannak definiálva a lineitemorders táblákon:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Íme egy lehetséges párhuzamos terv, amely a korábban megjelenített lekérdezéshez jön létre:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
A következő ábra egy olyan lekérdezési tervet mutat be, amelyet 4 mértékű párhuzamossággal hajtanak végre, és amely egy két tábla közötti összekapcsolást tartalmaz.
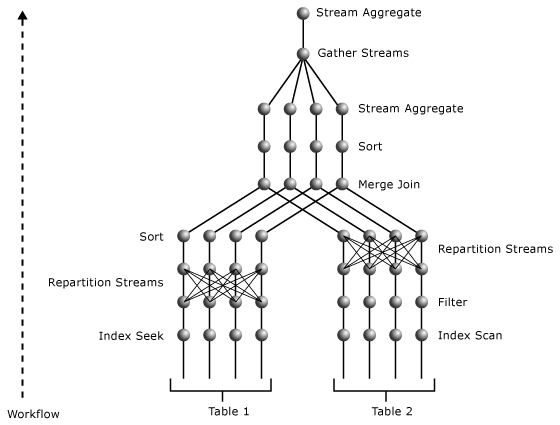
A párhuzamos terv három párhuzamossági operátort tartalmaz. Az o_datkey_ptr index Indexkeresés operátora és a l_order_dates_idx index Indexvizsgálat operátora is párhuzamosan történik. Ez a folyamat több különálló adatfolyamot eredményez, amelyek a legközelebbi, az Index Scan, illetve az Index Seek operátorok felett található Parallelism operátorok alapján határozhatók meg. Mindkét művelet újraparticionálja az adatcsere típusát. Átrendezik az adatokat az adatfolyamok között, és ugyanannyi adatfolyamot generálnak a kimenetükön, mint a bemenetükön. Ez a streamek száma megegyezik a párhuzamosság mértékével.
A l_order_dates_idx Index Scan operátor felett lévő párhuzamos operátor újraosztja a bemeneti folyamokat, a L_ORDERKEY értékét kulcsként használva. Így ugyanazok az értékek L_ORDERKEY ugyanabban a kimeneti adatfolyamban lesznek. Ugyanakkor a kimeneti streamek megtartják az oszlop sorrendjét a L_ORDERKEY helyen, hogy megfeleljenek a Merge Join operátor bemeneti követelményének.
Az Index Seek operátor felett a párhuzamos operátor újraosztja bemeneti folyamait a O_ORDERKEY értékét használva. Mivel a bemenete nincs a(z) O_ORDERKEY oszlop értékei szerint rendezve, és ez az oszlop a(z) Merge Join operátor összekapcsolási oszlopa, a Sort operátor a párhuzamossági és a Merge Join operátor között biztosítja, hogy a bemenet az összekapcsolási oszlopok szerint rendezve legyen a(z) Merge Join operátor számára. Az Sort operátor, mint a Merge Join operátor, párhuzamosan történik.
A legfelső párhuzamossági operátor több stream eredményeit gyűjti egyetlen streambe. A párhuzamossági operátor alatti Stream Aggregate operátor által végrehajtott részleges aggregációk ezután egyetlen SUM értékben kerülnek felhalmozásra a Stream Aggregate operátorban minden egyes különböző O_ORDERPRIORITY értékre a párhuzamossági operátor fölött. Mivel ennek a tervnek két csereszegmense van, amelyek párhuzamossági foka 4, nyolc munkafonalat használ.
További információkért a példában használt operátorokról lásd a Logikai és fizikai showplan-operátorok referenciáját.
Párhuzamos indexműveletek
Az indexműveletek lekérdezési tervei, amelyek indexet hoznak létre vagy újraépítenek, vagy törlik a klaszterelt indexet, támogathatják a párhuzamos, többszálas műveleteket olyan számítógépeken, amelyekben több processzor van.
Megjegyzés:
A párhuzamos index műveletek csak Enterprise kiadásban elérhetők.
A Database Engine ugyanazokat az algoritmusokat használja az indexműveletek párhuzamosságának (a futtatandó különálló munkafonalok teljes számának) meghatározására, mint más lekérdezéseknél. A 'max degree of parallelism' kiszolgálókonfigurációs beállítás határozza meg egy indexművelet maximális párhuzamossági fokát. Az egyes indexműveletekhez tartozó max degree of parallelism értéket felülírhatod, ha beállítod a(z) MAXDOP indexbeállítást a(z) ALTER INDEX, CREATE INDEX, DROP INDEX és ALTER TABLE utasításokban.
Amikor az SQL Server adatbázismotor indexvégrehajtási tervet készít, a párhuzamos műveletek száma a legalacsonyabb értékre kerül az alábbi értékek közül:
- A számítógépben lévő processzorok vagy CPU-k száma.
- A(z)
max degree of parallelismszerverkonfigurációs opcióban megadott szám. - Azon CPU-k száma, amelyek még nem haladták meg az SQL Server munkaszálai által végzett munka küszöbértékét.
Például egy olyan számítógépen, amelynek nyolc CPU-ja van, de ahol a max degree of parallelism értéke 6, az indexművelet legfeljebb hat párhuzamos munkaszálat használ. Ha a számítógép öt processzora túllépi az SQL Server-munka küszöbértékét egy index-végrehajtási terv létrehozásakor, a végrehajtási terv csak három párhuzamos munkaszálat határoz meg.
A párhuzamos index művelet fő fázisai a következők:
- A koordináló feldolgozói szál gyorsan és véletlenszerűen megvizsgálja a táblát az indexkulcsok eloszlásának becsléséhez. A koordináló munkafonal meghatározza azokat a kulcshatárokat, amelyek olyan számú kulcstartományt hoznak létre, amely megegyezik a párhuzamos műveletek fokával, ahol minden kulcstartomány becslése hasonló számú sort fed le. Például, ha a táblában négymillió sor van, és a párhuzamosság mértéke 4, a koordináló munkaszál határozza meg azokat a kulcsértékeket, amelyek négy, egyenként 1 millió sort tartalmazó sorhalmazt határolnak. Ha a koordináló munkaszál nem tud elegendő kulcstartományt meghatározni az összes CPU használatához, akkor ennek megfelelően csökkenti a párhuzamosság mértékét.
- A koordináló munkaszál több munkaszálat küld, amely egyenlő a párhuzamos műveletek mértékével, és megvárja, amíg ezek a munkaszálak befejezik a munkájukat. Minden munkaszál egy szűrővel ellenőrzi az alaptáblát, amely csak a munkaszálhoz rendelt tartományon belüli kulcsértékekkel rendelkező sorokat kéri le. Minden munkaszál létrehoz egy indexstruktúrát a kulcstartományában lévő sorokhoz. Particionált indexek esetén minden feldolgozói szál meghatározott számú partíciót hoz létre. A partíciók nincsenek megosztva a feldolgozói szálak között.
- Miután az összes párhuzamos munkaszál befejeződött, a koordináló munkaszál összekapcsolja az indexegységeket egyetlen indexbe. Ez a fázis csak offline indexműveletekre vonatkozik.
Az egyedi CREATE TABLE vagy ALTER TABLE állításoknak több korlátozása is lehet, amelyek miatt indexet kell létrehozni. Ezeket a több indexlétrehozási műveletet sorozatokban hajtja végre, bár minden egyes indexlétrehozási művelet párhuzamos művelet lehet egy olyan számítógépen, amelyen több PROCESSZOR található.
Elosztott lekérdezési architektúra
A Database Engine két módszert támogat heterogén OLE DB adatforrásokra való hivatkozásra T-SQL állításokban:
Csatolt kiszolgálónevek
Használd a
sp_addlinkedserveréssp_addlinkedsrvloginrendszerben tárolt eljárásokat ahhoz, hogy szervernevet adj egy OLE DB-adatforrásnak. Az ezen kapcsolt szervereken található objektumokra T-SQL utasításokban négyrészes nevekkel is lehet hivatkozni. Ha például egy csatolt kiszolgáló neveDeptSQLSrvraz SQL Server egy másik példányán van definiálva, az alábbi utasítás hivatkozik egy táblára az adott kiszolgálón:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;A kapcsolt szerver nevét is megadhatod egy
OPENQUERYutasításban, hogy megnyithass egy sorhalmazt az OLE DB adatforrásból. Ezután erre a sorhalmazra táblaként hivatkozhatsz T-SQL utasításokban.Alkalmi összekötők nevei
Ritka adatforrásra való hivatkozások esetén határozzuk meg az
OPENROWSETvagyOPENDATASOURCEfüggvényeket az összekapcsolt szerverhez való csatlakozáshoz szükséges információkkal. Ezután ugyanúgy hivatkozhatsz a sorhalmazra, ahogy egy táblázatra hivatkozol a T-SQL utasításokban:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
A Database Engine az OLE DB-t használja a relációs motor és a tárolómotor közötti kommunikációra. A relációs motor minden T-SQL utasítást egy sor műveletre bont le az alap OLE DB sorhalmazakon, amelyeket a tárolómotor az alaptáblákból nyit meg. Ez a folyamat azt jelenti, hogy a relációs motor bármely OLE DB adatforráson alapvető OLE DB sorhalmazokat is meg tud nyitni.
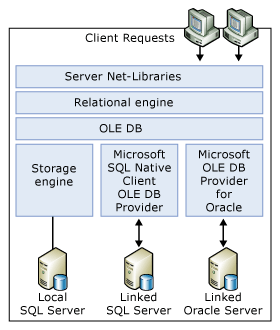
A relációs motor az OLE DB alkalmazásprogramozási felületével (API) nyitja meg a sorhalmazokat a csatolt kiszolgálókon, lekéri a sorokat, és kezeli a tranzakciókat.
Minden OLE DB adatforráshoz, amelyet csatolt szerverként érsz el, az SQL Server-t futtató szervernek rendelkeznie kell egy OLE DB szolgáltatóval. Az, hogy milyen T-SQL műveleteket lehet használni egy adott OLE DB adatforrás ellen, az OLE DB szolgáltató képességeitől függ.
Az SQL Server minden példánya esetén a sysadmin rögzített kiszolgálószerepkör tagjai engedélyezhetik vagy letilthatják az ad hoc összekötőnevek használatát egy OLE DB szolgáltatóprogram számára az SQL Server DisallowAdhocAccess tulajdonság használatával. Ha engedélyezed az ad hoc hozzáférést, az adott példányba bejelentkezett bármely felhasználó végrehajthat T-SQL utasításokat, amelyek ad hoc szolgáltatóneveket tartalmaznak, hivatkozva bármely adatforrásra a hálózaton, amelyhez az OLE DB szolgáltató hozzáférhet. Az adatforrásokhoz való hozzáférés szabályozásához a sysadmin rögzített kiszolgálói szerepkör tagjai letilthatják az adott OLE DB szolgáltató ad hoc hozzáférését, így a felhasználók csak az adminisztrátorok által meghatározott kapcsolt szervernevek által hivatkozott adatforrásokra korlátozhatók. Alapértelmezés szerint az alkalmi hozzáférés engedélyezve van az SQL Server OLE DB-szolgáltatóhoz, és minden más OLE DB-szolgáltató esetében le van tiltva.
Az elosztott lekérdezések lehetővé teszik a felhasználók számára, hogy más adatforrásokhoz (például fájlokhoz, nem relációs adatforrásokhoz, mint az Active Directory stb.) hozzáférjenek annak a Windows-fióknak a biztonsági kontextusában, amely alatt az SQL Server szolgáltatás fut. Az SQL Server megfelelően megszemélyesíti a bejelentkezési fiókot a Windows bejelentkezésekhez. Azonban ez a megszemélyesítés nem lehetséges SQL Server bejelentkezéseknél. Ez a korlátozás potenciálisan lehetővé teheti, hogy egy elosztott lekérdezési felhasználó hozzáférjen egy másik adatforráshoz, amelyhez nincs jogosultsága, de az a fiók, amely alatt az SQL Server szolgáltatás fut, rendelkezik jogosultságokkal. A sp_addlinkedsrvlogin használatával határozza meg azokat a konkrét bejelentkezéseket, amelyek jogosultak a kapcsolt kiszolgáló elérésére. Ez a beállítás nem érhető el ad hoc nevek esetén, ezért legyen óvatos, amikor egy OLE DB-szolgáltatót ad hoc hozzáféréshez engedélyez.
Lehetőség szerint a Database Engine az olyan relációs műveleteket, mint például az illesztéseket, korlátozásokat, vetítéseket, rendezéseket és GROUP BY műveleteket, az OLE DB adatforrásba küldi. A Database Engine alapértelmezés szerint nem szkenneli az alaptáblát az SQL Server számára, és maga végzi el a relációs műveleteket. A Database Engine az OLE DB szolgáltatóhoz fordul, hogy meghatározza, milyen szintű SQL-nyelvtant támogat, és ezen információk alapján minél több relációs műveletet ad át a szolgáltatónak.
A Database Engine egy mechanizmust határoz meg egy OLE DB szolgáltató számára, hogy statisztikákat adjon vissza, amely megmutatja, hogyan oszlanak el a kulcsértékek az OLE DB adatforrásban. Ez a mechanizmus lehetővé teszi, hogy a Database Engine Query Optimizer jobban elemezze az adatforrásban található adatmintát az egyes T-SQL utasítások követelményeivel szemben, növelve a Query Optimizer képességét az optimális végrehajtási tervek létrehozásában.
Lekérdezésfeldolgozás partíciós táblákon és indexeken
A Database Engine támogatja a partíciós alapú lekérdezésfeldolgozást partíciós táblák és indexek esetén. Ez a rész bemutatja, hogyan kezeli a lekérdezésfeldolgozó a particionált objektumokat, hogyan kell értelmezni a particionálást érintő végrehajtási terveket, valamint a legjobb gyakorlatokat a lekérdezések teljesítményének javítására a particionált objektumok esetében.
Megjegyzés:
A partíciós táblák és indexek támogatottak az SQL Server Standard kiadásban, kezdve az SQL Server 2016 (13.x) Service Pack 1-gyel.
Új partícióérzékeny keresési művelet
A Database Engine-ben a lekérdezésfeldolgozó belsőleg egy partíciós táblát többoszlopos indexként lát, amelynek vezető oszlopa a PartitionID.
PartitionID egy rejtett számított oszlop, amely belsőleg egy adott sort tartalmazó partíciót jelöl ID . Például tegyük fel, hogy a(z) T tábla, amely a következőképpen van definiálva: T(a, b, c), a a oszlop szerint particionált, és a b oszlopon klaszterezett indexe van. Ez a particionált tábla nem particionált táblaként van kezelve a(z) T(PartitionID, a, b, c) sémával és a(z) (PartitionID, b) összetett kulcson lévő klaszterezett indexszel. Ez a reprezentáció lehetővé teszi a lekérdezésoptimalizáló számára, hogy bármely particionált táblán vagy indexen PartitionID alapján keresési műveleteket végezzen.
A partíciók kizárása most ebben a keresési műveletben történik.
Ezen felül a Lekérdezésoptimalizáló kibővült, így egy keresési vagy szkennelési művelet egyetlen feltétellel végrehajtható a(z) PartitionID elemen (mint logikai vezető oszlopon), és esetleg más indexkulcs-oszlopokon is. A lekérdezési processzor ezután egy második szintű keresést végez egy másik feltétellel, egy vagy több további oszlopon minden egyes olyan különálló érték esetén, amely megfelel az első szintű keresési művelet kvalifikációjának. Ez a művelet, amelyet partition skip scannek neveznek, lehetővé teszi a lekérdezésoptimalizáló számára, hogy egy feltétel alapján végezzen keresési vagy szkennelési műveletet a hozzáférendő partíciók meghatározásához, valamint egy második szintű indexkeresési műveletet az adott operátoron belül, amely visszaadja azokat a sorokat ezekből a partíciókból, amelyek más feltételeknek felelnek meg. Vegyük például a következő lekérdezést.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Ehhez a példához tegyük fel, hogy a T táblázat, amelynek definíciója T(a, b, c), a a oszlop alapján van particionálva, és a b oszlopon klaszterelt indexe van. A következő partíciós függvény határozza meg a tábla Tpartíciós határait:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
A lekérdezés megoldásához a lekérdezésfeldolgozó első szintű keresési műveletet hajt végre, hogy megkeresse a feltételnek T.a < 10megfelelő sorokat tartalmazó összes partíciót. Ez a művelet azonosítja az elérendő partíciókat. Minden azonosított partíción belül a processzor második szintű keresést végez a(z) b oszlop klaszterezett indexében, hogy megtalálja azokat a sorokat, amelyek megfelelnek a T.b = 2 és T.a < 10 feltételnek.
Az alábbi illusztráció a partíciós skip szkennelés műveletének logikai ábrázolása. A(z) T táblázatot mutatja, ahol az adatok a a és b oszlopokban találhatók. A partíciók száma 1–4, a partíció határai szaggatott függőleges vonalakkal jelennek meg. A partíciókhoz végrehajtott első szintű keresési művelet (az ábrán nem látható) megállapítja, hogy az 1., 2. és 3. partíció megfelel a tábla partícionálása és a(z) T.a < 10 oszlopra vonatkozó predikátum (a) által implikált keresési feltételnek. A második szintű pozicionálás által bejárt útvonalat a görbe vonal szemlélteti. Lényegében a művelet mindegyik partícióban megkeresi azokat a sorokat, amelyek megfelelnek a b = 2 feltételnek. A művelet teljes költsége megegyezik három különálló indexkeresésével.
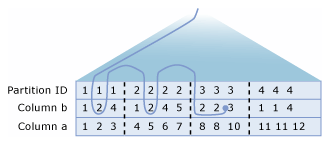
Particionálási információk megjelenítése a lekérdezés-végrehajtási tervekben
Vizsgálja meg a lekérdezések végrehajtási terveit partíciós táblákon és indexeken a T-SQL SET utasításokkal SET SHOWPLAN_XML vagy SET STATISTICS XML, vagy az SSMS-ben a grafikus végrehajtási terv kimenetével. Például megjelenítheted a becsült végrehajtási tervet úgy, hogy a Lekérdezésszerkesztő eszközsávon kiválasztod a Display Estimated Execution Plan lehetőséget, a futásidejű tervet pedig a Tényleges végrehajtási terv belefoglalása lehetőség kiválasztásával.
Ezeknek az eszközöknek a használatával a következő információkat találhatjuk:
- Az olyan műveletek, mint a szkennelések, pozicionálások, beillesztések, frissítések, egyesítések és törlések, amelyek particionált táblákat vagy indexeket érnek el.
- A lekérdezés által elért partíciók. Például a futásidejű végrehajtási tervek tartalmazzák az elért partíciók teljes számát és az összefüggő partíciók tartományait.
- Amikor egy partíciókihagyásos keresési vagy pásztázási műveletet alkalmaznak egy keresési vagy pásztázási műveletben, hogy adatokat kérjenek le egy vagy több partícióból.
Partícióinformációk fejlesztései
A Database Engine továbbfejlesztett partíciós információkat nyújt mind a fordítási, mind a futási idejű végrehajtási tervek számára. A végrehajtási tervek most a következő információkat adják meg:
- Egy opcionális
Partitionedattribútum, amely jelzi, hogy egy operátor, például keresési művelet, beolvasás, behelyezés, frissítés, egyesítés vagy törlés egy partíciós táblán történik. - Új
SeekPredicateNewelem egySeekKeysalelemmel, amely a vezető index kulcsoszlopként aPartitionID-t tartalmazza, és olyan szűrési feltételeket határoz meg, amelyek tartománykereséseket végeznek aPartitionIDsegítségével. KétSeekKeysalelem jelenléte partíciókihagyásos vizsgálatot jelez aPartitionID. - Összegző információk, amelyek az elért partíciók teljes számát megadják. Ez az információ csak futásidejű tervekben érhető el.
Annak bemutatásához, hogy ezek az információk hogyan jelennek meg mind a grafikus végrehajtási terv kimenetében, mind az XML Showplan kimenetében, vegye figyelembe a particionált tábla fact_saleskövetkező lekérdezését. Az adatokat két partíción frissíti ez a lekérdezés.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
Az alábbi ábrán az Clustered Index Seek operátor tulajdonságai láthatók a lekérdezés futtatókörnyezeti végrehajtási tervében. A fact_salestábla és a partíció definíciójának megtekintéséhez lásd Példa.
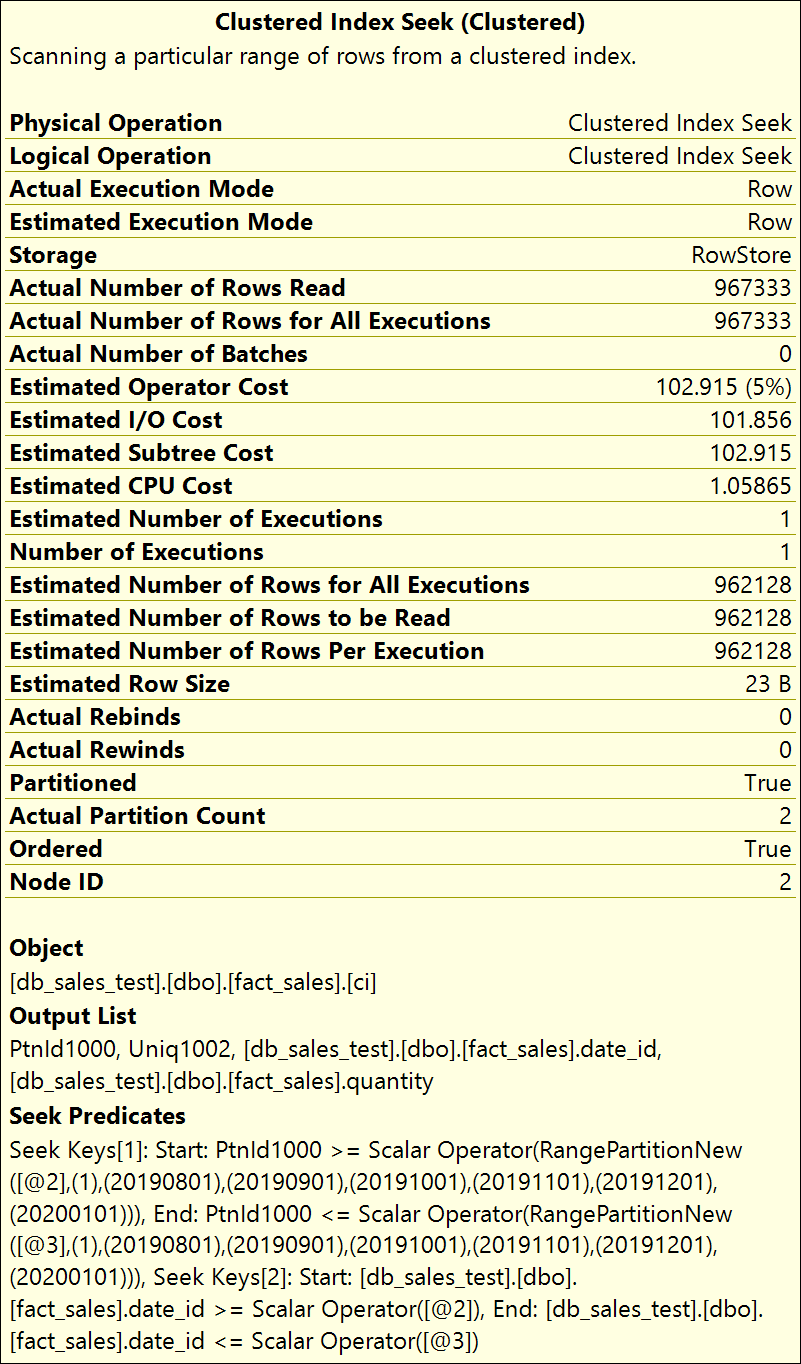
Particionált attribútum
Ha egy operátort, például egy indexkeresést egy particionált táblán vagy indexen hajtanak végre, az Partitioned attribútum megjelenik a fordítási idő és a futási idő tervében, és az (1) értékre True van állítva. Az attribútum nem jelenik meg, ha False (0) értékre van állítva.
Az Partitioned attribútum a következő fizikai és logikai operátorokban jelenhet meg:
- Táblavizsgálat
- Indexvizsgálat
- Indexkeresés
- Beilleszt
- Frissítés
- Törlés
- Egyesítés
Ahogy az előző ábrázon is látható, ez az attribútum megjelenik annak az operátornak a tulajdonságaiban, amelyben definiálják. Az XML Showplan kimenetben ez az attribútum Partitioned="1" formában jelenik meg annak az operátornak a RelOp csomópontjában, amelyben definiálva van.
Új keresési predikátum
Az XML Showplan kimenetben az SeekPredicateNew elem megjelenik abban az operátorban, amelyben definiálták. A SeekKeys al-eleme legfeljebb két előfordulást tartalmazhat. Az első SeekKeys elem a logikai index partícióazonosító szintjén adja meg az első szintű keresési műveletet. Vagyis ez a seek művelet határozza meg azokat a partíciókat, amelyeket elérni kell a lekérdezés feltételeinek teljesítéséhez. A második SeekKeys tétel meghatározza a második szintű keresést, amely az első szintű keresésben azonosított egyes partíciókon belül történik.
Partícióösszegzési információk
A futásidejű végrehajtási tervekben a partícióösszegzési információk a elért partíciók számát és a ténylegesen elért partíciók identitását biztosítják. Ezekkel az információkkal ellenőrizheti, hogy a megfelelő partíciók elérhetők-e a lekérdezésben, és hogy az összes többi partíció nincs-e figyelembe véve.
A rendszer a következő információkat adja meg: Actual Partition Countés Partitions Accessed.
Actual Partition Count A lekérdezés által elért partíciók teljes száma.
Partitions Accessed, az XML Showplan kimenetben az a partíciós összefoglaló információ, amely megjelenik az operátor azon RelOp csomópontjának új RuntimePartitionSummary elemében, amelyben definiálva van. Az alábbi példa az RuntimePartitionSummary elem tartalmát mutatja be, amely azt jelzi, hogy két teljes partíció érhető el (2. és 3. partíció).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Partícióinformációk megjelenítése más showplan metódusok használatával
A Showplan metódusok SHOWPLAN_ALL, SHOWPLAN_TEXTés STATISTICS PROFILE nem jelentik a cikkben leírt partícióadatokat az alábbi kivétellel. A predikátum részeként a SEEK elérendő partíciókat a partícióazonosítót reprezentáló számított oszlop tartomány predikátuma azonosítja. Az alábbi példa egy SEEKClustered Index Seek operátor predikátumát mutatja be. A 2. és a 3. partíció elérhető, a keresési operátor pedig a feltételnek date_id BETWEEN 20190802 AND 20190902megfelelő sorokra szűr.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Particionált halom végrehajtási terveinek értelmezése
A particionált halom logikai indexként van kezelve a partícióazonosítón. Egy végrehajtási tervben a particionált halom partíciókizárása egy Table Scan operátorként van ábrázolva, a partícióazonosítóra vonatkozó SEEK predikátummal. Az alábbi példa a Showplan megadott adatait mutatja be:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Az csoportosított illesztések végrehajtási terveinek értelmezése
Illesztési rendezés akkor fordulhat elő, ha két tábla particionálása ugyanazzal a vagy azzal egyenértékű particionálási függvénnyel történik, és az illesztés mindkét oldalának particionálási oszlopai a lekérdezés illesztési feltételében vannak megadva. A Lekérdezésoptimalizáló létrehozhat egy tervet, amelyben az egyenlő partícióazonosítóval rendelkező táblák partíciói külön csatlakoznak egymáshoz. Az csoportosított illesztések gyorsabbak lehetnek, mint a nem csoportosított illesztések, mivel kevesebb memóriát és feldolgozási időt igényelhetnek. A Lekérdezésoptimalizáló a költségbecslések alapján nem csoportosított vagy csoportosított tervet választ.
Egy csoportosított tervben az Nested Loops illesztés egy vagy több összekapcsolt tábla- vagy indexpartíciót olvas be a belső oldalról. Az operátorok számai a Constant Scan partíciószámokat jelölik.
Ha particionált táblákhoz vagy indexekhez párhuzamos tervek jönnek létre az csoportosított illesztésekhez, a párhuzamosság operátora jelenik meg az Constant ScanNested Loops illesztés operátorai között. Ebben az esetben az illesztés külső oldalán több feldolgozószál mindegyike más-más partíciót olvas és dolgozik fel.
Az alábbi ábra egy csoportosított illesztés párhuzamos lekérdezési tervét mutatja be.
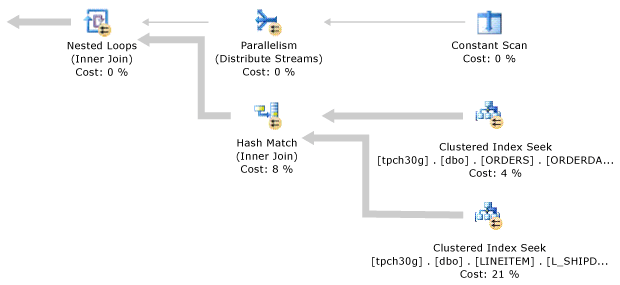
Párhuzamos lekérdezésvégrehajtási stratégia particionált objektumokhoz
A lekérdezésfeldolgozó párhuzamos végrehajtási stratégiát használ a particionált objektumokból kiválasztott lekérdezésekhez. A végrehajtási stratégia részeként a lekérdezésfeldolgozó határozza meg a lekérdezéshez szükséges táblapartíciókat, valamint az egyes partíciókhoz lefoglalandó feldolgozói szálak arányát. A lekérdezésfeldolgozó a legtöbb esetben egyenlő vagy majdnem azonos számú feldolgozószálat foglal le az egyes partíciókhoz, majd párhuzamosan hajtja végre a lekérdezést a partíciók között. Az alábbi bekezdések részletesebben ismertetik a munkavégző szálak kiosztását.
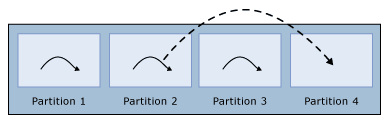
Ha a munkavégző szálak száma kisebb, mint a partíciók száma, a lekérdezésfeldolgozó az egyes feldolgozói szálakat egy másik partícióhoz rendeli hozzá, és kezdetben egy vagy több partíciót hagy hozzárendelt munkaszál nélkül. Amikor egy worker szál befejezi a futtatást egy partíción, a lekérdezésfeldolgozó hozzárendeli a következő partícióhoz, amíg minden partícióhoz egyetlen worker szál nincs hozzárendelve. Ez a feladat az egyetlen eset, amikor a lekérdezésfeldolgozó áthelyezi a munkaszálakat más partíciókra.
A munkaszál újbóli hozzárendelését jeleníti meg a befejezés után. Ha a feldolgozószálak száma megegyezik a partíciók számával, a lekérdezésfeldolgozó minden partícióhoz egy feldolgozószálat rendel. Amikor egy feldolgozószál befejeződik, a rendszer nem helyezi át egy másik partícióra.
Ha a feldolgozószálak száma nagyobb, mint a partíciók száma, a lekérdezésfeldolgozó egyenlő számú feldolgozószálat foglal le az egyes partíciókhoz. Ha a munkaszálak száma nem a partíciók számának pontos többszöröse, a lekérdezésfeldolgozó egy plusz worker szálat rendel néhány partícióhoz, hogy az összes elérhető worker szálat felhasználhassa. Ha csak egy partíció van, akkor az összes worker szál ahhoz a partícióhoz van rendelve. A következő ábrán négy partíció és 14 munka szál található. Minden partícióhoz három munkaszál tartozik, két partícióhoz pedig egy plusz munkaszál, így összesen 14 munkaszál-kiosztás. Amikor egy feldolgozószál befejeződik, a rendszer nem rendeli hozzá másik partícióhoz.
Bár az előző példák egyértelmű módot javasolnak a munkaszálak elosztására, a tényleges stratégia összetettebb, és figyelembe veszi a lekérdezés végrehajtása során előforduló egyéb változókat. Például, ha a tábla partíciózva van, és a(z) A oszlopon klaszterezett indexe van, és a lekérdezés predikátumzáradéka WHERE A IN (13, 17, 25), a lekérdezésfeldolgozó egy vagy több munkaszálat rendel e három keresési érték (A = 13, A = 17 és A = 25) mindegyikéhez az egyes táblapartíciók helyett. Csak azokban a partíciókban kell végrehajtani a lekérdezést, amelyek ezeket az értékeket tartalmazzák, és ha ezek a keresési predikátumok mind ugyanabban a táblapartícióban vannak, akkor minden munkaszál ugyanarra a táblapartícióra van rendelve.
Egy másik példaként tegyük fel, hogy a táblázatban négy partíció van a A oszlopon, (10, 20, 30) határpontokkal, egy index a B oszlopon, és a lekérdezésnek van egy WHERE B IN (50, 100, 150) predikátumfeltétele. Mivel a táblapartíciók a(z) A értékein alapulnak, B értékei bármely táblapartícióban előfordulhatnak. Így a lekérdezési processzor a négy táblapartíció mindegyikében az B három értékének mindegyikét (50, 100, 150) keresi. A lekérdezésfeldolgozó arányosan rendeli a munkaszálakat úgy, hogy e 12 lekérdezésvizsgálat mindegyikét párhuzamosan tudja végrehajtani.
Táblapartíciók oszlop alapján A |
Oszlopot B keres minden táblapartícióban |
|---|---|
1. táblapartíció: A < 10 |
\ |
Táblapartíció 2: A >= 10 AND A < 20 |
\ |
Táblapartíció 3: A >= 20 AND A < 30 |
\ |
Táblapartíció 4: A >= 30 |
\ |
Ajánlott eljárások
A nagy mennyiségű adathoz hozzáférő, nagy particionált táblákat és indexeket használó lekérdezések teljesítményének javításához kövesse ezeket a bevált gyakorlatokat:
Az egyes partíciók több lemezen való csíkozása. Ez a megközelítés különösen releváns forgó lemezes meghajtók használatakor.
Ha lehetséges, használjon olyan kiszolgálót, amely elegendő fő memóriával rendelkezik a gyakran használt partíciók vagy a memóriában lévő összes partíció elféréséhez az I/O-költségek csökkentése érdekében.
Ha a lekérdezett adatok nem férnek be a memóriába, tömörítsd a táblákat és indexeket, hogy csökkentsd az I/O költségeket.
Használjon olyan kiszolgálót, amely gyors processzorokkal és annyi processzormaggal rendelkezik, amennyit megengedhet magának, hogy kihasználhassa a párhuzamos lekérdezésfeldolgozási képességet.
Győződjön meg arról, hogy a kiszolgáló rendelkezik elegendő I/O-vezérlő sávszélességével.
Hozzon létre fürtözött indexet nagy particionált táblákon a B-fa keresési optimalizációk kihasználása érdekében.
Amikor adatokat tömegesen betöltünk partíciós táblázatba, kövesd a legjobb gyakorlati ajánlásokat a fehér könyvben, a The Data Loading Performance Guide-ban.
példa
Az alábbi példa egy hét partícióval rendelkező táblát tartalmazó tesztadatbázist hoz létre. A fordítási idejű és futási idejű tervek particionálási információinak megtekintéséhez használja a Particionálási információk megjelenítése a lekérdezés-végrehajtási tervekben című témakörben ismertetett eszközöket a példában szereplő lekérdezések végrehajtásakor.
Megjegyzés:
Ez a példa több mint 1 millió sort szúr be a táblázatba. A példa futtatása a hardvertől függően több percet is igénybe vehet. A példa végrehajtása előtt győződjön meg arról, hogy több mint 1,5 GB lemezterület áll rendelkezésre.
Megjegyzés:
Az Azure SQL Database-ben és a Microsoft Fabric SQL-adatbázisában a USE utasítás nem érhető el. Ehelyett csatlakozz közvetlenül a master-hoz és a kívánt felhasználói adatbázisokhoz külön-külön. Futtassa a kódminta minden kötegét azon az adatbázis-kapcsolaton, amelyet a USE utasítás nevez meg.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE [db_sales_test];
GO

CREATE DATABASE [db_sales_test];
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Kapcsolódó tartalom
- Logikai és fizikai showplan operátor referenciája
- bővített események áttekintése
- Legjobb gyakorlatok a számítási feladatok figyelésére a Lekérdezéstárral
- Számosságbecslés (SQL Server)
- intelligens lekérdezésfeldolgozás SQL-adatbázisokban
- Operátorok elsőbbsége (Transact-SQL)
- végrehajtási terv áttekintése
- Teljesítmény Központ a SQL Server adatbázismotor és Azure SQL Database részére