Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Important
Fitur ini ada di Beta.
Untuk informasi umum tentang pengujian unit Python di Databricks, lihat pengujian unit Python.
Pipeline Lakeflow mendukung penulisan pengujian unit Python di Editor Lakeflow Pipelines berbasis web. Ini memungkinkan Anda memvalidasi logika transformasi Python atau SQL menggunakan data tiruan. Dengan kerangka kerja pengujian pipeline, Anda dapat menguji kasus ekstrem, memvalidasi API pipeline proprieter (Auto CDC, tabel streaming, ekspektasi, alur append), dan melakukan iterasi menggunakan input tiruan untuk operasi pengidentifikasi tabel yang didukung. Tinjau batasan isolasi sebelum menjalankan pengujian.
- Eksekusi pengujian terisolasi: Kerangka kerja menyediakan SparkSession yang mengalihkan operasi tabel ke skema pengujian sementara di katalog default alur, sehingga Anda dapat meniru data input dan menulis output pengujian tanpa memengaruhi tabel produksi. Isolasi berlaku untuk operasi yang mereferensikan tabel berdasarkan nama; lihat Batasan.
- Cakupan pengujian yang fleksibel: Jalankan sebagian alur (tabel tertentu, rangkaian tabel yang saling bergantung, atau seluruh alur) dengan menggunakan komputasi alur tersebut melalui SparkSession pengujian.
- Validasi hasil: Verifikasi hasil tabel output terisolasi yang dibuat dalam pengujian menggunakan pernyataan pytest standar.
Kapan menggunakan pengujian unit
Kasus penggunaan yang umum meliputi:
- Memvalidasi logika transformasi baru: Uji bahwa transformasi Anda menghasilkan skema yang diharapkan, jumlah baris, agregasi, dan logika bisnis sebelum berjalan terhadap data produksi.
- Menguji spesifikasi CDC Otomatis: Validasi bahwa definisi alur CDC Otomatis Anda memproses peristiwa perubahan dengan benar, menangani penyisipan, pembaruan, penghapusan, dan jenis SCD (Dimensi yang Berubah Perlahan), menggunakan data tiruan.
- Ekspektasi pengujian dan aturan kualitas data: Verifikasi bahwa ekspektasi gagal saat seharusnya gagal dan lolos saat data valid.
- Pengujian di seluruh tabel dependen: Uji rantai transformasi (misalnya, perunggu, perak, dan emas) untuk memvalidasi bahwa data mengalir dengan benar melalui grafik alur Anda.
Requirements
Pipeline
Ownerizin, ditambah hak istimewaUSE CATALOGdanCREATE SCHEMApada katalog bawaan pipeline. Kerangka kerja membutuhkan hak istimewa ini untuk membuat skema pengujian sementara tempat pengujian dijalankan.Untuk memeriksa atau mengatur izin alur, buka alur dan klik Bagikan. Anda harus menjadi alur
Owner(IS OWNER);CAN RUNdanCAN MANAGEtidak cukup untuk menjalankan pengujian. Lihat Mengonfigurasi izin alur.Untuk memeriksa atau mengatur hak istimewa katalog, buka katalog di Catalog Explorer, pilih tab Izin , dan konfirmasikan bahwa Anda memiliki
USE CATALOGdanCREATE SCHEMA. Pemilik katalog, admin metastore, atau pengguna denganMANAGEhak istimewa dapat memberikannya, termasuk dengan SQL:GRANT USE CATALOG, CREATE SCHEMA ON CATALOG <catalog_name> TO `<principal>`;Untuk informasi selengkapnya, lihat Referensi hak istimewa Katalog Unity.
Alur harus dikonfigurasi dalam mode dipicu (tidak berkelanjutan).
Pipeline harus berjalan pada Databricks Runtime 18.1 atau versi lebih tinggi. Versi runtime yang lebih lama tidak menyertakan modul pengujian unit. Untuk memeriksa versi runtime yang digunakan saat pembaruan dijalankan, periksa log peristiwa pipeline. Lihat informasi waktu proses .
Spark Connect tidak didukung.
Note
Isolasi pengujian mencakup operasi tabel yang mereferensikan tabel berdasarkan nama. Operasi yang melewati isolasi dapat terjadi baik dalam kode pengujian Anda maupun dalam kode alur apa pun yang dijalankan oleh output yang Anda pilih, termasuk dependensi transitifnya. Berkas uji yang tampak aman masih dapat menjalankan alur pipeline yang membaca atau menulis melalui jalur atau konektor, yang beroperasi pada data produksi. Agar pengujian tidak memengaruhi data produksi atau metadata, ikuti aturan berikut:
- Referensikan setiap tabel menurut nama (
catalog.schema.table), dan tirukan semua input berdasarkan nama. Jangan membaca atau menulis berdasarkan jalur (/Volumes/...,dbfs:/...,s3://...,abfss://...) dan jangan membaca dari konektor seperti Kafka atau Auto Loader. Ini melewati isolasi dan bertindak pada sistem produksi nyata. - Jangan menjalankan pernyataan tata kelola atau kepemilikan, seperti
GRANT, ,REVOKEALTER ... OWNER TO,SET/UNSET TAGS, atau .CREATE/DROP POLICYIni dijalankan pada objek produksi nyata yang dapat diamankan. - Jangan membuat katalog atau skema (
CREATE CATALOG,CREATE SCHEMA). Ini mengarah ke metastore Unity Catalog Anda yang sebenarnya. - Jangan jalankan seluruh alur jika grafiknya mencakup input berbasis jalur, konektor, penulisan imperatif, atau efek samping eksternal lainnya. Pilih hanya output yang dependensinya menggunakan operasi tabel katalog yang didukung dan telah diganti dengan input tiruan.
Lihat Batasan untuk detailnya.
Keterbatasan
Warning
Beberapa operasi melewati isolasi pengujian dan dapat bertindak pada data atau metadata produksi nyata. Tinjau batasan berikut sebelum Anda menjalankan pengujian.
Isolasi pengujian hanya berdasarkan nama tabel
Jangan membaca atau menulis berdasarkan jalur atau konektor. Isolasi hanya mengalihkan operasi yang mereferensikan tabel berdasarkan nama (misalnya,
spark.read.table("catalog.schema.table")ataudf.write.saveAsTable("catalog.schema.table")). Operasi yang diakses melalui jalur atau konektor melewati isolasi dan beroperasi langsung pada sistem produksi nyata:-
Menulis berdasarkan jalur (misalnya,
df.write.save("/Volumes/..."), jalurdbfs:/, atau jalur cloud atau lokasi eksternal sepertis3://...atauabfss://...) akan menulis ke penyimpanan produksi yang sebenarnya dan dapat menimpa data produksi. -
Membaca berdasarkan path (misalnya,
spark.read.load(path)atauspark.read.format("delta").load(path)) akan mengembalikan data produksi yang sebenarnya, bukan mock Anda. -
Membaca data dari konektor menghubungkan ke sumber produksi yang sebenarnya. Ini mencakup Kafka (membaca dari broker sebenarnya) dan Auto Loader (
cloudFiles, yang membaca dari jalur penyimpanan cloud sebenarnya). Keduanya juga tidak dialihkan ke data mock Anda.
-
Menulis berdasarkan jalur (misalnya,
Jangan gunakan
event_log()fungsi bernilai tabel dalam pengujian unit alur. Dalam mode pengujian,event_log()tidak dialihkan ke log peristiwa uji coba Anda. Ini dapat mengembalikan data produksi atau log kejadian yang telah didaftarkan sebelumnya, sehingga asersi terhadapnya mungkin membaca data produksi. Dalam unit test, log peristiwa dikembalikan sebagai DataFrame oleh run yang sudah terfilter ke run tersebut. Gunakanstatus.event_loguntuk mengakses hasilnya. Skema pengujian tetap dapat dibaca setelah skema uji dihapus. Bisa saja (Nonemisalnya, jika nama tabel event-log tidak dapat diselesaikan), jadi periksa sebelum melakukan kueri:status = test_pipeline.run(test_spark, set(["catalog.schema.table"])) assert status.event_log is not None flow_progress = status.event_log.filter("event_type = 'flow_progress'")Untuk menerapkan assertion pada setiap eksekusi dalam pengujian, bukan hanya satu eksekusi, gunakan
test_pipeline.event_log. Lihat Testing APIs untuk seluruh set properti yang dikembalikan oleh run.Jangan menegaskan
status.is_successsebelum membaca log peristiwa jika tujuan Anda adalah mendiagnosis pembaruan yang gagal. Log peristiwa sering kali menjadi apa yang Anda periksa untuk memahami mengapa pembaruan gagal.
Operasi tata kelola dan DDL
- Katalog, skema, izin, kepemilikan, tag, dan mutasi kebijakan tidak didukung. Ini termasuk
CREATE/DROP/ALTER CATALOG,CREATE/DROP/ALTER SCHEMA(termasukSET MANAGED LOCATION),GRANT/REVOKE,ALTER ... OWNER TO,SET/UNSET TAGS, dan .CREATE/DROP POLICYBeberapa bentuk SQL yang dijalankan melaluitest_sparkditolak sebagai pertahanan secara mendalam; bentuk lain, atau operasi yang sama yang dipanggil melalui API langsung, dapat mencapai objek produksi nyata. Jangan mengandalkan penjaga ini sebagai batas isolasi. Jangan sertakan pernyataan ini dalam kode uji Anda maupun dalam kode pipeline apa pun yang dijalankan oleh keluaran yang dipilih.
Batasan operasional
- Eksekusi bersamaan tidak didukung: Menjalankan pengujian dan pembaruan alur pada saat yang sama tidak didukung, dan sistem tidak mencegahnya. Tidak ada koordinasi antara keduanya, jadi menjalankannya secara bersamaan dapat bersaing untuk sumber daya, sangat menurunkan performa pembaruan produksi Anda atau menyebabkan pengujian gagal dimulai. Jangan memulai pengujian saat alur menjalankan pembaruan (atau memulai pembaruan saat pengujian sedang berjalan); tunggu pembaruan yang sedang berlangsung selesai sebelum menjalankan pengujian.
-
Skema sementara setelah penghentian abnormal: Setiap eksekusi pengujian membuat skema sementara (bernama
redirecting_<id>) dalam katalog default alur dan menghilangkannya secara otomatis ketika eksekusi selesai. Jika proses eksekusi berakhir secara tidak normal (misalnya, sumber daya komputasi terputus di tengah proses eksekusi), skema sementara dapat tertinggal dan berisi tabel mock dan output milik proses eksekusi tersebut. Ini tidak memengaruhi data produksi. Untuk mengosongkan kembali ruang penyimpanan, hapus secara manual semua skema yang tersisa yang namanya diawali denganredirecting_di katalog default pipeline. - Eksekusi pengujian menggunakan sumber daya komputasi: Eksekusi pengujian dijalankan menggunakan sumber daya komputasi pipeline dan ditagihkan sebagai pembaruan pipeline biasa. Tidak ada pengukuran terpisah untuk uji coba.
-
Refresh penuh tidak didukung: Hanya refresh selektif yang tersedia.
test_pipeline.run()memuat ulang output yang Anda pilih (atau semua output saat Anda tidak memberikan pilihan apa pun); full refresh dan pemilihan full-refresh belum diimplementasikan.
Batasan penulisan dan keakuratan
- Eksekusi khusus editor: Tes harus dijalankan melalui Lakeflow Pipelines Editor berbasis web.
- Hanya pengujian Python: Pengujian harus ditulis dalam Python. Anda dapat menguji alur SQL, tetapi pengujian itu sendiri harus ditulis dalam Python.
- Keakuratan tata kelola: Data tiruan tidak mewarisi filter baris atau masker kolom yang ditentukan pada tabel produksi yang digantinya. Hasil pengujian mencerminkan input tiruan persis seperti yang Anda berikan dan dapat berbeda dari perilaku kueri yang sama pada data produksi yang diatur.
Langkah 1: Memperbarui pengaturan alur
Konfigurasikan pipeline agar berjalan dalam mode trigger.
- Di antarmuka pengguna, buka pipeline Anda dan klik Pengaturan.
- Atur mode Pipeline ke Triggered (jangan gunakan Continuous).
Atau, edit pengaturan alur JSON secara langsung:
"continuous": false
Langkah 2: Membuat file pengujian
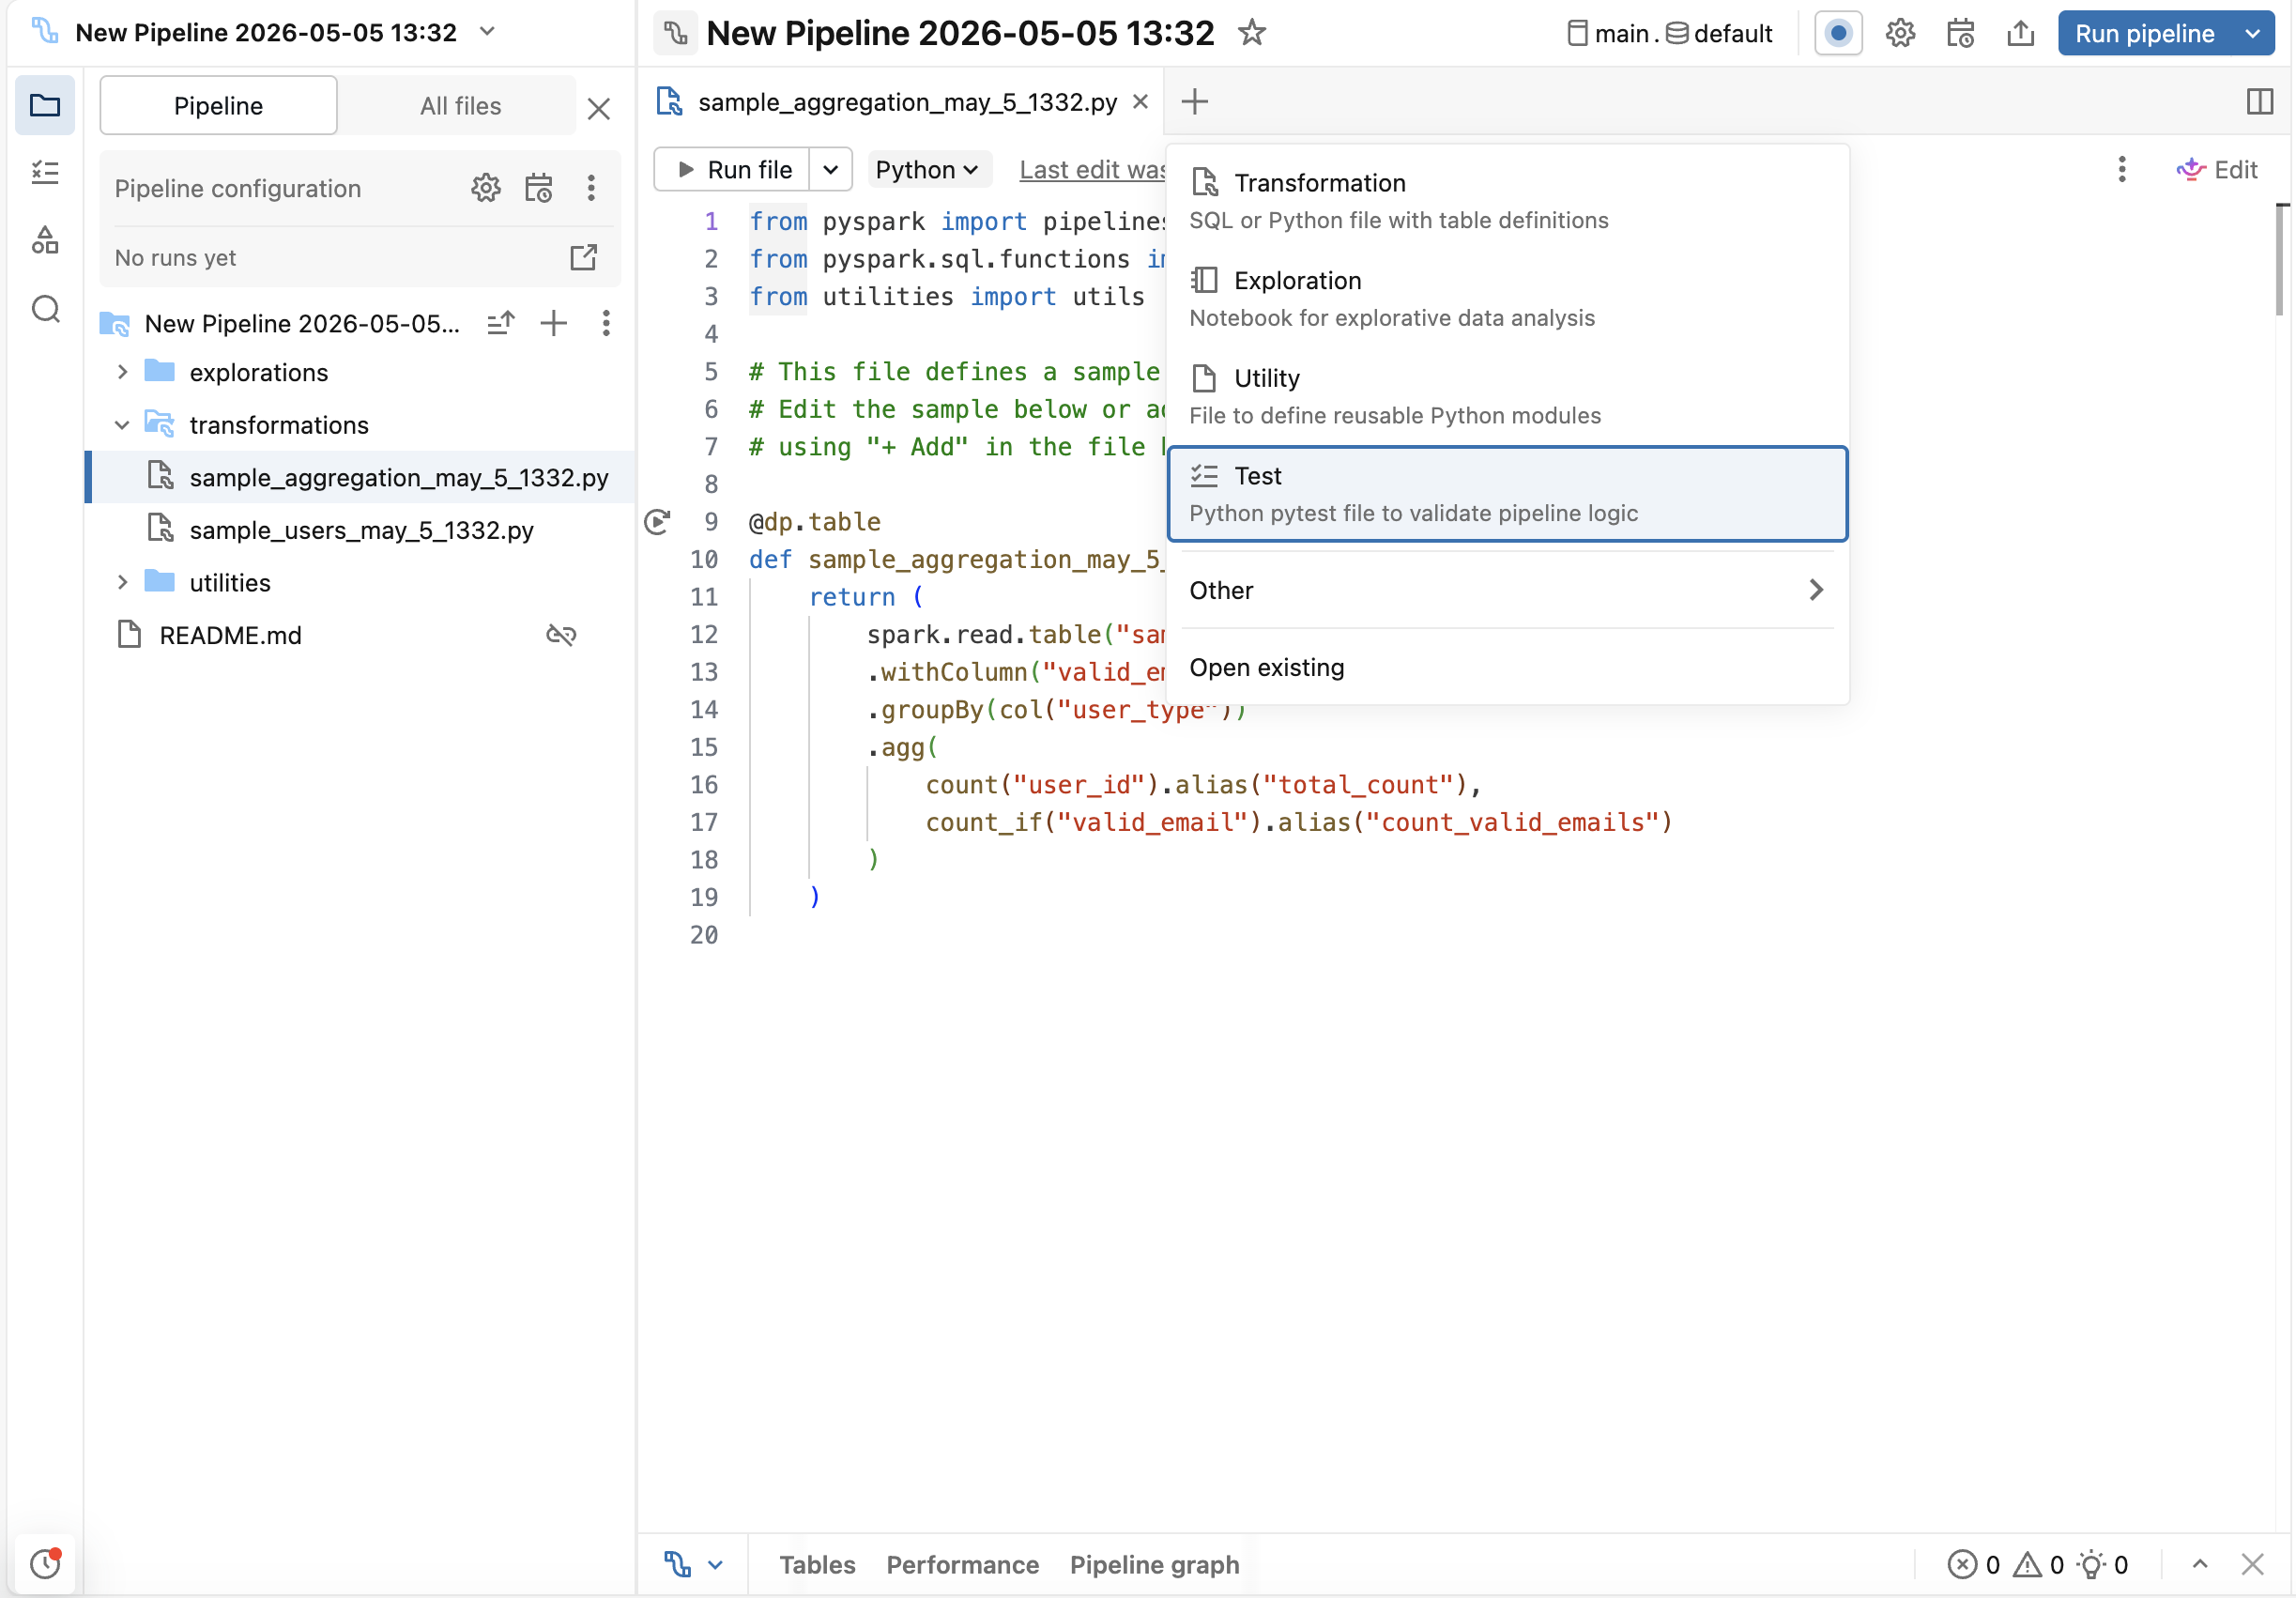
Di Editor Alur Lakeflow, klik tombol + (tambahkan) dan pilih Uji. Ini membuat file uji (dan folder tests, jika folder tersebut belum ada) yang tidak disertakan dalam kode sumber pipeline Anda. Anda tidak perlu membuat sendiri folder tests.
Langkah 3: Hasilkan pengujian
Kode Genie dapat menghasilkan perancah pengujian:
Di dalam file pengujian, klik tombol Hasilkan pengujian .

Sebagai alternatif, gunakan
/testsdi dalam Genie Code.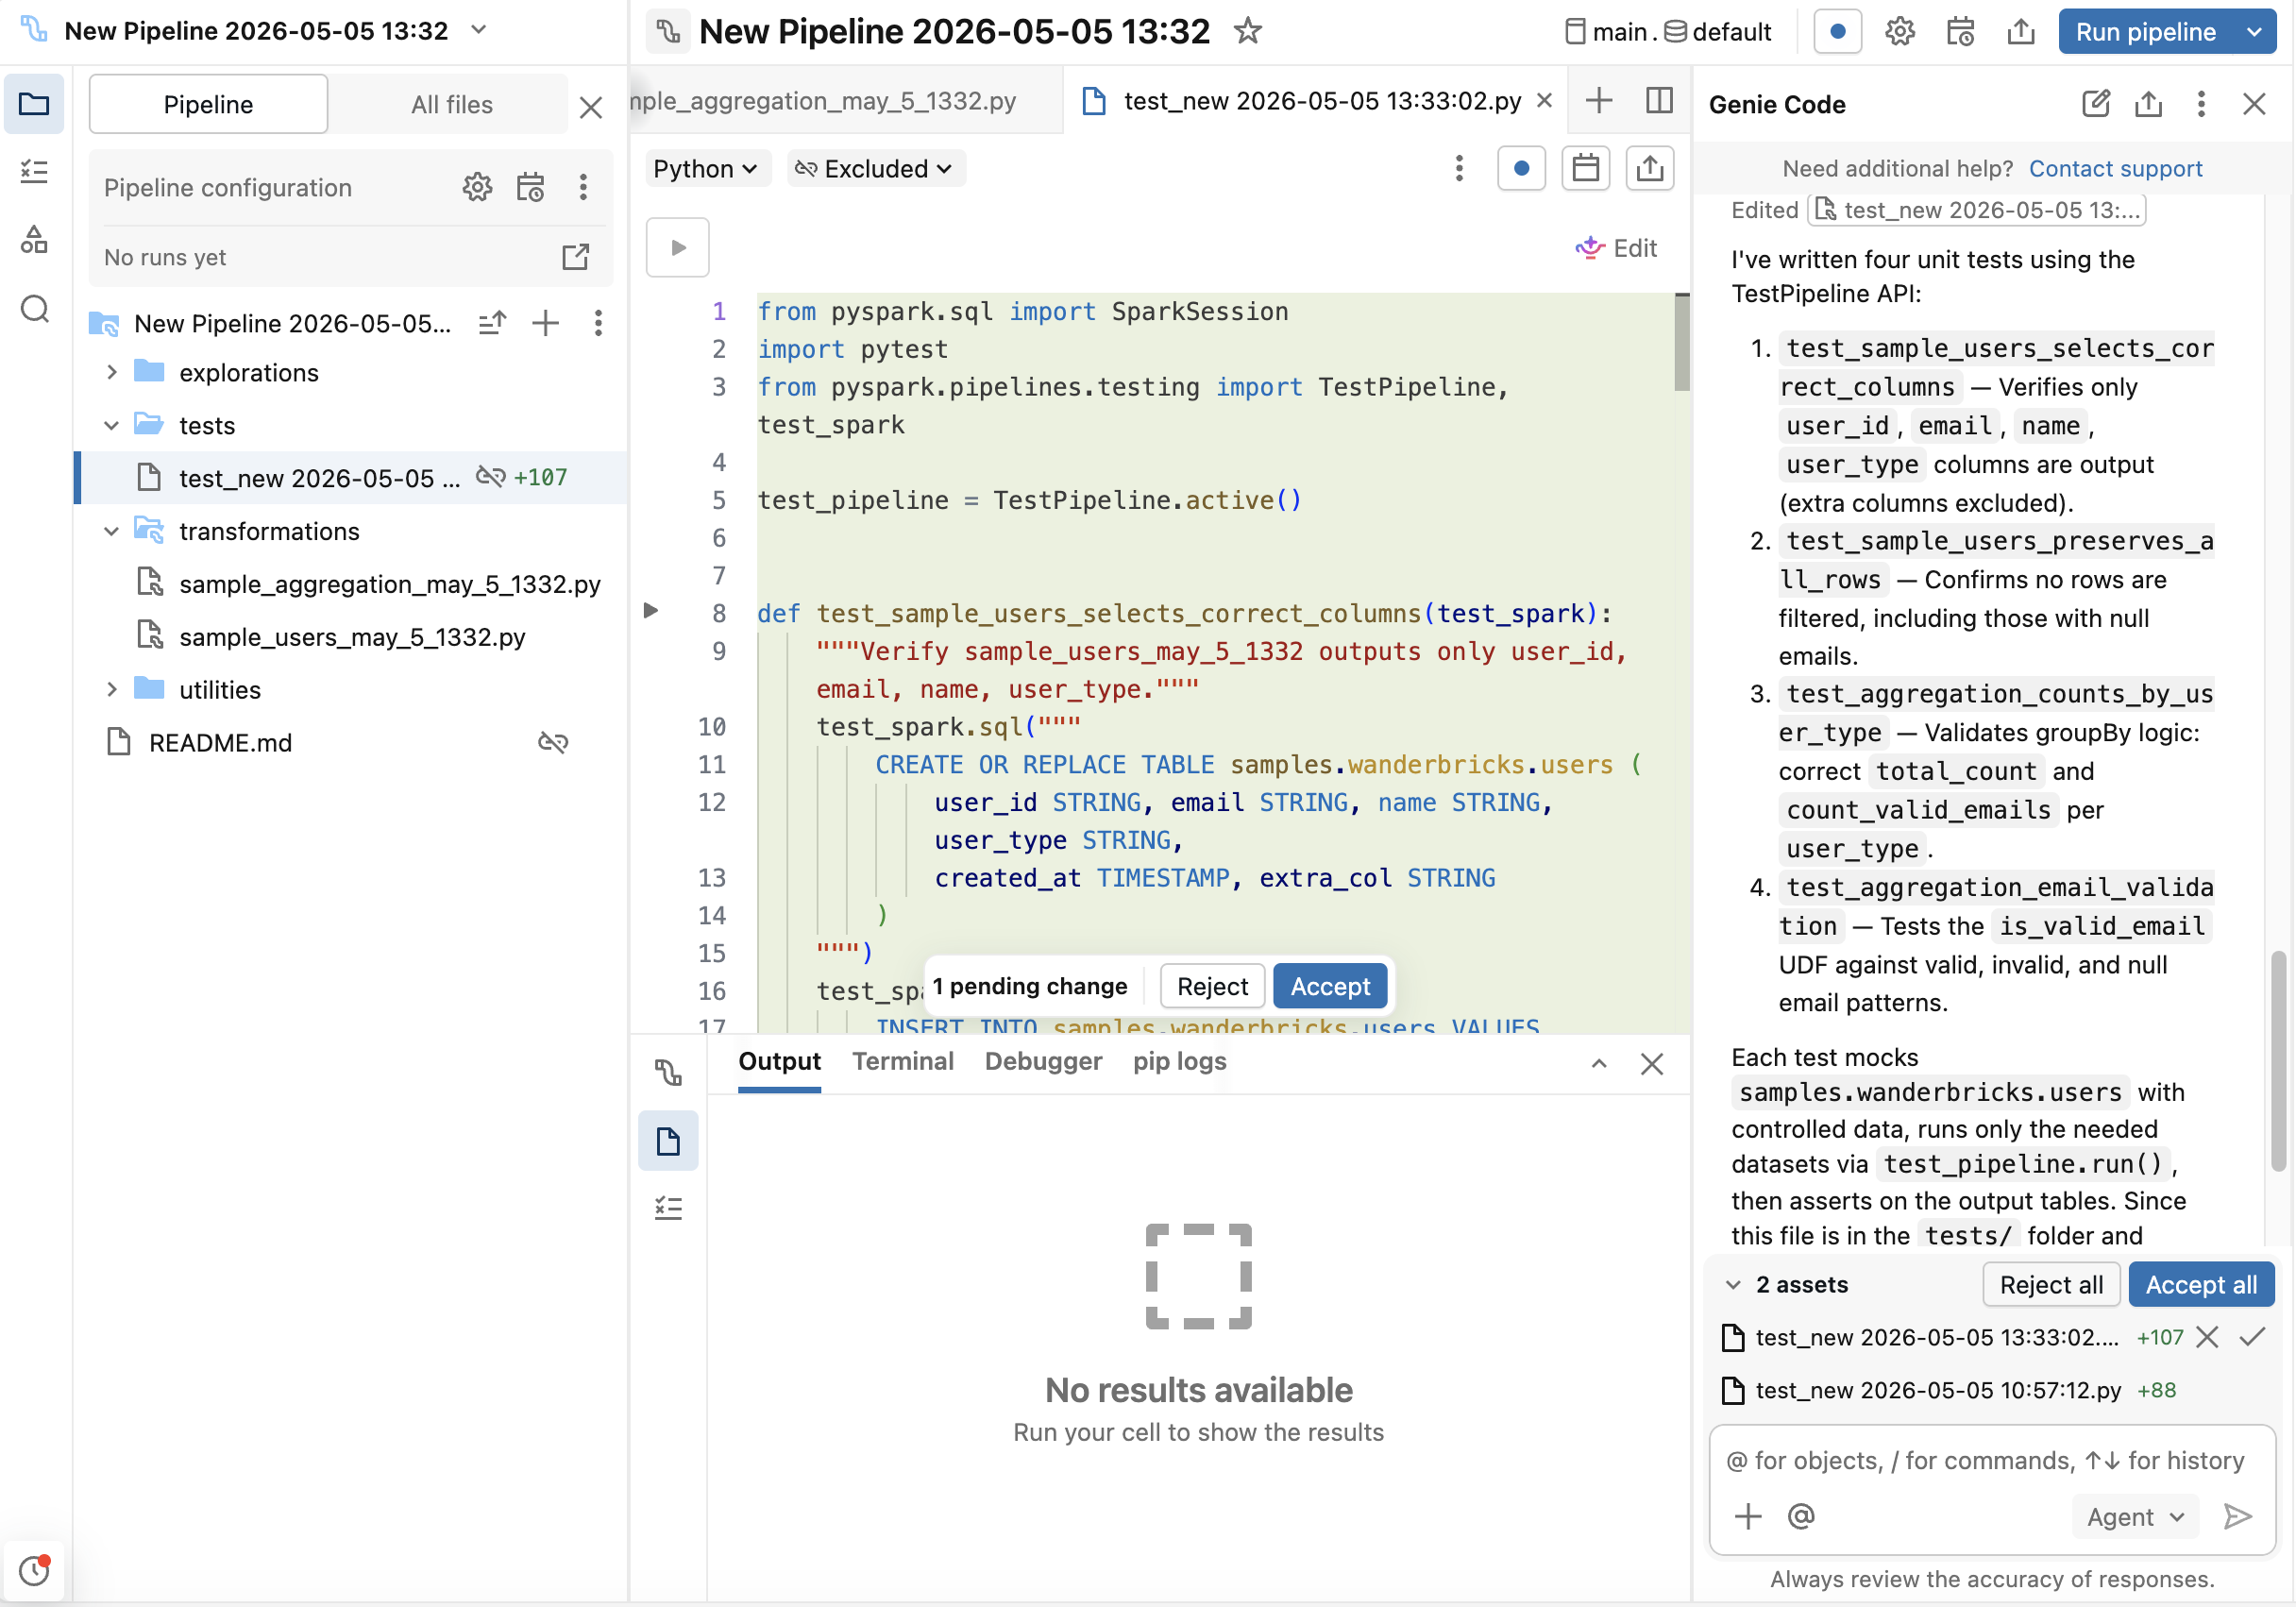
Gunakan Genie Code untuk menghasilkan kode boilerplate, lalu sesuaikan untuk kasus khusus Anda.
Atau, Anda dapat menulis kode pengujian sendiri. Tambahkan impor berikut ke bagian atas setiap file pengujian:
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()
Langkah 4: Jalankan pengujian
Jalankan uji dari Editor Pipeline Lakeflow:
- Klik
 (putar) di gutter di samping fungsi pengujian untuk menjalankan pengujian individual.
- Klik Jalankan pengujian dalam file di bagian atas file pengujian untuk menjalankan semua pengujian dalam file tersebut.
Hasil pengujian (berhasil atau gagal) muncul di panel bawah Editor. Tinjau kesalahan pernyataan untuk men-debug kegagalan.
Pengujian API
| API | Deskripsi |
|---|---|
TestPipeline.active() |
Mengembalikan objek TestPipeline dari pipeline yang sedang diedit di Editor Pipeline Lakeflow. Objek ini adalah referensi ke alur termasuk kode sumber, konfigurasi, katalog/skema default, dll. |
test_pipeline.run(test_spark, set([table_names])) |
Secara sinkron menjalankan pembaruan alur, melakukan refresh selektif jika nama tabel ditentukan. Mengembalikan setelah eksekusi alur berhasil atau berakhir dengan pengecualian. Mengembalikan TestUpdateStatus yang menjelaskan run. |
status.is_success |
True jika pembaruan berhasil diselesaikan. Ketika pembaruan gagal, status.error_message dan status.error_class jelaskan kegagalannya. |
status.event_log |
Log peristiwa untuk eksekusi ini, dalam bentuk DataFrame yang difilter berdasarkan pembaruan eksekusi ini. Gunakan ini untuk memverifikasi peristiwa yang dihasilkan oleh pembaruan, seperti kemajuan alur atau ekspektasi kualitas data. Dapat berupa None jika tidak ada tabel log kejadian yang tersedia. Kolom details adalah string JSON mentah, sesuai dengan fungsi bernilai tabel event_log, jadi parse terlebih dahulu sebelum melakukan asersi pada field bersarang. |
test_pipeline.event_log |
Log peristiwa untuk setiap eksekusi pada pengujian saat ini, sebagai DataFrame. Run terakumulasi di setiap pemanggilan run() dalam pengujian, jadi gunakan ini untuk melakukan assert pada beberapa run dan status.event_log untuk melakukan assert pada satu run saja. Dapat berupa None jika tidak ada tabel log kejadian yang tersedia. |
status.flow_info |
Kamus dengan kunci nama alur, dengan satu entri FlowInfo untuk setiap alur non-view yang dieksekusi selama proses berjalan. Setiap FlowInfo menunjukkan apa yang dilakukan alur tersebut: records_written (total baris output), duration (waktu eksekusi aktual), dan recompute_type ("incremental" atau "full_recompute"). Kolom apa pun bernilai None jika tidak dapat ditentukan untuk alur tersebut. Gunakan ini untuk memverifikasi hasil suatu alur tanpa harus mengurai log peristiwa sendiri. |
test_spark perlengkapan |
Membuat pengujian SparkSession dengan pengalihan tabel katalog yang secara otomatis mengalihkan pembacaan dan penulisan tabel yang mereferensikan tabel berdasarkan nama (misalnya, spark.read.table("catalog.schema.table") atau df.write.saveAsTable("catalog.schema.table")) ke skema pengujian sementara. Pengalihan hanya berlaku untuk operasi tabel berbasis nama; hal ini tidak mencakup operasi baca atau tulis yang diakses melalui jalur atau melalui konektor, yang beroperasi langsung pada sistem yang sebenarnya. Lihat Batasan. |
Membuat data tiruan
Anda dapat meniru data input menggunakan SQL atau createDataFrame:
# Option 1: Using SQL
test_spark.sql("""
    CREATE TABLE catalog.schema.table_name AS
    SELECT * FROM VALUES
        (1, 'value1'),
        (2, 'value2')
    AS t(id, name)
""")

# Option 2: Using createDataFrame
df = test_spark.createDataFrame(
    [(1, 'value1'), (2, 'value2')],
    schema=["id", "name"]
)
df.write.saveAsTable("catalog.schema.table_name")
Untuk menghasilkan volume data sintetis realistis yang lebih besar, Anda dapat menggunakan pustaka Faker . Jalankan %pip install faker di alur Anda terlebih dahulu, lalu buat DataFrame dari UDF yang didukung Faker:
# Option 3: Using Faker for synthetic data
from pyspark.sql import functions as F
from faker import Faker

fake = Faker()
fake_firstname = F.udf(fake.first_name)
fake_lastname = F.udf(fake.last_name)
fake_email = F.udf(fake.ascii_company_email)

df = (
    test_spark.range(0, 100)
    .withColumn("firstname", fake_firstname())
    .withColumn("lastname", fake_lastname())
    .withColumn("email", fake_email())
)
df.write.saveAsTable("catalog.schema.table_name")
Menjalankan alur atau tabel tertentu
# Run specific tables
test_pipeline.run(test_spark, set(["catalog.schema.table1", "catalog.schema.table2"]))

# Run all tables in the pipeline
test_pipeline.run(test_spark)
Examples
Contoh 1: Menguji agregasi dengan jumlah baris, skema, dan penanganan null
Tujuan: Memvalidasi agregasi pengguna dengan benar menghitung pengguna berdasarkan jenis, menangani email null, dan menghasilkan skema yang diharapkan.
Transformasi alur:
Transformasi ini membuat alur dua tabel sederhana: users memilih data pengguna, dan counts mengelompokkan pengguna berdasarkan jenis dan menghitung total pengguna dan email yang valid.
from pyspark import pipelines as dp
from pyspark.sql.functions import col, count, count_if

@dp.table
def users():
    return (
        spark.read.table("catalog.schema.wanderbricks_users")
        .select("user_id", "email", "name", "user_type")
    )

@dp.table
def counts():
    return (
        spark.read.table("catalog.schema.users")
        .withColumn("valid_email", col("email").isNotNull())
        .groupBy("user_type")
        .agg(
            count("user_id").alias("total_count"),
            count_if("valid_email").alias("count_valid_emails")
        )
    )
Pengujian:
Pengujian ini memvalidasi jumlah baris, struktur skema, penanganan null, dan logika agregasi dengan membuat data pengguna tiruan dengan null yang disengaja dan menjalankan alur dalam isolasi.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark
from pyspark.testing import assertDataFrameEqual

test_pipeline = TestPipeline.active()

# Mock data fixture
def mock_users(session):
    session.sql("""
        CREATE TABLE catalog.schema.wanderbricks_users AS
        SELECT * FROM VALUES
            (1, 'alice@example.com', 'Alice', 'admin'),
            (2, NULL, 'Bob', 'user'),
            (3, 'charlie@example.com', 'Charlie', 'user'),
            (4, NULL, 'Dana', 'admin')
        AS t(user_id, email, name, user_type)
    """)

# Test 1: Row count
def test_users_row_count(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    assert result.count() == 4

# Test 2: Schema validation
def test_users_schema(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    expected_fields = {"user_id", "email", "name", "user_type"}
    actual_fields = set(f.name for f in result.schema.fields)
    assert expected_fields == actual_fields

# Test 3: Null handling
def test_users_null_handling(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.users")
    null_emails = result.filter("email IS NULL").count()
    assert null_emails == 2

# Test 4: Aggregation
def test_counts(test_spark):
    mock_users(test_spark)
    # Run both tables since counts depends on users
    status = test_pipeline.run(test_spark, set(["catalog.schema.users", "catalog.schema.counts"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.counts")
    # Check counts for each user_type
    admin_row = result.filter("user_type = 'admin'").collect()[0]
    user_row = result.filter("user_type = 'user'").collect()[0]
    assert admin_row["total_count"] == 2
    assert admin_row["count_valid_emails"] == 1
    assert user_row["total_count"] == 2
    assert user_row["count_valid_emails"] == 1

# Test 5: Full DataFrame comparison with assertDataFrameEqual
def test_counts_full_dataframe(test_spark):
    mock_users(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.users", "catalog.schema.counts"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.counts")
    expected = test_spark.createDataFrame(
        [("admin", 2, 1), ("user", 2, 1)],
        schema=["user_type", "total_count", "count_valid_emails"]
    )
    assertDataFrameEqual(result, expected)
Contoh 2: Menguji Auto CDC
Tujuan: Pastikan bahwa Auto CDC memproses change feed yang berisi penyisipan dan pembaruan dengan benar.
Transformasi alur:
Transformasi ini menyiapkan Auto CDC dari feed perubahan, yang membaca perubahan secara streaming dan menerapkannya pada tabel target sebagai SCD Tipe 1 (hanya menyimpan versi terbaru).
from pyspark import pipelines as dp
from pyspark.sql.functions import col

@dp.view
def users():
    return spark.readStream.table("catalog.schema.change_feed")

dp.create_streaming_table("target_autocdc")
dp.create_auto_cdc_flow(
    target="target_autocdc",
    source="users",
    keys=["userId"],
    sequence_by=col("ts"),
    stored_as_scd_type=1
)
Pengujian:
Pengujian pertama membuat umpan perubahan tiruan dengan beberapa rekaman untuk userId yang sama (mensimulasikan pembaruan) dan memverifikasi bahwa hanya rekaman terbaru yang dipertahankan di target. Pengujian kedua mensimulasikan kejadian yang datang terlambat dan tidak sesuai urutan dengan menjalankan pipeline, menambahkan lebih banyak kejadian ke change feed, lalu menjalankan pipeline lagi.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

# Test 1: Standard inserts and updates
def test_auto_cdc_flow(test_spark):
    # Create a mock change feed table
    test_spark.sql("""
        CREATE TABLE catalog.schema.change_feed AS
        SELECT * FROM VALUES
            (1, 'Alice', 1000),
            (2, 'Bob', 1001),
            (1, 'Alice Updated', 1002)
        AS t(userId, name, ts)
    """)
    # Run the pipeline
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success
    # Read the output
    result = test_spark.table("catalog.schema.target_autocdc")
    # Verify two users exist
    user_ids = set(row["userId"] for row in result.collect())
    assert user_ids == {1, 2}
    # Verify latest record for userId=1 has ts=1002
    latest_user1 = result.filter("userId = 1").collect()[0]
    assert latest_user1["ts"] == 1002
    assert latest_user1["name"] == "Alice Updated"
    # Verify userId=2 has ts=1001
    user2 = result.filter("userId = 2").collect()[0]
    assert user2["ts"] == 1001

# Test 2: Late-arriving and out-of-order events
def test_auto_cdc_late_arriving(test_spark):
    # First batch of change events
    test_spark.sql("""
        CREATE TABLE catalog.schema.change_feed AS
        SELECT * FROM VALUES
            (1, 'Alice', 1000),
            (2, 'Bob', 1001)
        AS t(userId, name, ts)
    """)
    # Run the pipeline with the initial batch
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success

    # Append late-arriving events to the change feed:
    # - A newer event for userId=1 (ts=1003) that arrived after the first run
    # - A stale event for userId=2 (ts=999) with a timestamp older than what is already applied
    test_spark.sql("""
        INSERT INTO catalog.schema.change_feed VALUES
            (1, 'Alice Updated', 1003),
            (2, 'Bob (stale)', 999)
    """)
    # Re-run the pipeline. sequence_by=ts ensures stale events do not overwrite newer state.
    status = test_pipeline.run(test_spark, set(["catalog.schema.target_autocdc"]))
    assert status.is_success

    result = test_spark.table("catalog.schema.target_autocdc")
    # userId=1 should reflect the newer late-arriving event
    alice = result.filter("userId = 1").collect()[0]
    assert alice["ts"] == 1003
    assert alice["name"] == "Alice Updated"
    # userId=2 should be unchanged: the stale event with an older ts is ignored
    bob = result.filter("userId = 2").collect()[0]
    assert bob["ts"] == 1001
    assert bob["name"] == "Bob"
Contoh 3: Menguji Auto CDC dari snapshot
Tujuan: Validasi bahwa CDC memproses perubahan rekam jepret dengan benar termasuk penyisipan, pembaruan, dan penghapusan.
Transformasi alur:
Transformasi ini menyiapkan CDC Otomatis dari rekam jepret, yang membaca dari tabel rekam jepret dan melacak perubahan dari waktu ke waktu sebagai SCD Tipe 2 (mempertahankan riwayat penuh).
from pyspark import pipelines as dp

@dp.view(name="source")
def source():
    return spark.read.table("catalog.schema.snapshot")

dp.create_streaming_table("catalog.schema.target")
dp.create_auto_cdc_from_snapshot_flow(
    target="target",
    source="source",
    keys=["userId"],
    stored_as_scd_type=2
)
Tes:
Pengujian ini membuat rekam jepret awal, menjalankan alur, lalu mensimulasikan pembaruan rekam jepret dengan memotong dan menyisipkan data baru untuk memverifikasi bahwa CDC menangkap semua perubahan.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

def test_auto_cdc_from_snapshot_flow(test_spark):
    # Create initial snapshot
    test_spark.sql("""
        CREATE TABLE catalog.schema.snapshot AS
        SELECT * FROM VALUES
            (1, 'Alice', '2024-01-01'),
            (2, 'Bob', '2024-01-02')
        AS t(userId, name, created_at)
    """)
    # Run the pipeline
    status = test_pipeline.run(test_spark, set(["catalog.schema.target"]))
    assert status.is_success
    # Simulate a new snapshot by truncating and inserting updated data
    test_spark.sql("TRUNCATE TABLE catalog.schema.snapshot")
    test_spark.sql("INSERT INTO catalog.schema.snapshot VALUES (2, 'Bob', '2024-01-03')")
    status = test_pipeline.run(test_spark, set(["catalog.schema.target"]))
    assert status.is_success
    # Verify SCD Type 2: should have 3 rows (original Alice, original Bob, updated Bob)
    result = test_spark.table("catalog.schema.target")
    assert result.count() == 3
    user_ids = [row["userId"] for row in result.collect()]
    assert set(user_ids) == {1, 2}
Contoh 4: Menguji gabungan dan ekspektasi
Tujuan: Memvalidasi bahwa join berfungsi dengan benar dan ekspektasi menyaring data yang tidak valid.
Transformasi alur:
Transformasi ini menggabungkan gambar properti dengan fasilitas dan menerapkan harapan untuk memfilter gambar yang diunggah sebelum Januari 2024.
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("uploaded after Jan 2024", "uploaded_at > '2024-01-01'")
def property_images_amenities_join():
    return (
        spark.read.table("catalog.schema.property_images")
        .join(
            spark.read.table("catalog.schema.property_amenities"),
            on="property_id",
            how="inner"
        )
    )
Pengujian:
Pengujian ini memverifikasi bahwa gabungan menghasilkan jumlah baris yang benar dan bahwa harapan berhasil memfilter rekaman dengan tanggal unggahan yang tidak valid.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

# Mock property datasets
def mock_properties(session):
    session.sql("""
        CREATE TABLE catalog.schema.property_images AS
        SELECT * FROM VALUES
            (101, 'img1.jpg', '2024-02-01'),
            (102, 'img2.jpg', '2024-01-15'),
            (103, 'img3.jpg', '2024-12-20')
        AS t(property_id, image_url, uploaded_at)
    """)
    session.sql("""
        CREATE TABLE catalog.schema.property_amenities AS
        SELECT * FROM VALUES
            (101, 'wifi'),
            (102, 'pool'),
            (103, 'parking')
        AS t(property_id, amenity)
    """)

# Test 1: Join
def test_property_join(test_spark):
    mock_properties(test_spark)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.property_images_amenities_join")
    # Should have 3 rows after join
    assert result.count() == 3
    # Check all property_ids are present
    property_ids = set(row["property_id"] for row in result.collect())
    assert property_ids == {101, 102, 103}

# Test 2: Expectation
def test_property_expectation(test_spark):
    mock_properties(test_spark)
    # Add a row with uploaded_at before Jan 2024
    test_spark.sql("""
        INSERT INTO catalog.schema.property_images VALUES (104, 'img4.jpg', '2023-12-31')
    """)
    # Add a matching row in the amenities table for the join
    test_spark.sql("""
        INSERT INTO catalog.schema.property_amenities VALUES (104, 'gym')
    """)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    result = test_spark.table("catalog.schema.property_images_amenities_join")
    # Only property_ids with uploaded_at > '2024-01-01' should be present
    valid_ids = set(row["property_id"] for row in result.collect())
    assert 104 not in valid_ids
    assert valid_ids == {101, 102, 103}
Contoh 5: Melakukan asersi pada sebuah alur dengan flow_info
Tujuan: Verifikasi berapa banyak baris yang ditulis oleh alur, menggunakan hasil per alur dari run, bukan tabel output.
status.flow_info melaporkan apa yang dilakukan setiap alur selama eksekusi, dikelompokkan berdasarkan nama alur. Setiap entri menampilkan records_written, duration, dan recompute_type, sehingga Anda dapat mengklaim hasil alur tanpa memproses log peristiwa. Untuk melakukan assert pada event tingkat rendah, baca DataFrame mentah status.event_log secara langsung. Lihat Pengujian API.
Contoh ini menggunakan kembali pipeline dan fixture mock_properties dari Contoh 4, di mana @dp.expect_or_drop menyaring gambar yang diunggah sebelum Januari 2024.
Tes:
records_written menghitung baris yang ditulis aliran, sehingga mencerminkan ekspektasi untuk menghapus sebuah rekaman.
import pytest
from pyspark.pipelines.testing import TestPipeline, test_spark

test_pipeline = TestPipeline.active()

def test_flow_wrote_expected_row_count(test_spark):
    mock_properties(test_spark)
    # A fourth image uploaded before Jan 2024, which the expectation drops, plus a
    # matching amenities row so it survives the join and reaches the expectation.
    test_spark.sql("""
        INSERT INTO catalog.schema.property_images VALUES (104, 'img4.jpg', '2023-12-31')
    """)
    test_spark.sql("""
        INSERT INTO catalog.schema.property_amenities VALUES (104, 'gym')
    """)
    status = test_pipeline.run(test_spark, set(["catalog.schema.property_images_amenities_join"]))
    assert status.is_success
    # Four images are joined, but the expectation drops the one uploaded before Jan 2024,
    # so the flow reports three rows written.
    assert status.flow_info["property_images_amenities_join"].records_written == 3