Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Spark SQL menggunakan optimizer berbasis biaya (CBO) untuk memilih rencana kueri yang efisien. CBO menggunakan statistik tabel dan kolom, seperti ukuran tabel dan distribusi data, untuk memperkirakan biaya rencana alternatif dan memilih rencana dengan estimasi biaya terendah. Hal ini paling penting untuk query dengan beberapa join, di mana rencana yang buruk bisa jauh lebih lambat dibandingkan rencana yang baik.
CBO diaktifkan secara default, tapi tergantung pada statistik. Jika statistik hilang atau tidak mutakhir, CBO mungkin memilih urutan join atau strategi join yang tidak efisien. Kumpulkan statistik tabel dan kolom serta jaga agar tetap mutakhir. Lihat Kumpulkan statistik.
Praktik terbaik
Untuk membantu CBO memilih rencana kueri yang efisien, ikuti praktik-praktik berikut:
- Kumpulkan statistik untuk tabel yang digunakan dalam kueri multi-join. Jika Anda menggunakan optimasi prediktif pada tabel terkelola Unity Catalog, statistik akan dikumpulkan untuk Anda. Lihat Kumpulkan statistik.
- Periksa rencana kueri ketika kueri multi-join lebih lambat dari yang diharapkan. Statistik yang hilang atau tidak akurat adalah penyebab umum. Lihat Verifikasi rencana kueri.
- Hapus statistik atau nonaktifkan CBO hanya untuk memitigasi masalah perencanaan spesifik yang disebabkan oleh statistik. Lihat Nonaktifkan optimizer berbasis biaya.
Mengumpulkan statistik
Untuk mendapatkan manfaat penuh dari CBO, penting untuk mengumpulkan statistik kolom dan statistik tabel . Anda dapat menggunakan ANALYZE TABLE perintah untuk mengumpulkan statistik secara manual.
Petunjuk
Untuk mempertahankan statistik up-to-date, jalankan ANALYZE TABLE setelah menulis ke tabel.
Menggunakan ANALYZE
Pengoptimalan prediktif menjalankan secara otomatis ANALYZE, yaitu perintah untuk mengumpulkan statistik, pada tabel yang dikelola oleh Unity Catalog. Databricks merekomendasikan untuk mengaktifkan pengoptimalan prediktif untuk semua tabel terkelola Unity Catalog untuk menyederhanakan pemeliharaan data dan mengurangi biaya penyimpanan. Lihat ANALYZE TABLE ... STATISTIK KOMPUTASI.
Anda dapat menghapus statistik pengoptimal sehingga pengoptimal tidak lagi bergantung padanya, misalnya, untuk mengurangi masalah perencanaan yang disebabkan oleh statistik. Lihat ANALYZE TABLE … DROP STATISTICS.
Verifikasi rencana kueri
Ada beberapa cara untuk memverifikasi rencana kueri.
EXPLAIN perintah
Untuk memeriksa apakah rencana menggunakan statistik, gunakan perintah EXPLAIN.
Jika statistik hilang maka rencana kueri mungkin tidak optimal.
== Optimized Logical Plan ==
Aggregate [s_store_sk], [s_store_sk, count(1) AS count(1)L], Statistics(sizeInBytes=20.0 B, rowCount=1, hints=none)
+- Project [s_store_sk], Statistics(sizeInBytes=18.5 MB, rowCount=1.62E+6, hints=none)
   +- Join Inner, (d_date_sk = ss_sold_date_sk), Statistics(sizeInBytes=30.8 MB, rowCount=1.62E+6, hints=none)
      :- Project [ss_sold_date_sk, s_store_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :  +- Join Inner, (s_store_sk = ss_store_sk), Statistics(sizeInBytes=48.9 GB, rowCount=2.63E+9, hints=none)
      :     :- Project [ss_store_sk, ss_sold_date_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :  +- Filter (isnotnull(ss_store_sk) && isnotnull(ss_sold_date_sk)), Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :     +- Relation[ss_store_sk,ss_sold_date_sk] parquet, Statistics(sizeInBytes=134.6 GB, rowCount=2.88E+9, hints=none)
      :     +- Project [s_store_sk], Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :        +- Filter isnotnull(s_store_sk), Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :           +- Relation[s_store_sk] parquet, Statistics(sizeInBytes=88.0 KB, rowCount=1.00E+3, hints=none)
      +- Project [d_date_sk], Statistics(sizeInBytes=12.0 B, rowCount=1, hints=none)
         +- Filter ((((isnotnull(d_year) && isnotnull(d_date)) && (d_year = 2000)) && (d_date = 2000-12-31)) && isnotnull(d_date_sk)), Statistics(sizeInBytes=38.0 B, rowCount=1, hints=none)
            +- Relation[d_date_sk,d_date,d_year] parquet, Statistics(sizeInBytes=1786.7 KB, rowCount=7.30E+4, hints=none)
Penting
Statistik rowCount ini sangat penting untuk pertanyaan dengan beberapa penggabungan. Jika rowCount hilang, itu berarti tidak ada cukup informasi untuk menghitungnya (artinya, beberapa kolom yang diperlukan tidak memiliki statistik).
Dalam Databricks Runtime 16.0 dan yang lebih baru, output dari perintah EXPLAIN mencantumkan tabel yang direferensikan yang memiliki statistik yang hilang, parsial, dan lengkap, misalnya:
== Optimizer Statistics (table names per statistics state) ==
  missing = date_dim, store
  partial =
  full    = store_sales
Corrective actions: consider running the following command on all tables with missing or partial statistics
  ANALYZE TABLE <table-name> COMPUTE STATISTICS FOR ALL COLUMNS
Antarmuka Pengguna Spark SQL
Gunakan halaman antarmuka pengguna Spark SQL untuk melihat rencana yang dieksekusi dan akurasi statistik.
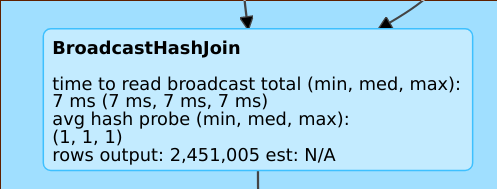
Garis seperti rows output: 2,451,005 est: N/A itu berarti bahwa operator ini menghasilkan sekitar 2 juta baris dan tidak ada statistik yang tersedia.
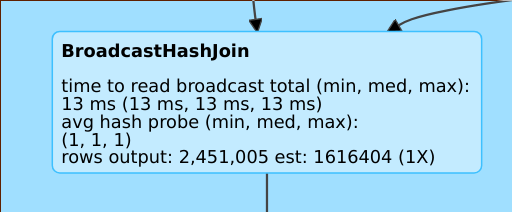
Garis seperti rows output: 2,451,005 est: 1616404 (1X) itu berarti bahwa operator ini menghasilkan sekitar 2 juta baris, sedangkan perkiraannya sekitar 1,6M dan faktor kesalahan estimasi adalah 1.
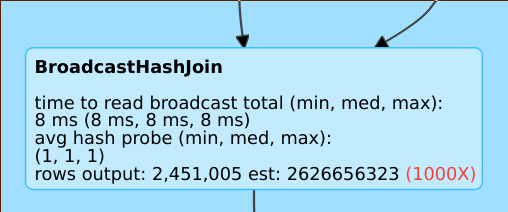
Garis seperti rows output: 2,451,005 est: 2626656323 itu berarti bahwa operator ini menghasilkan sekitar 2 juta baris, sedangkan perkiraannya sekitar 2 juta baris, jadi faktor kesalahan estimasi adalah 1.000.
Nonaktifkan optimizer berbasis biaya
CBO diaktifkan secara default. Anda menonaktifkan CBO dengan mengubah bendera spark.sql.cbo.enabled.
spark.conf.set("spark.sql.cbo.enabled", false)