Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Pemrosesan prioritas memberikan kinerja latensi rendah dengan fleksibilitas pembayaran sesuai penggunaan. Dalam artikel ini, Anda mengaktifkan pemrosesan prioritas pada penyebaran model, memverifikasi tingkat layanan mana yang memproses permintaan Anda, dan memantau biaya terkait.
Prasyarat
- Langganan Azure - Buat langganan secara gratis.
- Proyek Microsoft Foundry dengan model jenis penyebaran
GlobalStandardatauDataZoneStandarddisebarkan. - Versi model
2025-12-01atau yang lebih baru.
Kasus penggunaan kunci
- Latensi rendah yang konsisten untuk pengalaman pengguna yang responsif.
- Kesederhanaan pembayaran sesuai penggunaan tanpa komitmen jangka panjang.
- Trafik jam operasional atau bursty yang mendapat manfaat dari performa yang dapat diskalakan dan hemat biaya. Secara opsional, Anda dapat menggabungkan pemrosesan prioritas dengan Unit Throughput Yang Disediakan (PTU) untuk kapasitas status stabil dan pengoptimalan biaya.
Target latensi
Tabel berikut mencantumkan nilai target latensi untuk setiap model yang mendukung pemrosesan prioritas. Nilai target latensi dihitung sebagai latensi permintaan p50 per 5 menit dan dinyatakan sebagai ambang persentil. Misalnya, "99% > 50 Token per Detik (TPS)" berarti 99% permintaan diproses pada lebih dari 50 token per detik.
| Model | Nilai target latensi |
|---|---|
| gpt-6-sol, 2026-09-22 | 99% > 80 TPS |
| gpt-5.6-terra, 2026-07-09 | 99% > 70 TPS |
| gpt-5.6-sol, 2026-07-09 | 99% > 80 TPS |
| gpt-5.5, 2026-04-24 | 99% > 50 TPS |
| gpt-5.4-mini, 2026-03-17 | 99% > 100 TPS |
| gpt-5.4, 2026-03-051 | 99% > 50 TPS |
| gpt-5.2, 2025-12-11 | 99% > 50 TPS |
| gpt-5.1, 2025-11-13 | 99% > 50 TPS |
| gpt-4.1, 2025-04-141 | 99% > 80 TPS |
1Konteks panjang untuk model ini, artinya, permintaan yang diperkirakan melebihi 128k token perintah akan dialihkan ke pemrosesan standar dan dikenai tarif standar.
Ketersediaan pemrosesan prioritas berdasarkan jenis penyebaran
Pemrosesan prioritas dapat diaktifkan dalam penyebaran standar global atau penyebaran standar Zona Data (AS). Untuk informasi harga, lihat halaman harga Azure OpenAI.
Ketersediaan model standar global
| Wilayah | gpt-6-sol, 2026-09-22 | gpt-5.6-terra, 2026-07-09 | gpt-5.6-sol, 2026-07-09 | gpt-5.5, 2026-04-24 | gpt-5.4-mini, 2026-03-17 | gpt-5.4, 2026-03-05 | gpt-5.2, 2025-12-11 | gpt-5.1, 2025-11-13 | gpt-4.1, 2025-04-14 |
|---|---|---|---|---|---|---|---|---|---|
| AustraliaEast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| brasilouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| kanadacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| kanada timur | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| centralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus2 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| francecentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Jerman Barat Tengah | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| italynorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| japaneast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| koreacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| northcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| northeurope | - | - | - | ✅ | ✅ | ✅ | - | - | - |
| norwayeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| polandcentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southafricanorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southeastasia | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| India Selatan | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| spaincentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| swedencentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Swiss Utara | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| swisswest | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uaenorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uksouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westeurope | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus3 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Mengaktifkan pemrosesan prioritas pada tingkat penyebaran
Anda dapat mengaktifkan pemrosesan prioritas pada tingkat penyebaran dan (opsional) di tingkat permintaan.
Catatan
Pemrosesan prioritas dapat diaktifkan dalam penyebaran standar Global atau Standar Zona Data (AS). Pemrosesan prioritas menggunakan kuota yang sama dengan pemrosesan standar.
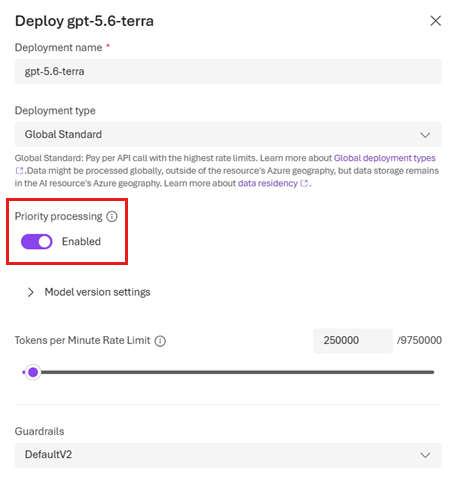
Di portal Microsoft Foundry, aktifkan beralih pemrosesan Prioritas pada halaman detail penyebaran ketika membuat penyebaran, atau perbarui pengaturan model yang telah disebarkan dengan mengedit detail penyebaran.
Catatan
Jika Anda lebih suka menggunakan kode untuk mengaktifkan pemrosesan prioritas pada tingkat penyebaran, Anda dapat melakukannya melalui REST API untuk penyebaran dengan mengatur service_tier atribut sebagai berikut: "properties" : {"service_tier" : "priority"}. Nilai yang diizinkan service_tier untuk atribut adalah default dan priority.
default menyiratkan pemrosesan standar, sekaligus priority memungkinkan pemrosesan prioritas.
Setelah penyebaran model dikonfigurasi untuk menggunakan pemrosesan prioritas, Anda dapat mulai mengirim permintaan ke model.
Menampilkan metrik penggunaan
Anda dapat melihat ukuran pemanfaatan untuk sumber daya Anda di bagian Azure Monitor di portal Azure.
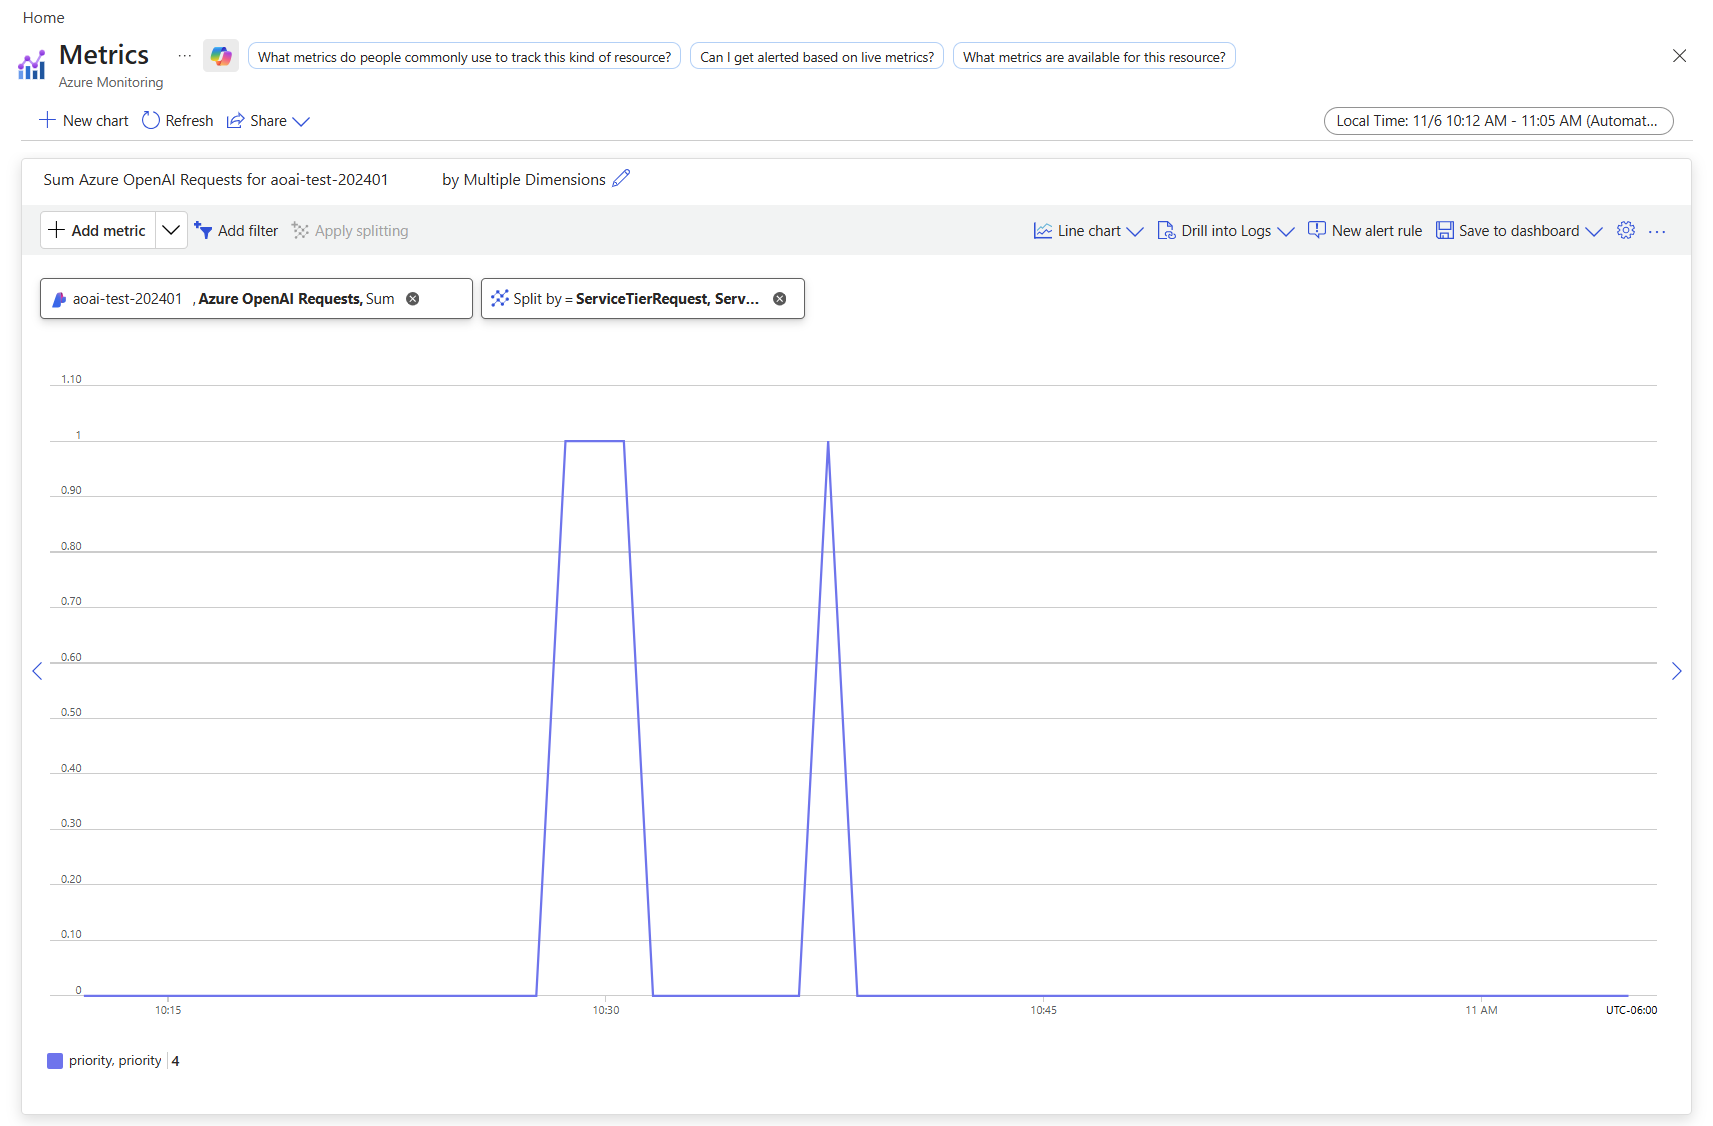
Untuk melihat volume permintaan yang diproses oleh pemrosesan standar versus pemrosesan prioritas, pisahkan berdasarkan tingkat layanan (standar atau prioritas) yang ada dalam permintaan asli:
- Masuk ke https://portal.azure.com.
- Buka sumber daya OpenAI Azure Anda dan pilih opsi Metrics dari navigasi kiri.
- Pada halaman metrik, tambahkan metrik permintaan Azure OpenAI. Anda juga dapat memilih metrik lain seperti Azure latensi OpenAI, Azure penggunaan OpenAI, dan lainnya.
- Pilih Tambahkan filter untuk memilih penyebaran standar yang permintaan pemrosesan prioritasnya diproses.
- Pilih Terapkan pemisahan untuk membagi nilai menurut ServiceTierRequest dan ServiceTierResponse.
Untuk informasi selengkapnya tentang memantau penyebaran Anda, lihat Monitor Azure OpenAI.
Memantau biaya
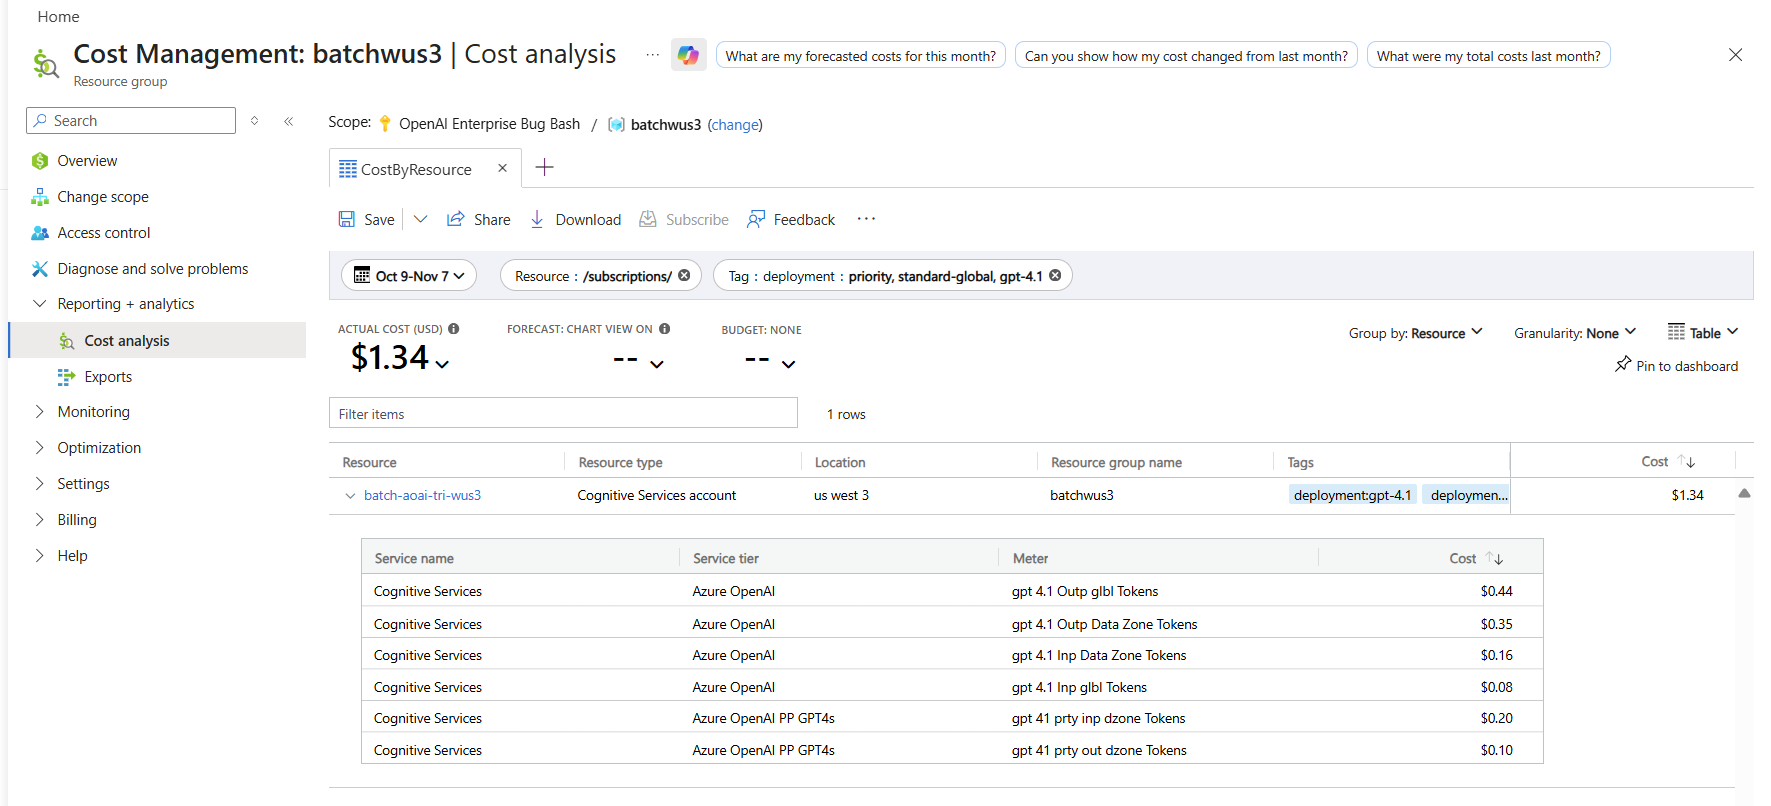
Anda dapat melihat perincian biaya untuk permintaan prioritas dan standar di halaman analisis biaya portal Azure dengan memfilter nama penyebaran dan tag penagihan sebagai berikut:
- Buka halaman analisis biaya di portal Azure.
- (Opsional) Filter menurut sumber daya.
- Untuk memfilter berdasarkan nama penyebaran: Tambahkan filter untuk tag penagihan>, pilih penyebaran sebagai nilai, lalu pilih nama penyebaran Anda.
Untuk informasi tentang harga untuk pemrosesan prioritas, lihat gambaran umum harga Azure OpenAI Service.
Mengaktifkan pemrosesan prioritas pada tingkat permintaan
Important
Mulai 25 September 2026, permintaan ke model yang tidak mendukung pemrosesan Flex mengembalikan HTTP 400 dengan invalid_request_error. Foundry tidak otomatis beralih dari flex ke pemrosesan standar. Verifikasi bahwa model Anda mendukung pemrosesan Flex sebelum Anda mengirim permintaan. Jika pemrosesan Standar dapat diterima, atur service_tier ke default sebagai gantinya. Untuk model dan panduan fallback yang didukung, lihat Menggunakan pemrosesan Flex dengan Azure OpenAI.
Mengaktifkan pemrosesan prioritas pada tingkat permintaan bersifat opsional. API penyelesaian obrolan dan API respons memiliki atribut service_tier opsional yang menentukan jenis pemrosesan yang akan digunakan saat melayani permintaan. Contoh berikut menunjukkan cara mengatur service_tier ke priority dalam permintaan respons.
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AZURE_OPENAI_AUTH_TOKEN" \
  -d '{
     "model": "gpt-4.1",
     "input": "This is a test",
     "service_tier": "priority"
    }'
Gunakan atribut service_tier untuk menggantikan pengaturan tingkat penyebaran. Untuk pemrosesan Standar dan Prioritas, service_tier dapat mengambil nilai auto, , defaultdan priority.
Jika Anda tidak mengatur atribut , atribut akan default ke
auto.service_tier = autoberarti permintaan menggunakan tingkat layanan yang dikonfigurasi dalam penyebaran.service_tier = defaultberarti permintaan menggunakan harga dan performa standar untuk model yang dipilih.service_tier = priorityberarti permintaan menggunakan tingkat layanan pemrosesan prioritas.
Tabel berikut ini meringkas perutean Standar dan Prioritas berdasarkan pengaturan tingkat penyebaran dan tingkat permintaan untuk service_tier.
| Pengaturan tingkat penyebaran | Pengaturan tingkat permintaan | Permintaan diproses oleh tingkat layanan |
|---|---|---|
| asali | otomatis, default | Standar |
| asali | Prioritas | Pemrosesan prioritas |
| Prioritas | otomatis, prioritas | Pemrosesan prioritas |
| Prioritas | asali | Standar |
Keterbatasan
Layanan saat ini tidak mendukung penyebaran standar regional dan penyebaran standar zona data Uni Eropa.
Layanan ini mungkin merutekan kembali beberapa permintaan prioritas ke pemrosesan standar* selama skenario ini:
- Jika peningkatan cepat pada token pemrosesan prioritas Anda per menit mengakibatkan mencapai batas tingkat kenaikan. Saat ini, batas laju ramp didefinisikan sebagai peningkatan lalu lintas lebih dari 50% token per menit dalam waktu kurang dari 15 menit.
- Selama periode permintaan puncak terhadap sistem pemrosesan prioritas.
- Permintaan konteks panjang dikirim ke model tertentu yang tercantum dalam tabel target Latensi.
Tips
Jika Anda secara rutin mengalami batas laju peningkatan, pertimbangkan untuk membeli PTU sebagai tambahan selain pemrosesan prioritas.
* Layanan mengenakan biaya untuk permintaan yang diproses pada tingkat layanan standar dengan tarif standar. Permintaan yang diproses oleh tingkat layanan standar termasuk
service_tier = defaultdalam respons, sementara permintaan yang diproses oleh tingkat pemrosesan prioritas termasukservice_tier = prioritydalam respons.
Pemecahan masalah
| Masalah | Menyebabkan | Resolusi |
|---|---|---|
| Permintaan diturunkan ke tingkatan standar | Salah satu situasi berikut: - Lalu lintas meningkat lebih dari 50% token per menit dalam waktu kurang dari 15 menit, mencapai batas laju peningkatan. - Permintaan yang dikirim selama periode permintaan puncak ke pemrosesan prioritas. - Permintaan konteks panjang dikirim ke model tertentu yang tercantum dalam tabel target Latensi. |
- Tingkatkan lalu lintas secara bertahap, jika Anda mengalami batas laju ramp. - Pertimbangkan untuk membeli PTU untuk kapasitas kondisi stabil. |