Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Pemrosesan fleksibel (pratinjau) memberikan inferensi dengan diskon 50% dibandingkan dengan pemrosesan Standar untuk beban kerja yang dapat mentolerir waktu respons yang lebih lambat dan sesekali tidak tersedianya sumber daya. Pilih Pemrosesan Flex untuk permintaan API Respons individual atau API Penyelesaian Obrolan dengan mengatur service_tier ke flex.
Gunakan pemrosesan Flex untuk pekerjaan noninteraktif dan berprioritas lebih rendah, seperti evaluasi model, pengayaan data, analisis dokumen, dan alur kerja aplikasi asinkron. Untuk beban kerja yang sensitif terhadap latensi atau sensitif kapasitas, gunakan Pemrosesan standar, Pemrosesan prioritas, atau throughput yang disediakan sebagai gantinya.
Important
Dengan pengenalan pemrosesan Flex, permintaan yang diatur service_tier ke flex hanya diproses ketika model yang dipilih mendukung pemrosesan Flex. Model yang tidak didukung mengembalikan HTTP 400 invalid_request_error dan tidak kembali ke pemrosesan Standar. Pemrosesan Flex tidak memiliki jaminan SLA untuk latensi maupun layanan.
Prasyarat
Sebuah langganan Azure. Buat akun gratis.
Sumber daya OpenAI Azure dengan model yang didukung yang disebarkan dengan menggunakan jenis penyebaran Standar Global.
Titik akhir sumber daya dan kunci API atau kredensial Microsoft Entra ID. Contoh dalam artikel ini menggunakan kunci API yang disimpan dalam
AZURE_OPENAI_API_KEYvariabel lingkungan.Beban kerja yang dapat menoleransi latensi variabel dan respons ketidaktersediaan sumber daya yang bersifat sementara.
Python 3.10 atau yang lebih baru dan paket Python OpenAI untuk contoh Python:
pip install --upgrade openai
Mengirim permintaan Flex
Atur service_tier ke flex di setiap permintaan yang harus menggunakan pemrosesan Flex. Nilai model adalah nama deployment model Azure Anda.
Python
Contoh berikut mengirimkan permintaan Flex dengan menggunakan Api Respons:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Respons berisi analisis yang dihasilkan dan tingkat layanan yang memproses permintaan.
Reference:Responses API
REST
Contoh berikut mengirimkan permintaan yang sama langsung ke API Respons:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Untuk memverifikasi lapisan mana yang memproses permintaan, periksa bidang service_tier dalam respons yang berhasil.
Referensi:Referensi REST API Responses
Pilih opsi pemrosesan
Pemrosesan Flex, Standard, dan Priority adalah pilihan tingkat layanan untuk permintaan API online. Throughput batch dan yang disediakan adalah opsi penyebaran dan pembelian terpisah.
| Option | Bagaimana Anda memilihnya | Latensi dan ketersediaan | Model biaya | Paling cocok untuk |
|---|---|---|---|---|
| Pemrosesan Flex | Atur tingkat service_tier permintaan ke flex. |
Latensi variabel. Permintaan dapat mengembalikan HTTP 429 saat kapasitas Flex tidak tersedia. | Diskon 50% dibandingkan dengan tarif token Standar. Diskon token cache juga berlaku. | Evaluasi, pengayaan, analisis offline, dan pekerjaan latar belakang yang toleran terhadap penundaan. |
| Pemrosesan standar | Atur tingkat service_tier permintaan ke default, atau gunakan tingkat Standar yang dikonfigurasi untuk penyebaran. |
Pemrosesan online dengan upaya terbaik untuk beban kerja umum. | Tarif bayar per token standar. | Beban kerja pengembangan, pengujian, dan produksi dengan lalu lintas variabel. |
| Pemrosesan prioritas | Konfigurasikan Prioritas pada penyebaran atau atur tingkat service_tier permintaan ke priority. |
Latensi yang lebih rendah dan lebih konsisten, dengan target yang ditentukan untuk model yang didukung. | Tarif bayar per token prioritas. | Aplikasi online yang peka terhadap latensi tanpa komitmen kapasitas yang dicadangkan. |
| Batch | Kirimkan pekerjaan batch asinkron ke penyebaran Batch. | Target penyelesaian hasil adalah dalam 24 jam. Tidak ada target latensi real time. | Tarif batch diskon. | Pekerjaan offline besar yang tidak memerlukan respons segera. |
| Throughput yang disediakan | Membuat penyebaran yang disediakan dan membeli atau memesan unit throughput yang disediakan (PTUs). | Kapasitas cadangan dengan throughput dan latensi yang dapat diprediksi. | Penagihan PTU per jam atau reservasi Azure. | Beban kerja produksi bervolume tinggi dan bersifat sangat kritis. |
Pilih Pemrosesan Flex saat semua kondisi berikut berlaku:
- Beban kerja Anda dapat mentolerir waktu pemrosesan yang lebih lama dan variabel.
- Anda lebih suka biaya yang lebih rendah daripada latensi yang dapat diprediksi.
- Aplikasi Anda dapat mencoba kembali kegagalan sementara atau merutekan permintaan yang gagal ke pemrosesan Standar.
- Model yang dipilih dan konteks permintaan didukung.
Jangan gunakan pemrosesan Flex saat salah satu kondisi berikut berlaku:
- Pengguna sedang menunggu respons interaktif.
- Permintaan harus diselesaikan dalam target latensi yang ketat.
- Aplikasi Anda tidak dapat mentolerir atau mencoba kembali respons HTTP 429 sementara.
- Anda memerlukan kapasitas pemrosesan yang dicadangkan atau laju pemrosesan yang dapat diprediksi.
Pemrosesan fleksibel memiliki karakteristik berikut:
-
Pilihan tingkat permintaan: Atur
service_tierkeflexpada setiap permintaan yang harus menggunakan pemrosesan Flex. - Tidak ada penyebaran terpisah: Kirim permintaan Standar dan Flex ke penyebaran Standar Global yang sama, dan pilih tingkat per permintaan.
- API yang didukung: Gunakan API Respons atau API Penyelesaian Obrolan.
- Respons sinkron: Panggilan API tetap sinkron, meskipun beban kerja dapat memakan waktu lebih lama untuk diselesaikan. Pemrosesan Flex tidak sama dengan API Batch.
- Ketersediaan tergantung kapasitas: Permintaan dapat mengembalikan HTTP 429 saat kapasitas Flex tidak tersedia.
-
Tidak ada pengalihan otomatis ke Standar: Aplikasi Anda harus secara eksplisit mencoba kembali dengan menetapkan
service_tierkedefaultjika pemrosesan Standar dapat diterima. - Kuota bersama: Permintaan Flex dan Standard menggunakan kuota yang ditetapkan ke penyebaran Standar Global.
- Kualitas output model yang sama: Flex menggunakan model yang mendasar yang sama dengan Standar. Tingkat pemrosesan mengubah latensi, ketersediaan, dan harga, bukan kualitas model.
Note
Token input dan output fleksibel menerima diskon 50% dibandingkan dengan tarif token Standar yang sesuai. Token input yang di-cache dan memenuhi syarat juga mendapatkan diskon yang berlaku untuk token yang di-cache. Untuk tarif saat ini, lihat harga Azure OpenAI.
Meninjau model yang didukung
Pemrosesan Flex memiliki ketersediaan model terbatas saat diluncurkan.
gpt-5.6-sol adalah model pertama yang didukung. Tabel berikut mencantumkan model yang didukung. Microsoft menambahkan lebih banyak model saat dukungan tersedia.
| Model | Version | Jenis penyebaran | Ketersediaan menurut wilayah |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-6-sol |
2026-09-22 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-6-luna |
2026-09-22 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-6-astra |
2026-09-03 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-5.6-sol |
2026-07-09 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-5.6-luna |
2026-07-09 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
gpt-5.6-terra |
2026-07-09 |
Standar Global | Semua wilayah Azure tempat Standar Global tersedia |
Periksa tabel ini sebelum Anda mengirim permintaan Flex. Jangan berasumsi bahwa model atau versi model baru mendukung pemrosesan Flex karena mendukung pemrosesan Standar atau Prioritas. Model yang tidak didukung mengembalikan HTTP 400. Untuk menghindari gangguan pada aplikasi Anda, terapkan fallback tingkat aplikasi ke pemrosesan Standar saat harga dan performa Standar dapat diterima.
Kembali ke pemrosesan Standar
Pemrosesan Flex tidak secara otomatis merutekan permintaan ke Standar ketika kapasitas Flex tidak tersedia. Jika menyelesaikan permintaan lebih penting daripada mempertahankan harga Flex, coba lagi permintaan dengan service_tier diatur ke default.
Contoh berikut menggunakan kebijakan yang mengutamakan penyelesaian. Ini pertama kali mencoba pemrosesan Flex dan mencoba kembali sekali dengan pemrosesan Standar setelah respons HTTP 429:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Beralih ke Standar mengubah harga dan karakteristik kinerja permintaan tersebut. Gunakan pola ini hanya ketika beban kerja dapat menerima harga Standar.
Respons HTTP 429 dapat menunjukkan kapasitas Flex yang tidak tersedia atau batas kuota. Karena pemrosesan Flex dan Standard berbagi kuota, permintaan Standard juga dapat gagal jika respons awal disebabkan oleh kuota. Terapkan batas percobaan ulang dan tangani RateLimitError kedua di aplikasi Anda. Saat layanan mengembalikan pengidentifikasi kesalahan khusus Flex, gunakan pengidentifikasi tersebut untuk membatasi fallback ke respons yang terkait dengan kapasitas.
Untuk beban kerja yang mengutamakan biaya terendah, coba ulangi pemrosesan Flex dengan backoff eksponensial sebelum beralih ke opsi cadangan. Untuk beban kerja yang mengutamakan waktu penyelesaian, beralih kembali ke Standard setelah terjadi kesalahan kapasitas Flex pertama.
Referensi:RateLimitError
Menangani kesalahan Flex
Membedakan kesalahan permintaan permanen dari kesalahan kapasitas sementara.
| HTTP Status | Kesalahan | Cause | Penanganan yang direkomendasikan |
|---|---|---|---|
| 400 | invalid_request_error |
Model yang dipilih, versi model, panjang konteks, API, atau konfigurasi permintaan tidak mendukung pemrosesan Flex. | Jangan coba kirim ulang permintaan yang sama tanpa perubahan. Pilih model atau panjang konteks yang didukung, atau coba lagi secara eksplisit dengan service_tier diatur ke default. |
| 408 | Permintaan habis waktu | Permintaan tidak selesai sebelum batas waktu klien atau layanan yang dikonfigurasi berakhir. Permintaan fleksibel dapat memakan waktu lebih lama daripada permintaan Standar. | Gunakan batas waktu klien yang lebih lama. Coba kembali dengan penundaan eksponensial terbatas. Jika waktu penyelesaian lebih penting daripada harga Flex, coba lagi dengan Standar. |
| 429 | Sumber daya tidak tersedia atau tarif terbatas | Kapasitas fleksibel untuk sementara tidak tersedia, atau permintaan melebihi batas tarif yang berlaku. Kapasitas fleksibel bersifat preemptible, sehingga kemungkinan tidak tersedia untuk sementara waktu lebih tinggi pada jam sibuk. | Jika permintaan melebihi batas tarif, tingkatkan batas tarif penyebaran Standar Global dengan menetapkan lebih banyak kuota. Flex dan Standard berbagi kuota ini. Jika langganan tidak memiliki kuota yang cukup untuk beban kerja throughput besar, minta penambahan kuota. Jika kapasitas Flex sementara tidak tersedia, coba lagi dengan penundaan bertahap eksponensial dan jeda acak, alihkan beban kerja yang toleran terhadap penundaan ke periode nonpuncak seperti malam pada hari kerja atau akhir pekan, atau coba lagi dengan service_tier disetel ke default. Hormati Retry-After jika ada. |
| 500, 502, 503, atau 504 | Kesalahan layanan sementara | Masalah layanan sementara atau gateway mencegah penyelesaian. | Coba kembali dengan penundaan eksponensial terbatas. Jangan mengirim percobaan ulang dalam jumlah tak terbatas. |
| 401 atau 403 | Kesalahan autentikasi atau otorisasi | Kredensial hilang, tidak valid, kedaluwarsa, atau tidak memiliki akses ke sumber daya. | Perbaiki kredensial atau penetapan peran. Jangan coba lagi sampai konfigurasi berubah. |
| 404 | Penyebaran tidak ditemukan | Nama penyebaran atau titik akhir salah. | Pastikan bahwa model sesuai dengan nama penyebaran dan URL dasar mengarah ke sumber daya Azure OpenAI yang benar. |
Note
Permintaan Flex yang ditolak karena kapasitas pemrosesan tidak tersedia tidak akan ditagih biaya. Namun, Anda mungkin akan mendapati kapasitas batas laju yang tersedia lebih rendah karena permintaan Flex dan Standard berbagi kuota yang dialokasikan ke deployment Global Standard.
Gunakan strategi backoff eksponensial dengan jitter acak untuk respons HTTP 408, 429, dan respons 5xx yang bersifat sementara. Atur jumlah coba lagi maksimum dan penundaan maksimum sehingga permintaan yang gagal tidak tetap dalam perulangan coba lagi yang tidak terbatas.
- Pertahankan
Retry-Afterjika respons menyertakannya. - Jika tidak, tunggu penundaan yang meningkat secara eksponensial dengan jitter acak.
- Gunakan kembali Flex hanya selama penundaannya masih dapat diterima untuk beban kerja.
- Gunakan Standard sebagai cadangan jika batas percobaan ulang telah habis dan aplikasi mengizinkan biaya Standard yang lebih tinggi.
- Kembalikan kegagalan eksplisit jika baik pemrosesan Flex yang ditunda maupun mekanisme fallback Standar tidak memenuhi persyaratan aplikasi.
Jangan berulang kali mencoba lagi permintaan Flex yang sama dan tidak didukung. Coba lagi hanya berhasil setelah Anda mengubah model, panjang konteks, konfigurasi API, atau tingkat layanan.
Memantau penggunaan dan biaya
Gunakan metrik Azure Monitor untuk membandingkan lalu lintas Flex dan Standar pada penyebaran yang sama. Pantau volume permintaan, konsumsi token, latensi, kegagalan, dan tingkat permintaan Flex kembali ke Standar dalam aplikasi Anda.
Masuk ke portal Azure.
Buka sumber daya OpenAI Azure Anda, dan pilih Metrik.
Tambahkan metrik Permintaan OpenAI Azure. Anda juga dapat menambahkan latensi Azure OpenAI, penggunaan Azure OpenAI, dan metrik galat.
Tambahkan filter di mana ServiceTierRequest sama dengan
flex.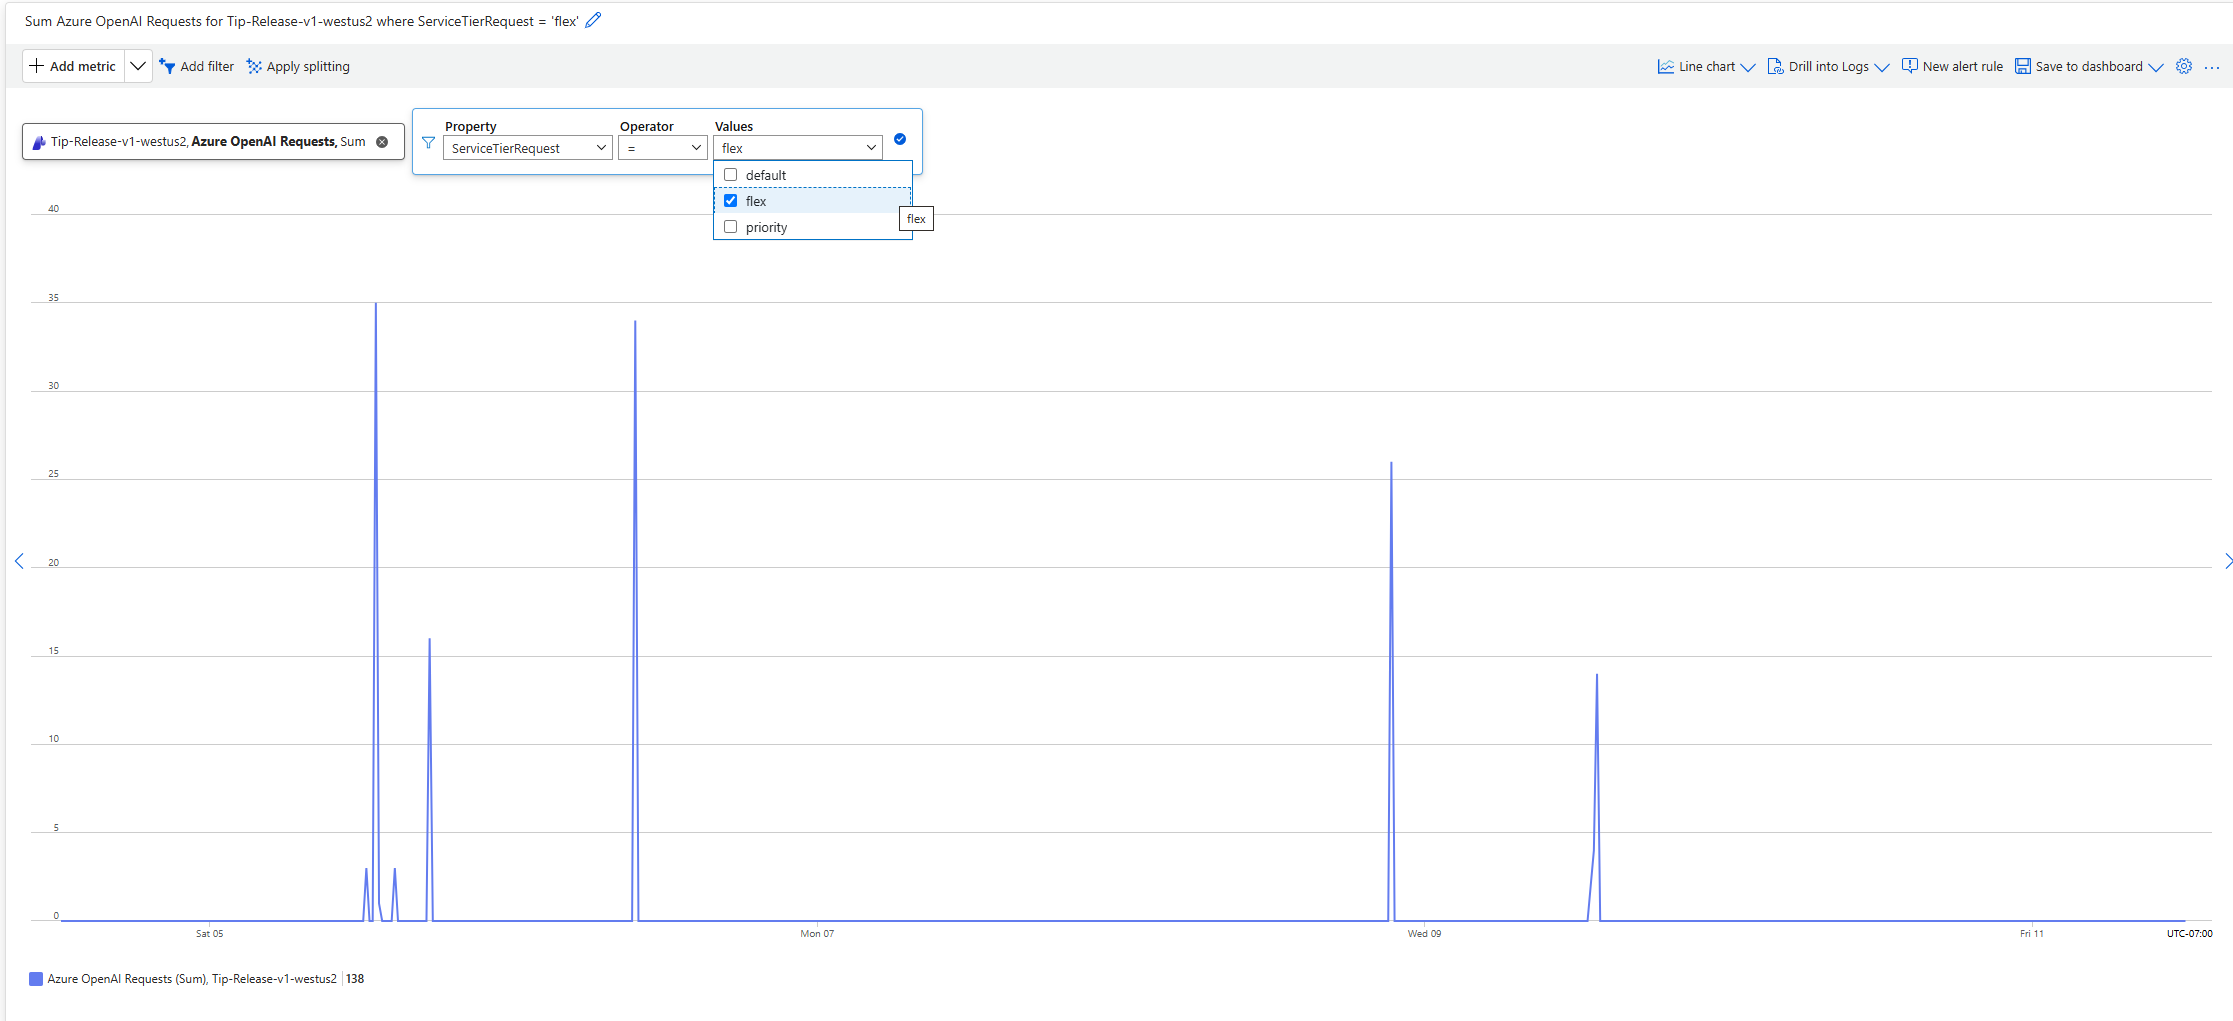
Buat alert untuk respons HTTP 429 yang terus-menerus, peningkatan rasio kesalahan, dan latensi yang melebihi anggaran percobaan ulang workload Anda.
Lacak sinyal berikut untuk setiap beban kerja:
| Sinyal | Mengapa penting |
|---|---|
| Jumlah permintaan Flex | Menampilkan tingkat adopsi dan lalu lintas yang diarahkan untuk pemrosesan berbiaya lebih rendah. |
| Tingkat keberhasilan permintaan Flex | Menunjukkan seberapa sering kapasitas Flex menerima dan menyelesaikan permintaan. |
| Tarif HTTP 429 | Menunjukkan periode ketika kapasitas Flex atau kuota penyebaran dibatasi. |
| Jumlah dan laju fallback standar | Menunjukkan manfaat keandalan dan biaya tambahan dari mekanisme cadangan yang dikendalikan oleh aplikasi. |
| Input, input yang di-cache, dan token output | Mendukung atribusi biaya dan memverifikasi dampak cache prompt. |
| Latensi ujung ke ujung | Membantu menentukan apakah beban kerja tetap cocok untuk Flex. |
Jumlah HTTP 400 invalid_request_error |
Mengidentifikasi model, versi model, panjang konteks, atau konfigurasi permintaan yang tidak didukung. |
Untuk informasi selengkapnya tentang memantau penyebaran model, lihat Memantau Azure OpenAI.
Penggunaan Flex ditagih pada meter Flex khusus sehingga Anda dapat membedakannya dari penggunaan Standar. Gunakan Analisis Biaya untuk meninjau biaya token Flex berdasarkan sumber daya dan penyebaran.
- Di portal Azure, buka Cost Management + Billing>Analisis biaya.
- Filter berdasarkan langganan, grup sumber daya, atau sumber daya Azure OpenAI yang berisi penerapan.
- Kelompokkan atau filter menurut Meter untuk memisahkan penggunaan Flex dari penggunaan Standar.
- Tambahkan filter penagihan Tag, pilih deployment, dan pilih nama deployment.
- Bandingkan penghematan biaya Flex dengan biaya fallback Standar dan persyaratan penyelesaian beban kerja.
Token input dan output flex dihargai 50% dari tarif Standar yang sesuai. Cache prompt dapat semakin mengurangi biaya untuk token input yang di-cache dan memenuhi syarat. Permintaan Flex yang ditolak karena kapasitas pemrosesan tidak tersedia tidak akan ditagih biaya.
Menerapkan praktik terbaik produksi
- Atur batas waktu yang lebih lama. Permintaan fleksibel dapat memakan waktu lebih lama daripada permintaan Standar. Mulailah dengan waktu tunggu klien yang sesuai untuk beban kerja Anda, misalnya 15 menit, lalu uji dengan prompt yang representatif.
- Gunakan percobaan ulang terbatas. Batasi jumlah percobaan ulang dan total waktu berlalu.
- Tambahkan jitter. Acakkan penundaan backoff untuk menghindari lonjakan percobaan ulang yang serentak.
- Jelaskan alternatif cadangan secara eksplisit. Atur
service_tierkedefaultdaripada mengandalkan perilaku implisit. - Pantau tingkat yang diproses. Catat nilai respons
service_tierdengan latensi, status, penggunaan token, dan data biaya. - Pisahkan lalu lintas interaktif dan latar belakang. Pertahankan permintaan yang ditujukan kepada pengguna pada throughput Standar, Prioritas, atau yang diprovisikan, kecuali jika latensi Flex yang bervariasi dapat diterima.
- Kendalikan pekerjaan ganda. Pastikan aplikasi tidak mengirimkan tugas logis yang sama beberapa kali setelah timeout di sisi klien.
- Menguji jalur kegagalan. Validasi penanganan untuk respons HTTP 400, 408, 429, dan 5xx sementara sebelum menggunakan pemrosesan Flex dalam alur kerja produksi.
- Tinjau dukungan model sebelum peningkatan. Model pengganti atau versi model tidak secara otomatis mewarisi dukungan Flex.
Mengesampingkan level layanan menggunakan header permintaan
Gunakan header permintaan x-ms-service-tier saat gateway, proksi, atau lapisan perutean terpusat perlu memilih tingkat layanan tanpa memeriksa atau memodifikasi bodi permintaan. Header tersebut juga dapat mengurangi perubahan yang diperlukan saat migrasi untuk aplikasi yang telah memilih tingkat layanan OpenAI melalui header permintaan.
Header menerima nilai berikut:
| Nilai Header | Tingkat pemrosesan yang diminta |
|---|---|
flex |
Fleksibel |
priority |
Prioritas |
default |
Standar |
auto |
Prioritas |
Ketika header ada dan valid, header tersebut diprioritaskan daripada nilai service_tier dalam badan permintaan.
| Masukan header | Input isi permintaan | Perilaku dan keluaran |
|---|---|---|
| Header dihilangkan | Nilai service_tier yang valid |
Bodi permintaan menentukan tingkat. Respons yang berhasil mengidentifikasi tingkat yang diproses di service_tier. |
| Nilai header yang valid | Nilai apa pun atau dihilangkan | Header memilih tier yang diminta. Respons yang berhasil mengidentifikasi tingkat yang diproses di service_tier. |
| Nilai header yang tidak didukung | Nilai apa pun atau dihilangkan | Permintaan mengembalikan HTTP 400. Layanan tidak kembali ke nilai isi permintaan. |
Contoh ini meminta pemrosesan Flex melalui header. Header mengambil alih default nilai dalam isi permintaan:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Header penggantian tidak menyediakan cadangan otomatis. Nilai header yang tidak valid atau tier yang tidak didukung oleh deployment yang dipilih akan menghasilkan HTTP 400.