Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Azure Batch menjalankan pekerjaan batch komputasi paralel dan performa tinggi (HPC) skala besar dalam Azure. Batch membuat dan mengelola kumpulan simpul komputasi, menginstal aplikasi yang ingin Anda jalankan, dan menjadwalkan pekerjaan untuk dijalankan pada simpul.
Saat Anda menggunakan Azure, keandalan adalah tanggung jawab bersama. Microsoft menyediakan berbagai kemampuan untuk mendukung ketahanan dan pemulihan. Anda bertanggung jawab untuk memahami cara kerja kemampuan tersebut dalam semua layanan yang Anda gunakan, dan memilih kemampuan yang Anda butuhkan untuk memenuhi tujuan bisnis dan tujuan waktu aktif Anda.
Artikel ini menjelaskan cara membuat Azure Batch tahan terhadap kesalahan sementara, kegagalan simpul komputasi, kegagalan zona ketersediaan, kegagalan di seluruh wilayah, dan pemeliharaan layanan. Ini juga menjelaskan rekomendasi penyebaran produksi, arsitektur keandalan Batch, pencadangan dan pemulihan, dan informasi utama tentang perjanjian tingkat layanan (SLA) Azure Batch.
Rekomendasi penyebaran produksi
Untuk beban kerja produksi, ikuti praktik terbaik untuk Azure Batch, termasuk rekomendasi keandalan ini:
Rancang tugas untuk menoleransi gangguan dan eksekusi kembali. Buat tugas idempoten, buat checkpoint untuk pekerjaan yang berjalan lama, dan simpan output dan data diagnostik yang diperlukan ke penyimpanan yang tahan lama. Untuk informasi selengkapnya, lihat Ketahanan terhadap kesalahan sementara dan Ketahanan terhadap kegagalan simpul komputasi.
Gunakan beberapa simpul komputasi saat beban kerja Anda harus tetap berjalan setelah kegagalan node. Simpul komputasi individual tidak dijamin tetap tersedia. Sediakan simpul yang cukup sehingga simpul yang dapat digunakan yang tersisa dapat menjalankan tugas yang dijadwalkan ulang.
Gunakan penempatan zona ketersediaan saat didukung. Konfigurasikan penempatan zona ketersediaan jika wilayah, SKU komputer virtual (VM), dan konfigurasi beban kerja mendukungnya. Simpul di zona sehat dapat terus menjalankan tugas selama pemadaman zona, tetapi rencanakan pengurangan kapasitas karena kapasitas penggantian tergantung pada kuota dan ketersediaan VM di zona sehat. Untuk informasi selengkapnya, lihat Ketahanan terhadap kegagalan zona ketersediaan.
Rancang pekerjaan untuk menargetkan kumpulan secara dinamis, bukan ID kumpulan yang tetap. Desain ini memungkinkan Anda untuk menargetkan ulang pekerjaan ke kumpulan yang sehat jika kumpulan asli menjadi tidak tersedia atau gagal menskalakan ke kapasitas yang diinginkan. Ini meningkatkan kelangsungan bisnis selama pemeliharaan atau kegagalan pool.
Jaga konfigurasi pool tetap terkini. Pantau tanggal akhir masa pakai (EOL) untuk image VM dan SKU, dan migrasikan kumpulan sebelum EOL. Ikuti panduan pemeliharaan layanan untuk menjaga agen simpul Batch tetap terkini.
Gambaran umum arsitektur keandalan
Bagian ini menjelaskan beberapa aspek penting tentang cara kerja layanan yang paling relevan dari perspektif keandalan. Bagian ini memperkenalkan arsitektur logis, yang mencakup beberapa sumber daya dan fitur yang Anda sebarkan dan gunakan. Ini juga membahas arsitektur fisik, yang memberikan detail tentang cara kerja layanan di bawah sampul.
Arsitektur logika
Azure Batch menggunakan beberapa jenis sumber daya untuk menjalankan beban kerja batch. Konfigurasi sumber daya ini menentukan bagaimana beban kerja Anda merespons kegagalan.
Semua pemrosesan dan sumber daya Batch dikaitkan dengan akun Batch. Solusi Batch menggunakan komponen logis berikut:
Akun batch: Sumber daya regional yang terkait dengan kumpulan, pekerjaan, tugas, dan sumber daya Batch lainnya. Anda membuat akun dan memilih wilayahnya, mode alokasi kumpulan, dan pengaturan autentikasi.
Pool: Kumpulan simpul komputasi tempat tugas dijalankan. Konfigurasi kumpulan mendefinisikan gambar dan ukuran VM- nya, jumlah simpul target, perilaku penskalaan, jaringan, dan penempatan zona. Anda mengonfigurasi setiap kumpulan untuk menyediakan kapasitas, penempatan, dan lingkungan operasi yang diperlukan beban kerja Anda. Jumlah simpul target adalah kapasitas yang diminta, tetapi jumlah simpul yang dialokasikan bisa lebih rendah karena batas kuota, batasan kapasitas, atau kegagalan alokasi.
Pekerjaan dan tugas:Pekerjaan mengelola kumpulan tugas dan dikaitkan dengan pool. task menjalankan aplikasi atau skrip pada simpul komputasi. Anda menentukan job, tugas, batasan, dependensi, perilaku percobaan ulang, dan pool tempat setiap job berjalan.
Akun penyimpanan terkait: Akun Azure Storage yang Anda tautkan secara opsional ke akun Batch. Sebagian besar solusi Batch menggunakan akun penyimpanan terkait untuk file aplikasi, file sumber daya tugas, data input, dan data output.
Setelah Anda menautkan akun penyimpanan ke akun Batch, Batch menyebutnya sebagai akun autostorage. Akun Autostorage diperlukan untuk paket aplikasi dan juga dapat menyimpan file sumber daya tugas.
Keandalan solusi Batch tergantung pada sumber daya penyimpanannya. Anda bertanggung jawab untuk memilih konfigurasi redundansi penyimpanan yang memenuhi persyaratan pemulihan Anda saat membuat akun penyimpanan. Pindahkan output tugas dan data tahan lama lainnya dari simpul komputasi ke penyimpanan. Untuk informasi tentang opsi keandalan Azure Storage, lihat Keandalan dalam Azure Blob Storage.
Untuk informasi selengkapnya, lihat Alur kerja layanan Batch dan sumber daya serta akun Batch dan akun Azure Storage.
Arsitektur fisik
Azure Batch memiliki control plane regional yang memproses operasi manajemen terhadap akun Batch dan sumber daya Batch lainnya, seperti kumpulan, pekerjaan, dan tugas. Ini terpisah dari simpul komputasi yang menjalankan tugas.
pool Azure Batch menggunakan Azure Virtual Machines dan Virtual Machine Scale Sets. Simpul komputasi adalah VM yang memproses bagian dari beban kerja Batch. Setiap node milik sebuah pool dan menjalankan tugas yang ditetapkan layanan Batch kepadanya. Agen node Batch berjalan pada setiap simpul dan menyediakan antarmuka perintah dan kontrol antara simpul dan layanan Batch. Simpul komputasi dan penyimpanan lokalnya bersifat ephemeral. Ketika node meninggalkan pool, perubahan pada sistem operasi dan filenya hilang.
Mode alokasi kumpulan akun Batch menentukan tempat Batch membuat sumber daya terkait komputasi dan VM:
- Mode alokasi kumpulan layanan batch: Batch mengalokasikan sumber daya dalam langganan Azure yang dikelola layanan Batch.
- Mode alokasi kumpulan langganan pengguna: Batch membuat sumber daya langsung dalam langganan yang berisi akun Batch.
Tanggung jawab untuk arsitektur fisik dibagi sebagai berikut:
Microsoft: Microsoft mengoperasikan control plane Batch regional dan infrastruktur layanan. Batch menyediakan simpul komputasi sesuai dengan konfigurasi kumpulan dan kapasitas yang tersedia, menjadwalkan tugas, memantau kesehatan simpul, dan mencoba memulihkan simpul setelah kegagalan infrastruktur. Batch dapat mengantre ulang tugas yang terganggu untuk eksekusi pada simpul lain yang tersedia.
Anda: Anda memilih image VM dan ukuran, jenis node, jumlah simpul target, konfigurasi penskalaan, jaringan, dan penempatan zona ketersediaan.
Anda juga bertanggung jawab untuk mempertahankan kapasitas yang cukup untuk mentolerir kegagalan node, memantau status node dan tugas, menjaga sistem operasi tamu dan agen node tetap terkini, merancang tugas untuk mentolerir eksekusi ulang, dan memindahkan data tahan lama dari node komputasi.
Pemulihan simpul batch tidak menjamin bahwa beban kerja berlanjut tanpa gangguan. Untuk informasi selengkapnya, lihat Ketahanan terhadap kegagalan simpul komputasi.
Ketahanan terhadap kesalahan sementara
Kesalahan sementara adalah kegagalan yang bersifat sementara dan intermiten dalam komponen. Mereka sering terjadi di lingkungan terdistribusi seperti cloud, dan mereka adalah bagian normal dari operasi. Kesalahan sementara memperbaiki diri setelah waktu yang singkat. Penting bahwa aplikasi Anda dapat menangani kesalahan sementara, biasanya dengan mencoba kembali permintaan yang terpengaruh.
Semua aplikasi yang dihosting cloud harus mengikuti panduan penanganan kesalahan sementara Azure saat berkomunikasi dengan API, database, dan komponen lain yang dihosting cloud. Untuk informasi selengkapnya, lihat Rekomendasi untuk menangani kesalahan sementara.
Dalam solusi Batch, kesalahan sementara dapat memengaruhi aplikasi dan skrip yang berjalan sebagai tugas dan aplikasi apa pun yang memanggil API Batch untuk mengelola sumber daya Batch. Batch menyediakan mekanisme coba lagi di tingkat tugas. Anda bertanggung jawab untuk mengonfigurasi batasan tugas, membuat tugas idempotent (aman untuk dijalankan lebih dari sekali), dan mengonfigurasi perilaku coba lagi untuk panggilan ke layanan Batch dan dependensi lainnya.
Percobaan ulang tugas dan batas waktu
Konfigurasikan maxTaskRetryCount untuk mengontrol berapa kali Batch mencoba kembali tugas setelah prosesnya keluar dengan kode keluar bukan nol:
- Nilai default,
0, berarti bahwa Batch tidak mencoba kembali tugas setelah kode keluar nonnol. - Bilangan bulat positif menetapkan jumlah maksimum percobaan ulang setelah upaya awal.
- Nilai
-1memungkinkan percobaan ulang tanpa batas. Nilai ini tidak disarankan karena kegagalan persisten dapat menyebabkan tugas berjalan tanpa henti.
Rancang setiap tugas menjadi idempoten sehingga percobaan ulang tidak menyebabkan kerusakan data atau output duplikat. Untuk tugas yang berjalan lama, gunakan pembuatan checkpoint sehingga percobaan ulang dapat berlanjut dari kemajuan yang disimpan. Untuk informasi selengkapnya, lihat Desain untuk percobaan ulang dan eksekusi ulang.
Atur constraint maxWallClockTime pada tugas atau pekerjaan untuk mengakhiri pekerjaan yang tidak membuat kemajuan dalam periode yang dapat diterima. Batas waktu juga membatasi dampak kegagalan berulang. Pilih jumlah coba lagi dan batas waktu yang selaras dengan tujuan pemulihan beban kerja.
Kesalahan sementara dalam dependensi tugas
Aplikasi dan skrip yang berjalan sebagai tugas Batch sering memanggil komponen lain, seperti Azure Storage, database, atau API. Batch tidak mengelola permintaan individual yang dikirim oleh kode tugas ke dependensi ini. Terapkan penanganan kegagalan transien dalam kode tugas, atau gunakan fitur coba lagi yang disediakan oleh SDK dependensi. Ikuti panduan setiap dependensi untuk mengidentifikasi kesalahan yang dapat dicoba lagi, pilih pengaturan backoff dan waktu habis yang sesuai, dan patuhi instruksi retry seperti header Retry-After. Ulangi hanya operasi yang aman untuk diulang.
Jika kegagalan dependensi menyebabkan proses tugas keluar dengan kode keluar bukan nol, Batch dapat mencoba kembali seluruh tugas sesuai dengan maxTaskRetryCount. Namun, Batch tidak mencoba kembali permintaan dependensi individual dalam tugas yang sedang berjalan.
Percobaan ulang permintaan API Batch
Aplikasi Anda yang berjalan di luar layanan dapat memanggil Batch API untuk membuat dan mengelola pool, job, task, node komputasi, dan sumber daya Batch lainnya. Konfigurasikan klien ini dengan kebijakan percobaan ulang yang mencakup setidaknya lima menit untuk menangani kegagalan sementara pada layanan Batch atau jaringan.
Gunakan dukungan retry bawaan pada SDK saat tersedia. Misalnya, Azure.Compute.Batch client library for .NET mengekspos perilaku coba lagi melalui Azure.Core opsi coba lagi.
Jika Anda berinteraksi langsung dengan API layanan Batch dari kode Anda, tunggu beberapa detik sebelum mencoba kembali, gunakan backoff eksponensial dengan pengacakan (jitter) untuk menghindari permintaan coba lagi yang disinkronkan, dan hormati header Retry-After yang dikembalikan bersama respons throttling seperti 429 Too Many Requests dan 503 Service Unavailable.
Batas waktu permintaan tidak selalu berarti bahwa Batch gagal memproses permintaan. Setelah terjadi timeout, coba lagi operasi saat aman untuk melakukannya, atau ambil status sumber daya untuk menentukan apakah operasi asli berhasil. Untuk informasi selengkapnya, lihat Penanganan kesalahan dan deteksi di Azure Batch.
Ketahanan terhadap kegagalan simpul komputasi
Simpul komputasi dapat menjadi tidak tersedia karena kegagalan infrastruktur, masalah sistem operasi, atau masalah konfigurasi. Batch mencoba memulihkan simpul yang terpengaruh oleh kegagalan infrastruktur, tetapi tidak dapat memulihkan setiap kegagalan terkait konfigurasi secara otomatis. Misalnya, jika paket aplikasi atau kontainer gagal diinstal, Anda harus memperbaiki masalah yang mendasar dan mungkin perlu menghapus dan mengganti simpul yang terpengaruh.
Jika kegagalan node mengganggu tugas, Batch dapat mencoba kembali tugas pada simpul yang sama, jika memungkinkan, hingga batas internal. Jika tugas tidak dapat dilanjutkan pada simpul tersebut, Batch dapat mengantrekannya kembali untuk dieksekusi pada simpul lain yang tersedia. Percobaan ulang pemulihan berbasis layanan ini independen dari maxTaskRetryCount dan dapat terjadi bahkan ketika nilainya adalah 0.
proses pemulihan simpul yang dikelola Microsoft
Microsoft mengelola pemulihan simpul berbasis layanan dan penantrean ulang tugas. Jika layanan Batch berhenti menerima heartbeat dari node cukup lama untuk memicu pemulihan, Batch dapat melakukan tindakan berikut:
-
Isolasikan simpul: Batch memperlakukan simpul sebagai tidak sehat, mengatur statusnya ke
unusable, dan berhenti menjadwalkan tugas baru di dalamnya. - Identifikasi tugas yang terpengaruh: Batch mengidentifikasi tugas yang berjalan pada simpul sebagai kandidat untuk penjadwalan ulang.
-
Mengantrekan ulang tugas yang memenuhi syarat: Jika tugas yang terpengaruh masih bertahan dalam
runningstatus, Batch dapat mengatur ulang keactivesehingga penjadwal dapat menetapkannya ke simpul lain. Batch tidak mengatur ulang atau menjalankan ulang tugas yang sudah disimpan dalam statuscompleted. - Pulihkan simpul: Batch mencoba memulihkan simpul ke status sehat atau mengganti VM yang mendasar.
Pemulihan tidak seketika. Tugas dapat tetap dalam status running sementara Batch mendeteksi kegagalan simpul dan mencoba menjadwalkan ulang tugas. Jika tidak ada simpul komputasi lain yang tersedia, tugas dapat tetap dalam status tersebut sampai Batch dapat menjadwalkannya ulang. Untuk informasi selengkapnya, lihat Batasan yang diketahui untuk tugas Batch.
Jika node asli melanjutkan heartbeat sehat sebelum penggantian dimulai, Batch dapat mengembalikannya ke keadaan stabil. Jika penggantian telah dimulai, Batch dapat menghapus VM asli dan menyediakan pengganti.
Tanggung jawab Anda
Pemulihan berbasis layanan tidak menjamin eksekusi tugas yang tidak terganggu atau kapasitas yang tersisa yang memadai. Anda bertanggung jawab atas tindakan berikut:
Pertahankan kapasitas yang memadai: Jika beban kerja Anda harus tetap berjalan saat simpul tidak tersedia, sediakan simpul yang cukup agar simpul yang tersisa dapat menjalankan tugas yang dijadwalkan ulang. Tanpa simpul lain yang dapat digunakan, tugas yang terganggu harus menunggu.
Memantau kapasitas yang dapat digunakan: Lacak jumlah total simpul dan statusnya sehingga Anda dapat mendeteksi kapan kumpulan tidak lagi memiliki cukup simpul yang dapat digunakan untuk beban kerja Anda. Status seperti
unusable,startTaskFailed,unknown, danpreemptedmenunjukkan kapasitas yang berkurang. Untuk informasi selengkapnya, lihat Memantau solusi Batch dengan menghitung tugas dan simpul berdasarkan status.Selidiki simpul yang bermasalah: Jika tugas berulang kali gagal, diantrekan kembali, atau tetap dalam status
runningsetelah simpul yang ditetapkan menjadi tidak dapat digunakan atau meninggalkan kumpulan, gunakan metadata tugas untuk menentukan apakah masalah terkait dengan simpul tertentu.Sebelum Anda menghapus simpul masalah, unggah log agen simpul Batch-nya dan pertahankan log tugas yang relevan karena menghapus simpul akan menghapus file lokalnya. Log agen node dapat membantu Microsoft Support mendiagnosis layanan Batch atau masalah node, sementara log tugas seperti stdout dan stderr dapat membantu Anda mengidentifikasi masalah aplikasi dan konfigurasi. Untuk informasi selengkapnya, lihat File log agen node.
Lindungi kemajuan dan data tugas: Rancang tugas agar tahan terhadap gangguan dan eksekusi ulang. Pindahkan titik pemeriksaan, output, dan data tahan lama lainnya dari simpul komputasi karena penyimpanan lokalnya bersifat sementara.
Untuk informasi selengkapnya, lihat kesalahan kumpulan dan simpul Azure Batch serta Penanganan dan deteksi kesalahan di Azure Batch.
Ketahanan terhadap kegagalan zona ketersediaan
Zona ketersediaan adalah grup pusat data yang terpisah secara fisik dalam wilayah Azure. Ketika satu zona gagal, layanan dapat melakukan failover ke salah satu zona yang tersisa.
Batch mendukung zona ketersediaan dengan dua cara utama:
Control plane: Control plane Batch tahan terhadap kegagalan zona di banyak wilayah. Di wilayah tersebut, operasi manajemen terhadap akun Batch dan sumber daya Batch lainnya dapat berlanjut selama kegagalan zona. Microsoft tidak mempublikasikan wilayah yang menyediakan ketahanan control plane ini.
Pool: Anda dapat mengonfigurasi kumpulan Batch untuk menggunakan penempatan zona ketersediaan. Jika zona menjadi tidak tersedia, simpul komputasi di zona sehat tetap tersedia untuk penjadwalan tugas.
Untuk penempatan simpul komputasi, model dukungan ini mirip dengan redundansi zona di layanan Azure lainnya karena satu kumpulan dapat berisi simpul komputasi di beberapa zona ketersediaan. Namun, Batch mendistribusikan simpul di seluruh zona sebisa mungkin. Ini mencoba menggunakan semua zona di wilayah tetapi tidak menjamin penempatan di setiap zona atau distribusi yang merata. Anda tidak dapat memilih zona tertentu atau mengontrol jumlah simpul yang ditempatkan di setiap zona.
Diagram berikut menunjukkan contoh akun Batch. Akun ini memiliki satu kumpulan dengan simpulnya yang didistribusikan di tiga zona ketersediaan:
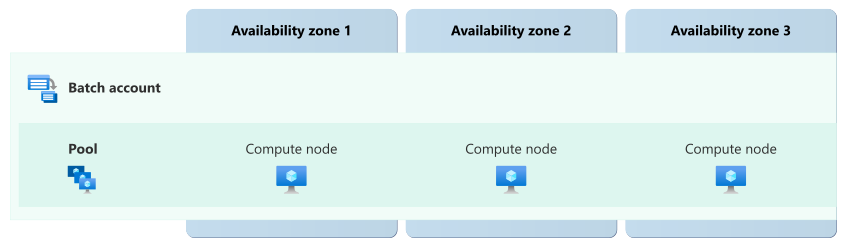
Diagram menunjukkan akun Batch yang berisi satu kumpulan. Pool memiliki tiga simpul komputasi, dengan satu simpul ditunjukkan di setiap zona ketersediaan 1, 2, dan 3. Penempatan zona ketersediaan/Availability Zone berlaku untuk node komputasi dan tidak menentukan ketahanan zona control plane Batch. Distribusi adalah contoh karena Batch menggunakan penyeimbangan best-effort dan tidak menjamin satu simpul di setiap zona.
Anda bertanggung jawab untuk membuat sumber daya dependen lainnya, seperti akun penyimpanan, memiliki ketahanan zona. Tinjau panduan keandalan untuk setiap layanan. Untuk informasi selengkapnya, lihat Panduan keandalan untuk layanan Azure.
Requirements
Dukungan wilayah: Buat kumpulan di wilayah Azure yang mendukung zona ketersediaan.
Ketersediaan VM SKU: SKU VM yang dipilih harus tersedia di lebih dari satu zona di wilayah tersebut. Gunakan API Daftar SKU Sumber Daya untuk memeriksa bidang
locationInfountuk SKU VM.Akses langganan: Untuk mode alokasi kumpulan langganan pengguna, langganan tidak boleh memiliki pembatasan penawaran zona untuk SKU VM yang dipilih. Periksa
ResourceSkuRestrictionsdi respons API Daftar SKU Sumber Daya. Jika ada pembatasan, kirimkan permintaan dukungan untuk meminta penghapusannya.Komunikasi antar-simpul: Kumpulan tidak dapat menggunakan kebijakan penempatan zona ketersediaan saat komunikasi antar-simpul diaktifkan dengan SKU VM berkemampuan InfiniBand.
Distribusi instans di seluruh zona
Saat Anda mengaktifkan penempatan zona ketersediaan, Batch mencoba mengalokasikan simpul komputasi di semua zona ketersediaan di wilayah yang dipilih. Alokasi ini dilakukan berdasarkan prinsip best-effort. Batch mengontrol distribusi, dan jumlah simpul di setiap zona mungkin tidak sama.
Cost
Batch tidak menambahkan biaya untuk mengaktifkan penempatan zona ketersediaan. Anda ditagih untuk komputasi, penyimpanan, jaringan, dan sumber daya Azure lainnya yang digunakan oleh beban kerja. Jika Anda menyediakan node tambahan untuk mengantisipasi hilangnya satu zona, node tersebut akan dikenakan biaya normal. Untuk informasi selengkapnya, lihat harga Azure Batch.
Mengonfigurasi dukungan zona ketersediaan
Buat kumpulan baru dengan penempatan zona ketersediaan: Untuk membuat kumpulan dengan penempatan zona ketersediaan diaktifkan, lihat Membuat kumpulan Batch di seluruh zona ketersediaan.
Ubah penempatan zona ketersediaan pada kumpulan yang ada: Anda harus memilih penempatan zona ketersediaan saat membuat kumpulan. Anda tidak dapat mengubah kumpulan yang ada untuk menggunakan zona ketersediaan.
Anda dapat membuat pool pengganti dan memperbarui setiap job Anda untuk menggunakannya dengan menggunakan langkah-langkah berikut:
Nonaktifkan pekerjaan: Gunakan operasi Nonaktifkan Pekerjaan , dan pilih cara Batch menangani tugas yang berjalan saat Anda mengirimkan permintaan:
-
Tunggu: Batch berhenti memulai tugas baru dan memungkinkan tugas yang sedang berjalan selesai pada kumpulan yang ada. Pekerjaan tetap dalam keadaan
disablinghingga tugas yang sedang berjalan selesai. - Masukkan kembali ke antrean: Batch menginterupsi tugas yang sedang berjalan dan mengembalikannya ke antrean. Tugas dapat berjalan lagi setelah Anda mengaktifkan job.
- Hentikan: Batch menghentikan tugas yang sedang berjalan dan menandainya sebagai selesai dengan informasi kegagalan yang menunjukkan bahwa tugas tersebut dihentikan. Task tidak berjalan lagi setelah Anda mengaktifkan job.
Tugas yang sudah dalam status
activestate, yang berarti bahwa tugas tersebut diantrekan tetapi tidak berjalan, tetap diantrekan dengan setiap opsi.Tunggu hingga pekerjaan mencapai status
disabledsebelum melanjutkan. Pada saat itu, tidak ada tugas yang berjalan dan Batch tidak akan menjadwalkan tugas baru.-
Tunggu: Batch berhenti memulai tugas baru dan memungkinkan tugas yang sedang berjalan selesai pada kumpulan yang ada. Pekerjaan tetap dalam keadaan
Edit pool pekerjaan: Gunakan operasi Perbarui Pekerjaan untuk mengatur pool pekerjaan
poolInfo.poolIdke pool pengganti. Batch hanya mengizinkan properti ini berubah saat job dalam keadaandisabled. Pastikan bahwa kumpulan pengganti ada dan memiliki kapasitas yang dapat digunakan sebelum Anda mengaktifkan job. Jika pool tidak ada, Batch menerima pembaruan, tetapi tidak dapat menjadwalkan tugas hingga Anda membuat pool.Aktifkan job: Gunakan operasi Aktifkan Job. Pekerjaan beralih melalui status
enablingke statusactive. Batch kemudian menjadwalkan tugas yang diantrekan, termasuk tugas yang dikembalikan ke antrean oleh opsi Antrean Ulang , pada kumpulan pengganti. Tugas yang selesai saat Batch menerapkan opsi Tunggu dan tugas yang dihentikan oleh opsi Hentikan tidak berjalan lagi.
Perencanaan dan manajemen kapasitas
Proses pemulihan simpul normal Batch mencoba mengganti simpul yang menjadi tidak dapat digunakan selama kegagalan zona dan memulihkan kumpulan ke jumlah simpul target yang dikonfigurasi. Itu tidak menambah target tersebut. Untuk mempertahankan kapasitas yang cukup agar beban kerja berlanjut ketika satu zona tidak tersedia, pertimbangkan untuk menyediakan kapasitas kumpulan secara provisi berlebih dengan menggunakan skala otomatis atau secara manual:
Jika Anda menggunakan skala otomatis: Rujuk
$UsableNodeCountvariabel yang ditentukan layanan dalam rumus skala otomatis kumpulan untuk mendeteksi kapan kapasitas yang dapat digunakan berada di bawah nilai dasar yang diperlukan beban kerja Anda.$UsableNodeCountadalah variabel skala otomatis Batch untuk kumpulan yang rumusnya sedang dievaluasi, bukan metrik Azure Monitor. Azure Monitor menerbitkan metrik jumlah simpul Batch di cakupan akun Batch, dan metrik tersebut tidak memilikipoolIddimensi.Jika Anda mengelola kapasitas secara manual: Gunakan operasi List Pool Node Counts untuk mengambil jumlah simpul khusus dan Spot di setiap status untuk setiap kumpulan. Operasi ini tidak mengembalikan jumlah node yang dapat digunakan. Menilai status yang mampu menjalankan tugas seperti
idledanunusableterhadap status tidak tersedia atau bermasalah sepertiunknown,offline,startTaskFailed, danrunning. Jumlah yang dikembalikan mungkin tidak mutakhir, jadi enumerasi node komputasi kumpulan saat Anda memerlukan jumlah yang tepat.
Batch mendistribusikan simpul di seluruh zona secara best-effort, sehingga distribusi aktual mungkin tidak sama. Jangan berasumsi bahwa simpul didistribusikan secara merata di seluruh zona saat Anda merencanakan kapasitas. Validasi bahwa beban kerja Anda dapat memenuhi tujuan pemulihannya dengan kapasitas kumpulan yang berkurang.
Perilaku ketika semua zona sehat
Bagian ini menjelaskan apa yang diharapkan ketika kumpulan Batch menggunakan penempatan zona ketersediaan dan semua zona beroperasi.
Operasi lintas zona: Batch menjadwalkan tugas pada simpul komputasi yang tersedia di seluruh kumpulan, terlepas dari zona yang berisi setiap simpul.
Replikasi data lintas zona: Simpul komputasi batch bersifat sementara dan Batch tidak mereplikasi file tugas antar zona. Anda bertanggung jawab untuk memindahkan input, output, titik pemeriksaan, dan data diagnostik yang harus bertahan dari kehilangan node ke penyimpanan yang tahan lama. Konfigurasikan redundansi akun penyimpanan untuk memenuhi persyaratan ketersediaan Anda.
Perilaku selama kegagalan zona
Bagian ini menjelaskan apa yang diharapkan ketika kumpulan Batch menggunakan penempatan zona ketersediaan dan satu zona ketersediaan tidak tersedia.
Deteksi dan respons: Microsoft memantau layanan Batch dan kesehatan simpul komputasi. Selama kegagalan zona, Batch mendeteksi kehilangan heartbeat berkelanjutan dari node yang terpengaruh dan memulai proses pemulihan node normal. Simpul di zona sehat tetap tersedia, dan Batch dapat terus menjadwalkan tugas pada mereka.
Batch mencoba memulihkan kumpulan ke jumlah simpul target yang dikonfigurasi melalui proses pemulihan normalnya, tetapi tidak meningkatkan target tersebut. Anda bertanggung jawab untuk meminta kapasitas tambahan jika target tidak menyediakan kapasitas yang cukup untuk beban kerja.
- Pemberitahuan: Microsoft tidak secara otomatis memberi tahu Anda saat zona tidak berfungsi. Namun, Anda dapat menggunakan Azure Service Health untuk memahami kesehatan keseluruhan layanan, termasuk kegagalan zona apa pun, dan Anda dapat menyiapkan pemberitahuan Service Health untuk memberi tahu Anda tentang masalah.
Tugas aktif: Tugas yang berjalan pada simpul yang terpengaruh terganggu. Batch mungkin menjadwalkan ulang tugas pada simpul yang tersedia sebagai bagian dari perilaku pemulihan internalnya. Mendesain tugas untuk mentolerir percobaan ulang dan eksekusi ulang, seperti yang dijelaskan dalam Ketahanan terhadap kesalahan sementara dan Ketahanan terhadap kegagalan simpul komputasi.
Kehilangan data yang diharapkan: File pada simpul komputasi yang terpengaruh tidak tersedia selama pemadaman dan hilang jika simpul di-image ulang atau dihapus dari kumpulan. Proses batch tidak mereplikasi file-file ini di seluruh zona. Data yang disimpan ke penyimpanan tahan lama tetap tersedia sesuai dengan konfigurasi redundansi sumber daya penyimpanan tersebut.
Waktu henti yang diharapkan: Tugas pada node yang sehat berlanjut. Tugas yang terganggu mengalami waktu henti hingga Batch dapat menjadwalkannya ulang ke simpul yang dapat digunakan. Jika tidak ada simpul yang dapat digunakan yang tersedia, tugas mungkin tetap dalam keadaan
runninghingga Batch dapat menjadwalkan ulang. Waktu pemulihan tergantung pada kapasitas kumpulan yang tersedia dan beban kerja yang diantrekan.Operasi manajemen terhadap akun Batch dan sumber daya Batch lainnya tetap berlanjut jika akun berada di wilayah tempat control plane tahan zona. Di wilayah lain, operasi manajemen mungkin tidak tersedia sampai zona yang terpengaruh pulih.
Redistribusi: Setelah kehilangan heartbeat berkelanjutan, Batch menandai node yang terpengaruh sebagai
unusabledan mengirimkannya untuk penggantian melalui proses pemulihan simpul normalnya. Batch mencoba memulihkan kumpulan ke jumlah simpul target yang dikonfigurasi, tetapi kapasitas penggantian tergantung pada kuota dan ketersediaan VM di zona sehat.Pekerjaan tetap terkait dengan pool selama proses ini. Batch terus menjadwalkan tugas dari pekerjaan aktif pada simpul yang dapat digunakan di zona sehat. Jika simpul pengganti dialokasikan dan dapat digunakan, Batch juga dapat menjadwalkan tugas pada simpul tersebut.
Proses pemulihan ini tidak meningkatkan jumlah simpul target yang dikonfigurasi. Jika beban kerja Anda memerlukan kapasitas di luar target tersebut, tingkatkan secara manual atau konfigurasikan rumus skala otomatis kumpulan untuk melakukannya.
Pemulihan Zona
Batch mengelola proses pemulihan ketika zona pulih setelah kegagalan. Batch mengikuti proses yang sama yang ditentukan dalam Ketahanan terhadap kegagalan simpul komputasi.
Batch tidak menjamin bahwa simpul diseimbangkan kembali secara merata di seluruh zona ketersediaan setelah pemulihan. Penempatan zona tetap dilakukan sebatas upaya terbaik.
Uji kegagalan zona
Anda tidak dapat mensimulasikan pemadaman zona ketersediaan Azure aktual untuk pengujian. Sebagai gantinya, gunakan pool nonproduksi untuk menginterupsi tugas-tugas representatif dan mengambil simpul komputasi yang cukup dari layanan untuk memperkirakan kehilangan kapasitas yang diharapkan. Pertimbangkan untuk menggunakan operasi simpul yang didukung berikut ini:
- Mulai ulang simpul yang dipilih.
- Nonaktifkan penjadwalan tugas pada simpul yang dipilih.
- Hapus simpul yang dipilih dari kumpulan.
Saat operasi memungkinkan Anda memilih cara menangani tugas yang sedang berjalan, pilih opsi Requeue sehingga Batch dapat menjadwalkan tugas yang terganggu pada simpul yang tersisa.
Selama pengujian, verifikasi bahwa Batch menjadwalkan ulang tugas yang terinterupsi dan bahwa eksekusi ulang tidak menghasilkan output duplikat atau tidak konsisten. Konfirmasikan bahwa titik pemeriksaan dan output tetap tersedia dari penyimpanan tahan lama, pemantauan mendeteksi kehilangan node dan kapasitas yang berkurang, dan beban kerja dapat selesai dengan kapasitas yang tersisa.
Operasi ini memvalidasi gangguan tugas dan penjadwalan ulang, idempotensi, titik pemeriksaan, dan penanganan output yang tahan lama. Namun, mereka tidak mereproduksi setiap efek kegagalan skala zona.
Ketahanan terhadap kegagalan di seluruh wilayah
Akun Batch dan pool-poolnya dibatasi pada satu wilayah Azure. Jika wilayah mengalami kegagalan, job Batch dan pool Batch Anda mungkin terpengaruh.
Batch tidak mereplikasi akun, konfigurasi kumpulan, pekerjaan, tugas, paket aplikasi, atau data tugas ke wilayah lain, dan tidak menyediakan failover lintas wilayah bawaan. Anda bertanggung jawab untuk menyebarkan dan mengoperasikan solusi Batch multiregion ketika beban kerja Anda harus mentolerir kegagalan di seluruh wilayah.
Solusi multiregion kustom untuk ketahanan
Untuk membangun solusi multiregion, sebarkan setidaknya satu akun Batch di setiap wilayah yang digunakan oleh desain pemulihan Anda. Akun batch beroperasi secara independen di seluruh wilayah. Anda bertanggung jawab untuk memilih wilayah, menyebarkan dan mengoperasikan sumber daya di setiap wilayah, dan mengoordinasikan konfigurasi, replikasi, failover, dan failback.
Anda dapat merancang pendekatan aktif-aktif yang menjalankan beban kerja di beberapa wilayah selama operasi normal, atau pendekatan aktif-pasif yang membuat penyebaran sekunder siap untuk failover. Desain aktif-aktif dapat mengurangi waktu pemulihan karena kedua deployment memproses beban kerja selama operasi normal, sementara desain aktif-pasif dapat mengurangi biaya komputasi status stabil.
Daftar berikut ini menyediakan contoh tanggung jawab Anda saat Anda merancang solusi:
Penyebaran: Buat terlebih dahulu akun Batch, kumpulan, atau definisi penyebaran kumpulan, akun penyimpanan, sumber daya jaringan, dan dependensi lainnya di setiap wilayah. Verifikasi bahwa setiap wilayah yang dipilih mendukung fitur Batch, ukuran VM, dan layanan dependen yang diperlukan beban kerja Anda. Pertahankan setiap akun Batch dan sumber daya penyimpanan yang digunakan oleh tugasnya di wilayah yang sama jika memungkinkan untuk menghindari latensi yang tidak perlu. Tentukan akun Batch, pool, dan sumber daya pendukung dengan menggunakan infrastruktur sebagai kode sehingga konfigurasi dapat direproduksi secara konsisten di seluruh wilayah.
Kuota dan kapasitas: Verifikasi kuota akun Batch, langganan, dan keluarga VM yang berlaku di setiap wilayah pemulihan, dan ajukan permintaan peningkatan sebelum terjadi pemadaman jika diperlukan. Kuota adalah batas, bukan jaminan kapasitas. Ketersediaan VM bervariasi menurut wilayah, keluarga VM, dan waktu. Untuk informasi selengkapnya, lihat Akun batch dan kuota inti.
Replikasi data: Pastikan paket aplikasi, image kontainer, data input, dan data referensi tersedia di setiap wilayah pemulihan. Batch tidak mereplikasi item ini untuk Anda.
Replikasi penyimpanan: Konfigurasikan redundansi penyimpanan dan replikasi data lintas wilayah berdasarkan tujuan titik pemulihan Anda. Verifikasi bahwa data yang direplikasi dapat diakses dari setiap wilayah pemulihan. Untuk opsi keandalan penyimpanan, lihat Keandalan dalam Azure Blob Storage.
Penargetan wilayah: Jika aplikasi Anda bekerja dengan akun Batch Anda, rancang sehingga mereka dapat memilih akun Batch lain dan sumber daya penyimpanan terkait tanpa memerlukan penyebaran kode.
Failover: Batch tidak secara otomatis memindahkan beban kerja Anda ke wilayah lain. Anda bertanggung jawab untuk mendeteksi pemadaman, menentukan bagaimana pemadaman memengaruhi beban kerja Anda, menghentikan pengiriman ke akun Batch yang terpengaruh, mengarahkan pekerjaan baru ke akun Batch di wilayah yang sehat, dan memutuskan apakah akan mengirim ulang pekerjaan yang terganggu. Output kerja atau tugas yang belum Anda replikasi di luar wilayah yang terpengaruh mungkin tidak tersedia atau hilang. Waktu pemulihan Anda tergantung pada model penyebaran Anda, kapasitas yang tersedia, replikasi data, dan otomatisasi.
Pemulihan wilayah: Setelah ketersediaan layanan dipulihkan di wilayah yang terpengaruh, validasi akun Batch, kumpulan, dependensi penyimpanan, dan status pekerjaan sebelum mengarahkan pekerjaan ke wilayah tersebut. Selaraskan tugas duplikat atau yang selesai sebagian sebelum pengiriman ulang. Batch tidak mengoordinasikan proses ini atau menyelaraskan status antara akun regional.
Pengujian: Uji secara teratur proses pemulihan regional lengkap di lingkungan nonproduksi. Simulasikan satu penyebaran regional menjadi tidak tersedia, arahkan pengiriman ke akun Batch regional lain, memvalidasi akses ke paket aplikasi dan data input, menjalankan pekerjaan perwakilan, mengumpulkan output, dan berlatih mengembalikan penyebaran yang dipulihkan ke layanan. Ukur hasilnya terhadap sasaran waktu pemulihan (RTO) dan sasaran titik pemulihan (RPO) Anda.
Pencadangan dan pemulihan
Azure Batch bukan penyimpanan tahan lama untuk data input dan output beban kerja. Microsoft mengelola layanan Batch, tetapi Anda bertanggung jawab untuk menyimpan konfigurasi dan data yang diperlukan untuk membuat ulang beban kerja Anda:
Konfigurasi batch: Tentukan akun Batch, pool, pekerjaan, dan sumber daya pendukung dengan menggunakan infrastruktur sebagai kode, seperti Bicep, dan definisi pekerjaan yang dikontrol versi. Artefak ini menyediakan cara yang dapat diulang untuk membuat ulang konfigurasi di wilayah yang sama atau wilayah lain. Uji secara teratur bahwa definisi dapat menerapkan pool dan menjalankan job representatif.
Metadata batch: Batch mempertahankan catatan pekerjaan dan tugas hingga Anda menghapus pekerjaan atau tugas terkait, tetapi rekaman ini bukan cadangan. Jika Anda perlu mempertahankan riwayat ini, pertahankan catatan yang diperlukan di luar Batch.
Data pada simpul komputasi: Simpul komputasi bersifat sementara, dan sistem filenya bukan cadangan atau penyimpanan persisten. Data pada node hilang saat node di-image ulang atau meninggalkan pool. Batch juga dapat menghapus file tugas setelah periode retensinya kedaluwarsa. Simpan output dan log diagnostik yang diperlukan ke penyimpanan tahan lama sebelum tugas selesai. Untuk tugas yang berjalan lama, simpan checkpoint selama eksekusi. Untuk informasi selengkapnya, lihat Mempertahankan output pekerjaan dan tugas dan Memantau Azure Batch.
Data di akun autostorage: Akun autostorage terkait dapat menyimpan paket aplikasi dan file sumber daya tugas. Selain mengonfigurasi redundansi yang memenuhi tujuan pemulihan Anda, pertimbangkan apakah Anda perlu melindungi data ini dari penghapusan atau kerusakan yang tidak disengaja. Untuk informasi selengkapnya, lihat Pencadangan dan pemulihan di Azure Blob Storage.
Pengujian restore dan recovery
Untuk memulihkan, sebarkan konfigurasi sumber daya Batch dan pendukung, pulihkan atau sambungkan kembali data input dan artefak aplikasi yang diperlukan, dan kirim ulang pekerjaan yang tidak selesai. Uji rekonstruksi sumber daya dan pemulihan data secara berkala di lingkungan pemulihan yang terisolasi atau nonproduksi. Gunakan definisi yang dikontrol versi dan data yang dicadangkan, jalankan job representatif, verifikasi output yang dihasilkan dan akses ke dependensi, dan ukur waktu pemulihan dan titik pemulihan yang dicapai terhadap tujuan Anda. Verifikasi bahwa tugas bersifat idempoten sehingga mengirim ulang pekerjaan yang tidak pasti tidak merusak data atau membuat output duplikat.
Ketahanan terhadap pemeliharaan layanan
Microsoft melakukan pemeliharaan platform dan mengoordinasikan pembaruan infrastruktur untuk Azure Batch dan layanan lainnya. Anda bertanggung jawab untuk mengonfigurasi perilaku pembaruan kumpulan dan merancang tugas untuk mentolerir gangguan.
Pemeliharaan host: Azure menggunakan teknik pemeliharaan seperti migrasi langsung jika memungkinkan. Jika pemeliharaan memerlukan simpul komputasi untuk dimulai ulang atau dipindahkan, tugas yang berjalan dapat terganggu dan Batch mungkin menjadwalkan ulang tugas tersebut. Buat tugas idempoten, dan simpan checkpoint dan output ke penyimpanan tahan lama.
Sistem operasi tamu: Anda bertanggung jawab untuk menjaga sistem operasi tamu dan agen simpul Batch tetap terkini. Perilaku pembaruan sistem operasi tergantung pada konfigurasi image dan pembaruan. Dengan konfigurasi yang sesuai, pemutakhiran image OS otomatis untuk kumpulan Batch dapat memperbarui simpul kumpulan tanpa mengganggu tugas yang sedang berjalan. Upgrade image OS otomatis tidak mendukung setiap image sistem operasi Batch.
Pembaruan agen node: Peningkatan image OS otomatis tidak secara otomatis memperbarui agen node Batch. Agen simpul batch tidak ditingkatkan secara otomatis saat kumpulan memiliki simpul komputasi. Untuk menerima node agent yang lebih baru, ubah ukuran pool menjadi nol node lalu skalakan lagi, atau ganti pool. Sebelum menghapus node, pertahankan output tugas dan log diagnostik yang diperlukan. Untuk informasi selengkapnya, lihat Pembaruan agen simpul Batch.
Ikuti rekomendasi penyebaran produksi dan panduan kegagalan simpul komputasi untuk membantu beban kerja Anda melanjutkan atau memulihkan saat pemeliharaan mengganggu tugas atau membuat simpul komputasi tidak tersedia.
Perjanjian tingkat layanan
Perjanjian tingkat layanan (SLA) untuk layanan Azure menjelaskan ketersediaan yang diharapkan dari setiap layanan dan kondisi yang harus dipenuhi solusi Anda untuk mencapai harapan ketersediaan tersebut. Untuk informasi selengkapnya, lihat SLA untuk layanan online.
SLA ketersediaan Azure Batch berlaku untuk operasi yang Anda lakukan terhadap API Batch. Untuk informasi terperinci tentang jenis operasi yang disertakan, tinjau redaksi SLA. Ukuran kumpulan, distribusi zona, dan layanan dependen Anda memengaruhi ketersediaan beban kerja end-to-end tetapi tidak mengubah ketentuan Batch SLA.