Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Diterapkan pada:✅ Gudang di Microsoft Fabric
Penting
Fitur ini sedang dalam tahap pratinjau.
Pengklusteran data adalah teknik yang digunakan untuk mengatur dan menyimpan data berdasarkan kesamaan. Pengklusteran data meningkatkan performa kueri dan mengurangi biaya akses komputasi dan penyimpanan untuk kueri dengan mengelompokkan rekaman serupa bersama-sama.
Cara kerjanya
Pengklusteran data berfungsi dengan menyimpan baris dengan nilai yang mirip di lokasi yang berdekatan pada penyimpanan selama pengambilan data. Pengklusteran data menggunakan kurva pengisian ruang untuk menata data dengan cara yang mempertahankan lokalitas di beberapa dimensi, yang berarti baris dengan nilai serupa di seluruh kolom pengklusteran disimpan secara fisik berdekatan. Pendekatan ini secara dramatis meningkatkan performa kueri dengan melakukan lompati file dan mengurangi jumlah file yang dipindai.
Tidak seperti pengurutan leksikografis konvensional, pengklusteran data menggunakan algoritma canggih untuk mencerna, menjaga baris dengan nilai kolom serupa berdekatan, bahkan ketika tabel diklusterkan oleh beberapa kolom. Ini membuat pengklusteran data ideal untuk kueri rentang, filter kardinalitas tinggi, dan tabel besar dengan distribusi condong, menghasilkan pembacaan yang lebih cepat, mengurangi I/O, dan penggunaan sumber daya yang lebih efisien.
Berikut adalah ilustrasi konseptual yang disederhanakan dari pengklusteran data:

Dalam diagram ini, tabel berlabel Source data memperlihatkan baris yang dicampur dan disorot dalam warna yang berbeda untuk mencerminkan pengelompokan pada tujuan. Tabel yang Diurutkan dibagi menjadi tiga segmen file, mengelompokkan baris dengan warna serupa, yang menunjukkan bagaimana pengelompokan menata data ke dalam segmen penyimpanan yang dioptimalkan berdasarkan nilai kolom.
Metadata pengklusteran data disematkan dalam manifes selama penyerapan, memungkinkan mesin gudang untuk membuat keputusan cerdas tentang file mana yang akan diakses selama kueri pengguna. Metadata ini, dikombinasikan dengan bagaimana baris dengan nilai serupa disimpan bersama-sama memastikan bahwa kueri dengan predikat filter dapat melewati seluruh file dan grup baris yang berada di luar cakupan predikat. Misalnya: jika kueri hanya menargetkan 10% data tabel, pengklusteran memastikan bahwa hanya file yang berisi data dalam rentang filter yang dipindai, mengurangi I/O dan konsumsi komputasi. Tabel yang lebih besar mendapatkan lebih banyak manfaat dari pengklusteran data, karena manfaat dari file skipping meningkat seiring dengan volume data.
Kapan menggunakan pengklusteran data
Saat memutuskan apakah pengklusteran data bisa bermanfaat, selidiki pola kueri dan karakteristik tabel di gudang. Pengklusteran data paling efektif ketika kueri berulang kali memfilter kolom tertentu dan ketika tabel yang mendasarinya besar dan berisi data kardinalitas menengah hingga tinggi. Beberapa skenario umum meliputi:
- Kueri berulang dengan
WHEREfilter: Jika beban kerja menyertakan kueri yang sering memfilter kolom tertentu, pengklusteran data memastikan bahwa hanya file yang relevan yang dipindai selama kueri baca. Ini juga berlaku ketika filter digunakan berulang kali di dasbor, laporan, atau pekerjaan terjadwal dan didorong ke mesin penyimpanan data sebagai perintah SQL. - Tabel yang lebih besar: pengklusteran data paling efektif saat diterapkan ke tabel besar di mana pemindaian himpunan data lengkap mahal. Dengan mengatur baris dengan pengklusteran data, mesin gudang dapat melewati seluruh file dan grup baris yang tidak cocok dengan filter kueri, yang dapat mengurangi I/O dan penggunaan komputasi.
- Kolom kardinalitas menengah hingga tinggi: kolom dengan kardinalitas yang lebih tinggi (misalnya: kolom yang memiliki banyak nilai berbeda, seperti ID, atau tanggal) mendapat manfaat lebih dari pengklusteran data karena memungkinkan mesin untuk mengisolasi dan menkolokasi nilai yang sama. Ini memungkinkan lompati file yang efisien, terutama untuk kueri selektif. Kolom dengan kardinalitas rendah (misalnya: jenis kelamin, wilayah) secara alami memiliki nilai yang tersebar di lebih banyak file, oleh karena itu menawarkan peluang terbatas untuk melewatkan file.
- Kueri selektif dengan cakupan sempit: ketika kueri biasanya menargetkan subset kecil data dan dikombinasikan dengan filter WHERE, pengklusteran data memastikan bahwa hanya file yang berisi baris yang relevan yang dibaca.
Pengklusteran data terjadi secara otomatis selama penyerapan data, terlepas dari bagaimana baris diserap. Tidak ada operasi pengguna yang diperlukan setelah data diserap untuk menerapkan pengklusteran data.
CLUSTER BY Sintaks
Pengklusteran data didefinisikan selama pembuatan tabel, menggunakan CLUSTER BY klausa. Sintaksnya adalah sebagai berikut:
Sintaks CREATE TABLE (Transact-SQL) :
CREATE TABLE { warehouse_name.schema_name.table_name | schema_name.table_name | table_name } (
 [ ,... n ] –- Column list
) WITH (CLUSTER BY [ ,... n ]);
Sintaks CREATE TABLE AS SELECT (Transact-SQL) :
CREATE TABLE { warehouse_name.schema_name.table_name | schema_name.table_name | table_name }
( { <column_definition> } [ ,... n ] )
WITH (CLUSTER BY [ ,... n ])
AS <select_statement>;
Klausa CLUSTER BY mengharuskan setidaknya satu kolom ditentukan untuk pengklusteran data, dan maksimum empat kolom.
Membuat tabel yang menggunakan pengklusteran data dengan SELECT INTO tidak didukung.
Dukungan jenis data
Tabel berikut ini meringkas jenis kolom yang dapat digunakan dalam CLUSTER BY klausa:
| Kategori | Jenis data | Pengklusteran data didukung |
|---|---|---|
| Numerik yang tepat | bit | Tidak. |
| Numerik yang tepat | bigint, int, smallint, desimal2, numerik | Yes |
| Perkiraan numerik | float, real | Yes |
| Tanggal dan waktu | tanggal, datetime2, waktu | Yes |
| Rangkaian karakter1 | Char | Yes |
| Rangkaian karakter1 | varchar | Yes |
| Jenis LOB | varchar(max), varbinary(max) | Tidak. |
| String biner | varbinary, uniqueidentifier | Tidak. |
1 Untuk jenis string (char/varchar), hanya 32 karakter pertama yang digunakan saat statistik kolom diproduksi. Akibatnya, kolom dengan nilai yang berisi awalan panjang mungkin memiliki manfaat terbatas dengan pengklusteran data.
2 Untuk jenis desimal dengan presisi lebih besar dari 18, predikat tidak didorong ke penyimpanan selama eksekusi kueri. Jika Anda menggunakan jenis desimal dalam pengklusteran data, utamakan kolom dengan presisi lebih rendah.
Kolom dengan tipe data yang tidak didukung masih bisa ada dalam tabel yang menggunakan pengklusteran data, tetapi tidak dapat digunakan dengan CLUSTER BY.
Praktik terbaik dengan pengklusteran data
Pengklusteran data lebih efektif ketika kolom pengklusteran dipilih berdasarkan pola kueri aktual, terutama yang memiliki kardinalitas menengah hingga tinggi dan kapan predikat rentang digunakan selama kueri.
Pertimbangkan praktik terbaik berikut saat menggunakan pengklusteran data:
- Pengklusteran data lebih efektif pada tabel besar.
- Usahakan untuk melakukan penyerapan data dan pembaruan secara batch agar dapat memproses jumlah baris yang lebih besar sekaligus, daripada menggunakan tugas yang lebih kecil. Untuk performa optimal, operasi DML harus memiliki setidaknya 1 juta baris untuk mendapatkan manfaat dari pengklusteran data. Setelah penyisipan, pembaruan, dan penghapusan berturut-turut, pemadatan data dapat mengonsolidasikan baris dari file yang lebih kecil menjadi yang berukuran optimal.
- Pilih kolom dengan kardinalitas menengah hingga tinggi untuk pengklusteran data, karena menghasilkan hasil yang lebih baik karena distribusi nilainya yang berbeda. Kolom dengan kardinalitas rendah mungkin menawarkan peluang terbatas untuk penghapusan file yang tidak diperlukan.
- Pilih kolom berdasarkan penggunaan predikat
WHEREyang sering digunakan dalam dasbor, laporan, tugas terjadwal, atau kueri pengguna. Kondisi gabungan kesetaraan tidak mendapat manfaat dari pengklusteran data. Untuk gambaran umum tentang cara menggunakan Wawasan Kueri untuk membantu memilih kolom untuk pengklusteran data berdasarkan beban kerja Anda saat ini, lihat Tutorial: Menggunakan Pengklusteran Data di Gudang Data Fabric. - Jangan gunakan pengklusteran data dengan lebih banyak kolom daripada yang benar-benar diperlukan. Pengklusteran multi-kolom menambah kompleksitas penyimpanan, menambah overhead, dan mungkin tidak memberikan manfaat kecuali semua kolom digunakan bersama dalam kueri yang memiliki predikat.
- Urutan kolom yang digunakan
CLUSTER BYtidak penting dan tidak mengubah cara baris disimpan. - Saat membuat tabel dengan pengklusteran data menggunakan
CREATE TABLE AS SELECT(CTAS) atau menyerap data denganINSERT INTO ... SELECT, pertahankan bagian tertentu dari pernyataan ini sesingkat mungkin untuk kualitas pengklusteran data yang optimal.
Pengklusteran data dapat secara signifikan mengurangi biaya selama kueri, jika selaras dengan predikat kueri. Namun, penyerapan data menimbulkan lebih banyak unit waktu dan kapasitas (CU) pada tabel yang menggunakan pengklusteran data jika dibandingkan dengan tabel yang setara dengan data yang sama tanpa pengklusteran data. Ini terjadi karena mesin gudang data perlu menyortir data selama ingestinya. Karena data yang diserap dibaca beberapa kali, pengklusteran data dapat mengurangi konsumsi komputasi keseluruhan beban kerja tertentu.
Tampilan sistem
Metadata pengklusteran data dapat dikueri menggunakan sys.index_columns. Ini menunjukkan semua kolom yang digunakan dalam pengklusteran data, termasuk kolom ordinal yang digunakan dalam CLUSTER BY klausa.
Kueri berikut mencantumkan semua kolom yang digunakan dalam pengklusteran data pada gudang saat ini, dan tabelnya:
SELECT
    t.name AS table_name,
    c.name AS column_name,
    ic.data_clustering_ordinal AS clustering_ordinal
FROM sys.tables t
JOIN sys.columns c
    ON t.object_id = c.object_id
JOIN sys.index_columns ic
    ON c.object_id = ic.object_id
   AND c.column_id = ic.column_id
WHERE ic.data_clustering_ordinal > 0
ORDER BY
    t.name,
    ic.data_clustering_ordinal;
Nota
Ordinal kolom ditampilkan hanya untuk referensi sebagai urutan yang digunakan dalam CLUSTER BY ketika tabel ditentukan. Seperti yang dibahas dalam Praktik terbaik, urutan kolom tidak memengaruhi performa.
Batasan dan Keterangan
- Performa penyerapan data mungkin turun ketika tabel berisi kolom varchar besar dengan ukuran data yang sangat bervariasi.
- Misalnya, pertimbangkan tabel dengan kolom varchar(200): jika beberapa baris hanya berisi beberapa karakter sementara yang lain mendekati panjang maksimum, varians signifikan dalam ukuran data dapat berdampak negatif pada kecepatan penyerapan.
- Masalah ini diketahui dan akan ditangani dalam rilis mendatang.
-
IDENTITYkolom tidak dapat digunakan denganCLUSTER BY. Tabel yang berisiIDENTITYkolom masih dapat digunakan untuk pengklusteran data, mengingat bahwa kolom tersebut menggunakan kolom yang berbeda denganCLUSTER BY. - Pengklusteran data harus ditentukan pada pembuatan tabel. Mengonversi tabel reguler menjadi tabel
CLUSTER BYtidak didukung. Demikian pula, memodifikasi kolom pengklusteran setelah tabel dibuat tidak diizinkan. Jika kolom pengklusteran yang berbeda diperlukan, gunakanCREATE TABLE AS SELECTsecara opsional (CTAS) untuk membuat tabel baru dengan kolom pengklusteran yang diinginkan. - Dalam beberapa kasus, pengklusteran data mungkin diterapkan secara asinkron. Dalam kasus seperti itu, data diatur ulang dengan tugas latar belakang, dan tabel mungkin tidak sepenuhnya dioptimalkan ketika penyerapan selesai. Ini dapat terjadi dalam kondisi berikut:
- Saat menggunakan
INSERT INTO ... SELECTatauCREATE TABLE AS SELECT (CTAS)dan pengurutan tabel sumber dan target berbeda. - Saat menyerap dari data eksternal yang berformat CSV terkompresi.
- Ketika pernyataan penyerapan memiliki kurang dari 1 juta baris.
- Saat menggunakan
- Penyerapan data pada tabel pengklusteran data menimbulkan overhead jika dibandingkan dengan tabel dengan skema yang sama yang tidak menggunakan pengklusteran data. Ini terjadi karena komputasi tambahan yang diperlukan untuk mengoptimalkan penyimpanan. Ketika kolom pengklusteran memiliki pengurutan yang tidak peka terhadap huruf besar/kecil, lebih banyak overhead juga diharapkan.
- Pengklusteran data dapat menguntungkan waktu respons kueri, konsumsi unit kapasitas (CU), atau keduanya.
Examples
A. Membuat tabel berkluster untuk data penjualan
Contoh ini membuat tabel sederhana Sales dan menggunakan CustomerID kolom dan SaleDate untuk pengklusteran data.
CREATE TABLE Sales (
    SaleID INT,
    CustomerID INT,
    SaleDate DATE,
    Amount DECIMAL(10,2)
) WITH (CLUSTER BY (CustomerID, SaleDate))
B. Membuat tabel berkluster menggunakan CREATE TABLE AS SELECT
Contoh ini menggunakan CREATE TABLE AS SELECT untuk membuat salinan dari tabel Sales yang sudah ada, dengan CLUSTER BY kolom SaleDate.
CREATE TABLE Sales_CTAS
WITH (CLUSTER BY (SaleDate))
AS SELECT * FROM Sales
C. Menampilkan kolom yang digunakan untuk Pengklusteran Data pada tabel tertentu
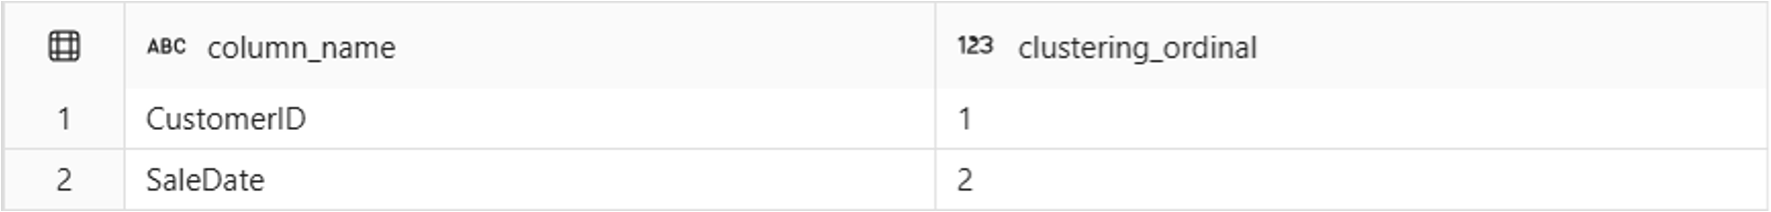
Contoh ini mencantumkan kolom yang digunakan untuk pengklusteran data dalam Sales tabel.
SELECT
    c.name AS column_name,
    ic.data_clustering_ordinal AS clustering_ordinal
FROM sys.tables t
JOIN sys.columns c
    ON t.object_id = c.object_id
JOIN sys.index_columns ic
    ON c.object_id = ic.object_id
   AND c.column_id = ic.column_id
WHERE
    ic.data_clustering_ordinal > 0
   AND t.name = 'Sales'
ORDER BY
    t.name,
    ic.data_clustering_ordinal;
Hasil:
D. Periksa efektivitas pilihan kolom untuk pengklusteran data
Wawasan Kueri dapat membantu mengevaluasi efek pengklusteran data pada beban kerja Anda dengan membandingkan waktu CPU dan data yang dipindai antara kueri tertentu dan eksekusi yang setara pada salinan kluster tabel asli. Contoh berikut menggambarkan cara mengambil waktu CPU yang dialokasikan serta volume data yang telah dipindai di seluruh disk, memori, dan penyimpanan jarak jauh untuk sebuah kueri tertentu.
SELECT
    allocated_cpu_time_ms,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb
FROM
    queryinsights.exec_requests_history
WHERE
     distributed_statement_id = '<Query_Statement_ID>'
Di mana <Query_Statement_ID> ADALAH ID pernyataan terdistribusi kueri yang ingin Anda evaluasi.