Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Berlaku untuk:✅ Titik akhir analitik SQL dan Gudang di Microsoft Fabric
Penting
Fitur ini sedang dalam tahap pratinjau.
Pengklusteran data di Fabric Data Warehouse mengatur data untuk performa kueri yang lebih cepat dan mengurangi penggunaan komputasi. Tutorial ini menjelaskan langkah-langkah untuk membuat tabel dengan pengklusteran data, mulai dari membuat tabel berkluster hingga memeriksa efektivitasnya.
Prasyarat
- Akun tenant Microsoft Fabric dengan langganan aktif.
- Pastikan Anda memiliki Ruang Kerja yang diaktifkan oleh Microsoft Fabric: Buat Ruang Kerja.
- Pastikan Anda telah membuat Gudang. Untuk membuat Gudang baru, lihat Membuat Gudang di Microsoft Fabric.
- Pemahaman dasar tentang T-SQL dan mengkueri data.
Impor data Sampel
Tutorial ini menggunakan himpunan data sampel Taksi NY. Untuk mengimpor data Taksi NY ke Gudang Anda. Gunakan tutorial Tutorial Memuat Sampel data ke Gudang Data .
Membuat tabel dengan pengelompokan data
Untuk tutorial ini, kita memerlukan dua salinan tabel NYTaxi: salinan tabel reguler seperti yang diimpor dari tutorial, dan salinan yang menggunakan pengklusteran data. Gunakan perintah berikut untuk membuat tabel baru menggunakan CREATE TABLE AS SELECT (CTAS), berdasarkan tabel NYTaxi asli:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Nota
Contoh mengasumsikan nama tabel yang diberikan ke himpunan data Taksi NY dalam tutorial Memuat Data Sampel ke Gudang Data. Jika Anda menggunakan nama yang berbeda untuk tabel Anda, sesuaikan perintah untuk mengganti nyctlc dengan nama tabel Anda.
Perintah ini membuat salinan yang tepat dari tabel NYTaxi asli, tetapi dengan klasterisasi data pada kolom lpepPickupDatetime. Selanjutnya, kita menggunakan kolom ini untuk mengkueri.
Mencari data
Jalankan kueri pada tabel NYTaxi, dan ulangi kueri yang sama persis pada tabel NYTaxi_With_DataClustering untuk perbandingan.
Nota
Untuk analisis ini, bermanfaat untuk melihat performa cache dingin dari kedua pengujian - yaitu, tanpa menggunakan fitur caching dari Fabric Data Warehouse. Oleh karena itu, jalankan setiap kueri tepat sekali sebelum Anda melihat hasilnya di Wawasan Kueri.
Kami menggunakan kueri yang sering diulang di Data Warehouse. Kueri ini menghitung jumlah tarif rata-rata menurut tahun antara tanggal 2008-12-31 dan 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Nota
Opsi label yang digunakan dalam kueri ini berguna saat kita membandingkan detail kueri Regular tabel dengan tabel lain yang menggunakan pengklusteran data dengan menggunakan Query Insights views.
Selanjutnya, kita mengulangi kueri yang sama persis, tetapi pada versi tabel yang menggunakan pengklusteran data:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
Kueri kedua menggunakan label Clustered untuk memungkinkan kami mengidentifikasi kueri ini nanti dengan Wawasan Kueri.
Periksa efektivitas pengklusteran data
Setelah menyiapkan pengklusteran, Anda dapat menilai efektivitasnya menggunakan Wawasan Kueri. Wawasan Kueri di Gudang Data Fabric menangkap data eksekusi kueri historis dan menggabungkannya ke dalam wawasan yang dapat ditindak lanjuti, seperti mengidentifikasi kueri yang berjalan lama atau sering dijalankan.
Dalam hal ini, kami menggunakan Wawasan Kueri untuk membandingkan perbedaan data yang dipindai antara kasus reguler dan berkluster.
Gunakan kueri berikut:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Kueri ini mendapatkan detail dari tampilan exec_requests_history. Untuk informasi selengkapnya, lihat queryinsights.exec_requests_history (Transact-SQL).
Kueri memfilter hasil dengan cara berikut:
- Mengambil hanya baris yang berisi
NYTaxiteks dalam nama perintah (seperti yang digunakan dalam kueri pengujian) - Mengambil hanya baris di mana nilai label reguler atau berkluster
Nota
Mungkin perlu waktu beberapa menit agar detail kueri Anda tersedia di Wawasan Kueri. Jika kueri Query Insights Anda tidak mengembalikan hasil, coba lagi setelah beberapa menit.
Menjalankan kueri ini, kami mengamati hasil berikut:

Kedua kueri memiliki jumlah baris 6 dan waktu pengiriman serupa. Kueri Clustered menunjukkan total_elapsed_time_ms dari 1794, allocated_cpu_time_ms dari 1676, dan data_scanned_remote_storage_mb dari 77.519. Kueri Regular menunjukkan total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600, dan data_scanned_remote_storage_mb 177,700. Angka-angka ini menunjukkan bahwa meskipun kedua kueri mengembalikan hasil yang sama, versi yang Clustered digunakan sekitar 36% lebih sedikit waktu CPU daripada Regular versi dan memindai sekitar 56% lebih sedikit data pada disk. Tidak ada cache yang digunakan dalam eksekusi kueri. Ini adalah hasil yang signifikan untuk membantu mengurangi waktu eksekusi kueri dan penggunaan konsumsi, dan menjadikan lpepPickupDatetime kolom kandidat yang kuat untuk pengklusteran data.
Nota
Ini adalah tabel kecil, dengan sekitar 76 juta baris dan volume data 2GB. Meskipun kueri ini hanya mengembalikan enam baris pada agregasinya (satu untuk setiap tahun dalam rentang), kueri ini memindai sekitar 8,3 juta baris dalam rentang tanggal yang disediakan sebelum hasil dikumpulkan. Data produksi aktual dengan volume data yang lebih besar dapat memberikan hasil yang lebih signifikan. Hasil Anda mungkin bervariasi berdasarkan ukuran kapasitas, hasil cache, atau konkurensi selama kueri.
Pilih kolom klaster dari beban kerja Anda
Untuk tabel produksi, gunakan pola query yang diamati daripada menebak kolom mana yang akan dikelompokkan. Kapabilitas operasional dari sqldw-cli keterampilan ini menganalisis riwayat Query Insights, memberi peringkat pola kueri berulang berdasarkan jumlah data jarak jauh yang dipindai, dan mengidentifikasi kolom yang digunakan dalam predikat WHERE.
Sebelum memulai, instal Skills for Fabric, pastikan gudang data memiliki aktivitas kueri terkini, dan pastikan Anda memiliki peran Kontributor di ruang kerja atau yang lebih tinggi. Kemudian, buka GitHub Copilot CLI dan gunakan prompt seperti ini:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
Keterampilan ini mengidentifikasi pola kueri dengan dampak pemindaian terbesar, mengekstrak tabel dan kolom filter dari kueri tersebut, serta memberi peringkat kandidat klaster. Tinjau rekomendasi dengan pedoman berikut:
- Pilih kolom yang berulang kali memfilter tabel besar dan menggunakan nilai kardinalitas menengah hingga tinggi, seperti tanggal atau pengenal.
- Utamakan kolom yang digunakan dalam predikat rentang selektif atau predikat kesetaraan dalam klausa
WHERE. - Jangan memilih kolom hanya karena kolom tersebut muncul dalam kondisi join kesetaraan. Kondisi-kondisi ini tidak diuntungkan dari pengelompokan data.
- Gunakan tidak lebih dari empat kolom clustering, dan jangan tambahkan lebih banyak kolom dari yang dibutuhkan beban kerja.
Misalnya, pertimbangkan gudang e-commerce yang Sales.SalesOrder berisi 1,5 miliar baris dan Sales.OrderLine 6 miliar baris. Setelah menganalisis kueri berulang, keterampilan mungkin mengembalikan rekomendasi berikut:
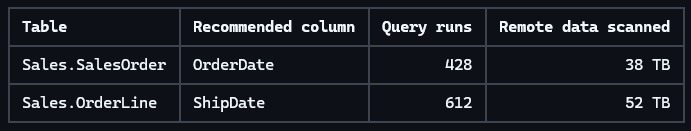
Kolom tanggal merupakan kandidat yang kuat karena digunakan untuk memfilter tabel terbesar, mendukung predikat rentang yang umum, dan memberikan peluang untuk melewati lebih banyak file dibandingkan kolom berkardinalitas rendah seperti OrderStatus atau SalesRegion.
sqldw-cli kapabilitas operasi ini bersifat hanya baca. Ia merekomendasikan kolom tetapi tidak membuat atau menggantikan tabel. Setelah Anda meninjau rekomendasi, gunakan CTAS untuk membuat salinan tabel yang diklasterkan:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Bandingkan beban kerja yang terklaster dan tidak berklaster untuk memverifikasi efeknya. Setelah Anda memvalidasi tabel yang diklasterkan, ganti nama tabel asli lalu ganti nama tabel yang dikelompokkan ke nama asli:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Tabel asli tetap tersedia sebagai Sales.SalesOrder_old untuk rollback. Verifikasi beban kerja yang bergantung dan tabel baru sebelum Anda menghapus tabel asli. Ketika Anda tidak lagi membutuhkan salinan rollback, hapus:
DROP TABLE Sales.SalesOrder_old;