Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
si applica a:✅ Magazzino di dati in Microsoft Fabric
Questo articolo descrive metodi per migrare i data warehouse da SQL Server a Microsoft Fabric Data Warehouse.
Suggerimento
Per maggiori informazioni su strategia e pianificazione, vedi Pianificazione della migrazione: SQL Server a Fabric Data Warehouse.
Usa il Fabric Migration Assistant per Data Warehouse per un'esperienza di migrazione automatica da SQL Server. Il resto di questo articolo descrive ulteriori passaggi manuali di migrazione.
La tabella seguente riassume i metodi per la migrazione dello schema dati (DDL), del codice del database (DML) e dei dati. Ogni opzione è descritta più avanti in questo articolo.
| Opzione | Method | Funzionamento | Abilità o preferenze | Scenario |
|---|---|---|---|---|
| 1 | Data Factory | Conversione dello schema Estrazione dei dati Inserimento dati |
pipeline di Data Factory | Schemi semplificati e migrazione dei dati. Consigliato per le tabelle delle dimensioni. |
| 2 | Data Factory con partizionamento | Conversione dello schema Estrazione dei dati Inserimento dati |
Pipeline di Data Factory | Migrazione parallelizzata per grandi tabelle di fatto. |
| 3 | Migrazione basata sullo schema | Conversione dello schema | Pipeline di Data Factory | Migra prima lo schema, poi estrai e assorbi i dati separatamente per un maggiore controllo sulla produttività. |
| 4 | Script di migrazione SQL | Conversione dello schema Estrazione dei dati Valutazione del codice |
T-SQL | Usa un IDE e script per un controllo granulare sui compiti di migrazione. |
| 5 | progetti di database SQL | Conversione dello schema Valutazione del codice |
Progetto SQL | Usa un progetto di database per il controllo del codice sorgente, la valutazione e la distribuzione. |
| 6 | dbt | Conversione dello schema Conversione del codice del database |
dbt | Riutilizza un progetto DBT esistente cambiando adattatore e configurazione target. |
Scegliere un carico di lavoro per la migrazione iniziale
Quando decidi dove iniziare un progetto di migrazione SQL Server Fabric Data Warehouse, scegli un'area di carico di lavoro dove puoi:
- Dimostra la fattibilità della migrazione verso Fabric Data Warehouse offrendo rapidamente i benefici del nuovo ambiente. Inizia in modo semplice e su piccola scala, e preparati a eseguire più migrazioni di piccola entità.
- Dai al tuo staff tecnico il tempo di acquisire esperienza rilevante con i processi e gli strumenti che utilizzano per migrare altri carichi di lavoro.
- Crea un modello per ulteriori migrazioni specifico per il tuo ambiente, strumenti e processi SQL Server.
Suggerimento
Crea un inventario degli oggetti che devono essere migrati e documenta il processo di migrazione dall'inizio alla fine in modo che possa essere ripetuto per altri database o carichi di lavoro.
Il volume di dati in una migrazione iniziale dovrebbe essere abbastanza grande da dimostrare le capacità e i benefici della Fabric Data Warehouse, ma abbastanza piccolo da dimostrare rapidamente il valore. Una dimensione nell'intervallo da 1 a 10 terabyte è tipica.
Migra con Fabric Data Factory
Fabric Data Factory fornisce un'interfaccia low-code che può convertire DDL di tabelle e migrare dati da SQL Server.
Fabric Data Factory può eseguire le attività seguenti:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea oggetti dello schema in Fabric Data Warehouse.
- Migra i dati su Fabric Data Warehouse.
Opzione 1. Migrazione di schema e dati con Copy Assistant
Questo metodo utilizza l'assistente Data Factory Copy per collegarsi al database SQL Server sorgente, convertire la DDL della tabella in sintassi Fabric e copiare i dati in Fabric Data Warehouse. Puoi selezionare una o più tabelle sorgente. La pipeline generata utilizza un'attività ForEach per copiare in parallelo le tabelle selezionate.
Quando configuri l'operazione di copia:
- Usa il connettore SQL Server per la connessione sorgente.
- Limitare le copie parallele a un livello che il database sorgente e la rete possano sostenere.
- Monitorare la CPU sorgente, l'I/O, l'uso del log delle transazioni e la latenza del carico di lavoro in produzione durante l'estrazione.
Uso consigliato
Usa Copy Assistant per un'interfaccia semplice che converte DDL e assorbe le tabelle selezionate in un'unica operazione. Questo metodo si adatta bene a tabelle di dimensioni e carichi di lavoro più piccoli.
Per tabelle grandi, usa la partizionazione per aumentare il parallelismo di lettura e scrittura.
Opzione 2. Migrazione dei dati con partizionamento
Per tabelle dei fatti di grandi dimensioni, usa un'attività di copia per ogni tabella e configura il partizionamento dell'origine. Utilizzare partizioni fisiche quando disponibili, oppure configurare la partizionazione a intervallo dinamico specificando una colonna numerica o di data appropriata e i suoi valori minimi e massimi.
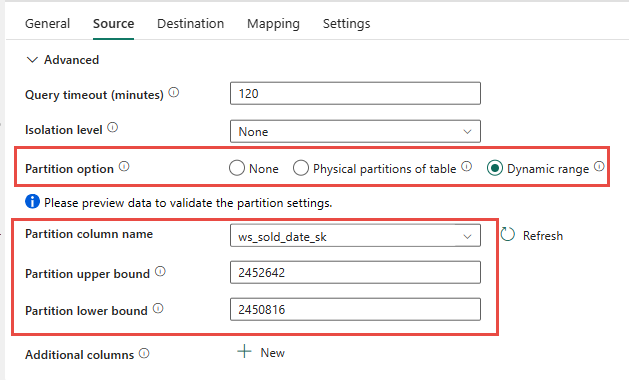
Quando usi la partizionazione:
- Scegli una colonna di partizione che distribuisca le righe in modo uniforme.
- Evita di creare più query sorgente concorrenti di quante ne possa elaborare SQL Server senza influenzare i carichi di lavoro di produzione.
- Testa l'intervallo di partizione e le impostazioni di copia parallela rispetto a un carico di lavoro rappresentativo.
- Aumentare gradualmente il parallelismo monitorando la fonte e la destinazione.
Uso consigliato
Usa la partizionazione Data Factory per grandi tabelle di fatti quando l'estrazione parallela migliora la produttività. Dimensiona il conteggio dei batch e gli intervalli di partizione in base alle risorse del database sorgente e alla capacità della rete.
Opzione 3. Migrazione basata sullo schema
Per database più grandi, separare la migrazione degli schemi da quella dei dati:
- Converti e crea gli schemi delle tabelle in Fabric Data Warehouse.
- Estrai i dati sorgente in Azure Data Lake Storage (ADLS) Gen2.
- Usa Data Factory o il comando COPY INTO per integrare i dati in fase in Fabric Data Warehouse.
Separare queste fasi permette di accordare in modo indipendente l'estrazione e l'ingestione.
Migrazione dello schema con Data Factory
Puoi usare una pipeline Fabric per migrare gli schemi delle tabelle da SQL Server a Fabric Data Warehouse senza dover copiare righe.
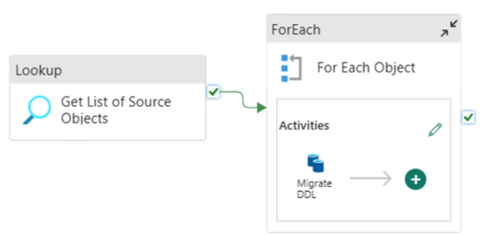
Configurare i parametri della pipeline
Crea un SchemaName parametro che specifichi quali schemi migrare. Usa dbo come impostazione predefinita, oppure inserisci una lista delimitata da virgole come 'dbo','sales'.
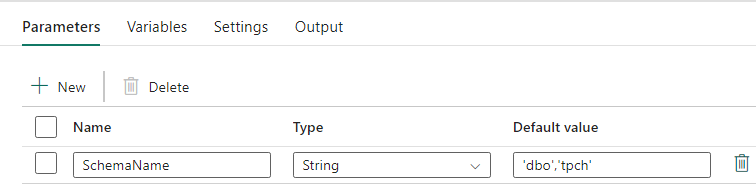
Configura l'attività Ricerca
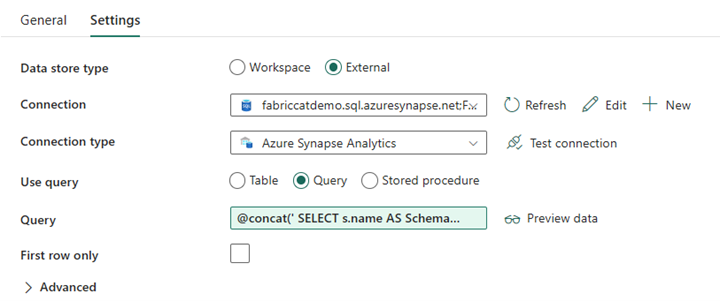
Crea un'attività di ricerca e imposta la sua connessione al database SQL Server sorgente. Nella scheda Impostazioni:
- Impostare Tipo di archivio dati su Esterno.
- Seleziona la connessione SQL Server di origine.
- Imposta Usa query su Query.
- Aggiungi una query dinamica che restituisca lo schema sorgente e i nomi delle tabelle.
Usa la seguente espressione per creare la query:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Configura l'attività ForEach
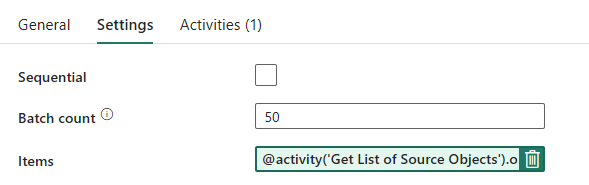
Nella scheda Impostazioni per l'attività ForEach :
- Disabilita Sequenziale per permettere l'esecuzione simultanea delle iterazioni.
- Imposta il conteggio dei lotti a un valore che il database sorgente può sostenere. Inizia con un valore conservativo e testalo.
- Imposta Items su
@activity('Get List of Source Objects').output.value.
Configura l'attività di copia
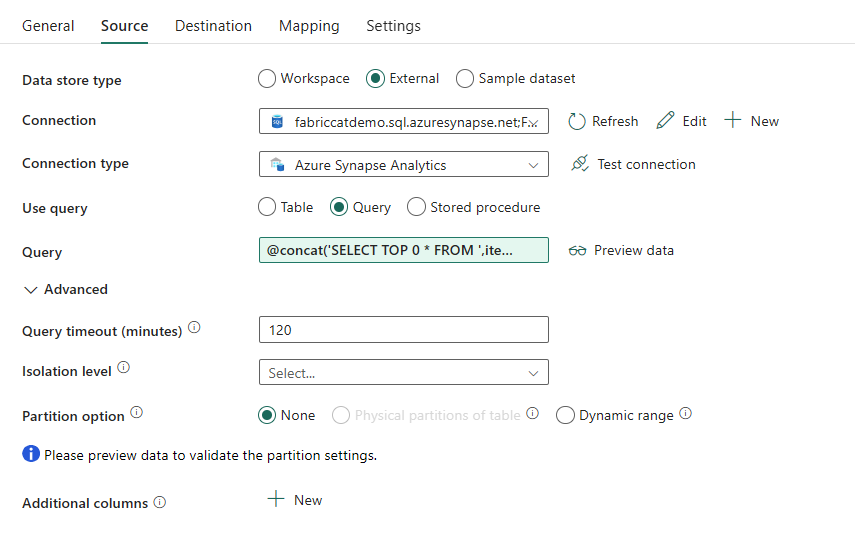
Aggiungi un'attività di copia all'interno dell'attività ForEach. Nella scheda Origine:
- Impostare Tipo di archivio dati su Esterno.
- Seleziona la connessione SQL Server di origine.
- Imposta Usa query su Query.
-
Imposta Query su
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)in modo che vengano migrati solo i metadati della tabella.
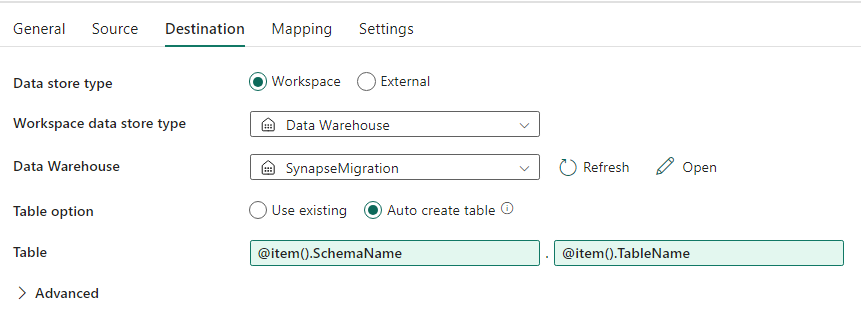
Nella scheda Destinazione:
- Impostare Tipo di archivio dati su Area di lavoro.
- Imposta il tipo di archivio dati Workspace su Data Warehouse e seleziona il warehouse di destinazione.
- Imposta lo schema di destinazione su
@item().SchemaName. - Imposta la tabella destinazione su
@item().TableName.
Dopo aver eseguito la pipeline, verifica che Fabric Data Warehouse contenga ogni tabella selezionata con lo schema atteso.
Migra usando script SQL
Usa script di migrazione T-SQL e PowerShell quando vuoi un controllo granulare sulla conversione dello schema, l'estrazione dei dati e la valutazione del codice.
Gli script di migrazione possono:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea oggetti dello schema in Fabric Data Warehouse.
- Estrai i dati da SQL Server ad ADLS Gen2.
- Segnala la sintassi T-SQL non supportata nelle stored procedure, nelle funzioni e nelle viste.
Il team CAT di Microsoft Fabric fornisce esempi di codice per la migrazione nel repository fabric-migration repository.
Uso consigliato
Usa script quando conosci T-SQL, preferisci un ambiente di sviluppo integrato e devi controllare i singoli compiti di migrazione. Usa COPY INTO o Data Factory per acquisire i dati estratti in Fabric Data Warehouse.
Eseguire la migrazione tramite progetti di database SQL
Fabric Data Warehouse è supportata dall'estensione SQL Database Projects per Visual Studio Code.
Un progetto di database SQL fornisce controllo del fonte, test del database, validazione dello schema e funzionalità di implementazione. Il Centro sicurezza di Azure può:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea oggetti dello schema in Fabric Data Warehouse.
- Valuta la sintassi T-SQL non supportata nelle stored procedure, nelle funzioni e nelle visualizzazioni.
Per la migrazione dei dati, usa Data Factory per copiare direttamente da SQL Server oppure estrai i dati in ADLS Gen2 e importali con COPY INTO o con Data Factory.
Per una guida dettagliata all'uso di progetti di database SQL con script di migrazione, vedi il fabric-migration repository.
Per maggiori informazioni, consulta Inizia con l'estensione SQL Database Projects e Costruisci un progetto database dalla riga di comando.
Migrazione con DBT
Se il tuo SQL Server data warehouse usa dbt, puoi usare l'adattatore dbt per Fabric Data Warehouse convertire schema e codice database cambiando il profilo target e l'adattatore.
Il framework dbt genera script DDL e DML dai file del modello. Devi migrare i dati separatamente utilizzando Data Factory o un'altra opzione di migrazione dati in questo articolo.
Per iniziare, consulta il Tutorial: Configura la DBT per Fabric Data Warehouse.
Ingestione dei dati in Fabric Data Warehouse
Per i dati di staging, usa COPY INTO o Fabric Data Factory per acquisire i file da ADLS Gen2 in un Fabric Data Warehouse. Considera le seguenti indicazioni:
- Estrae grandi tabelle in parallelo quando il database sorgente e la rete hanno sufficiente capacità.
- Preferisci i file Parquet per ridurre l'uso di memoria e rete e migliorare l'efficienza dell'ingestione.
- Carica più tabelle di destinazione contemporaneamente quando la tua capacità Fabric è in grado di supportare il carico di lavoro.
- Monitorare sia l'estrazione della sorgente che la capacità Fabric per trovare il grado ottimale di parallelismo.