Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Si applica a: ✅ Magazzino in Microsoft Fabric
Questo articolo descrive metodi per migrare da pool SQL dedicati Azure Synapse Analytics a Microsoft Fabric Data Warehouse.
Suggerimento
Per maggiori informazioni sulla strategia e la pianificazione della migrazione, vedi Pianificazione della migrazione: Azure Synapse Analytics pool SQL dedicati per Fabric Data Warehouse.
Un'esperienza automatizzata per la migrazione da pool SQL dedicati di Azure Synapse Analytics è disponibile usando Fabric Migration Assistant per Data Warehouse. Il resto di questo articolo contiene altri passaggi di migrazione manuale.
La tabella seguente riassume i metodi per la migrazione dello schema dati (DDL), del codice del database (DML) e dei dati. La colonna Opzione è collegata ai dettagli di ogni scenario.
| Numero di opzione | Opzione | Funzione | Abilità o preferenze | Sceneggiatura |
|---|---|---|---|---|
| 1 | Data Factory | Schema (DDL) conversione Estrazione dei dati Inserimento dati |
ADF/Pipeline | Tutto semplificato in uno schema (DDL) e migrazione dei dati. Consigliato per le tabelle delle dimensioni. |
| 2 | Fabbrica di dati con partizione | Schema (DDL) conversione Estrazione dei dati Inserimento dati |
ADF/Pipeline | Usando le opzioni di partizionamento per aumentare il parallelismo di lettura/scrittura, fornendo dieci volte la velocità effettiva rispetto all'opzione 1, consigliata per tabelle dei fatti. |
| 3 | Data Factory con codice accelerato | Schema (DDL) conversione | ADF/Pipeline | Convertire e migrare prima lo schema (DDL), quindi utilizzare CETAS per l'estrazione e COPY/Data Factory per l'ingestione dei dati per ottenere prestazioni complessive ottimali nell'inserimento. |
| 4 | Stored procedure che accelerano il codice | Schema (DDL) conversione Estrazione dei dati Valutazione del codice |
T-SQL | Utente SQL che usa l'IDE con un controllo più granulare su quali attività vogliono lavorare. Usare COPY/Data Factory per inserire i dati. |
| 5 | Estensione progetto di database SQL per Visual Studio Code | Schema (DDL) conversione Estrazione dei dati Valutazione del codice |
Progetto SQL | Progetto di database SQL per la distribuzione con l'integrazione dell'opzione 4. Usare COPY o Data Factory per inserire i dati. |
| 6 | CREA UNA TABELLA ESTERNA COME SELECT (CETAS) | Estrazione dei dati | T-SQL | Estrarre dati convenienti e ad alte prestazioni in Azure Data Lake Storage (ADLS) Gen2. Usare COPY/Data Factory per inserire i dati. |
| 7 | Eseguire la migrazione con dbt | Schema (DDL) conversione conversione del codice di database (DML) |
dbt | Gli utenti dbt esistenti possono usare l'adattatore dbt Fabric per convertire DDL e DML. È quindi necessario eseguire la migrazione dei dati usando altre opzioni in questa tabella. |
Scegliere un carico di lavoro per la migrazione iniziale
Quando decidi da dove iniziare con il pool SQL dedicato di Synapse per Fabric Data Warehouse progetto di migrazione, scegli un'area di carico di lavoro dove puoi:
- Dimostra la fattibilità della migrazione verso Fabric Data Warehouse offrendo rapidamente i benefici del nuovo ambiente. Inizia in modo semplice e su piccola scala, e preparati a eseguire più migrazioni di piccola entità.
- Concedere tempo al personale tecnico interno per acquisire esperienza pertinente con i processi e gli strumenti che usa per eseguire la migrazione ad altre aree.
- Creare un modello per altre migrazioni specifiche per l'ambiente Synapse di origine, e gli strumenti e i processi di aiuto già presenti.
Suggerimento
Crea un inventario degli oggetti da migrare e documenta il processo di migrazione dall'inizio alla fine così da poterlo ripetere per altri pool o carichi di lavoro SQL dedicati.
Il volume di dati migrati in una migrazione iniziale dovrebbe essere abbastanza grande da dimostrare le capacità e i benefici dell'ambiente Fabric Data Warehouse, ma non troppo grande per dimostrare rapidamente il valore. Una dimensione nell'intervallo da 1 a 10 terabyte è tipica.
Migrazione con Fabric Data Factory
Questa sezione descrive le opzioni Data Factory per gli utenti familiari con Azure Data Factory e Synapse. L'interfaccia drag-and-drop offre un modo semplice per convertire DDL e migrare i dati.
Fabric Data Factory può eseguire le attività seguenti:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea lo schema (DDL) su Fabric Data Warehouse.
- Migra i dati su Fabric Data Warehouse.
Opzione 1. Migrazione di schema e dati - Assistente Copia dati e attività Copy ForEach
Questo metodo utilizza l'assistente dati Data Factory Copy per collegarsi al pool SQL dedicato di sorgente, convertire la sintassi DDL del pool SQL dedicato in Fabric e copiare i dati in Fabric Data Warehouse. È possibile selezionare una o più tabelle di destinazione (per il set di dati TPC-DS sono presenti 22 tabelle). Genera il ciclo ForEach per scorrere l'elenco di tabelle selezionate nell'interfaccia utente e generare 22 thread di attività di copia parallela.
- Vengono generate ed eseguite 22
SELECTquery (una per ogni tabella selezionata) nel pool SQL dedicato. - Assicurati di avere la DWU e la classe risorsa appropriate per permettere l'esecuzione delle query generate. Per questo caso, è necessario un minimo di DWU1000 con
staticrc10per consentire un massimo di 32 query per gestire 22 query inviate. - Copiare i dati direttamente dal pool SQL dedicato a Fabric Data Warehouse con Data Factory richiede uno staging. Il processo di ingestione ha due fasi:
- La prima fase estrae i dati dal pool SQL dedicato in ADLS. Questa fase si chiama fase di preparazione.
- La seconda fase assorbe i dati a stadi nel Fabric Data Warehouse. La maggior parte del tempo di ingestione viene impiegata nella fase di staging, quindi lo staging incide significativamente sulle prestazioni.
Uso consigliato
L'utilizzo dell'assistente Copy per generare un'attività ForEach fornisce un'interfaccia semplice per convertire DDL e ingerire tabelle selezionate dal pool SQL dedicato in Fabric Data Warehouse in un unico passaggio.
Tuttavia, questa opzione non garantisce una capacità ottimale complessiva. Lo staging e la necessità di parallelizzare letture e scritture durante la fase sorgente-stadio sono le principali fonti di latenza. Usa questa opzione solo per le tabelle delle dimensioni.
Opzione 2. Migrazione DDL/Dati - Pipeline utilizzando l'opzione di partizionamento
Per migliorare il throughput durante il caricamento di tabelle dei fatti di grandi dimensioni con una pipeline di Fabric, usa un'attività di copia per ogni tabella dei fatti e abilita il partizionamento. Questa configurazione offre le migliori prestazioni di attività Copy.
Usa le partizioni fisiche della tabella sorgente quando disponibili. Se la tabella non è fisicamente partizionata, specifica una colonna di partizione e valori minimi e massimi per la partizionazione dinamica. Nello screenshot seguente, le opzioni Source della pipeline specificano un intervallo di partizione dinamico basato sulla ws_sold_date_sk colonna.

La partizionazione può aumentare la velocità effettiva dello staging. Considera le seguenti indicazioni quando lo configuri:
- A seconda dell'intervallo di partizioni, l'operazione potrebbe generare più di 128 query e utilizzare tutti gli slot di concorrenza nel pool SQL dedicato.
- Devi scalare fino a un minimo di DWU6000 per permettere l'esecuzione di tutte le query.
- Ad esempio, per la tabella TPC-DS
web_salessono state inviate 163 query al pool SQL dedicato. A DWU6000, 128 query venivano eseguite mentre 35 query erano in coda. - La partizione dinamica seleziona automaticamente la partizione di intervallo. In questo caso, un intervallo di 11 giorni per ogni query SELECT inviata al pool SQL dedicato. Per esempio:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Uso consigliato
Per le tabelle dei fatti, usa Data Factory con l'opzione di partizionamento per aumentare la produttività.
Tuttavia, le letture parallele richiedono di scalare il pool SQL dedicato a una DWU superiore affinché possa eseguire le query di estrazione. La partizionazione migliora il tasso di dieci volte rispetto a non usare la partizionazione. Puoi aumentare la DWU per aumentare la produttività, ma un pool SQL dedicato permette un massimo di 128 query attive.
Per ulteriori informazioni sulla mappatura tra Synapse DWU e Fabric, vedere Blog: Mapping dei pool SQL dedicati di Azure Synapse alle risorse di calcolo di Fabric Data Warehouse.
Opzione 3. Migrazione DDL - Assistente Copia dati ForEach Attività di copia
Le due opzioni precedenti sono adatte a database più piccoli . Se hai bisogno di un throughput più alto, usa questa alternativa:
- Estrai i dati dal pool SQL dedicato in ADLS per ridurre il sovraccarico di staging.
- Usa o Data Factory o il comando COPY per inserire i dati nel tuo warehouse.
Uso consigliato
È possibile continuare a usare Data Factory per convertire lo schema (DDL). Utilizzando l'assistente Copia dati, puoi selezionare la tabella specifica o Tutte le tabelle. Per progettazione, questo metodo migra lo schema in un solo passaggio, estraendo lo schema senza righe usando la condizione falsa, TOP 0 nella istruzione di query.
L'esempio di codice seguente illustra la migrazione dello schema (DDL) con Data Factory.
Esempio di codice: migrazione dello schema (DDL) con Data Factory
Puoi usare Fabric Pipelines per migrare facilmente i tuoi DDL (schemi) per oggetti tabelle da qualsiasi database SQL di Azure o pool SQL dedicato. Questa pipeline migra lo schema (DDL) delle tabelle del pool SQL dedicato di origine in Fabric Data Warehouse.

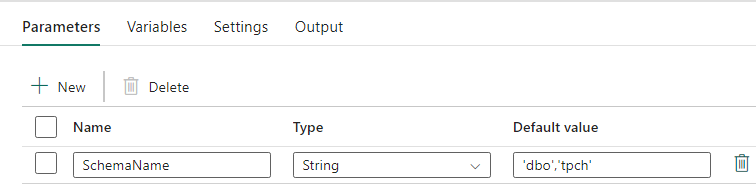
Progettazione della pipeline: parametri
Questa pipeline accetta un parametro SchemaName, che si usa per specificare quali schemi migrare. Lo schema predefinito è dbo.
Nel campo Valore predefinito, immettere un elenco delimitato da virgole dello schema di tabella che indica gli schemi di cui eseguire la migrazione: 'dbo','tpch' per fornire due schemi, dbo e tpch.
Progettazione della pipeline: attività di ricerca
Creare un'attività di ricerca e impostare la Connessione per puntare al database di origine.
Nella scheda Impostazioni:
Impostare Tipo di archivio dati su Esterno.
Connessione è il tuo pool SQL dedicato di Azure Synapse. Il tipo di connessione è Azure Synapse Analytics.
"L'uso della query è impostato su Query."
Costruisci il campo Query usando un'espressione dinamica, così puoi usare il parametro
SchemaNamein una query che restituisce una lista di tabelle sorgente di destinazione. Seleziona Query e poi seleziona Aggiungi contenuto dinamico.Questa espressione all'interno dell'attività LookUp genera un'istruzione SQL per eseguire query sulle viste di sistema per recuperare un elenco di schemi e tabelle. Fa riferimento al
SchemaNameparametro per permettere il filtraggio sugli schemi SQL. L'output di questa espressione è un array di schemi e tabelle SQL che l'attività ForEach utilizza come input.Usare il codice seguente per restituire un elenco di tutte le tabelle utente con il nome dello schema.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

Pipeline design: Ciclo ForEach
Per il ciclo ForEach, configurare le opzioni seguenti nella scheda Impostazioni:
- Disabilita Sequenziale per permettere l'esecuzione simultanea di più iterazioni.
- Imposta Batch count su
50, limitando il numero massimo di iterazioni simultanee. - Usa contenuti dinamici nel campo Items per fare riferimento all'output dell'attività LookUp. Usare il frammento di codice seguente:
@activity('Get List of Source Objects').output.value

Progettazione della pipeline: attività di copia all'interno del ciclo ForEach
All'interno dell'attività ForEach, aggiungi un'attività di copia. Questo metodo utilizza il Dynamic Expression Language all'interno delle pipeline per costruire un'istruzione SELECT TOP 0 * FROM <TABLE> che migra solo lo schema senza dati in un warehouse.
Nella scheda Origine:
- Impostare Tipo di archivio dati su Esterno.
- Connessione è il tuo pool SQL dedicato di Azure Synapse. Il tipo di connessione è Azure Synapse Analytics.
- Impostare Usa query su Query.
- Nel campo Query , incolla la query di contenuto dinamico e usa questa espressione che restituisce zero righe, ma include lo schema della tabella:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

Nella scheda Destinazione:
- Impostare Tipo di archivio dati su Area di lavoro.
- Imposta il tipo di archivio dati Workspace su Data Warehouse e imposta il Data Warehouse come magazzino.
- Lo schema e il nome della tabella di destinazione vengono definiti usando il contenuto dinamico.
- Schema si riferisce al campo dell'iterazione corrente,
SchemaNamecon il frammento:@item().SchemaName - Riferimenti alla tabella
TableNamecon il frammento:@item().TableName
- Schema si riferisce al campo dell'iterazione corrente,

Progettazione della pipeline: Destinazione
Per la Destinazione, punta al tuo Magazzino e fai riferimento allo Schema sorgente e al Nome della tabella.
Quando esegui questa pipeline, vedi il tuo data warehouse popolato con tutte le tabelle presenti nell'origine, utilizzando lo schema corretto.
Migrazione mediante l'uso di stored procedure in un pool SQL dedicato di Synapse
Questa opzione utilizza stored procedure per effettuare la migrazione verso Fabric Data Warehouse.
È possibile ottenere gli esempi di codice in microsoft/fabric-migration in GitHub.com. Questo codice viene condiviso come open source, quindi è possibile contribuire a collaborare e aiutare la community.
Cosa possono fare le stored procedure di Fabric Migration:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea lo schema (DDL) su Fabric Data Warehouse.
- Estrarre dati dal pool SQL dedicato di Synapse ad ADLS.
- Segnala la sintassi di Fabric non supportata nel codice T-SQL (procedure archiviate, funzioni, viste).
Uso consigliato
Questa opzione è perfetta per te se:
- Hanno familiarità con T-SQL.
- Voglio utilizzare un ambiente di sviluppo integrato per lo sviluppo T-SQL.
- Vuoi un controllo più dettagliato sui compiti su cui lavori.
Puoi eseguire la procedura memorizzata specifica per la conversione dello schema (DDL), l'estrazione dati o la valutazione del codice T-SQL.
Per la migrazione dei dati, usa COPY INTO o Fabric Data Factory per inserire i dati nel tuo warehouse.
Eseguire la migrazione tramite progetti di database SQL
Fabric Data Warehouse supporta l'estensione SQL Database Projects disponibile all'interno di Visual Studio Code.
Questa estensione è disponibile in Visual Studio Code. Questa funzionalità abilita le funzionalità per il controllo del codice sorgente, il test del database e la convalida dello schema.
Per ulteriori informazioni sul controllo del codice sorgente, vedere Panoramica dello sviluppo e della distribuzione.
Uso consigliato
Usa questa opzione se preferisci usare SQL Database Project per il tuo deployment. Questa opzione integra le stored procedure di Fabric Migration nel progetto di database SQL per offrire un'esperienza di migrazione fluida.
Un progetto database SQL può:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea lo schema (DDL) su Fabric Data Warehouse.
- Estrarre dati dal pool SQL dedicato di Synapse ad ADLS.
- Segnala la sintassi non supportata per i codici T-SQL (procedure memorizzate, funzioni, viste).
Per la migrazione dei dati, usa COPY INTO o Data Factory per integrare i dati nel tuo warehouse.
Il team Microsoft Fabric CAT fornisce script PowerShell per estrarre, creare e distribuire schema (DDL) e codice database (DML) tramite un progetto database SQL. Per una guida, consulta microsoft/fabric-migration su GitHub.
Per altre informazioni sui progetti di database SQL, vedere Introduzione all'estensione Progetti di database SQL e Compilare un progetto di database dalla riga di comando.
Migrazione dei dati con CETAS
Il comando T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) fornisce il metodo più conveniente e ottimale per estrarre dati dai pool SQL dedicati Azure Synapse verso Azure Data Lake Storage (ADLS) Gen2.
Cosa può fare CETAS:
- Estrarre dati in ADLS.
- Questa opzione richiede di creare lo schema (DDL) nel tuo warehouse prima di ingerire i dati. Considerare le opzioni di questo articolo per migrare lo schema (DDL).
I vantaggi di questa opzione sono:
- La migrazione invia solo una singola query per tabella al pool SQL dedicato di Synapse di origine. Questa query non occupa tutti gli slot di concorrenza e non blocca gli ETL o le query di produzione dei clienti eseguiti contemporaneamente.
- Non è necessario scalare a DWU6000, dato che per ogni tavolo viene usato solo uno slot di concorrenza, quindi puoi usare DWU più bassi.
- L'estratto viene eseguito in parallelo su tutti i nodi di calcolo, e questa funzione migliora le prestazioni.
Uso consigliato
Usare CETAS per estrarre i dati su ADLS in formato Parquet. I file Parquet offrono il vantaggio di un'archiviazione efficiente dei dati con compressione colonnare, che richiede meno larghezza di banda per il trasferimento sulla rete. Poiché Fabric memorizza i dati in formato parquet Delta, l'ingestione dati è 2,5 volte più veloce rispetto al formato file di testo, poiché non c'è sovraccarico di conversione al formato Delta durante l'ingestione.
Per aumentare la velocità effettiva CETAS:
- Aggiungere operazioni CETAS parallele, aumentando l'uso di slot di concorrenza, ma consentendo una maggiore capacità di elaborazione.
- Ridimensionare la DWU nel pool SQL dedicato di Synapse.
Migrazione tramite dbt
Questa sezione descrive l'opzione dbt per i clienti che già utilizzano dbt nel loro ambiente dedicato di pool SQL Synapse.
Operazioni che dbt può eseguire:
- Converti lo schema (DDL) nella sintassi di Fabric Data Warehouse.
- Crea lo schema (DDL) su Fabric Data Warehouse.
- Convertire il codice del database (DML) nella sintassi di Fabric.
Il framework dbt genera DDL e DML (script SQL) in tempo reale con ogni esecuzione. Utilizzando file di modello espressi come istruzioni SELECT, dbt traduce istantaneamente il codice DDL/DML per qualsiasi piattaforma di destinazione modificando il profilo (stringa di connessione) e il tipo di adattatore.
Uso consigliato
Il framework DBT utilizza un approccio code-first. Migra i dati utilizzando le opzioni elencate in questo documento, come CETAS o COPY/Data Factory.
Utilizzando l'adattatore dbt per Microsoft Fabric Data Warehouse, puoi migrare progetti DBT esistenti che mirano a diverse piattaforme come Azure Synapse pool SQL dedicati, Snowflake, Databricks, Google BigQuery o Amazon Redshift in un warehouse con una semplice modifica di configurazione.
Per iniziare con un progetto dbt che mira Fabric Data Warehouse, consulta Tutorial: Configura dbt per Fabric Data Warehouse. Questo documento elenca anche un'opzione per spostarsi tra diversi magazzini e piattaforme.
Ingestione dei dati in Fabric Data Warehouse
Per l'ingestione in Fabric Data Warehouse, usa COPY INTO o Fabric Data Factory, a seconda delle tue preferenze. Entrambi i metodi sono le opzioni raccomandate e con le migliori prestazioni, poiché hanno un throughput di prestazioni equivalente, dato il prerequisito che i file siano già estratti in Azure Data Lake Storage (ADLS) Gen2.
Progetta il tuo processo per ottenere la massima prestazione considerando i seguenti fattori:
- Con Fabric, non c'è contesa sulle risorse quando si caricano più tabelle da ADLS a Fabric Data Warehouse contemporaneamente. Di conseguenza, non si verifica alcuna riduzione delle prestazioni durante il caricamento di thread paralleli. La massima velocità di ingestione è limitata solo dalla potenza di calcolo della tua capacità Fabric.
- La gestione del carico di lavoro del fabric offre la separazione delle risorse allocate per il carico di lavoro e le interrogazioni. Non c'è contesa sulle risorse mentre query e caricamento dati vengono eseguiti contemporaneamente.
Contenuto correlato
- Assistente alla Migrazione di Fabric per Magazzino Dati
- Crea un magazzino in Microsoft Fabric
- Linee guida sulle prestazioni di Fabric Data Warehouse
- Sicurezza a Fabric Data Warehouse
- Blog: Mappatura dei pool SQL dedicati di Azure Synapse al calcolo di Fabric Data Warehouse
- Panoramica della migrazione di Microsoft Fabric