Important
この機能は ベータ版です。
エージェントの記憶は、会話をまたいで持続する長期記憶をエージェントに与えます。 Azure DatabricksはメモリをLakebaseに保存し、ストレージ、インデックス作成、検索を管理するため、エージェントはデータベースを運用しなくてもユーザーの好みや過去の決定、蓄積されたコンテキストを記憶できます。
Note
プレビュー中は、メモリエントリを保存する基盤となるLakebaseインスタンスに対して請求されます。 エージェントの記憶自体に追加料金はかかりません。 プレビューの進行に伴い価格が変更される場合があります。
エージェントで次のこと実行する場合は、エージェント メモリを使用します:
- ユーザーの好み、事実、意思決定を別々の会話で覚えておく。
- エージェントが以前のセッションで学んだことを基に、個別の回答をカスタマイズしましょう。
- エージェントやプロジェクト間で蓄積された知識を共有しましょう。
- 時間の経過に伴う精度と効率の向上。
エージェントメモリは、任意のフレームワークで構築されたエージェントで動作します。 単一のやり取り内での短期的な会話履歴を記録するには、エージェントセッションを使いましょう。
Requirements
- AgentKit SDKを使用するには、Python 3.10以降をインストールしてください。 AgentKit SDKは、以下の例で使われているエージェントAPI用のDatabricks Pythonクライアントです。 また、Pythonの必要はなく、どの言語からでもREST APIを直接呼び出せます。
-
memory_store.put()またはmemory_store.list(path=...)を使うには、databricks-agentbricks0.6.0以降をインストールしてください。
エージェントメモリの仕組み
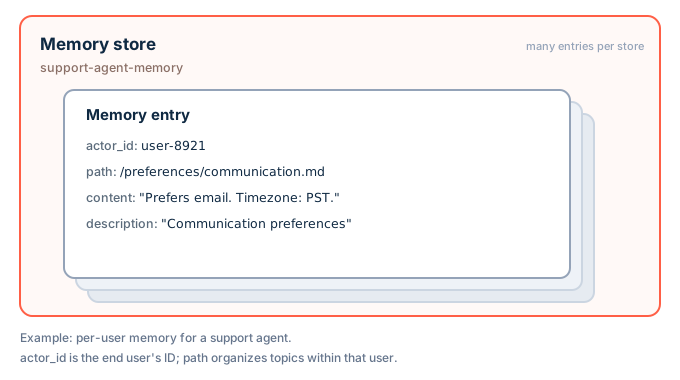
エージェントメモリには2つのレベルがあります:
- メモリストアは、エージェントのメモリを格納するためのワークスペーススコープ付きのコンテナです。 ストアを作成することで、バックアップするLakebaseストレージが自動的にプロビジョニングされます。 店舗はストアIDで指定し、ストアを作成する際にそのIDを選択します。
-
メモリエントリとはストア内の個々のコンテンツのことです。 各エントリーは自由形式のテキスト
content、取得用の短いdescription、そしてそれを整理・分割する一連のフィールドを持っています。-
actor_id(必須):メモリの所有者、例えばエンドユーザーや他のエージェント。 -
session_id(任意):メモリが属するセッション。 アクターのセッション間で適用されるメモリ用に未設定のままにしておきます。 -
path(必須):アクター内のエントリを整理するファイルシステムのようなパス(/preferences/response-style.mdなど)。
-
エントリーは actor_id、 session_id、 pathの組み合わせで一意に識別されます。 同一パスが、2 つの異なるセッション配下の場合、またはセッション配下とセッションなしの場合、2 つの別個のエントリを保持します。
エントリは2つの方法でストアに入ります。エージェントやアプリケーションが直接書き込むか、 メモリパイプライン がセッションストア内の会話からそれらを抽出します。
検索
メモリの取得方法は2通りです:
- アクターのエントリを一覧表示します。
session_id、pathプレフィックス、または完全なpathで、任意にフィルタリングできます。 これを使ってエージェントが知っていることを閲覧またはインデックス表示します。 - 自然言語クエリでアクターのエントリを検索してください。 検索は関連度スコアでランク付けされた最も関連性の高いエントリーを返します。
どちらの操作でも session_id フィルターを適用すると、そのセッションで保存されたエントリのみが返されます。 セッションなしで保存されたエントリーは返されません。
概要
AgentKit SDKやREST APIの例は、サポートエージェントのためにエージェントメモリを設定します。メモリストアを作成し、ユーザーの好みを保存し、後の会話で呼び戻します。 Agent BricksのCLI例では、CLIでビルドおよびデプロイするエージェントに、メモリストアを接続します。 自分のプロジェクトに合ったクライアントを選びましょう。 メモリストアIDは3文字から56文字で、小文字の英字で始まり、英字または数字で終わり、小文字の英字、数字、ハイフンのみを含む必要があります。
AgentKit SDK
AgentKit SDKは、エージェントAPIのためのDatabricks Pythonクライアントで、databricks-agentbricksパッケージに配布されています。 Databricks SDKの WorkspaceClientで認証されます。
AgentKit SDKをインストールする:
pip install databricks-agentbricksエージェントのためにメモリーストアを作成しましょう。
AgentKitClientお客様のWorkspaceClient認証情報で認証します:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")エージェントがユーザーについて何か持続的なことを知った後にメモリを保存します。
actor_idはこのメモリの所有者であり、pathそのアクター内で整理し、description検索を改善します。memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()は、そのパスにすでにエントリが存在する場合、ALREADY_EXISTSで失敗します。 エントリを作成したり既存のエントリを更新するには、同じ引数でmemory_store.put()を呼び出します。自然言語検索で後の会話でユーザーの記憶を思い出す:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
クライアントはREST APIを /api/2.0/agents/memory-storesで呼び出します。 Python以外の言語では直接呼び出せばいいです。
Databricks CLIを使ってOAuthトークンを生成します:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
エージェントのためのメモリストアを作成する:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
ユーザー用のメモリエントリを保存します。
actor_idはこのメモリの所有者であり、pathはそれを整理し、descriptionは検索を改善します。curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'もしそのパスにすでにエントリが存在する場合、リクエストは
ALREADY_EXISTS(HTTP 409)で失敗します。 代わりに既存のエントリを更新するには、それをパスで検索します。 検索では各セッションのパスのエントリが返されるので、session_idが一致するものを選びます。nameの最後のセグメントはエントリIDです:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"次に、エントリーのIDを使用して内容を更新します:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
自然言語検索でユーザーの記憶を呼び起こす:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
エージェント・ブリックス
エージェントをAgent Bricks CLIでビルドすると、agentbricks init は agent.toml でメモリストアを宣言します。
agentbricks deploy は、ストアがまだ存在しない場合はそれを作成し、デプロイされたエージェントにアクセス権を付与します。
パスを選択:
空からスタート(ほとんどのエージェント): エージェントをデプロイします。
agentbricks deployがagentbricks initが宣言したメモリ ストアを作成します。my-agentという名前のエージェントをデプロイするには、以下を実行します。agentbricks deploy my-agentまずストア内の既存のメモリから始めます:まずストアを作成し、エントリを追加し、ストアをエージェントにバインドしてデプロイします。
my-agent-memoryという名前のストアを作成するには、以下を実行します。 出力にはストアIDが含まれており、これはストア名とは別に生成された識別子です:agentbricks memory stores create --name my-agent-memoryエントリを追加するには、以下を実行し、
<store-id>を前のステップのストアIDに置き換えます:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."ストアをバインドしエージェントをデプロイするには、以下を実行します。
agentbricks memory bindはagent.toml内の店舗名を置き換え、agentbricks deployは名前で既存の店舗を見つけて、新しい店舗を作成する代わりにそれを使用します:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path はストア内でそのエントリを識別するキーであり、マシン上のファイルではありません。
--actor-id は記憶の所有者であるユーザーです。 デプロイされたエージェントはサインインしたユーザーのメールアドレスをアクターIDとして使うため、各エントリをサインインしているユーザーのメールアドレスで初期化します。
Agent Bricks CLIでは、memory bind と agentbricks deploy はストアを名前で参照します。
memory entries createのように単一のストアに作用するコマンドは、生成されたストアIDを受け取ります。
エージェントに記憶ツールを与えましょう
エージェントがいつメモリを保存・リコールするかを決められるようにし、クライアント操作をツールとしてラップし、システムプロンプトでいつ使用するか指示します。 認証済みのエンドユーザーIDから信頼されたアプリケーションコードで actor_id を設定します。 どちらのメモリを読み書きするかをモデルに決めさせてはいけません。
以下の例は、GetstartedのAgentKit memory_storeSDKをOpenAIエージェントSDKのツールとしてラップしています。
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() エントリを作成するか、そのパスにあるエントリの内容を置き換えます。 代わりに新しい行として内容を追加するには、append=True を指定してください。
put() は原子的ではないため、同じパスへの同時書き込みは互いに上書きし合うことがあります。
list(path=...) はすべてのセッションでその正確なパスにあるエントリを返すため、セッション配下のパスに保存されたエントリも forget_memory で削除されます。
同じパターンはClaude Agent SDKや他のフレームワークでも機能します。ストアの検索、保存、リスト、削除操作をフレームワークのツールタイプとしてラップします。
同じメモリストアで メモリパイプライン も実行すれば、パイプラインはエージェントが処理する任意のアクターについて保存するエントリを書き換え、マージ、分割、削除できます。
パーティションとセキュアメモリ
店内では、 actor_id 誰の記憶が誰のものかを区別する方法です。 すべてのリストと検索は単一の actor_idに限定されているため、エージェントが覚えておくべき戦略を選びましょう。
-
各ユーザーごとのプライベートメモリ:
actor_idを認証済みエンドユーザーの身元に設定します。 各ユーザーは自分のパーティションを持ち、エージェントはそのユーザーのエントリだけを思い出します。- 例: サポート担当者は、あるユーザーのコミュニケーションの好みや過去のチケットを覚えています。
-
グループ共有メモリ:
actor_idチーム、プロジェクト、組織IDなど、選択した固定キーに設定します。 みんな同じ記憶を読み書きします。- 例: チームエージェントは会社の用語や社内慣習の共通用語集を覚えています。
-
メモリを別のもので分割する場合:テナントIDや
user:project複合データなど、自分の値からactor_idを構築しましょう。-
例: マルチテナントアプリは
actor_idを{tenant}:{user}に設定し、各顧客のユーザー同士を隔離します。
-
例: マルチテナントアプリは
アプリケーションコード内で actor_id を設定してください。信頼された呼び出し元コンテキストから:ユーザー単位のメモリは検証済みエンドユーザーID、共有メモリは信頼できるチームまたはプロジェクトキーです。 モデルに決めさせてはいけません。 もし戦略がエンドユーザーのアイデンティティに依存している場合は、共有 actor_idに戻るのではなく、エンドユーザーのアイデンティティを含まないリクエストを拒否してください。
Warning
actor_id メモリを分離しますが、アクセス制御ではありません。 メモリストアはワークスペーススコープで定義されているため、ストアにアクセスできるプリンシパルはすべてのアクターにまたがるすべてのエントリを読み書きできます。 セキュリティ境界はアクターではなく、ストアです。 テナントやユーザー間の厳密な隔離のために、境界ごとに別々のメモリストアを作成します。
エージェントのサービスプリンシパルのような別のプリンシパルにストアを使わせるには、ストアの付与許可操作(AgentKit SDK内のmemory_store.grant_permission(principal_id) )でアクセス権を付与します。 アクセスを許可できるのは、ストアの作成者またはワークスペース管理者のみです。
Limitations
- エージェントメモリは長期記憶のみを提供します。 短期的な会話履歴については、エージェントセッションを参照してください。
- 検索は関連性でエントリーをランク付けし、全文(BM25)と各エントリーの内容や説明の意味的マッチングを組み合わせます。 最大100件まで返し、ページ付けはサポートしていません。
- 店舗レベルでアクセス制御が施行されます。 エントリごとおよびアクターごとのアクセス制御は利用できません。
- ストア アクセス コントロールはストアのエントリを対象とします。 どのワークスペースユーザーでも、IDや記述を含むメモリストアをリストアップし取得できます。
- 店舗を作成した後はIDを変更することはできません。 更新できるのは
descriptionだけです。