Important
この機能は ベータ版です。
マネージドエージェントセッションは、エージェントに持続的でフレームワークに依存しないセッション状態のストアを提供します。これはエージェントやフレームワークが1回のやり取りで保持する状態です。 最も一般的なのは会話履歴であり、エージェントがターン開始時に読み、実行中に付け加えるメッセージ、ツール呼び出し、結果の順序付けされた書き起こしです。 また、LangGraph のグラフのように、フレームワークがそのやり取りのために永続化する他の任意の状態である場合もあります。 Azure DatabricksはLakebaseにデータを保存し、ストレージを管理しているので、あなたがデータベースを構築・運用することはありません。
Note
プレビュー中は、セッションを保存する基盤となるLakebaseインスタンスに対して請求されます。 マネージドエージェントセッション自体に追加料金はかかりません。 プレビューの進行に伴い価格が変更される場合があります。
管理されたセッションは、必要に応じて使います:
- エージェントの会話履歴を永続化し、再起動後に再開できるようにしてください。
- フォローアップメッセージの文脈(ツール呼び出しや推論を含む)を再構築します。
- 独自のUIから過去の会話を一覧表示し、再開し、分岐できます。
マネージドセッションは単一のインタラクションの状態(短期のセッション内状態)を保持します。 複数の会話にまたがって保持される永続的な長期記憶には、マネージド エージェント メモリを使用します。
必要条件
- AgentKit SDKを使用するには、Python 3.10以降をインストールしてください。 AgentKit SDKは、以下の例で使われているエージェントAPI用のDatabricks Pythonクライアントです。 また、Pythonの必要はなく、どの言語からでもREST APIを直接呼び出せます。
管理されたセッションの仕組み
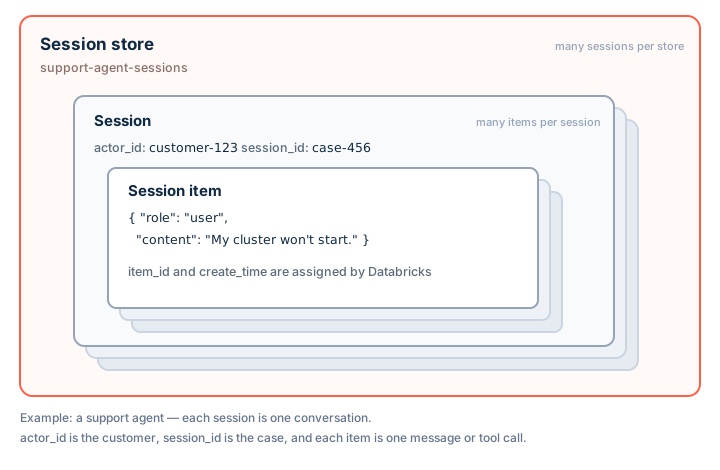
管理されたセッションは3つのレベルに分かれます:
-
セッションストアは、エージェントのセッションのためのワークスペーススコープ付きコンテナです。 ストアを作成することで、バックアップするLakebaseストレージが自動的にプロビジョニングされます。 ワークスペース独自の
session_store_nameを選びます。 -
セッションとは、店舗内での持続的なやり取り(通常は会話スレッド)のことです。 セッションは以下で識別されます:
-
actor_id(必須):セッションの属先、例えばエンドユーザーや他のエージェント。 1つの科目のセッションをすべてまとめてリストアップし、まとめてフィルターできます。 ユーザーごとのアプリを構築する際は、actor_idユーザーID(例えばアプリの認証で確認されたエンドユーザーID)に設定し、各ユーザーのセッションがグループ化されたままにします。 信頼できるアプリケーションのコンテキストから設定し、モデルやユーザーが提供する値では決して設定しないでください。 -
session_id(任意):やり取り用の発信者選択IDです。 省略するとサービス側が1つを生成します。 -
parent_session_id(任意): 分岐した会話を表すために、セッションをフォーク元のセッションにリンクします。
-
-
セッション項目とは、セッションの順序付け履歴の一つのエントリーです。 各項目には、メッセージ、ツール呼び出し、ツール結果、推論ブロックなどの不透明なJSON互換
data値が保持されます。 Azure Databricksは各アイテムにitem_idとcreate_timeを割り当て、その内容を検査・検証しません。 項目は付加されると不変です。
サービスはセッションのアイテムに対して決定的な順序を維持し、セッションストアに対してすべての操作を承認します。
概要
これらの例はサポートエージェントのためにマネージドセッションを設定するものです。セッションストアを作成し、ある会話のセッションを開始し、その会話のターンを追加し、後のリクエストで履歴を読み返します。 自分のプロジェクトに合ったクライアントを選びましょう。
AgentKit SDK
AgentKit SDKは、エージェントAPIのためのDatabricks Pythonクライアントで、databricks-agentbricksパッケージに配布されています。 Databricks SDKの WorkspaceClientで認証されます。
AgentKit SDKをインストールする:
pip install databricks-agentbricksセッションストアを作成し、1つの会話のためにセッションを始めます。
actor_idは会話の属先であり、オプションsession_idはこの会話を一意に識別します:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")エージェントが走る間に会話の順番を付け加えてください。 各項目は任意のJSON互換値です:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
フォローアップのリクエストがあったら、セッションを再読み込みし、その全履歴を読み返してコンテキストを再構築します:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
REST API
クライアントはREST APIを /api/2.0/agents/session-storesで呼び出します。 Python以外の言語では直接呼び出せばいいです。
Databricks CLIを使ってOAuthトークンを生成します:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
エージェント用のセッションストアを作成する:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
会話のセッションを始めましょう。
actor_idはその所有者である。session_idこの会話を独自に識別している:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'エージェントが走る間に会話ターンを追加してください:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
歴史を時系列で読み返して文脈を再構築しよう:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
クライアントはまた、最新のアイテムの削除、セッションのアイテムのクリア、会話を独立したコピー(任意の特定のアイテムまで)にフォークすることもサポートしています。 子セッションが存在するセッションを削除するには、削除をカスケードする強制オプションが必要です(例: session.delete(force=True))。
管理されたセッションでエージェントフレームワークのセッションをバックする
OpenAI Agents SDKやClaude Agent SDKのようなエージェントフレームワークは、実行開始時に会話履歴を読み取り、終了時に新しい項目を追加します。 セッションストアはそのパターンに直接マッピングされます:
| フレームワークの運用 | セッションストア呼び出し |
|---|---|
| 歴史を読む |
list_items 時系列順 (order_by="create_time asc") |
| ターンアイテムの追加 |
append 新しいアイテム |
| 最後の項目を元に戻す |
pop 最新のアイテム |
| スレッドを消してください |
clear セッションの項目 |
範囲とアクセス
マネージドセッションは、セッションの項目を不透明でJSON互換の値として保存します。サービスは永続化し、エージェントやフレームワークが付加したものを解釈せずに返します。 実行、チェックポイント、承認などの実行制御リソースを一級概念として追加するわけではありませんが、そのような状態をシリアライズするフレームワークはアイテムとして永続化できます。
セッションストアはワークスペーススコープが設定されており、アクセスはストアレベルで認可されます。
actor_idおよびmetadataフィールドはグループ化とフィルタリングのみを支持しており、アクセスの許可や制限は行いません。 モデルやユーザーが提供する値ではなく、信頼できるアプリケーションのコンテキストから actor_id を設定しましょう。
エージェントのサービスプリンシパルのような別のプリンシパルにストアを使わせるには、ストアの付与許可操作(AgentKit SDK内のsession_store.grant_permission(principal_id) )でアクセス権を付与します。
マネージドセッションと マネージドメモリ は独立しています。 セッションやセッションストアを削除しても、メモリストアに保持されているメモリは削除されません。