Databricks AI Search(旧称:Databricks Vector Search)は、Databricks Data + AIプラットフォームに組み込まれ、ガバナンスおよび生産性ツールと統合された検索ソリューションです。 これは、クエリに最も似た埋め込みを見つけることで、RAG システム、レコメンダー システム、画像とビデオ認識などの AI アプリケーションの取得に力を発揮します。
ベクター検索は、埋め込みを取得するために最適化された検索の一種です。 埋め込みとは、データ (通常はテキストまたは画像データ) のセマンティック コンテンツの数学的表現です。 埋め込みは大規模な言語モデルによって生成され、互いに似たドキュメントや画像を見つけることに依存する多くの AI アプリケーションの重要なコンポーネントです。
Databricks AI Searchでは、Delta Lakeテーブル、ストリーミングテーブル、または Iceberg v3 以上の管理テーブルなど、ソーステーブルからAI検索インデックスを作成できます。 インデックスには、メタデータを含む埋め込みデータが含まれます。 続いて REST API を使用してインデックスでクエリを実行し、最も類似したベクトルを特定して、関連するドキュメントを返すことができます。 インデックスを構造化すれば、基盤となるソーステーブルが更新された際に自動的に同期されるようにできます。
AI Search では、次の機能がサポートされます。
- ハイブリッドキーワード類似性検索。
- 任意のエンドポイントでのフルテキスト キーワード検索 (ベータ)、またはストレージ最適化エンドポイントでの専用のフルテキスト インデックス (ベータ)。
- フィルター処理。
- Reranking。
- AI Search エンドポイントを管理するためのアクセス制御リスト (ACL)。
- 選択した列のみを同期します。
- 生成された埋め込みを保存して同期します。
AI 検索のしくみ
AI Search では、近似最近傍(ANN)検索に Hierarchical Navigable Small World(HNSW)アルゴリズムを使用し、埋め込みベクトルの類似性の測定には L2 距離メトリックを使用します。 コサインの類似性を使用する場合は、ベクター検索アルゴリズムにデータポイント埋め込みをフィードする前に、データポイントの埋め込みを正規化する必要があります。 データ ポイントが正規化されると、L2 距離によって生成される順位は、コサインの類似性によって生成されるランキングと同じです。
AI Search では、ベクターベースの埋め込み検索と従来のキーワードベースの検索手法を組み合わせたハイブリッド キーワード類似性検索もサポートされています。 この手法は、クエリ内の正確な単語と一致させると同時に、ベクトルベースの類似性検索を使用して、クエリのセマンティック リレーションシップとコンテキストをキャプチャします。
ハイブリッド キーワード類似性検索では、これら 2 つの手法を統合することで、正確なキーワードだけでなく、概念的に似ているものも含まれるドキュメントを取得し、より包括的で関連性の高い検索結果を提供します。 この方法は、ソース データに SKU や識別子などの一意のキーワードがあり、純粋な類似性検索に適していない RAG アプリケーションで特に便利です。
API の詳細については、Python SDK リファレンスと AI Search インデックスのクエリを参照してください。
類似性検索の計算
類似性検索の計算では、次の式を使用します。
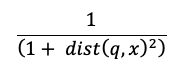
ここで dist は、クエリ q とインデックス エントリ x間のユークリッド距離です。
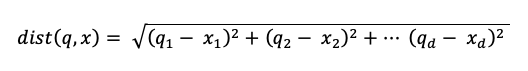
キーワード検索アルゴリズム
関連性スコアは 、Okapi BM25 を使用して計算されます。 ソース テキストの埋め込みと、テキストまたは文字列形式のメタデータ列を含め、すべてのテキストまたは文字列列が検索されます。 トークン化関数は、単語の境界で分割し、句読点を削除し、すべてのテキストを小文字に変換します。
類似性検索とキーワード検索を組み合わせるには
類似性検索とキーワード検索結果は、Reciprocal Rank Fusion (RRF) 関数を使用して組み合わせることができます。
RRF はまず、各メソッドのスコアを利用して各ドキュメントを再評価します。
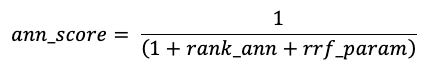
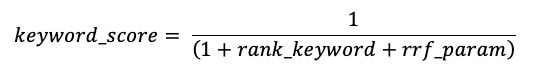
rrf_param は、上位と下位のドキュメントの相対的な重要度を制御します。 文献に基づいて、 rrf_param は60に設定されている。
スコアは、次の正規化係数を使用して、可能な限り最高のスコアが 1 になるように正規化されます。
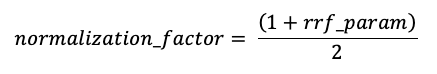
各ドキュメントの最終スコアは次のように計算されます。
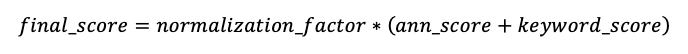
最終スコアが最も高いドキュメントが返されます。
ベクトル埋め込みを提供するためのオプション
Databricks で AI 検索インデックスを作成するには、まずベクター埋め込みを提供する方法を決定する必要があります。 Databricks では、3 つのオプションがサポートされています。
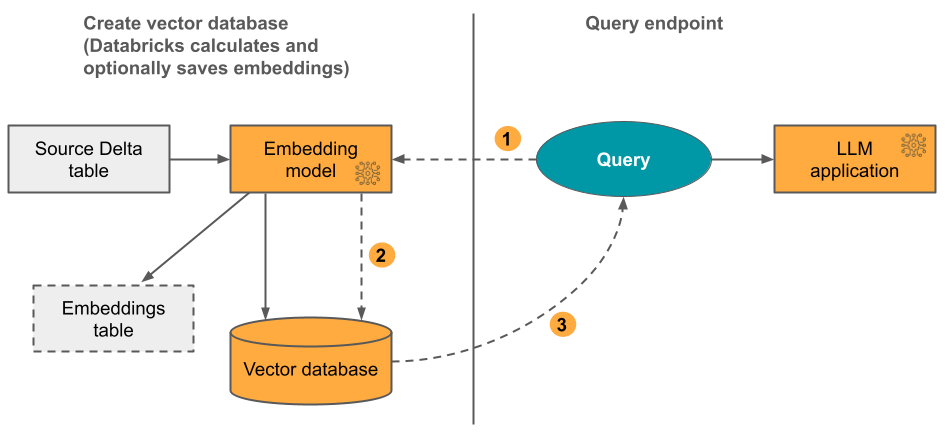
オプション 1: Databricks によって計算された埋め込みを使ったデルタ同期インデックス
このオプションでは、テキスト形式のデータを含むソースを使いましょう。 サポートされているソースタイプには、Delta Lakeテーブル、ストリーミングテーブル、またはIceberg v3以上を使った管理型テーブルが含まれます。 Databricks は、指定したモデルを使用して埋め込みを計算し、必要に応じて Unity カタログのテーブルに埋め込みを保存します。 ソースが更新されると、インデックスは同期されたままです。
次の図にこのプロセスを示します。
- クエリの埋め込みを計算します。 クエリにはメタデータ フィルターを含めることができます。
- 類似性検索を実行して、最も関連性の高いドキュメントを特定します。
- 最も関連性の高いドキュメントを返し、それをクエリに追加します。
オプション 2: 自己管理型埋め込みを使用した差分同期インデックス
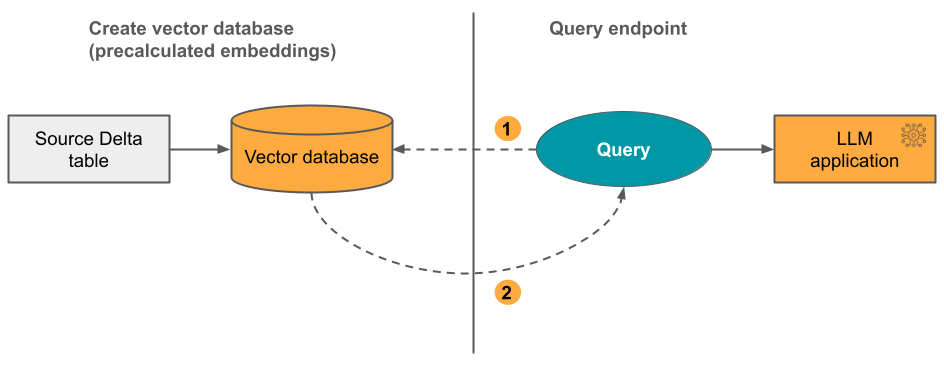
このオプションでは、事前に計算された埋め込みを含むソースを使いましょう。 サポートされているソースタイプには、Delta Lakeテーブル、ストリーミングテーブル、またはIceberg v3以上を使った管理型テーブルが含まれます。 ソースが更新されると、インデックスは同期されたままです。
Note
自己管理型埋め込みインデックスを Databricks マネージド インデックスに変換することはできません。 後でマネージド 埋め込みを使用する場合は、新しいインデックスを作成し、埋め込みを再計算する必要があります。
次の図にこのプロセスを示します。
- クエリは埋め込みで構成され、メタデータ フィルターを含めることができます。
- 類似性検索を実行して、最も関連性の高いドキュメントを特定します。 最も関連性の高いドキュメントを返し、それをクエリに追加します。
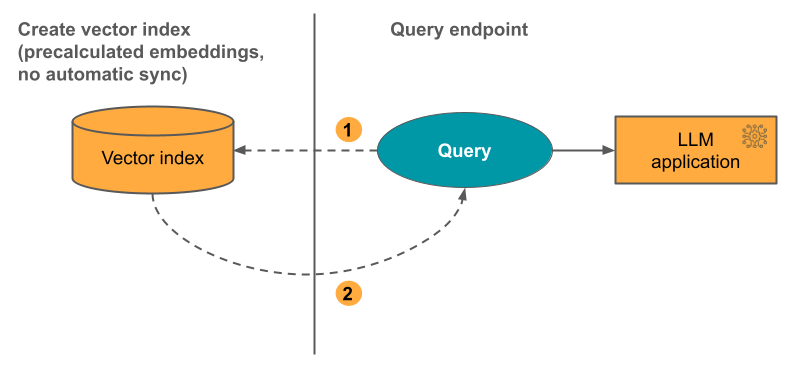
オプション 3: 直接ベクター アクセス インデックス
このオプションでは、埋め込みテーブルが変更されたときに REST API を使用してインデックスを手動で更新する必要があります。
次の図にこのプロセスを示します。
オプション 4: ストレージ最適化エンドポイントでのフルテキスト検索インデックス (ベータ)
このオプションでは、列を埋め込まずに、ストレージ最適化エンドポイントに差分同期インデックスを作成します。 インデックスでは、ベクター埋め込みを必要とせずに、BM25 スコアリングを使用したキーワードベースのフルテキスト検索がサポートされます。 これは、テキスト データ内の正確な用語、識別子、またはキーワードを検索する場合に便利です。
Note
query_type="FULL_TEXT"を使用して、標準エンドポイントとストレージ最適化エンドポイントの両方で既存の AI Search インデックスに対してキーワード検索を実行することもできます。 このオプションは、埋め込みをまったく含まない専用インデックスを作成するためのオプションです。
専用のフルテキスト検索インデックスは、ストレージ最適化エンドポイントでのみ使用でき、トリガーされた同期モードが必要です。 手順については 、フルテキスト検索インデックス (ベータ) の作成 を参照してください。
エンドポイント オプション
AI Search には次のオプションが用意されているため、アプリケーションのニーズを満たすエンドポイント構成を選択できます。
Note
High QPS は、標準エンドポイントでのみ使用できます。
-
標準 エンドポイントの容量は、ディメンション 768 で 3 億 2,000 万ベクトルです。
- 標準エンドポイントでは、高い QPS を使用して、高い持続的スループットをサポートできます。 高い QPS を使用した AI Search エンドポイントのスループットのスケーリングに関する説明を参照してください。
- ストレージ最適化 エンドポイントの容量は大きく (ディメンション 768 で 10 億ベクトルを超えています)、インデックス作成が 10 ~ 20 倍高速化されます。 ストレージ最適化エンドポイントに対するクエリの待機時間は、約 250 ミリ秒で若干増加します。 このオプションの価格は、ベクターの数が多い場合に最適化されています。 価格の詳細については、 AI Search の価格に関するページを参照してください。 AI Search コストの管理については、 AI Search のコスト管理ガイドを参照してください。
エンドポイントの種類は、エンドポイントの作成時に指定します。
ストレージ最適化エンドポイントの制限事項も参照してください。
AI 検索を設定する方法
AI Search を使用するには、次を作成する必要があります。
AI Search エンドポイント。 このエンドポイントは、AI Search インデックスを提供します。 REST API または SDK を使用して、エンドポイントのクエリと更新を行うことができます。 手順については、「 AI Search エンドポイントの作成 」を参照してください。
エンドポイントは、インデックスのサイズや同時要求の数をサポートするように、自動的にスケールアップされます。 インデックスが削除されると、エンドポイントは自動的にスケールダウンされます。
AI Search のインデックス。 AI検索インデックスを使えば、ソーステーブルやビューに対してリアルタイム近似近傍(ANN)検索を利用できます。 サポートされているソースタイプには、Delta Lakeテーブル、ストリーミングテーブル、またはIceberg v3以上を使った管理型テーブルが含まれます。 検索の目的は、クエリと類似したドキュメントを特定することです。 AI 検索インデックスは Unity カタログに表示され、管理されます。 手順については、「 AI Search インデックスの作成 」を参照してください。
さらに、Databricks で埋め込みを計算することを選択した場合、事前に構成した Foundation Model API エンドポイントを使用するか、モデル提供エンドポイントを作成して任意の埋め込みモデルとすることができます。 手順については、トークンごとの支払い基盤モデル API またはエンドポイントを提供する基盤モデルの作成に関する記事を参照してください。
モデル サービス エンドポイントのクエリを実行するには、REST API または Python SDK を使用します。 クエリはソーステーブル内の任意の列に基づいてフィルターを定義できます。 詳細については、「クエリのフィルターの使用、API リファレンス、または Python SDK リファレンスを参照してください。
必要条件
- Unity Catalog 対応ワークスペース。
- サーバーレス コンピューティングが有効になっている。 手順については、「サーバーレス コンピューティングに接続する」を参照してください。
- 標準エンドポイントの場合、ソーステーブルは変更データフィードを使用しなければなりません。 Azure Databricksでの変更データ フィードの使用を参照してください。 行追跡が有効なテーブルは、手動設定を必要とせず、変更データフィードを自動的に使用します。 これはIceberg v3以上のDelta Lakeテーブルおよび管理されたテーブルに適用されます。
- AI Search インデックスを作成するには、インデックスが作成されるカタログ スキーマに対する CREATE TABLE 特権が必要です。
AI Search エンドポイントを作成および管理するためのアクセス許可は、アクセス制御リストを使用して構成されます。 AI Search エンドポイント ACL を参照してください。
データ保護と認証
Databricks では、データを保護するために次のセキュリティ制御が実装されています。
- AI Search に対するすべての顧客要求は、論理的に分離され、認証され、承認されます。
- AI Search では、保存されているすべてのデータ (AES-256) と転送中 (TLS 1.2 以降) が暗号化されます。
AI Search では、サービス プリンシパルと個人用アクセス トークン (AT) の 2 つの認証モードがサポートされています。 運用アプリケーションの場合、Databricks では、個人アクセス トークンに対して最大 100 ミリ秒のクエリごとのパフォーマンスを実現できるサービス プリンシパルを使用することをお勧めします。
サービス プリンシパル トークン。 管理者はサービス プリンシパル トークンを生成し、それを SDK または API に渡すことができます。 「サービス プリンシパルの使用」を参照してください。 運用環境のユース ケースの場合、Databricks ではサービス プリンシパル トークンの使用が推奨されます。
# Pass in a service principal
vsc = AISearchClient(workspace_url="...",
        service_principal_client_id="...",
        service_principal_client_secret="..."
        )
個人用アクセス トークン。 個人アクセス トークンを使用して、AI Search で認証できます。 個人用アクセス認証トークンを参照してください。 ノートブック環境で SDK を使用する場合、SDK によって認証用の PAT トークンが自動的に生成されます。
# Pass in the PAT token
client = AISearchClient(workspace_url="...", personal_access_token="...")
カスタマー マネージド キー (CMK) は、2024 年 5 月 8 日以降に作成されたエンドポイントでサポートされます。
使用状況とコストの監視
AI Search のインデックスとエンドポイントに関連する使用状況とコストの監視については、 AI Search のコスト管理ガイドを参照してください。
使用状況ポリシーで使用状況のクエリを実行することもできます。 AI 検索の使用ポリシーを参照してください。
リソースとデータ サイズの制限
次の表は、AI Search エンドポイントとインデックスのリソースとデータ サイズの制限をまとめたものです。
| Resource | 粒度 | 制限 |
|---|---|---|
| AI Search エンドポイント | ワークスペースごと | 500 |
| 埋め込み(デルタ同期インデックス) | 標準エンドポイント単位 | 768 埋め込みディメンションでは ~ 320,000,000 1536 埋め込みディメンションでは ~ 160,000,000 埋め込み寸法が 3072 の場合、約 80,000,000 になります (ほぼ直線的に拡大縮小) |
| 埋め込み(ダイレクトベクターアクセス索引) | 標準エンドポイント単位 | 768 埋め込みディメンションでは ~ 2,000,000 |
| 埋め込み (ストレージ最適化エンドポイント) | ストレージ最適化エンドポイントごと | 768 埋め込みディメンションでは ~ 1,000,000,000 |
| 埋め込みディメンション | インデックス単位 | 4096 |
| Indexes | エンドポイントあたり | 50 |
| Columns | インデックス単位 | 50 |
| Columns | 対応型:バイト、ショート、整数、ロング、float、double、ブールアン、文字列、タイムスタンプ、日付、配列、構造体、マップ | |
| メタデータ フィールド | インデックス単位 | 50 |
| インデックス名 | インデックス単位 | 128 文字 |
AI Search インデックスの作成と更新には、次の制限が適用されます。
| Resource | 粒度 | 制限 |
|---|---|---|
| 差分同期インデックスの行サイズ | インデックス単位 | 100KB |
| 差分同期インデックスの埋め込みソース列のサイズ | インデックス単位 | 32764 バイト |
| Direct Vector インデックスにおける一括アップサート要求のサイズ制限 | インデックス単位 | 10 MB |
| 直接ベクター インデックスの一括削除要求サイズの制限 | インデックス単位 | 10 MB |
クエリ API には、次の制限が適用されます。
| Resource | 粒度 | 制限 |
|---|---|---|
| クエリ テキストの長さ | クエリ単位 | 32764 文字 |
| ハイブリッド検索を使用する場合のトークン | クエリ単位 | 1024 文字または 2 バイト文字 |
| フィルター条件 | フィルター条件ごと | 1024 個の要素 |
| 返される結果の最大数 (近似最近隣検索) | クエリ単位 | 10,000 |
| 返される結果の最大数 (ハイブリッド キーワード類似性検索) | クエリ単位 | 200 |
| 返される結果の最大数 (フルテキスト検索) | クエリ単位 | 10,000 |
| 応答サイズ | クエリ単位 | 10 MB |
制限事項
- structおよびmapカラムには以下の制限があります:
- 構造体フィールドはプリミティブ値に解決されなければなりません。
- 配列やマップは構造体内にネストできません。
ARRAY<STRUCT>はサポートされていません。 - マップは文字列キーとプリミティブな値を持つ最上位カラムでなければなりません。
- 列名
_idは予約されています。 ソース テーブルに_idという名前の列がある場合は、AI Search インデックスを作成する前に名前を変更します。 - 行レベルと列レベルのアクセス許可はサポートされていません。 ただし、フィルター API を使用して独自のアプリケーション レベルの ACL を実装することができます。
- 別のワークスペースにインデックスを複製することはできません。 Databricks SDK または REST API を使用して、ワークスペース間の要求を行うことができます。
- インデックスの容量は、インデックス作成時のソース テーブルのサイズに基づいてプロビジョニングされます。 小さいソース テーブルから始めると、インデックスのサイズが制限され、容量不足エラーが発生する可能性があるため、インデックスを作成する前に、予想されるデータ ボリュームに合わせてソース テーブルのサイズを変更します。
ストレージ最適化エンドポイントの制限事項
このセクションの制限は、 ストレージ最適化エンドポイントにのみ適用されます。
- 継続的同期モードはサポートされていません。
- 同期する列はサポートされていません。
- 埋め込みディメンションは 16 で割り切れる必要があります。
- 増分更新は部分的にサポートされています。 すべての同期では、AI Search インデックスの一部を再構築する必要があります。
- マネージド インデックスの場合、ソース行が変更されていない場合、以前に計算された埋め込みはすべて再利用されます。
- 標準エンドポイントと比較して、同期に必要な時間の大幅なエンドツーエンドの短縮を予測する必要があります。 10 億個の埋め込みがあるデータセットは、8 時間以内に同期を完了する必要があります。 データセットが小さいほど、同期にかかる時間が短くなります。
- FedRAMP 準拠のワークスペースはサポートされていません。
- マネージド差分同期インデックスにカスタム埋め込みモデルを使用するには、 カスタム モデルと外部モデルのプレビューに対する AI クエリ を有効にする必要があります。 プレビューを有効にする方法については、「 Azure Databricks プレビューの管理 」を参照してください。
- ストレージ最適化エンドポイントは、最大 10 億個の 768 次元のベクター埋め込みをサポートします。 大規模なユース ケースがある場合は、アカウント チームにお問い合わせください。