アクセス制御
機能は、管理可能な Unity カタログ オブジェクトです。 機能へのアクセスは、 CREATE FEATURE、 READ FEATURE、および Unity カタログの MANAGE 権限によって制御されます。 完全な説明については、 Unity カタログの特権リファレンスを参照してください。
-
CREATE FEATUREスキーマ内で特徴を作成するために必要です。create_feature親スキーマregister_featureCREATE FEATUREが必要です。 最小特権の原則に従って、スキーマ レベルでCREATE FEATUREを付与します。カタログに付与して、そのカタログ内の任意のスキーマに機能を作成できるようにすることもできます。 -
READ FEATURE特徴メタデータを読むために必須です。get_feature、create_training_set、list_materialized_featuresは特徴にREAD FEATUREが必要です。 この権限は、ソースやマテリアル化された出力テーブルのフィーチャーデータへのアクセスを許可しません。 トレーニングやサービスのためにそのデータを読むには、該当する表に書SELECTかれたものも持っている必要があります。READ FEATUREスキーマまたはカタログに付与された機能は、そのスキーマまたはカタログに含まれるすべての現在および将来の機能に適用されます。 -
MANAGE: 機能のライフサイクルおよび助成金を管理するために必要です。 特徴をdelete_featureで削除し、特徴をmaterialize_featuresで具現化するには、特徴に付けMANAGEが必要です。delete_materialized_featureでマテリアル化された特徴を削除することはMANAGEによって制限されていません。削除できるのはママタイズされた特徴の創造者だけです。
すべての機能操作では、親カタログと親スキーマのUSE CATALOGにUSE SCHEMAも必要です。 具体化に MANAGE と READ FEATURE 適用する方法については、「 アクセス許可」を参照してください。
機能ビュー API
Feature コンストラクターと register_feature()
推奨される方法は、 Feature オブジェクトをローカルに構築し、 register_feature を使用して Unity カタログに保持することです。 この 2 段階のワークフローでは、機能を登録する前に ( create_training_setを含む) 実験を行うことができます。
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() は、Unity カタログにローカルに構築された Feature を登録します。
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() は、Unity カタログの機能を 1 つのステップで検証、構築、およびすぐに登録します。 これは、最初に機能をローカルで試す必要がない場合に使用します。
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
パラメーター:
-
source特徴計算で使用されるデータソース(DeltaTableSource、StreamSource、RequestSource、またはFeatureViewSource)。 -
function演算子とタイムウィンドウを束ねたAggregationFunctionで、パススルー特徴量ColumnSelection("column_name")、行ごとの変換にCustomUDFを割り当てます。 互換性のあるソースタイプについては 「サポート関数 」を参照してください。 -
catalog_name: 機能の Unity カタログ カタログ名。 -
schema_name: 機能の Unity カタログ スキーマ名。 -
entity: 集計キーまたはルックアップ キー (主キー) を定義する列名の一覧。DeltaTableSourceとStreamSourceに必須です。 たとえば、ユーザーごとに集計または検索["user_id"]。 省略RequestSourceとFeatureViewSource。 -
timeseries_column: 時間枠の集計または最新の値の選択に使用されるタイムスタンプ列。DeltaTableSourceとStreamSourceに必須です。 省略RequestSourceとFeatureViewSource。 -
name: 省略可能な機能名。 省略すると、入力列、関数、ウィンドウ (amount_avg_rolling_7dなど) から自動生成されます。 -
description: 機能の説明 (省略可能)。
返します: 検証済みのフィーチャー インスタンス
発生します: 検証が失敗した場合には ValueError
delete_feature()
Unity カタログから機能を完全修飾名で削除します。
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
フィーチャーを削除する前に、そのフィーチャーを参照するモデルまたはフィーチャー・スペックを削除または更新します。 特徴がまだ実体化されている限り削除することはできません。 まず物質化された特徴を削除し、その後特徴を削除してください。 具体化されたフィーチャーを削除する方法を参照してください。
自動生成された名前
nameを省略すると、名前が自動的に生成されます。 生成された名前は、 {column}_{function}_{window}というパターンに従います。 例えば次が挙げられます。
-
price_avg_rolling_1h(1時間平均値) -
transaction_count_rolling_30d_1d(イベント タイムスタンプからの 1d 遅延を含むトランザクションの 30 日間の数)
サポートされている関数
集計関数
Note
集計関数は、時間枠で説明されているように、時間枠と共に AggregationFunction にラップ されます。 各関数は、集計するソース列を指定する input パラメーターを受け取ります。
| Function | Description | ユースケースの例 |
|---|---|---|
Sum(input="column") |
値の合計 | ユーザーごとの毎日のアプリの使用状況 (分) |
Avg(input="column") |
値の平均 | 平均トランザクション量 |
Count(input="column") |
レコードの数 | ユーザーあたりのログイン数 |
Min(input="column") |
最小値 | ウェアラブルデバイスで記録される最低心拍数 |
Max(input="column") |
最大値 | セッションあたりのトランザクション量が最も多い |
StddevPop(input="column") |
母集団標準偏差 | すべての顧客の日次トランザクション量の変動 |
StddevSamp(input="column") |
標本標準偏差 | 広告キャンペーンのクリック率の変動 |
VarPop(input="column") |
母集団の分散 | 工場内の IoT デバイスのセンサー読み取り値の拡散 |
VarSamp(input="column") |
サンプル分散 | サンプリングされたグループに映画の評価の広がり |
ApproxCountDistinct(input="column", relativeSD=0.05) |
おおよその異なるカウント | 購入したアイテムの個別の数 |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
近似百分位数 | p95 応答の待機時間 |
First(input="column") |
最初の値 | 最初のログイン タイムスタンプ |
Last(input="column") |
最後の値 | 最新の購入金額 |
FirstN(input="column", n=3) |
まず n 配列としての値を |
セッションで最初に見た3つの製品 |
LastN(input="column", n=3) |
配列としてのラスト n 値 |
最近の3つのサポートケースの状況 |
FirstDistinct(input="column", n=3) |
まず配列として異なる値をn |
最初に見る3つの異なる製品カテゴリー |
LastDistinct(input="column", n=3) |
最後に n 配列として異なる値を示します |
最近の3つの明確な商人カテゴリー |
Note
First、 Last、 FirstN、 LastN、 FirstDistinct、 LastDistinct はデフォルトでnull値を含む。 null をスキップするには、null である入力列を明示的に除外する filter_condition を追加します。
FirstN、 LastN、 FirstDistinct、そして LastDistinct は特徴の timeseries_column を使って入力行を順序付けし、最大 n 値を含む配列を返します。
nパラメータは正の整数でなければなりません。
FirstN そして FirstDistinct 最も古いから最新のまでの値を選択します。
LastN
LastDistinct、遅い順に値を選択し、選択した値をタイムスタンプ順に返します。
FirstDistinct そして LastDistinct その方向の値を選択する際に重複値を除去します。
例えば、エンティティのソース行が event_time で ["A", "A", "B", "C", "B", "B"]のように並べられている場合、以下の関数が返されます。
| Function | 結果 |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN
LastN、FirstDistinct、LastDistinctはバージョン0.17.0以降databricks-feature-engineering必要です。
カスタムUDF
CustomUDF各行には登録されたUnity CatalogのPythonユーザー定義関数(UDF)を適用します。 リクエスト入力の変換や特徴値の結合に使います。 行を集約したり、タイムウィンドウを定義したりはしません。
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings 各UDFパラメータ名を入力にマッピングします。
RequestSourceの場合、入力はソースカラム名です。
FeatureViewSourceにとっては、上流の特徴参照です。 デフォルトパラメータを含むすべてのUDFパラメータをバインドします。 入力型はUDFのパラメータ型と正確に一致し、暗黙の数値キャストは避けなければなりません。 スカラー入力型とリターン型を使いましょう。
| Source | Behavior |
|---|---|
RequestSource |
訓練中のDataFrameや推論リクエストから列を変換します。 |
FeatureViewSource |
上流の特徴値を組み合わせます。 FeatureViewSourceをご覧ください。 |
デルタ支援の CustomUDF 機能はオンラインで具現化または提供できません。 テーブル裏の特徴値を訓練および提供のために変換するには、デルタ裏付けの集計または列選択特徴を定義し、 FeatureViewSourceを通じて参照してください。
CustomUDF
StreamSourceではサポートされていません。 ストリーミング機能の出力を変換するには、 FeatureViewSourceを通じてその機能を参照してください。
CustomUDF
RequestSourceではdatabricks-feature-engineeringバージョン0.17.0以降が必要です。
CustomUDFを使うには、UDFのEXECUTE権限、親カタログのUSE CATALOG権限、親スキーマのUSE SCHEMA権限が必要です。
以下の例ではNumPyを使って log(1 + amount)を計算し、大きな取引額のスケールを縮小しています。
カスタムUDF依存を有効にしたサーバーレスコンピュートで実行してください。
main.ecommerceスキーマは存在しなければなりません。
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
リクエスト列 transaction_amount をUDFパラメータにバインドする機能を登録 amount:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
UDFの ENVIRONMENT はオフライン計算のための依存関係を設定します。 オンライン配送の場合は、荷物を create_feature_spec(extra_pip_requirements=...) または log_model(extra_pip_requirements=...)で申告してください。 これらはUDFから自動的にコピーされるわけではありません。 特徴 サービス依存関係 および モデル依存関係を参照。
CustomUDF 機能を具体化できません。 リクエストバックおよび機能支援型UDFは、訓練やサービス中にオンデマンドで実行されます。 依存関係チェーン内の各UDFは計算量を加えるため、関数とチェーンは小さく保ちます。 UDFは欠落した入力を処理しなければならず、それはオフラインで None されたり、オンライン NaN されたりします。
欠損値の扱いに関するガイダンスについては、「 欠損特徴値の扱い方」を参照してください。
ColumnSelection (パススルー)
ColumnSelection は、集計を適用せずにソースから 1 つの列を選択します。 これは、(function内ではなく) AggregationFunctionパラメーターに直接ラップされます。 戻り値の型は、ソース スキーマから推論されます。
| Function | Description | ユースケースの例 |
|---|---|---|
ColumnSelection("col") |
列の最新の値 (集計なし) | 最新のベンダー カテゴリ、要求フィールドのパススルー |
ColumnSelection 以下のデータソースをサポートしています:
-
DeltaTableSource: ポイントインタイム結合 (ルックバック ウィンドウ集計なし) を使用して、エンティティ キーごとの最新の値を返します。 -
StreamSourceストリームからエンティティキーごとの最新の値を返します(ルックバックウィンドウの集計なし)。 -
RequestSource: 推論時に指定された値を通過します (または、トレーニング時にラベル付けされた DataFrame から抽出されます)。
DeltaTableSourceの場合、ColumnSelection機能はfilter_conditionとtransformation_sqlをサポートしており、これは最新価値選択の前に適用されます。これは集約機能と同じです。
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
例: 集計機能と列選択機能
次の例は、同じデータ ソースに対して定義されている機能を示しています。
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
フィルター条件を含む機能
filter_conditionパラメータは、集計を計算したり最新の列値を選択したりする前に、ソーステーブルから行をフィルタリングできます。 これは、データをグループ化して集計する前に適用される SQL WHERE 句として機能します。
Note
集約機能の場合、filter_condition集約前に行をフィルタリングします。これはGROUP BYの前に適用されるSQL WHERE条のようにです。 機能定義の entity によって常に定義される細分性は変更されません。
フィルターは、特徴の計算に必要なデータのスーパーセットを含む大きなソース テーブルを操作する場合に便利であり、これらのテーブルの上に個別のビューを作成する必要性を最小限に抑えます。
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
データ ソース
DeltaTableSource
DeltaTableSource は、ソース テーブルから特徴を計算する方法を定義するために使用されるエフェメラル Python オブジェクトです。 新しいテーブルは作成されません。 データの読み取りと機能の集計の構成を指定します。
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
パラメーター:
-
catalog_name、schema_name、table_name: Unity カタログのソース Delta テーブルを識別します。 -
filter_condition: 集約や列選択の前に適用されるSQLWHERE節。 例:"status = 'completed'"。 -
transformation_sql: ソース テーブルに適用される SQLSELECT式。 これを使って列名の変更、キャスト型の生成、または集約や列選択前の派生列の計算を行います。 省略すると、すべての列が選択されます (*)。 例:"user_id, CAST(amount AS DOUBLE) AS amount, event_time"。 -
dataframe_schema: 変換後の結果の DataFrame のスキーマ 。Spark StructType JSON 形式 (df.schema.json())。transformation_sqlが指定されている場合は必須です。 これにより、変換の結果として得られた列名と型がシステムに通知されます。 -
lateness:ソースが通常、イベント時間で完全になるまでの時間を記述するSourceLatenessオブジェクト。 省略された場合、そのソースは即座に完全とみなされます。
filter_conditionとtransformation_sqlの両方が設定されている場合、結果のクエリは SELECT {transformation_sql} FROM {table} WHERE {filter_condition} になります。
SourceLateness.settling_delay は、訓練中に一貫したETL遅延をシミュレートし、オンラインのマチャリゼーションに影響を与える推奨方法です。 Azure Databricksは、対象となるトレーニング評価時間をこの期間だけ後退させ、トレーニング例がオンライン上でまだ送信中のデータを使わないようにします。 マテリアライゼーション期間中、Azure Databricksは同じ期間待って完了ウィンドウを公開し、その間の最後の完了ウィンドウをサービスします。
例えば、1日のETLジョブが現地時間帯で07:00 UTCに相当する深夜8時間後に完了するとします。 8時間の決済遅延と7時間のウィンドウオフセットを使用します:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
timeseries_columnはタイプTimestampTypeまたはTimestampNTZTypeでなければなりません。
DateType 時系列には対応していません;列を最初に TimestampType にキャストします(例えば、 transformation_sql の場合)。
例: 列変換に transformation_sql を使用する
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
例: PySpark DataFrame から transformation_sql と dataframe_schema を派生する
変換を PySpark クエリとして記述し、結果の DataFrame からスキーマを抽出できます。
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
サポート transformation_sql 表現
DeltaTableSourceとStreamSourceのtransformation_sqlにも同じルールが適用されます。
transformation_sql 行ごとの表現をサポートします。各行ごとに独立して計算されます。 行数やソースとの1対1対応は変わりません。 行ごとの式には、列名変更、キャスト、算術演算などが含まれます。
形状や行数を変える操作、例えば SUM() や COUNT()のような集計はサポートされていません。 代わりに、フィーチャ定義で AggregationFunction を使用します。
DeltaTableSource.from_sql()
便宜上、SQL クエリから DeltaTableSource を作成できます。 このメソッドは、クエリを解析して、テーブル名、 transformation_sql、および filter_conditionを自動的に抽出します。
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
単純な SELECT ... FROM ... [WHERE ...] クエリのみがサポートされています。 複合 SQL (JOIN、サブクエリ、CTE、UNION) は拒否されます。 複雑なクエリの場合は、DeltaTableSourceとtransformation_sqlを使用して直接filter_conditionを構築します。
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
次の値を使用して反復処理を to_dataframe()
source.to_dataframe()を使用して、特徴の計算に使用されるデータをプレビューします。 これは、予想される結果が生成されるまで、 filter_condition と transformation_sql を反復処理する場合に便利です。
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
エンティティについて
エンティティ列は、特徴の集計レベルを定義します。 これらは、Featureではなく、DeltaTableSource定義で指定されます。 エンティティによって次の決定が行われます。
-
データのグループ化方法: エンティティ値の一意の組み合わせごとに特徴が集計されます (SQL の
GROUP BYと同様) - 主キー構造: 一意のエンティティの組み合わせごとに、1 行の計算された特徴が得られます
例: 顧客レベルの機能
次のコードは、顧客レベル (顧客ごとに 1 行) の特徴を集計します。
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
例: Customer-Store レベルの機能
より詳細なレベル (顧客ストアの組み合わせごとに 1 行) で特徴を集計するには、複数のエンティティ列を使用します。
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
さまざまなレベルの集計 (顧客レベルや顧客ストア レベルなど) で特徴が必要な場合は、機能定義で異なる entity 値を使用します。 同じ DeltaTableSource は、異なるエンティティ構成を持つ機能間で共有できます。
StreamSource
StreamSource は Stream を参照 します。 Stream には、ストリーミング ソースの接続、認証、スキーマ、およびインジェストの構成が含まれています。 Kafka の場合、読み取るメッセージの一部を示すために、機能定義内の列参照の前に value. または key. を付ける必要があります。
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
パラメーター:
-
full_name: Stream の完全な 3 部構成の名前 (たとえば、"my_catalog.my_schema.my_stream")。 -
filter_condition(省略可能): ドットプレフィックス付きの列参照 (WHEREなど) を使用して、集計前にストリーム データに適用される SQL"value.event_type = 'purchase'"句。 -
transformation_sql(任意):集計や列選択前に適用されるSQLSELECT式で、keyおよびvalue構造体へのドット接頭辞参照を使用します。DeltaTableSourceと同じ行ごとの表現をサポートしています。 省略すると、ソースはすべての列(*)を使用します。 -
dataframe_schema: SparkStructType投影出力の JSON スキーマ。 設定transformation_sqlなら必須です。 -
lateness:ストリームが通常イベント時間で完了するまでの期間を表すSourceLatenessオブジェクト。SourceLateness.settling_delayを参照してください。
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Streamのインジェスションテーブルに対して投影を実行することで、keyとvalue構造体を公開することでdataframe_schemaを導出します。
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource は、事前マテリアライズド テーブルから検索するのではなく、要求ペイロードの推論時に提供されるデータのスキーマを定義します。 トレーニング中、これらの列は、 create_training_setに渡されるラベル付き DataFrame から抽出されます。 モデルの提供中に、呼び出し元は HTTP 要求ペイロードにそれらを含める必要があります。
RequestSource
CustomUDFやColumnSelection Feature View機能と組み合わせて使用できます。 集計関数や時間枠はサポートされていません。
スキーマの定義
スキーマを FieldDefinition オブジェクトの一覧として定義し、それぞれに列名と ScalarDataTypeを指定します。
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
サポートされているデータの種類
RequestSource では、 ScalarDataTypeで定義されているスカラー型 ( INTEGER、 FLOAT、 BOOLEAN、 STRING、 DOUBLE、 LONG、 TIMESTAMP、 DATE、 SHORT) がサポートされます。 配列、マップ、構造体などの複合型はサポートされていません。
要求データのハイドレート方法
| Context | Behavior |
|---|---|
トレーニング (create_training_set) |
列は、ラベル付けされた DataFrame から抽出されます。 型は、宣言されたスキーマに対して検証されます。 型が一致しない場合はエラーになります(暗黙的なキャストは行われません)。 |
| サービス ( モデル エンドポイント) | 列は、HTTP 要求の dataframe_records または dataframe_split からプルされます。 JSON 値は、宣言された型 (JSON 番号→ DOUBLEなど) にキャストされます。 |
モデル シグネチャ
log_model特徴を含むトレーニング セットを使用してRequestSourceを使用してモデルをログに記録すると、RequestSource列が必要な入力として MLflow モデルシグネチャに追加されます。 つまり、サービス エンドポイントの API スキーマには、呼び出し元が推論時に指定する必要があるフィールドが反映されます。
FeatureViewSource
FeatureViewSource 他のフィーチャービューの出力を CustomUDFの入力として使用します。 特徴の連鎖は有向非巡回グラフ(DAG)を作成します。 例えば、マージン機能では収益とコストの集計を組み合わせることができ、別の機能ではマージンを変換できます。
FeatureViewSourceにはバージョン0.18.0以降databricks-feature-engineeringしてください。
特徴名文字列ではなく、 Feature オブジェクトのリストを featuresに渡してください。
get_featureで登録済みの特徴を取得できます。
input_bindingsでは、登録された各特徴のfull_nameを活用してください。 ローカルで未登録の機能の場合は、その name を使えばいい。
以下の例は、customer_idで値をDOUBLE返し、event_timeを用いる2つの登録済み特徴、revenue_sum_7dとcost_sum_7dを仮定しています。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
次の制限事項が適用されます。
- サポートされている関数は
CustomUDFのみです。 上流の特徴は集計、列選択、その他のCustomUDF機能である場合があります。 - 派生した特徴の
entityとtimeseries_columnは省略してください。 各上流の機能はそれぞれ独自のエンティティ、タイムスタンプ、ウィンドウ定義を保持します。 - 特徴は一つの出所を持っています。 リクエスト値とテーブル裏の機能を組み合わせるには、
RequestSource機能を定義し、両方をFeatureViewSourceで参照してください。 - 宣言されたすべての上流特徴は
input_bindingsで使用されなければなりません。 サイクルは許可されていません。 - 派生した特徴を登録する前に、上流の特徴を登録してください。 局所的で登録されていないグラフは、
create_training_setと組み合わせて実験に利用できます。 - 訓練やサービスを行う場合、派生特徴およびその推移的な上流特徴に対して
READ FEATUREまたはMANAGEの特権が必要です。 カタログやスキーマ間でも、登録やサービスにグラフ上で異なる特徴名を使いましょう。 - 特徴は最大20の直接上流特徴物を参照することができます。 登録グラフは依存経路に沿った最大5つの深さの特徴をサポートし、基本特徴も含まれます。
-
FeatureViewSource特徴はcompute_featuresで具現化や評価できません。create_training_setを使ってオフラインで評価しましょう。 オンラインサービスの場合は、対応するテーブルバックのアップストリーム機能を具現化してください。
依存性の評価と出力選択については、 FeatureViewSource特徴で訓練する項目を参照してください。 展開については、 Serve derived features(サービス派生機能)を参照してください。
トレーニングと推論 API
create_training_set と score_batch ソース データからオンデマンドでポイントインタイムの正しい特徴値を計算します。 差分テーブル ソースのスライディング ウィンドウ集計など、オフラインマテリアライズをサポートする機能の場合、最初にオフライン ストアにフィーチャーを具体化すると、両方の操作のパフォーマンスが向上します。 具体化されたオフライン機能を使用できる場合、操作では、ソースから機能の値を再計算するのではなく、事前計算済みのオフライン データを読み取ります。 オフライン ストア にフィーチャーを具体化するには、「フィーチャー ビュー を具体化する」を参照してください。
create_training_set()
ポイントインタイムの正しい特徴計算を使用してトレーニング データセットを作成します。 詳細については、「 フィーチャ ビューを使用してモデルをトレーニングする」を参照してください。
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
系列追跡と推論中の自動特徴検索の特徴メタデータを含むモデルをログに記録します。 詳細については、「 フィーチャ ビューを使用してモデルをトレーニングする」を参照してください。
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
機能の自動参照を使用してオフライン バッチ推論を実行します。 モデルに格納されている特徴メタデータを使用して、ポイントインタイムの正しい特徴を計算し、トレーニングとの一貫性を確保します。
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
入力 DataFrame には、トレーニング中に使用されるエンティティ列と時系列列が含まれている必要があります。 特徴はソース データから自動的に計算されます。
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
時間枠
Feature Viewsは、時間ウィンドウベースの集約におけるルックバックの挙動を制御するための4種類のウィンドウタイプをサポートしています。 利用可能なウィンドウタイプは、その機能のソースによって異なり、ストリーミングソース機能はローリングウィンドウやソートゥースウィンドウを、バッチソース機能はローリング、タンブリング、スライディングウィンドウを使用できます。
- ローリング ウィンドウは、イベント時刻から振り返ります。 期間と遅延は明示的に定義されます。
- タンブリング ウィンドウは固定され、重複しない時間窓です。 各データ ポイントは、1 つのウィンドウに属します。
- スライド ウィンドウは、構成可能なスライド間隔で重なり合うローリング タイム ウィンドウです。
- Sawtooth Windowsは、ハイブリッドバッチとストリーミングパスを用いてストリーミングソースに対して長いルックバックウィンドウを新鮮に保ちます。 ソー トゥースウィンドウをご覧ください。
以下の図は、タンブリング、スライド、ロール、ソーストゥースウィンドウの各タイプを示しています。

タイムウィンドウタイミング
delayを使って、より前の解析時点のウィンドウを評価します。 例えば、7日遅延の30日間のウィンドウは、評価時刻の1週間前時点での30日間の値を計算します。
delay はソースの到着時間に依存しません。 ソースデータが到達するまでの時間をモデル化するには、代わりに SourceLateness.settling_delay を設定しましょう。
両方の環境が揃うと、彼らは作曲します。 Azure Databricksは、ソース決済遅延後のウィンドウを完了として扱い、解析遅延で評価します。
offsetを使って固定ウィンドウ境界のアライメントを変更してください。 デフォルトでは、回転ウィンドウとスライドウィンドウは真夜中UTCに割り当てられています。 例えば、22時間のオフセットは日々の境界を22:00 UTCに合わせます。 現地のタイムゾーンで境界を近似するには、UTCに対して静的なオフセットを設定してください。 オフセットはサマータイムを調整したり、評価時間をずらしたり、遅れて到着したデータをモデル化したりしません。
以下の表はこれらのフィールドのサポートをまとめたものです。
| フィールド | 対応ウィンドウ | 制約 |
|---|---|---|
delay |
転がり、転がり、滑り | 非負でなければなりません datetime.timedelta |
offset |
転がり、滑り | 非負で、かつ周期より短いものでなければなりません。 |
SourceLateness.settling_delay |
転がり、回転、滑る特徴 | 非負でなければなりません datetime.timedelta |
start_time |
転がり、転がり、滑り | きっと datetime.datetime |
*句点:タンブリングウィンドウの場合、オフセットは window_durationより短くなければなりません。 スライド式の窓は slide_durationより短くなければなりません。
[開始時間]
特徴が出力を出すことができる最も早いイベント時間境界を設定するために start_time を使いましょう。 境界線は包括的です。
start_time ゲート出力。 ウィンドウが読み取れる過去のソース行を制限せず、ウィンドウのアラインメントも変更しません。
start_timeが2つのアラインメントされた境界の間に位置する場合、最初の適格な固定ウィンドウ出力が次の境界となります。
start_timeの場合、固定時間のウィンドウはソースでウィンドウの全期間が経過する前に発信できます。 これらの初期出力は利用可能なソース履歴を利用しています。 例えば、データ開始日が2024年1月1日であるソースに対して、1年 window_duration と1日 slide_durationのスライディングウィンドウを考えてみましょう:
-
start_timeがなければ、この特集は1年間のウィンドウが完全にできた後、2025年1月1日に初めて公開されます。 -
start_time2024年8月21日に設定されており、特集は2024年8月21日に初公開されます。 その出力は、2024年1月1日以降の現時点で利用可能なソース履歴のみをカバーしています。 このウィンドウは2025年1月1日に1年間のフルスパンチを迎え、それ以降は完全な出力を生み出します。
start_timeウィンドウのアライメントを変えないため、アラインされた2つの境界間の値が新しい境界を生み出しません。 UTC時の1日境界を持つタンブリングウィンドウの場合、10時UTCの10時06:0 start_time 0の境界が次の深夜境界で最初に送信されます。 境界に正確に着地した start_time は、その境界が包含的であるため、その境界から放射されます。
start_timeが未設定の場合、タンブリングウィンドウや固定時間のスライドウィンドウは、完全なウィンドウが形成された後に最初に整列した境界から放射されます。 ライフタイムスライディングウィンドウとロールウィンドウは、対象となるソースデータが存在すると同時に発行します。
Note
start_time ロールウィンドウ、タンブリングウィンドウ、スライドウィンドウを備えた DeltaTableSource を使うバッチ機能に対応しています。
StreamSourceやSawtoothWindowではサポートされていません。
例えば次が挙げられます。
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
ローリングウィンドウ
Note
RollingWindow は以前に ContinuousWindow という名前でした。 以前のバージョンの SDK から移行する場合は、それに応じてインポートを更新します。
ローリング ウィンドウは-date とリアルタイムの集計 up-toされ、通常はストリーミング データに対して使用されます。 ストリーミング パイプラインでは、イベントの入退出時など、固定長ウィンドウの内容が変更された場合にのみ、ローリング ウィンドウによって新しい行が出力されます。 トレーニング パイプラインでローリング ウィンドウ 機能を使用すると、特定のイベントのタイムスタンプの直前の固定長ウィンドウ期間を使用して、ソース データに対して正確なポイントインタイム機能計算が実行されます。 これは、オンラインオフラインのスキューやデータ漏洩を防ぐのに役立ちます。 時間Tでの機能は、[T から - 期間、T) におけるイベントを集計します。
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、ローリング ウィンドウのパラメーターを示します。 ウィンドウの開始時刻と終了時刻は、次のパラメーターに基づいています。
- 開始時刻:
evaluation_time - window_duration - delay(含む) - 終了時刻:
evaluation_time - delay(を含まない)
| パラメーター | Constraints |
|---|---|
delay (任意) |
0≥に違いない。 分析ウィンドウを評価タイムスタンプから後ろにずらします。
SourceLateness.settling_delayを使って、ストリーム内のソース到着遅延の一貫したベースラインをモデル化しましょう。 |
window_duration |
> 0 にする必要があります |
start_time (任意) |
特徴が出力を発出できる最も早い事象時間境界。 |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
以下のコードを使用して、遅延を伴うローリング ウィンドウを定義します。
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
ローリング ウィンドウの例
window_duration=timedelta(days=7): 現在の評価時間で終了する 7 日間のルックバック ウィンドウが作成されます。 7 日目の午後 2:00 のイベントの場合、これには、0 日目の午後 2 時から 7 日目の午後 2:00 までのすべてのイベントが含まれます。window_duration=timedelta(hours=1), delay=timedelta(minutes=30): 評価時間の 30 分前に終了する 1 時間のルックバック ウィンドウが作成されます。 午後 3 時 00 分のイベントの場合、これには午後 1 時 30 分から午後 2 時 30 分までの (ただし含まない) すべてのイベントが含まれます。
Lastを使えば、最新の価値の新鮮さをバインディングしましょう
LastとRollingWindowを組み合わせて、最新の値は一定期間有効です。 評価時に、特徴はこの区間内の最新のタイムスタンプを持つ行の値を返します:
[evaluation_time - delay - window_duration, evaluation_time - delay)
区間の最新の行にnull値がある場合、特徴はnullを返します。 null入力値を除外したい場合は、ソースに filter_condition を設定してください。
この組み合わせは ColumnSelectionとは異なります。
ColumnSelection 年齢に基づいて期限切れを切らずに、最新の観測された非null値を返します。
バッチフィーチャーには、この組み合わせにはオンライン専用の特別なマニマルライゼーションモードがあります。 対応は DeltaTableSource、 Last、 RollingWindow、 TableTriggerのみです。 「 Materialize」の鮮度制限の最新値をご参照ください。
タンブリングウィンドウ
タンブリング ウィンドウを使用して定義された機能の場合、集計は、定められた固定長ウィンドウで計算され、ウィンドウはスライド間隔によって進み、非重複となる時間の完全パーティションを生成します。 その結果、ソース内の各イベントは、1 つのウィンドウに正確に影響します。 時間 t 機能は、 t 以前に終了するウィンドウからのデータを集計します (排他的)。 Windows は Unix エポックから開始します。
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、タンブリング ウィンドウのパラメーターを示します。
| パラメーター | Constraints |
|---|---|
window_duration |
> 0 にする必要があります |
delay (任意) |
0≥に違いない。 分析ウィンドウを評価タイムスタンプから後ろにずらします。 |
offset (任意) |
≥0で window_durationより短い必要があります。 UTCの真夜中から境界がシフトされます。 |
start_time (任意) |
特徴が出力を発出できる最も早い事象時間境界。 |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
タンブリング ウィンドウの例
-
window_duration=timedelta(days=5):これにより、事前に決定された固定長ウィンドウが 5 日ごとに作成されます。 例: ウィンドウ #1 は 0 日目から 4 日目まで、ウィンドウ #2 は 5 日目から 9 日目まで、ウィンドウ #3 は 10 日目から 14 日目までです。 Window #1 には、0 日目の00:00:00.00から始まるイベントで、5 日目の00:00:00.00を含まないすべてのイベントが含まれます。 各イベントは、1 つのウィンドウに属します。
スライディング ウィンドウ
スライディングウィンドウで定義された特徴については、スライド間隔で進むウィンドウ上で集約計算されます。 スライディングウィンドウは固定時間または生涯持続時間のいずれかを持ちます。 固定期間のウィンドウは重複するため、各ソースイベントが複数のウィンドウのフィーチャー集約に寄与できます。 ライフタイムウィンドウには、ウィンドウ終了前のすべてのソースイベントが含まれます。 時間 t 機能は、 t 以前に終了するウィンドウからのデータを集計します (排他的)。 WindowsはUnix時代に合わせています。
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
次の表に、スライディング ウィンドウのパラメーターを示します。
| パラメーター | Constraints |
|---|---|
window_duration |
一定期間のウィンドウなら正でなければなりません。 生涯のウィンドウで None に設定。 |
slide_duration |
正である必要があります。 固定期間のウィンドウは window_durationよりも短くなければなりません。 |
delay (任意) |
0≥に違いない。 分析ウィンドウを評価タイムスタンプから後ろにずらします。 |
offset (任意) |
≥0で slide_durationより短い必要があります。 UTCの真夜中から境界がシフトされます。 |
start_time (任意) |
特徴が出力を発出できる最も早い事象時間境界。 |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
スライディング ウィンドウの例
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1):これにより、毎回 1 日進む 5 日間のウィンドウが重なって作成されます。 例: Window #1 は 0 日目から 4 日目まで、Window #2 は 1 日目から 5 日目まで、Window #3 は 2 日目から 6 日目までです。 各ウィンドウには、開始日の00:00:00.00から、終了日に00:00:00.00までのイベントが含まれます (含まれません)。 ウィンドウは重なっているため、1 つのイベントが複数のウィンドウに属している可能性があります (この例では、各イベントは最大 5 つの異なるウィンドウに属しています)。
生涯の窓
window_duration=Noneを生涯ウィンドウ作成に設定してください。 各スライド境界で、特徴はその境界より前のタイムスタンプを持つエンティティのすべてのソースイベントを集約します。 例えば、1日のスライドは1日1回の累積値を生成します。
ライフタイムウィンドウは SlidingWindowのみがサポートしています。
RollingWindow そして TumblingWindow 有限の window_durationを必要とします。
Note
ライフタイムウィンドウは、window_duration=Noneやワークスペースの有効化をサポートするdatabricks-feature-engineeringクライアントバージョンが必要です。 以前のクライアントバージョンではこの構文はサポートされていません。
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
ノコギリガラス窓
ソートゥースウィンドウは、最近の出来事の非常に新しい更新や、過去データの日々の圧縮をサポートする集約です。 その後ろ(古い)エッジは固定された日々のステップで進み、前方(最近)のエッジは最新のイベントに合わせて更新されるため、実効的なウィンドウ長は1日を通して「ソー」と動く。 ウィンドウの大部分はストリームの取り込みテーブルのデータから提供されており、ライブストリームからの直近の2日のみが提供されます。 これは、長期間のウィンドウ(数年までスケーリング)を効率的に計算しつつ、新しいアップデートにも対応できる妥協案です。
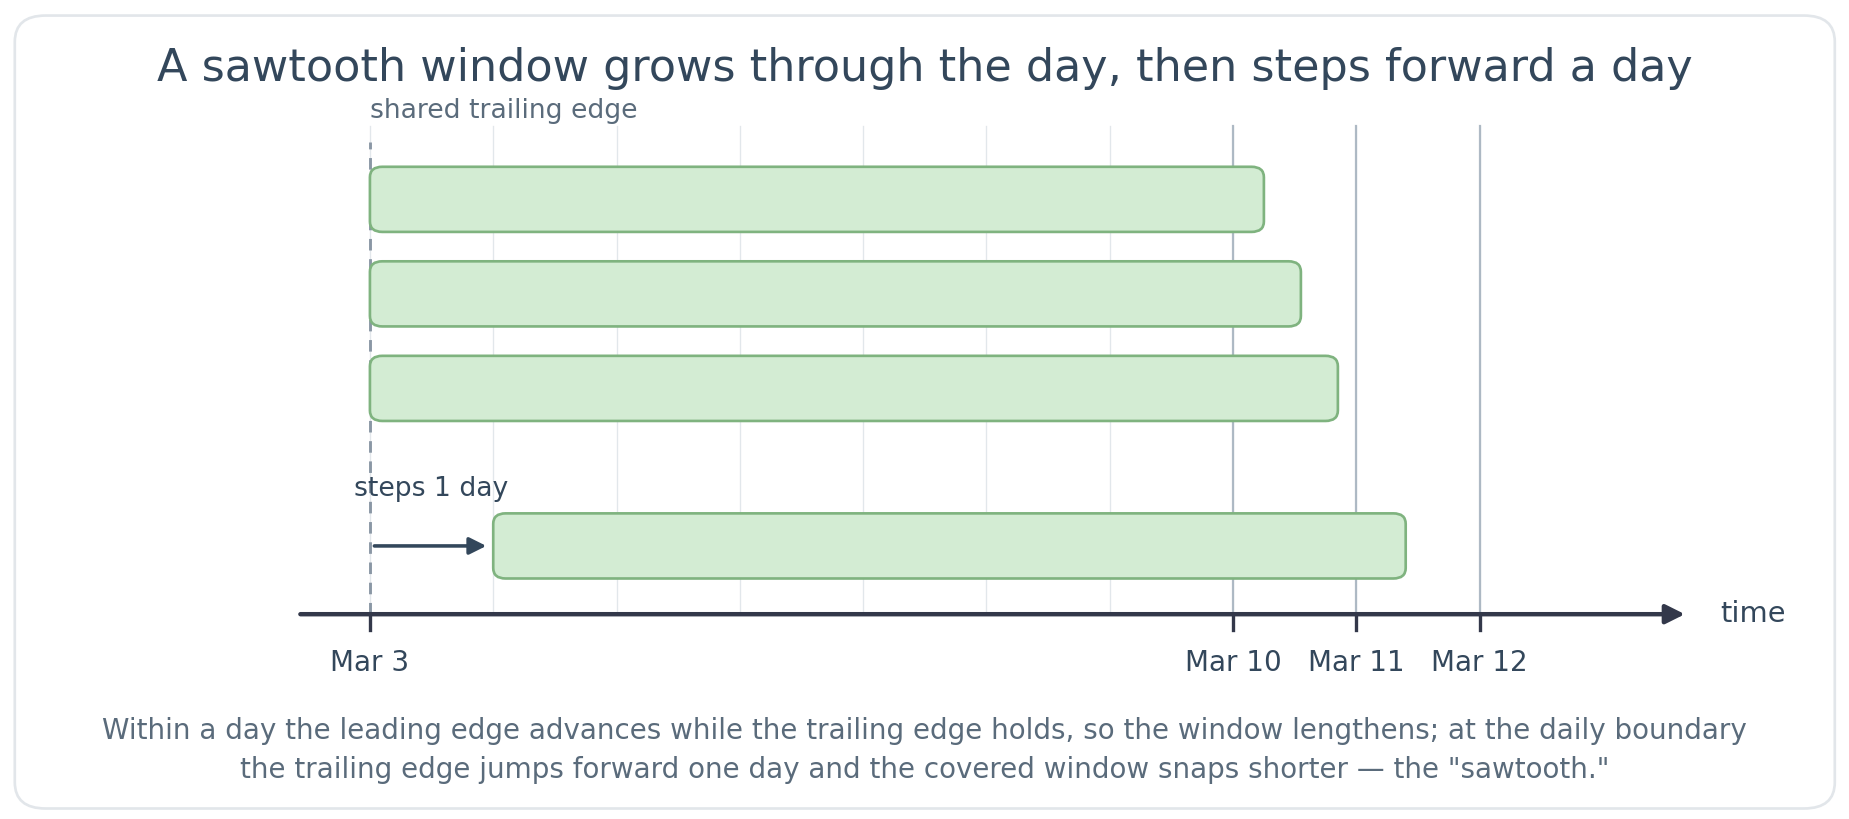
ソートゥーウィンドウはハイブリッドバッチおよびストリーミングパスで物質化されます。 バッチパイプラインはウィンドウの大部分を維持し、ストリーミングパイプラインは最新のデータをリアルタイムで新鮮に保ちます。 この2つは読み取り時に統合されるため、モデルやサービス消費者にとっては単一の機能として扱われます。
ウィンドウの過去部分はバッチパイプラインによって計算されるため、数ヶ月や数年にまたがるウィンドウでも、マテリアル化が始まってすぐにソートゥース特徴が提供されます。 ローリングウィンドウは、その全ウィンドウ期間が経過して初めて完成します。 最低の通 window_duration は2日以上でなければなりません(強制される下限)。 Databricksは7日以上の期間にはソートゥースウィンドウを推奨しています。 2日以上、最大7日間の窓については、 ロールウィンドウ の固定長の精度と、鋸歯ガラスの迅速な生産準備のどちらかを選びましょう。
Note
ノコギリ型の特徴は、すでに存在する歴史に基づいています。 ストリームのインジェスションテーブルには、少なくとも全ウィンドウ期間をカバーするデータが含まれていなければ、計算されたウィンドウは不完全となります。 2日経過しないうちに、この特徴はこれまでに取得したデータのみを反映します。 制作中に機能を提供するのは、2日間経過するまで推奨されません。 空のウィンドウ上の集約は、 Sum と Countで0、 Avg、 Min、 Max、 First、 Last、 VarPop、 VarSamp、 StddevPop、 StddevSampに対してはnullを返します。
ノコギリ型機能が準備完了かどうかを確認するには、カタログエクスプローラーの機能ビューを開きます。 Materialized featuresセクションでは、Featureの最終物質化時間が進み、その状態が成功したと表示されるとバッチバックフィルは完了します。 ストリーミング部分はLakeflow宣言型パイプラインによって実現されています。 フィーチャービューが検証を通過した後、マテリアル化されたフィーチャーはそのパイプラインにリンクし、実行状況を監視できます。
ノコギリガラスは StreamSource が必要で、 StreamingModeで具現化されます。
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
ノコギリ型窓の端はローリングウィンドウとは異なる動きをします。先端は最新の事象を追い、後端は連続せず1日に1回進みます。 毎日固定された18:00 UTCカットオフで、トレーリングエッジはその日のUTCから深夜0時までの境界まで前に進みます。 その結果、有効ウィンドウは1 window_duration よりやや長くなり、1日を通して成長し、次のカットオフで1日戻ってきます。 訓練とサービスは同じ18:00 UTCの締め切りを使っているため、オフライントレーニングとオンラインサービスは一貫しています。
| パラメーター | Constraints |
|---|---|
window_duration |
2日以上は必要だ。 整数日数ではない期間(例えば timedelta(days=3, minutes=15)日)も許可されていますが、ウィンドウは日単位で更新されます。 |
ソートゥーウィンドウは、 Sum、 Avg、 Count、 Min、 Max、 First、 Last、 VarPop、 VarSamp、 StddevPop、 StddevSamp集約機能をサポートします。
ノコギリガラスの例
以下の例は、ユーザーの取引の7日間のカウントを示しています。 先端は現在の出来事を追い、後端は一日ずつ前進していきます。 3月10日のイベントについては、その期間は3月3日頃まで遡ります。 3月10日が進むにつれて、先端は前進し続け、後縁は保持されるため、覆われたスパンは拡大します。 そして3月11日の初めには、後縁が3月4日頃まで動きます。 有効な期間は常に7日より少し長く設定されています。 直近の2日はライブストリームから配信され、それ以前の日はストリームのインジェストテーブルから配信されます。
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
ノコギリ窓の制限
-
delayパラメーターはサポートされていません。 -
SourceLateness.settling_delayはサポートされません。 -
Sum、Avg、Count、Min、Max、First、Last、VarPop、VarSamp、StddevPop、StddevSamp以外の集約関数(例:ApproxCountDistinct、ApproxPercentile、FirstN、LastN、FirstDistinct、LastDistinct)はサポートされていません。 - ノコギリガラスには
StreamSourceが必要です。DeltaTableSourceはサポートされていません。
具体化トリガー
具体化パイプラインを実行するタイミングを制御します。 トリガーの種類は、機能の種類によって異なります。
CronSchedule
バッチ集約機能には CronSchedule を使いましょう。 デフォルトでは、Azure Databricksはアグリゲーションウィンドウからスケジュールを派生します。 派生スケジュールはウィンドウ期間、ウィンドウ delay と offset、ソース settling_delay を考慮し、実行がソースデータが完了する前にウィンドウを公開しないようにします。 派生スケジュールはタンブルウィンドウやスライドウィンドウをサポートしています。
派生スケジュールを要求するには、cron式を省略してください。
CronSchedule() および明示的な CronSchedule(mode=CronScheduleMode.DERIVED) 形は同値です:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
CronScheduleMode.DERIVEDでquartz_cron_expressionを設定しないでください。 マテリアル化された特徴を取得すると、返されたスケジュールにはAzure Databricksが計算したcron式を含めることができます。
スケジュールを直接制御するには、Quartz cron式を提供します。
CronScheduleMode.MANUAL 次の式を用意すると推論されます:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
TableTriggerはColumnSelection特徴や集約機能(AggregationFunction)にDeltaTableSourceを裏付けて使います。 パイプラインは、アップストリームの Delta テーブルが新しいコミットを受信するたびに実行されます。
アグリゲーション機能の場合、パイプラインはスロットルされているため、すべてのコミットで実行されません。 パイプラインはフィーチャーのウィンドウ長の半分に1回最大で1回しか動作しませんが、5分ごとにそれ以上は回りません。 例えば、1時間の時間の連続時間を持つ映画は最大で30分に1回、8時間の時間の時間を持つ映画は最大で4時間に1回しか放送されません。 5分フロアは、ウィンドウの半分がそれより小さい場合に適用されます。つまり、10分以下のウィンドウは最大でも5分に1回しか実行されません。 5分未満のアグリゲーション機能は TableTriggerを使えず、代わりにストリーミングトリガーを使います。
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
StreamingModeによってサポートされる機能には、StreamSourceを使用します。 パイプラインは、継続的ストリーミング パイプラインとして実行されます。
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
トリガーの選択
各機能は1つのトリガーを使用します。機能タイプごとのオプションは以下の通りです:
| 機能の種類 | Trigger | 実行時 |
|---|---|---|
集計 (AggregationFunction) DeltaTableSource |
CronSchedule |
派生または手動スケジュールで |
集計 (AggregationFunction) DeltaTableSource |
TableTrigger |
ソース テーブルのコミットごとに |
ColumnSelection ( DeltaTableSourceから) |
TableTrigger |
ソース テーブルのコミットごとに |
の機能 StreamSource |
StreamingMode |
継続的ストリーミング |
1 回の materialize_features 呼び出しで異なるトリガーの種類を必要とする機能を具体化することはできません。 代わりに個別の呼び出しを発行します。