この記事では、LLM を利用するワークロードを 1 つの基本モデルから別のベース モデルに移行するための 6 段階のプロセスについて説明します。各フェーズで考慮すべき事項、Microsoft Foundry の機能が適用されます。また、さまざまな種類のチームで作業がどのように変化するかについて説明します。
モデル移行の意味
運用環境で実行するすべてのモデルには提供終了日があります。 依存しているモデルが置き換えられた場合、または新しいモデルがワークロードにより適切に機能する場合は、移行します。 モデルのスワップは 1 行の変更ではありません。別のモデルは、トーン、書式設定、JSON の形状、待機時間、コスト、またはツール呼び出しの動作を静かにシフトし、古い動作に依存するダウンストリーム コードを中断することができます。
移行が成功すると、アプリケーションの動作が維持されるか、測定可能な方法で改善されます。 成功するには、広範なロールアウトの前にドリフトを検出し、安全に適応し、品質を証明する反復可能なプロセスが必要です。
移行するタイミング
通常、移行は次の 4 つの理由のいずれかで開始されます。
- モデルは提供終了となります。 Foundry では、一般提供されているすべてのモデルに提供終了日が設定されており、旧世代のモデルファミリーは時間の経過とともに置き換えられます。 提供終了ポリシーと日付については、Foundry Models のライフサイクルとサポート ポリシーとモデルの提供終了スケジュールを参照してください。
- より優れたモデルを使用できます。 新しいモデルでは、高品質、低コスト、待機時間の短縮、またはワークロードに必要な機能 (構造化された出力やツール呼び出しの改善など) が提供されます。
- コストまたは待機時間の問題により、変更が強制されます。 現在のモデルの待機時間またはユニット コストは、ニーズを満たしなくなりました。
- 機能ギャップによって製品がブロックされます。 現在のモデルでは、製品に必要な処理を行うことはできません。
廃止日に何が起こるか
モデルが廃止される際に Azure がどう対応するかは、容量をどのように購入しているかによって異なり、Foundry ではそれぞれの方式について異なる用語を使用します。
-
Standard、Global Standard、Data Zone Standard (従量課金制) のデプロイは、リージョンごとにローリング スケジュールに従って 自動アップグレード されます。
versionUpgradeOptionをOnceNewDefaultVersionAvailable、OnceCurrentVersionExpired、またはNoAutoUpgradeのいずれかに設定することで、タイミングを制御できます(これは、デプロイメントが廃止時に機能しなくなることを意味します)。 優先度処理は同じパスに従います。 - Provisioned(PTU)デプロイは自動アップグレードされません。 イン プレース (トラフィックはダウンタイムなしで 20 ~ 30 分の時間枠で移動) または サイド バイ サイド (新しいデプロイの立ち上げ、テスト、トラフィックのシフト、古いデプロイの削除) のいずれかを自分で移行します。
- バッチ デプロイは、サイド バイ サイド パスに従います。新しいモデルをデプロイし、ジョブを再送信し、古いデプロイを廃止します。
どのパスが適用されても、開発者の課題は同じです。設定された日に、トラフィックは別のモデルにヒットし始めます。 それでも応答するエンドポイントは、アプリが正しく動作することを意味するわけではないため、自動アップグレードと手動移行の両方のワークロードで、この記事で説明する評価と検証の恩恵を受けることができます。
提供終了日より前に移行する
自動アップグレードは、移行計画ではなく、従量課金制デプロイのセーフティ ネットにすぎません。 プロビジョニングされたデプロイには、セーフティ ネットはありません。 どちらにしても、移行計画に代わるものではありません。 次の 2 つのポリシー コミットメントを使用すると、期限を待つ代わりに、独自のスケジュールで移行する余地があります。
- 交換モデルは、Global Standard での提供終了の約 90 日前 、および前身が廃止されるプロビジョニング済みリージョンでの提供終了の約 30 日前 に利用可能になります。 このウィンドウを使用して、新しいモデルを評価し、手動で移行します。
- 提供終了日は延長できるものではありません。 例外プロセスがないため、計画していない日付が適用されます。
始めるのに非推奨通知は必要ありません。 新しいモデルが安価、高速、またはより多くの能力がある場合は、今すぐプロセスを実行します。 計画的に移行することで、廃止日は単なる形式上のものになります。 移行が繰り返されるため、プロセスを反復可能にする価値があります。
移行プロセスを使用すべきユーザー
移行プロセスは、チームが大規模な製品またはプラットフォーム内に LLM を利用する機能を構築し、約四半期ごとに移行し、各移行を意図的に実行する明確な所有者 (中央プラットフォーム チームやアプリ チームなど) を持っている場合に最適です。
このプロセスは、モデルが製品である AI ネイティブ チームにも適合します。 フェーズは同じですが、厳密な順序ではなく、高速で並列に実行されることがよくあります。
このプロセスでは、基本モデル間を移動していることを前提としています。つまり、重みレベルのカスタマイズを行わずに、モデル カタログに発行されたモデルとしてデプロイします。 微調整されたワークロードは範囲外です。 それぞれ独自の学習およびデプロイの提供終了までのタイムラインを持っているため、自動アップグレードはできません。 微調整済みのワークロードに対応させるには、プロンプトやスキーマを変更するのではなく、知識蒸留または再学習が必要になります。 微調整されたデプロイを実行する場合は、早期に交換ベース モデルに対して再調整することを計画してください。
移行フェーズ
移行は 6 つのフェーズに分けられます。 各フェーズでは、次のフェーズで使用される出力が生成されます。 移行フェーズは次のとおりです。
発見 → 評価 → 適用 → 検証 → 展開 → 廃止
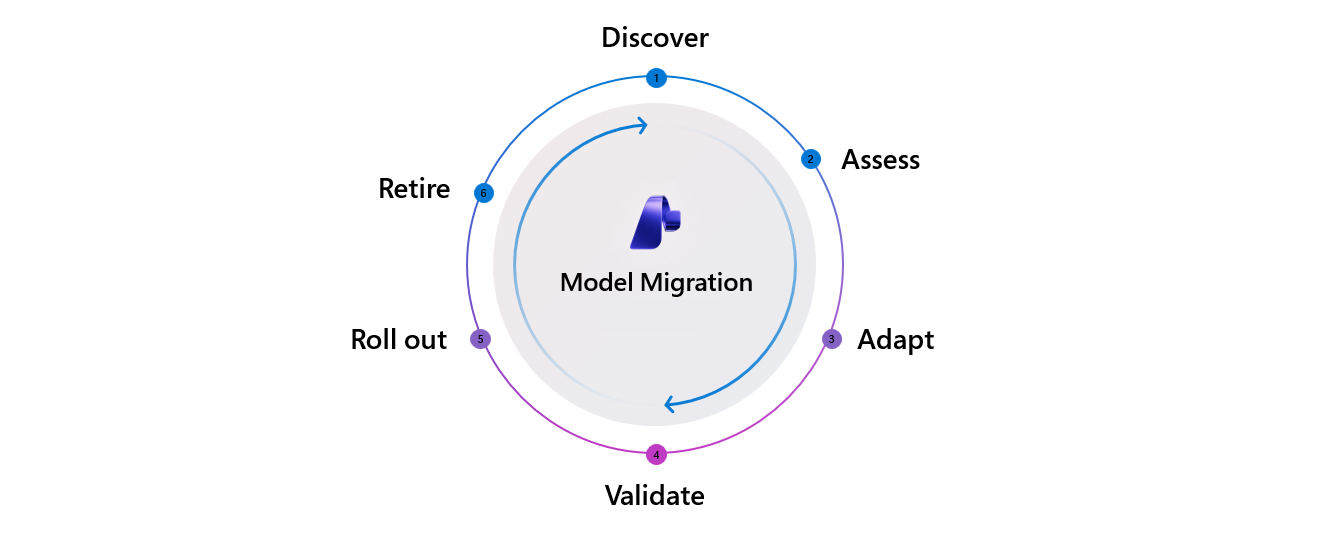
次の表では、各フェーズと、それをサポートする Foundry の機能とツールについて説明します。 Foundry と Microsoft Azure OpenAI の両方で機能を使用できます。Foundry のみがマークされていない限り、Azure OpenAI には同等の機能はありません。
この記事の後半のフェーズごとのセクションでは、各フェーズが存在する理由、成功した結果の概要、考慮すべき事項、各機能を使用するタイミング、およびフェーズが一般的に中断される場所について説明します。
| Phase | Description | 機能とツール |
|---|---|---|
| 発見 | モデルの変更が来ているか必要かを学習し、動作するかどうかを決定します。 |
|
| 評価する | ターゲット モデルを選択し、運用可能であることを確認します。 |
|
| 順応 | 新しいモデルで現在のワークロードを再生し、動作の変更を診断し、プロンプト、パラメーター、ツール定義、出力スキーマ、およびそれらの周囲の呼び出し元コードを再設計します。 |
|
| 検証 | 適合したワークロードを品質ルーブリックに対してスコア付けして、発送しても安全かどうかを判断します。 |
|
| ロールアウト | 段階的に公開しながら本番環境に昇格し、本番環境での動作を監視して、コミットまたはロールバックします。 |
|
| 廃止 | 古いデプロイを廃止し、容量を確保し、評価結果をアーカイブし、ダウンストリームのドキュメントを更新してください。 |
移行する前に: テスト データセットを準備する
この準備手順では、移行作業が開始される前に、代表的な入力、予想される出力、合意された成功基準のセットを組み立てます。 この一式は、プロセス中盤におけるゲーティング依存関係です。入力がなければ Adapt フェーズでリプレイを実行できず、グラウンド トゥルースと評価基準がなければ、Validate フェーズでスコアリングを実行できません。
考慮事項
- ターゲットを選択する前にデータセットをビルドします。 データセットは候補モデルではなく ワークロードを記述するため、Discover と並行して組み立てることができます。
- 実際のソースまたは合成ソースから入力を収集します。 キャプチャされた運用トラフィックまたはキュレーションされたドメインの例を CSV または JSONL として使用します。 代表的なデータがまだない場合は、シミュレーターを使用して合成入力と敵対的入力を生成 します。
- 必要な前にインストルメントキャプチャを行います。 運用コンテンツ キャプチャはオプトインされ、さかのぼって行われることはありません。そのため、記録しなかったトラフィックを評価することはできません。 プロンプト、応答、待機時間、トークン数のログ記録を今すぐ開始します。
- データセットを固定します。 入力、正解データ、成功基準は移行全体を通して固定します。 いずれかが変更された場合、ソースとターゲットの結果を比較できなくなります。
また、デプロイの種類 (Standard、Provisioned、Batch) など、ワークロードで使用されるモデル デプロイのインベントリも必要です。 ソース モデルごとに、提供終了日と、モデル提供終了スケジュールからの推奨される置換をメモ します。
フェーズ 1: 検出
検出フェーズの目的は、モデルの変更が来ているか価値があるかを認識し、行動するかどうかを決定することです。出力は go/no-go の決定であり、現在のモデルに留まることが有効な選択肢です。 望ましい成果とは、非推奨となる日付、後継モデル、移行期間を早い段階で整理して示すシグナル、あるいは現在のモデルを使い続けるという意図的な判断です。
考慮事項
- 提供終了日と実際のランウェイの数はどのくらいですか? 廃止日から検証とロールアウトの時間を差し引いた日付を実際の期限として扱います。
- 置換候補の名前が付いているか、または自分で候補をリストに登録する必要がありますか?
- この変更には、コンプライアンスやリージョンの制約 (規制されたワークロード、可用性、認定に関しては、品質よりも前に重要であることが多い) が含まれますか?
一般的に中断される場所
各チームは、メール、ポータルのバナー、または社内メッセージを通じて廃止の情報を一貫性なく受け取り、その兆候に気づくのが遅れます。 この遅延により、既にタイトなウィンドウが短縮されます。 ソロ開発者や小規模なチームは、多くの場合、発表ではなく、運用エラーからの提供終了を発見します。
ご持参いただくもの
提供終了スケジュールと Models API は、安定したコントラクトでデータを公開します。 成熟した組織は、適切な所有者にルーティングするために、上に薄い内部通知レイヤーを追加します。
フェーズ 2: 評価
評価フェーズの目的は、候補のターゲット モデルを選択し、適切なリージョン、適切なデプロイの種類、十分なクォータ、および可用性を現在のモデルと共に実行できることを確認して、ロールバックを可能にすることです。 成功した結果は、チューニングを開始する前にリージョン、SKU、クォータ、コストが確認された、候補モデルの中から明確に選択することです。
考慮事項
- 候補間の品質と位置付け。 複数のモデルが進行中の場合は、パブリック ベンチマークで最も高いスコアだけでなく、ワークロード に適した モデルを品質に合わせて決定します。
- 自分のトラフィックに対するコスト。 価格構造は、モデルの世代間で変化します。 トークン、キャッシュされた入力、構造化出力のオーバーヘッドを推論すると、ユニットの経済性が 2 倍以上増加する可能性があるため、表示価格だけでなく、履歴トラフィックに対する毎月のコストを計画します。
- 運用上の可用性。 リージョン、SKU、クォータを確認し、ロールバック パスを維持できるようにターゲットをソースと並行して実行できることを確認します。
- コンプライアンス上のゲート。 規制対象のワークロードでは、品質が検討対象になる前に、認証やリージョンでの提供状況によって候補リストを絞り込めます。
一般的に中断される場所
複数の候補の位置づけが不明確だと、選択麻痺に陥ります。 Teams は、選択したモデルがリージョンまたは SKU で使用できないことを計画中にのみ検出します。 または、コスト予測では、新しいモデルの方が実際のトラフィックに対して大幅にコストがかかることが明らかになります。
ご持参いただくもの
ベンチマークは公開データセットで算出されるため、リーダーボードはゴールではなくフィルターとして捉え、自分のワークロードで最終候補を検証してください。 コストプロジェクションは同じストーリーです。毎月のビューは、トラフィック データを取得すると簡単な独自のトークン ログから取得されます。
フェーズ 3: 適応
適応フェーズの目的は、新しいモデルでワークロードを適切に動作させることです。 既存のワークロードを最初に変更せずに再生し (モデル駆動型の動作の変更を分離するために)、変化した内容を診断してから、繰り返しリエンジニアリングします。 成功した結果は、実際のトラフィックまたは代表的なトラフィックと並べて動作を比較し、すべての変更を追跡することです。
適応はプロンプト編集以上のもの
プロンプトは最も目に見える面ですが、通常、移行は他の 4 つの画面に触れます。
-
Parameters.
temperature、top_p、max_tokens、および推論作業の制御では、世代間で 1 対 1 のマッピングが行われず、新しいモデル ファミリでは一部のパラメーターがサポートされない可能性があります。 - ツール定義。 古いモデルを確実にガイドする引数の名前、説明、および必須フィールドの言い換えや強化が必要になる場合があります。
- 出力スキーマ。 モデルは、構造化された出力に準拠する方法が異なります。 古いモデルが緩やかに満たしたスキーマに明示的な制約を追加する必要がある場合や、最終的にスキーマを適用できる場合があります。
- コードの呼び出し。 API サーフェスと SDK の違い (チャットの完了と応答、ストリーミングの形状、新しい要求フィールドまたは名前が変更された要求フィールド)。 また、古い応答の形状を想定したダウンストリーム解析を更新する必要がある場合もあります。
エージェントワークロードとワークフローワークロードの場合、スキーマとツール呼び出しの作業はプロンプト作業よりも多くの場合、上回ります。
考慮事項
- チューニングする前に変更せずに再生します。 ターゲット モデルで現在の構成を変更せずに実行します。 このアプローチは、 モデル が変更した動作 と導入した 変更を分離するのに役立ち、ベースラインを提供します。
- 実際に変化するものを見てください。 詳細度、推論の深さ、構造化された出力の準拠、ツール呼び出しの形状、拒否動作、待機時間の差異はすべて一般的に変化します。
- 実際のトレースを再生して、ツール呼び出しの回帰をキャッチします。 フィールドの追加、引数の名前変更、シーケンス処理の変更は、シングルターン ベンチマークではなく、実際のトレースでのみ行われます。
- 変更を追跡します。 迅速な再エンジニアリングは簡単に行い、失うのが簡単です。 元の内容を保持し、変更内容とその理由を記録します。
Foundry の機能
次の 3 つの Foundry 機能がこのフェーズをサポートします。
- プロンプト オプティマイザー は、エージェントプレイグラウンドのシステム命令フィールドのすぐ下にある [最適化 ] ボタンです。 プロンプト エンジニアリングのベスト プラクティスを使用して手順を再構築し、各変更の段落ごとの推論を示し、反復ループをサポートします。 "JSON スキーマを正確に保持する" などの提案を追加し、再最適化します。 Foundry でのみ利用可能で、Azure OpenAI では利用できません。
- エージェントの最適化 により、エージェントワークロードの指示、ツール、モデルの選択が調整されます。 Foundry でのみ利用可能で、Azure OpenAI では利用できません。
- シミュレーター は、再生する運用データがない場合に合成入力と敵対的入力を生成します。
一般的に中断される場所
組み込みの製品向けワークロードの場合、診断ループは手動であるため、通常、このフェーズは最も時間がかかります。チームはプロンプトを再実行し、違いを比較し、変更内容や理由を記録することはほとんどありません。
ご持参いただくもの
- オプティマイザーから始めて、確認します。 データセットに適合するのではなく、1 回のパスで 一般的な ベスト プラクティスを適用し、ツール定義や出力スキーマではなく命令テキストを調整します。 出力を強力な下書きとして扱います。最初に元のプロンプトをコピーし (バージョン履歴はありません)、変更を信頼する前に、固定されたデータセットに対して再評価します。
- 家族間の移動のための追加の実践的な作業を計画します。 "ターゲット モデル X に対する最適化" フローはないため、モデル ファミリ間の移動には、意図的なプロンプトとスキーマ変換が必要です。
- 必要な前にトラフィックを記録します。 リプレイの品質はキャプチャの品質次第であり、コンテンツのキャプチャはオプトイン方式で、過去に遡って適用されることはありません。
フェーズ 4: 検証
検証フェーズの目的は、調整されたワークロードを、キュレーションされたデータセット上の品質ルーブリックに対してスコア付けすることで、出荷しても安全かどうかを判断することです。 ルーブリックは、ルールベース、参照ベース、LLM-as-judge、human review、またはドメイン固有のフレームワークにすることができます。 成功した結果は、アプリ チームとレビュー担当者の両方が信じる信頼できる評価スイートを提供し、凍結されたデータセットで実行することです。
Validate は 1 つのフェーズですが、2 つのタッチポイントがあるため、単一の行末イベントとして扱わないようにしてください。
- 早めに準備します。 [ 移行する前に、適応する前に] でデータセットと成功条件を固定します。 それらに変更が加わった瞬間に、ソースとターゲットは比較できなくなります。
- 2 回に分けて、後段でゲートします。 まず、固定セットで現在のモデルを実行して、 ソース ベースライン (ビートする必要がある数) を確立します。 次に、同じセットで ターゲット にスコアを付け、決定します。
考慮事項
- データセットと条件は固定したままにしておきます。 これは、結果を同等に保つためのプロセスで最も重要な規範です。
- サインオフの判断に対応する 3 つの指標を測定します: 品質(評価者またはレビュアーのスコア)、待機時間(移行対象の呼び出しに限定した、最初のトークンが生成されるまでの時間とスループット)、およびコスト(リクエストあたりの入力トークンと出力トークンのコスト)。
- ルーブリックをワークロードと一致させます。 臨床要約のためのルーブリック、エージェント向けのツール呼び出し順序に関するアサーション、あるいは既存のユーザーフィードバック信号のほうが、汎用的なスコアよりも有意義である場合があります。
- ゲートを AI ネイティブ チームのシグナルとして扱います。 評価は、1 回限りの成功/失敗ではなく、すべてのコミットで継続的に実行され、ロールアウトと融合します。
Foundry の機能
このフェーズは、次の 2 つの Foundry 機能でサポートされています。
- Azure AI Evaluation SDK には、根拠、関連性、取得、一貫性、流暢さ、参照ベースのメトリック (F1、BLEU、および ROUGE)、安全性、エージェント、Azure OpenAI の採点者をカバーする、30 を超える組み込みのエバリュエーターが含まれています。 また、タスク固有のルーブリックに対応した、審判役として用いるカスタムLLMも含まれています。
- ポータルの評価 では、モデル、エージェント、データセット、トレースターゲットに対して同じエバリュエーターが実行されます。
固定データセットのソースとターゲットの 両方 に対して同じエバリュエーターのセットを実行して、数値が同等になるようにします。
| ディメンション | 測定対象 | Where |
|---|---|---|
| Quality | ソースとターゲットのエバリュエーター スコア | Azure AI Evaluation SDK、ポータルの評価 |
| Latency | 初回トークン生成時間とスループット | ベンチマーク ランキング、運用メトリック |
| Cost | 要求あたりの入力トークンと出力トークンのコスト | 評価出力、モデルの価格 |
一般的に中断される場所
ほとんどのチームには評価スイートがなく、多くの場合、自分で構築します。 規制されたワークロードの場合、必須の人間または品質管理のレビューが上位にあり 、ボトルネックになります 。 これらの移行は、Adapt ではなく Validate で停止します。
ご持参いただくもの
エバリュエーターは実行する準備ができていますが、独自の運用トラフィックからドメイン関連のテスト セット を キュレーションすることは、モデル (エージェント以外) ワークロードのハンズオン作業です。 この必要性こそが、準備ステップに十分な価値がある理由です。
フェーズ 5: ロールアウト
このフェーズの目的は、検証済みの構成を段階的に本番環境へ反映することです。まず非本番環境で適用し、次にカナリアリリースまたは一定割合への重み付き展開を行い、その後、より広範囲に展開します。 全期間を通じて、リアルタイムのレイテンシ、エラー、そして可能であれば移行前のベースラインと比較した品質を監視してください。 次に、コミットまたはロールバックします。 成功した結果は、カナリア トラフィック、重み付けトラフィック、シャドウ トラフィック、待機時間とエラーを超えたライブ品質信号、および保持されたロールバック パスを介した段階的な露出です。
考慮事項
- デプロイの種類を把握します。 デプロイの種類によってメカニズムが決まります。Standard ファミリのデプロイでは、制御するスケジュールに従って自動アップグレードできます。 プロビジョニング済み、バッチ、およびファインチューニング済みのデプロイは、手動で移行する必要があります。 次の表は、種類ごとのメカニズムを示しています。
- ロールバック コリドーを保持します。 確信が持てるまで、古いデプロイにアクセスできる状態を維持してください。 証拠ではなく廃止期限によって強制されたロールバックの決定は、開始が遅すぎる警告サインです。
- カナリアができない場合は、シャドウ モードまたはミラー モードを使用します。 規制されたフロー (PHI、金融トランザクション) では、多くの場合、新しいモデルを実際の顧客トラフィックに公開することはできません。 これに相当するものは、運用環境の入力で新しいモデルをオフラインで実行し、ユーザーに影響を与えずに出力を古いモデルと比較することです。
- オフライン評価で見逃したリグレッションがないか監視します。 実ユーザーの待機時間とエッジケースの動作は、運用環境の負荷の下でのみ発生する可能性があります。
デプロイの種類別の移行のしくみ
| 展開の種類 | 移行のアプローチ | Quota |
|---|---|---|
| 標準、グローバル標準、データ ゾーン標準 | 段階的なスケジュールに基づく自動アップグレード。
versionUpgradeOption (OnceNewDefaultVersionAvailable、OnceCurrentVersionExpired、またはNoAutoUpgrade) を使用してタイミングを制御します。 優先度処理は同じパスに従います。 |
自動引き継ぎ |
| プロビジョニング済み | 手動: インプレース (20 ー 30 分かけてトラフィックを移行) またはサイドバイサイド (新しいデプロイを作成し、トラフィックを切り替えて、古いデプロイを削除)。 | まずターゲット モデルのクォータを確認する |
| Batch | サイド バイ サイド: 新しいモデルをデプロイし、ジョブを再送信してから、古いデプロイを廃止します。 | ターゲットモデルのクォータを確保する |
| 微調整 (この記事の範囲外) | 自動アップグレードされません。トレーニング用とデプロイ用で、それぞれ別個の提供終了期限があります。 置き換え用のベースモデルへ再チューニングまたは蒸留を行います。 | ターゲットモデルのクォータを確保する |
トラフィック切り替え後は、継続的評価を構成し、Foundry Observability ダッシュボードで本番トラフィックの一定割合をサンプリングしてスコアリングできるようにします。さらに、根本原因分析のためにトレースと関連付け、品質が低下した場合は Azure Monitor でアラートを生成します。
一般的に中断される場所
オフライン評価が見逃した品質回帰は、運用環境の負荷の下に表示されます。 ロールバックの決定は、多くの場合、証拠ではなく廃止期限によって強制されます。これは、移行が遅すぎて開始された兆候です。
ご持参いただくもの
2 つのデプロイ間の重み付けルーティングは、独自のゲートウェイまたはアプリケーション レイヤーに実装されます。ロールバック コリドーは、ウィンドウの古いデプロイを暖かく保つための意図的な選択です (埋め込みチームは通常、約 30 日間必要です)。 どちらも一度設計し、すべての移行を再利用する価値があります。
フェーズ 6: 廃止
リタイア フェーズの目的は、古いデプロイを廃止し、容量を解放し、評価成果物をアーカイブするとともに、変更内容を顧客向けドキュメント、マーケティングページ、サポート ランブック、および保持が必要な監査ログなどの下流先に周知することです。 最後に、古いデプロイはなくなり、デプロイ数の傾向は減少し、レッスンは次のサイクルに移ります。
考慮事項
- 廃止は、単なるクリーンアップではなく、ガバナンスとして捉えるべきです。 規制対象のワークロードでは、保持義務により、アーティファクトを長年にわたって保存する必要がある場合があります。
- ソースが実際になくなったことを確認します。 古いバージョンが廃止されたことを確認してから、容量の消費を停止するようにデプロイを削除します。
- 得られた知見を次に生かす。 新しい運用トレースをゴールデン データセットに折り返して、 次 の移行が安価に開始されるようにします。
一般的に中断される場所
チームが廃止プロセスを省略することで、ゾンビ状態のデプロイメントが蓄積します。 積極的に廃止を進めないチームは、他チームよりもはるかに多くの稼働中デプロイを抱えており、その大半は過去の移行で生じた構造上の残骸です。 一般的なミスサブステップはコミュニケーションです。マーケティングと製品のドキュメントは、スワップ後も古いモデルを参照しています。
ご持参いただくもの
オブザーバビリティダッシュボードにはデプロイ数が減少傾向にあることが示されていますが、どのデプロイメントが依然として負荷を担っているかを見極めるのは、最終的にはチームの判断です。 廃止作業を単なる期待事項ではなく、明示的に追跡・管理するタスクにします。
移行がバイナリになることはほとんどありません
実際の移行は多くの場合、分割状態です。ワークロードの一部は新しいモデルで実行されますが、待機時間の影響を受けやすいパスまたはリスクの高いパスは古いパスに残ります。場合によっては数週間です。 古いモデルから新しいモデルへの単一の切り替えではなく、部分ロールアウトと部分ロールバックを計画します。 一般に、廃止はロールアウトから数週間、場合によっては数か月遅れることが多く、こうして残り続ける古いデプロイメントが、スプロールとして顕在化します。
関連するコンテンツ
- Foundry Models のライフサイクルとサポート ポリシーの廃止とサポートタイムラインについて理解する
- モデルの提供終了スケジュールで、提供終了日と後継モデルを確認する
- 廃止されたMicrosoft Foundry モデルで既に廃止された内容を確認する
- 候補モデルと モデル ベンチマークとランキングを比較する
- プロンプト オプティマイザーを使用してプロンプトを 最適化して、新しいモデルにプロンプトを調整する
- Foundry ポータルから評価を実行して切り替える前に品質を検証する
- 生成 AI の可観測性を使用して移行されたワークロードを監視する