メモ
Azure AI 検索は、Azure ポータル、REST API、およびAzure SDKから使用できます。 また、Foundry IQ は、エンタープライズ コンテンツを、Microsoft Foundry ポータルのエージェントの再利用可能なアクセス許可に対応したナレッジ ベースに変換するマネージド ナレッジ レイヤーです。
フルテキスト検索は、インデックスに格納されているプレーン テキストに一致する情報取得のアプローチです。 たとえば、クエリ文字列 "hotels in San Diego on the beach" を指定すると、検索エンジンはこれらの用語に基づいてトークン化された文字列を検索します。 スキャンをより効率的にするために、クエリ文字列は字句分析を受けます。すべての用語の大文字と小文字の区別が低く、"the" のようなストップ ワードが削除され、用語がプリミティブ ルート フォームに減ります。 一致する用語が見つかると、検索エンジンはドキュメントを取得し、関連性の順にランク付けして、上位の結果を返します。
クエリの実行は複雑な場合があります。 この記事は、Azure AI 検索でのフルテキスト検索のしくみをより深く理解する必要がある開発者を対象としています。 テキスト クエリの場合、Azure AI 検索はほとんどのシナリオで予想される結果をシームレスに提供しますが、場合によっては、何らかの方法で "オフ" と思われる結果が得られる場合があります。 このような状況では、Lucene クエリ実行の 4 つの段階 (クエリ解析、字句解析、ドキュメント照合、スコアリング) の背景を持つことで、目的の結果を生成するクエリ パラメーターまたはインデックス構成に対する特定の変更を特定できます。
メモ
Azure AI 検索では、フルテキスト検索に Apache Lucene を使用しますが、Lucene の統合は完全ではありません。 Lucene の機能を選択的に公開および拡張して、Azure AI 検索にとって重要なシナリオを実現します。
アーキテクチャの概要と図
クエリの実行には、次の 4 つのステージがあります。
- クエリの解析
- 字句解析
- ドキュメントの取得
- スコアリング
フルテキスト検索クエリは、クエリ テキストを解析して検索語句と演算子を抽出することから始まります。 速度と複雑さを選択できるように、2 つのパーサーがあります。 分析フェーズが次に、個々のクエリ用語が分割され、新しい形式に再構成される場合があります。 この手順は、潜在的な一致として考えられる対象をより広範にカバーするのに役立ちます。 次に、検索エンジンはインデックスをスキャンして、一致する用語を持つドキュメントを検索し、各一致をスコア付けします。 結果セットは、個々の一致するドキュメントに割り当てられた関連性スコアで並べ替えられます。 ランク付けされたリストの先頭にあるものは、呼び出し元のアプリケーションに返されます。
次の図は、検索要求の処理に使用されるコンポーネントを示しています。
Azure AI 検索 内の Lucene クエリ アーキテクチャ ダイアグラム
| 主要コンポーネント | 機能の説明 |
|---|---|
| クエリ パーサー | クエリ用語をクエリ演算子から分離し、検索エンジンに送信するクエリ構造 (クエリ ツリー) を作成します。 |
| アナライザー | クエリ用語に対して字句分析を実行します。 このプロセスには、クエリ用語の変換、削除、または展開が含まれる場合があります。 |
| インデックス | インデックス付きドキュメントから抽出された検索可能な用語を格納および整理するために使用される効率的なデータ構造。 |
| 検索エンジン | 逆インデックスの内容に基づいて、一致するドキュメントを取得およびスコア付けします。 |
検索要求の構造
検索要求は、結果セットで返される内容の完全な仕様です。 最も単純な形式では、任意の種類の条件を持たない空のクエリです。 より現実的な例には、パラメーター、いくつかのクエリ用語(おそらく特定のフィールドにスコープが設定されています)、場合によってはフィルター式と順序付けルールが含まれます。
次の例は、REST API を使用してAzure AI 検索に送信する検索要求です。
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
この要求の場合、検索エンジンは次の操作を実行します。
価格が 60 ドル以上 300 ドル未満のドキュメントを検索します。
クエリを実行します。 この例では、検索クエリは語句と用語で構成されています:
"Spacious, air-condition* +\"Ocean view\""(ユーザーは通常、句読点を入力しませんが、この例に含めることで、アナライザーがそれを処理する方法を説明できます)。このクエリの場合、検索エンジンは、"searchFields" で指定された説明フィールドとタイトル フィールドをスキャンして、
"Ocean view"を含むドキュメント、さらに"spacious"という用語、またはプレフィックス"air-condition"で始まる用語を検索します。 "searchMode" パラメーターは、用語が明示的に必要でない (+) 場合に、任意の用語 (既定) またはそのすべてを照合するために使用されます。特定の地域の場所に近接して結果のホテルのセットを並べ替え、呼び出し元のアプリケーションに結果を返します。
この記事の大部分は、 検索クエリの処理についてです: "Spacious, air-condition* +\"Ocean view\""。 フィルター処理と順序付けは範囲外です。 詳細については、 Search API リファレンス ドキュメントを参照してください。
ステージ 1: クエリの解析
説明したように、クエリ文字列は要求の最初の行です。
"search": "Spacious, air-condition* +\"Ocean view\"",
クエリ パーサーは、演算子 (例では * や + など) を検索用語から分離し、検索クエリをサポートされている型の サブクエリ に分解します。
- 単独の用語に対する用語クエリ(例えば "広々" など)
- 引用符で囲まれた用語のフレーズクエリ (オーシャン ビューなど)
-
プレフィックス検索": 語句 + プレフィックス演算子
*を検索 (air-condition など)
サポートされているクエリの種類の完全な一覧については、 Lucene クエリ構文に関するページを参照してください。
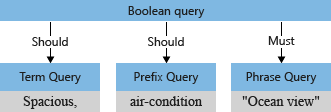
サブクエリに関連付けられている演算子は、ドキュメントが一致と見なされるために、クエリが "必須" か "満たす必要があるか" を決定します。 たとえば、+"Ocean view"演算子のため、+は "必須" です。
クエリ パーサーは、サブクエリを クエリ ツリー (クエリ を表す内部構造) に再構築し、検索エンジンに渡します。 クエリ解析の最初の段階では、クエリ ツリーは次のようになります。
サポートされているパーサー: Simple と Full Lucene
Azure AI 検索では、simple (既定値) と full という 2 つの異なるクエリ言語が公開されています。 検索要求で queryType パラメーターを設定すると、演算子と構文を解釈する方法がわかるように、選択したクエリ言語をクエリ パーサーに伝えることができます。
Simple クエリ言語は直感的で堅牢であり、多くの場合、クライアント側の処理なしでユーザー入力 as-is を解釈するのに適しています。 Web 検索エンジンで使い慣れたクエリ演算子をサポートします。
設定して取得する
queryType=fullでは、ワイルドカード、あいまいクエリ、正規表現クエリ、フィールド スコープ クエリなどの演算子とクエリの種類のサポートが追加され、既定の Simple クエリ言語が拡張されます。 たとえば、Simple クエリ構文で送信される正規表現は、式ではなくクエリ文字列として解釈されます。 この記事の要求例では、完全な Lucene クエリ言語を使用します。
パーサーに対する searchMode の影響
解析に影響するもう 1 つの検索要求パラメーターは、"searchMode" パラメーターです。 ブール型クエリの既定の演算子 (任意 (既定) またはすべて) を制御します。
"searchMode=any" (デフォルト) の場合、spacious と air-condition の間のスペース区切り記号は論理演算子 OR (||) になり、サンプルクエリテキストは次のようになります。
Spacious,||air-condition*+"Ocean view"
ブール クエリの構造において、明示的な演算子 (+ の +"Ocean view" など) の意味ははっきりしています。つまり検索条件との一致は "必須 (must)" です。 あまり明白でないのは、残りの用語「広々とした」と「空調」の解釈方法です。 検索エンジンは、海の景色、広々とした空間、そして空調に関して一致するものを見つける必要がありますか? それとも、ocean view に加えて、残りの 2 つの語句のうち、"どちらか一方" のみが含まれていればよいのでしょうか。
既定では ("searchMode=any")、検索エンジンはより広範な解釈を前提としています。 "or" セマンティクスを反映して、いずれかのフィールドを一致させるべきです
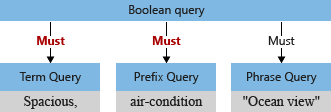
ここで "searchMode=all" を設定するとします。 この場合、スペースは "and" 操作として解釈されます。 文書内に一致と認められるためには、残りの2つの用語が必ず存在している必要があります。 結果のサンプル クエリは次のように解釈されます。
+Spacious,+air-condition*+"Ocean view"
一致するドキュメントが 3 つのサブクエリすべての共通部分である、このクエリの変更されたクエリ ツリーは次のようになります。
メモ
"searchMode=all" の上に "searchMode=any" を選択することは、代表的なクエリを実行することで最適な判断です。 演算子 (ドキュメント ストアの検索時に一般的) を含める可能性が高いユーザーは、"searchMode=all" がブール型クエリコンストラクトに通知すると、より直感的な結果が得られる場合があります。 "searchMode" と演算子の間の相互作用の詳細については、「 単純なクエリ構文」を参照してください。
ステージ 2: 字句解析
字句アナライザーは、クエリ ツリーの構造化後に 用語クエリ と フレーズ クエリ を処理します。 アナライザーは、パーサーによって渡されたテキスト入力を受け入れ、テキストを処理した後、トークン化された用語を返してクエリ ツリーに組み込みます。
構文分析の最も一般的な形式は 言語分析であり、特定の言語に固有のルールに基づいてクエリ用語を変換します。 これには次の処理が含まれます。
- クエリ用語を単語の語幹に変換する。
- 必須ではない単語 (英語の "the" や "and" などのストップワード) を削除する。
- 複合単語をコンポーネント パーツに分割する。
- 大文字の単語を小文字にします。
これらの操作はすべて、ユーザーによって提供されるテキスト入力とインデックスに格納されている用語の違いを消去する傾向があります。 このような操作はテキスト処理を超え、言語自体に関する詳細な知識が必要です。 言語認識のこのレイヤーを追加するために、Azure AI 検索は Lucene と Microsoft の両方からlanguage アナライザーの長い一覧をサポートします。
メモ
シナリオによっては、分析の要件は最小限から複雑なものまでさまざまです。 構文分析の複雑さを制御するには、定義済みのアナライザーのいずれかを選択するか、独自のcustom アナライザーを作成します。 アナライザーは検索可能なフィールドにスコープが設定され、フィールド定義の一部として指定されます。 これにより、フィールドごとに構文分析を変更できます。 指定しない場合は、 標準 の Lucene アナライザーが使用されます。
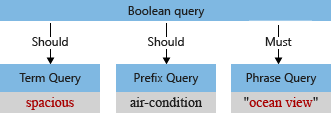
この例では、分析の前に、最初のクエリ ツリーに "Spacious" という用語があり、大文字の "S" と、クエリ パーサーがクエリ用語の一部として解釈するコンマがあります (コンマはクエリ言語演算子とは見なされません)。
既定のアナライザーが用語を処理すると、"ocean view" と "spacious" が小文字になり、コンマ文字が削除されます。 変更されたクエリ ツリーは次のようになります。
アナライザーの動作のテスト
アナライザーの動作は、 Analyze API を使用してテストできます。 分析するテキストを指定して、指定されたアナライザーによって生成される用語を確認します。 たとえば、標準アナライザーで "air-condition" というテキストがどのように処理されるかを確認するには、次の要求を発行できます。
{
    "text": "air-condition",
    "analyzer": "standard"
}
標準アナライザーは、入力テキストを次の 2 つのトークンに分割し、開始オフセットと終了オフセット (ヒット強調表示に使用) や位置 (フレーズ マッチングに使用) などの属性で注釈を付けます。
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
字句分析の例外
字句分析は、用語クエリまたはフレーズ クエリのいずれか、完全な用語を必要とするクエリの種類にのみ適用されます。 プレフィックス クエリ、ワイルドカード クエリ、正規表現クエリなど、不完全な用語を含むクエリの種類やあいまいクエリには適用されません。 この例のプレフィックス クエリと air-condition* という用語を含むクエリの種類は、分析ステージをバイパスしてクエリ ツリーに直接追加されます。 これらの型のクエリ用語に対して実行される唯一の変換は、小文字に変換することです。
ステージ 3: ドキュメントの取得
ドキュメントの取得とは、インデックス内の用語が一致するドキュメントを検索することです。 この段階は、例を通じて最もよく理解されています。 次の単純なスキーマを持つホテル インデックスから始めましょう。
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
さらに、このインデックスに次の 4 つのドキュメントが含まれていると仮定します。
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
用語のインデックス付け方法
取得を理解するために、インデックス作成に関するいくつかの基本を理解するのに役立ちます。 ストレージの単位は、検索可能なフィールドごとに 1 つずつ、反転インデックスです。 逆インデックス内は、すべてのドキュメントのすべての用語の並べ替えられたリストです。 次の例で明らかなように、各用語は、それが発生するドキュメントの一覧にマップされます。
逆インデックスで用語を生成するために、検索エンジンは、クエリ処理中に発生するのと同様に、ドキュメントの内容に対して字句分析を実行します。
- テキスト入力 は、アナライザーの構成に応じて、小文字化や句読点の削除など、アナライザーに渡されます。
- トークン は字句分析の出力です。
- 用語 がインデックスに追加されます。
クエリ用語がインデックス内の用語のように見えるように、検索操作とインデックス作成操作に同じアナライザーを使用することは一般的ですが、必須ではありません。
メモ
Azure AI 検索では、追加の indexAnalyzer および searchAnalyzer フィールド パラメーターを使用して、インデックス作成と検索にさまざまなアナライザーを指定できます。 指定しない場合、 analyzer プロパティを持つアナライザー セットは、インデックス作成と検索の両方に使用されます。
ドキュメントなどの逆インデックス
タイトル フィールドの例に戻って、反転インデックスは次のようになります。
| 用語 | ドキュメント リスト |
|---|---|
| アートマン | 1 |
| ビーチ | 2 |
| ホテル | 1, 3 |
| 海 | 4 |
| プラヤ | 3 |
| リゾート | 2 |
| リトリート | 4 |
タイトル フィールドには、1 と 3 の 2 つのドキュメントに ホテル のみが表示されます。
説明フィールドのインデックスは次のようになります。
| 用語 | ドキュメント リスト |
|---|---|
| 空気 | 3 |
| そして | 4 |
| ビーチ | 1 |
| 調整済み | 3 |
| 快適 | 3 |
| 距離 | 1 |
| 島 | 2 |
| kauaʻi | 2 |
| located | 2 |
| 北 | 2 |
| 海 | 1, 2, 3 |
| の | 2 |
| に | 2 |
| 静か | 4 |
| 部屋 | 1, 3 |
| 人里 離れた | 4 |
| 海岸 | 2 |
| 広い | 1 |
| the | 1、2 |
| to | 1 |
| ビュー | 1, 2, 3 |
| ウォーキング | 1 |
| と一緒に | 3 |
インデックス付き用語に対するクエリ用語の照合
上記の逆インデックスを使用して、サンプル クエリに戻り、サンプル クエリで一致するドキュメントがどのように見つかるかを見てみましょう。 最終的なクエリ ツリーは次のようになります。
クエリの実行中、個々のクエリは、検索可能なフィールドに対して個別に実行されます。
TermQuery "spacious" は、ドキュメント 1 (Hotel Atman) と一致します。
PrefixQuery "air-condition*" は、どのドキュメントとも一致しません。
この動作により、開発者が混乱することがあります。 ドキュメントにはエアコンという用語が存在しますが、既定のアナライザーでは 2 つの用語に分割されます。 部分的な用語を含むプレフィックス クエリは分析されていないことを思い出してください。 したがって、プレフィックス "air-condition" の用語は逆インデックスで検索され、見つかりません。
PhraseQuery "ocean view" は、"ocean" と "view" という用語を検索し、元のドキュメント内の用語の近接性を確認します。 ドキュメント 1、2、および 3 は、説明フィールドのこのクエリと一致します。 ドキュメント 4 にはタイトルに "ocean" という用語がありますが、個々の単語ではなく "ocean view" フレーズを探しているため、一致とは見なされません。
メモ
検索クエリは、検索要求の例に示すように、searchFields パラメーターで設定されたフィールドを制限しない限り、Azure AI 検索 インデックス内のすべての検索可能なフィールドに対して個別に実行されます。 選択したフィールドのいずれかに一致するドキュメントが返されます。
全体として、対象のクエリの場合、一致するドキュメントは 1、2、3 です。
ステージ 4: スコアリング
検索結果セット内のすべてのドキュメントには、関連性スコアが割り当てられます。 関連性スコアの機能は、検索クエリで表されるユーザーの質問に最も適したドキュメントをランク付けすることです。 スコアは、一致した項の統計的特性に基づいて計算されます。 スコア付け式の中核となるのは、 用語の頻度 -逆ドキュメントの頻度 (TF/IDF) です。 まれで一般的な用語を含むクエリでは、TF/IDF はまれな用語を含む結果を昇格します。 たとえば、Wikipedia のすべての記事を含む架空のインデックスでは、社長のクエリに一致したドキュメントから、社長に一致するドキュメントは、上に一致するドキュメントよりも関連性が高いと見なされます。
スコアリングの例
この例のクエリに一致した 3 つのドキュメントを思い出してください。
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
ドキュメント 1 は、説明フィールドに "spacious " と "required phrase ocean view " という用語の両方が含まれているため、クエリに最も一致しました。 次の 2 つのドキュメントは 、オーシャン ビューという語句にのみ一致します。 同じ方法でクエリに一致したドキュメント 2 と 3 の関連性スコアが異なっていても驚くかもしれません。 これは、スコアリング式に TF/IDF だけでなく多くのコンポーネントがあるためです。 この場合、ドキュメント 3 の説明が短いため、少し高いスコアが割り当てられます。 Lucene の実用的なスコアリング式について説明し、フィールドの長さやその他の要因が関連性スコアにどのように影響するかを理解します。
一部のクエリの種類 (ワイルドカード、プレフィックス、正規表現) は、常にドキュメント 全体のスコアに一定のスコアを提供します。 これにより、ランク付けに影響を与えずに、クエリ拡張によって検出された一致を結果に含めることができます。
例は、これが重要な理由を示しています。 プレフィックス検索を含むワイルドカード検索は定義上あいまいです。これは、入力が非常に多くの異なる用語で一致する可能性のある部分的な文字列であるためです。 "tour*" の入力を検討します。"tours"、"tourettes"、"tourmaline" に一致が見つかりました。 これらの結果の性質を考えると、他の用語よりも価値のある用語を合理的に推測する方法はありません。 このため、スコアリングの結果としてワイルドカード、プレフィックス、正規表現の型のクエリが発生する場合、用語の頻度は無視されます。 部分的かつ完全な用語を含むマルチパート検索要求では、予期しない一致の可能性に対する偏りを回避するために、部分入力の結果が一定のスコアで組み込まれます。
関連性調整
Azure AI 検索で関連性スコアを調整するには、次の 2 つの方法があります。
スコアリング プロファイルは 、一連のルールに基づいて、ランキングされた結果リスト内でドキュメントを優先します。 この例では、タイトル フィールドで一致したドキュメントの方が、説明フィールドで一致したドキュメントよりも関連性が高いと考えることができました。 さらに、インデックスに各ホテルの価格フィールドがある場合は、価格の低いドキュメントを昇格できます。 スコアリング プロファイルを検索インデックスに追加する方法について説明します。
用語ブースト (Full Lucene クエリ構文でのみ使用可能) は、クエリ ツリーの任意の部分に適用できるブースト演算子
^を提供します。 この例では、プレフィックス の空気条件*を検索する代わりに、正確な用語 の空気条件 またはプレフィックスを検索できますが、正確な用語に一致するドキュメントは、用語クエリにブーストを適用することで上位にランク付けされます: air-condition^2||air-condition*. クエリでの用語ブーストの詳細を確認します。
分散インデックスでのスコアリング
Azure AI 検索内のすべてのインデックスは自動的に複数のシャードに分割されるため、サービスのスケールアップまたはスケールダウン中に複数のノード間でインデックスをすばやく分散できます。 検索要求は送信されると、各シャードに対して別々に送られます。 その後、各シャードの結果がマージされ、スコアで並べ替えられます (他の順序が定義されていない場合)。 スコアリング関数は、シャード内のすべてのドキュメントで逆ドキュメント頻度に対して検索語頻度を重み付けするものであり、すべてのシャードで重み付けするものではないことを知ることが重要です。
つまり、同一のドキュメントが異なるシャードに存在する場合、関連性スコアが異なる 可能性 があります。 幸いなことに、このような違いは、より均等な用語分布のためにインデックス内のドキュメントの数が増えるにつれて消える傾向があります。 特定のドキュメントがどのシャードに配置されるかを想定することはできません。 ただし、ドキュメント キーが変更されない場合は、常に同じシャードに割り当てられます。
一般に、順序の安定性が重要な場合、ドキュメント スコアはドキュメントの順序付けに最適な属性ではありません。 たとえば、同じスコアを持つ 2 つのドキュメントがある場合、同じクエリの後続の実行で最初に表示される保証はありません。 ドキュメント スコアは、結果セット内の他のドキュメントに対するドキュメントの関連性の一般的な感覚のみを与える必要があります。
結論
商用検索エンジンの成功により、プライベート データに対するフルテキスト検索が期待されています。 ほぼすべての種類の検索エクスペリエンスでは、用語のスペルが間違っているか不完全な場合でも、エンジンが意図を理解することが求められるようになりました。 指定しなかったほぼ同等の用語またはシノニムに基づいて一致が予想される場合もあります。
技術的な観点からは、フルテキスト検索は非常に複雑であり、高度な言語分析と、関連する結果を提供するためにクエリ用語を蒸留、拡張、変換する方法での処理に体系的なアプローチが必要です。 固有の複雑さを考えると、クエリの結果に影響を与える可能性のある多くの要因があります。 このため、フルテキスト検索の仕組みを理解するのに時間を費やして、予期しない結果を処理しようとすると、具体的な利点が得られます。
この記事では、Azure AI 検索のコンテキストでのフルテキスト検索について説明しました。 一般的なクエリの問題に対処するための潜在的な原因と解決策を認識するのに十分な背景が提供されることを願っています。
次の手順
サンプル インデックスを作成し、さまざまなクエリを試して、結果を確認します。 手順については、「Build」を参照し、Azure ポータルでインデックスを照会します。
Azure ポータルの Search エクスプローラーで、Search Documents の例のセクションまたは Simple クエリ構文 から他のクエリ構文を試してください。
検索アプリケーションでランク付けを調整する場合は、 スコアリング プロファイル を確認します。
特定のフィールドで最小限の処理または特殊な処理を行うカスタム アナライザーを構成します。