Frontier Tuning を使用することで、組織は独自の用語、コミュニケーション スタイル、ビジネス プロセスを反映するように AI モデルを調整できます。 独自のデータを使用して大規模言語モデル (LLM) を微調整すると、テナント全体の Copilot 応答の精度、トーン、関連性を向上させることができます。
Frontier チューニングは、保持と取得にとどまらず、堅牢なエンタープライズ セキュリティ、コンプライアンス、ガバナンス、管理制御を維持しながら、organization のデータでテナント固有の LLM をトレーニングします。 LLM は、ドキュメントの要約、ドキュメントの作成、専門家の回答、スタイルの編集、ドキュメントの検証、最適化などの特定のタスクに合わせて調整されます。
この記事では、Frontier Tuning の学習ループと、集中的な改善を選択する方法について説明します。 また、ツールとサンプル チューニング環境が評価とトレーニングをサポートする方法についても説明します。
重要
Microsoft Copilot のチューニングは現在、早期アクセス プログラムを通じて一部の顧客のみが利用できます。 Frontier 経由のアクセスは 2026 年 4 月を予定しています。 機能と要件は変更される可能性があります。
チューニング学習ループ
学習ループは、ワークフロー、評価証拠、改善の決定を結び付けます。
- ワークフローをエンコードします。 タスクの指示、代表的なサンプル、品質基準、および作業に必要な知識とツールをCaptureします。
- ギャップを明らかにします。 現実的なタスクを明示的な基準に照らして評価し、成功と失敗を特定します。
- 変更を選択します。 証拠を使用して重点的な改善点を 1 つ選択し、結果を比較します。
これらは必須のトレーニング ステージではありません。 ベースラインが要件を満たしている場合、変更なしで停止することは有効な結果です。
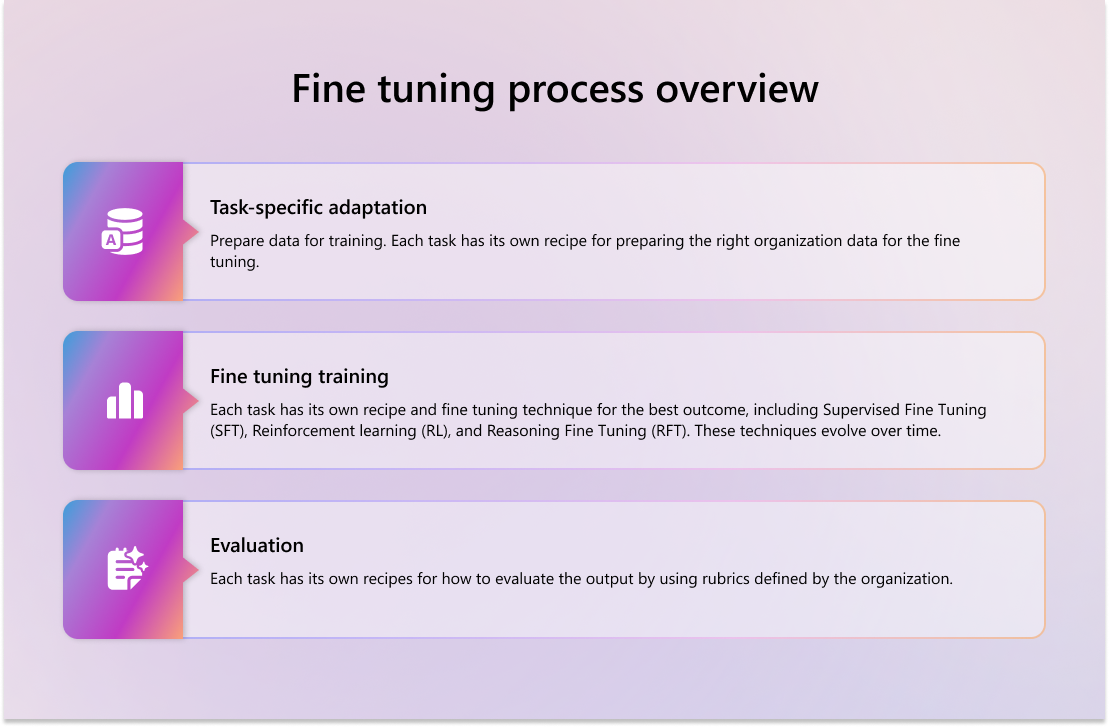
微調整プロセスの概要
Frontier チューニング - チューン モデルを使用して organization の AI モデルを微調整するには、次のトレーニングとチューニングの手順に従います:
タスク固有の適応 - トレーニング用データを準備します。 各タスクには、微調整に適したorganizationデータを準備するための独自のレシピがあります。
Fine-tuning training - 各タスクには独自のレシピと微調整テクニックがあり、organization データを使用して最良の結果を得ることができます。 これらの手法には、教師ありファイン チューニング (SFT)、強化学習 (RL)、推論ファイン チューニング (RFT) が含まれますが、これらに限定されません。 これらのレシピやテクニックも時間の経過とともに進化します。
評価 - organizationの期待を反映する評価基準に照らして応答を評価します。 チューニングによってすべての応答が改善されると仮定するのではなく、チューニング前とチューニング後の結果を比較します。
選択するツール、例、および評価基準は、タスクに適合する必要があります。 たとえば、モック データを使用するサンプル タスクには、そのデータに一致するスキルと評価基準が必要です。
注
チューニングするモデルはプライベートです。 データは、他のテナントの一般的なモデルのトレーニングには使用されません。 データのすべての処理は、承認されたユーザーのみがアクセスしてトレーニングおよび使用できるテナントで行われます。 特定の個人 (通常は管理者) がトレーニング プロセスを制御できます。
環境の調整
チューニング環境は、チューニング シナリオのためにアーティファクトとツールをまとめます。
- スキルは、 モデルがタスクに対して何を行う必要があるかを記述します。これらの説明は、要求のルーティングに役立ちます。
- サンプルは 、評価またはトレーニングのための入力例を提供します。
- 評価基準は 、完全性や指示の順守など、応答を評価するための要件を定義します。
- ツールは 、メールの検索や SharePoint ファイルの読み取りなど、エージェントが実行できるアクションを提供します。 コネクタは、サービスのツールをグループ化します。
選択したナレッジ参照には、SharePoint サイト、SharePoint または OneDrive のファイルとフォルダー、Teams スレッド、会議を含めることができます。 モデルと推論の構成によって、スキルの実行方法が決まります。
対象分野の専門家は、専門知識やフィードバックを取得して確認し、環境の所有者によるレビュー用のスキル、評価基準、サンプルを提案できます。 このコントリビューション ワークフローは、評価およびチューニング ジョブとは別に扱います。コントリビューションを承認するとモデルがトレーニングされると想定しないでください。
評価基準が重要な理由
評価基準は、専門家の品質基準を明確にします: 対応に何を含める必要があるか、何を避ける必要があるかを示します。 これらは、応答を採点および比較するための測定器であり、スキルの指示やモデルの重みの代わりではありません。 サポートされている推論戦略では、基準ベースのフィードバックが、選択される候補応答にも影響を与えることができます。
タスク固有の適応
タスク固有の適応は、コーパスを取り込んだ後に行われます。 この適応には、organization のコンテンツを元の形式から、1 行に 1 つのステートメントを含むプレーン テキスト形式に処理することが含まれます。
監視あり微調整
教師あり微調整を使用して、ラベル付きの入出力ペアで事前トレーニング済みモデルを特定のタスクや組織の要件に適応させます。 このプロセスは、モデルがorganizationの優先形式、トーン、コンプライアンスのニーズに合った応答を生成することを学習するのに役立ちます。 監視あり微調整:
- 構造とトーンを教える - モデルは、organization's voiceを反映する方法で応答する方法を学びます。
- タスクの精度を向上 - 高品質の例でトレーニングを行うことで、エンタープライズ ユース ケースでのモデルの信頼性が向上します。
- コンプライアンスのサポート - 規制言語と内部分類を認識して応答するようにモデルをトレーニングできます。
強化学習
トレーニング後の手法として強化学習を使用して、LLM をorganization独自のコミュニケーションスタイル、トーン、ツールの使用設定に合わせて調整します。 ラベル付けされた例から正しい出力を生成するようにモデルに指示する教師あり微調整とは異なり、強化学習はフィードバック信号から学習することで主観的な品質を最適化します。
強化学習は、モデルで次のことを行う場合に役立ちます。
- 特定の声のトーン (共感的、フォーマル、簡潔) を反映させます。
- RAG ベースの取得よりも特定のツール (Microsoft Graph API など) を優先します。
- 機密性の高いソース (ACL タグ付きドキュメントなど) からコンテンツを取得することは避けます。
- ユーザー フィードバックから学び、継続的に改善します。
強化学習は、人間のフィードバックと自動フィードバックの両方を使用して学習を導き、組織の好みに基づいてアウトプットをスコアリングすることで、モデルを改良します。 たとえば、Copilot が休暇ポリシーに関する質問に対する回答に対して肯定的なフィードバックを受け取った場合、モデルはその回答を強化し、同様のコンテキストで再利用します。 逆に、応答にトーンまたはコンテンツのフラグが設定されている場合、モデルはそのパターンを回避することを学習します。
チューニング ワークフローのツール
ツールの選択は、ワークフローの 3 つのステージに影響します。
| ステージング | ツールの役割 |
|---|---|
| 推論。 | エージェントまたはチューニングされたモデルは、要求の処理中にツールを呼び出します。 |
| 評価。 | エージェントはツールを呼び出してサンプル タスクを完了し、応答は評価基準に照らして評価されます。 |
| トレーニング。 | モデルは、タスクから学習しながらツールを呼び出します。 |
実際のツールはサービスを呼び出し、そのデータを使用します。 仮想化されたツールは引き続き実際のデータを読み取りますが、評価およびトレーニング中にサポートされている書き込みをインターセプトします。 モック ツールは、サービスの代わりに独自に提供されたデータを使用します。
モデルは、トレーニング中に遭遇したツール (名前、入力、結果、エラーなど) の操作方法を学習します。 推論の違いは、推論の動作に影響を与える可能性があります。 また、トレーニングは通常の使用よりも頻繁にツールを呼び出すため、ツールを選択するときは、サービスの負荷、プライバシー要件、および副作用を考慮してください。
ツールの種類、ステージの動作、および接続のライフサイクルについては、 Frontierチューニングのツールとコネクタを参照してください。
サンプルのチューニング環境から始める
サンプルのチューニング環境は、独自のビジネスデータを準備する前にワークフローを試すための出発点を提供します。 サンプル・テンプレートからチューニング環境を作成すると、サンプル・シナリオ用の既製の成果物およびモック・データが追加されます。 内容はテンプレートによって異なります。
含まれるスキルとサンプルを検査し、モデルの初期応答を評価し、チューニングを実行して結果を比較できます。 サンプル結果では、ビジネス シナリオのパフォーマンスは確立されません。運用環境で使用する前に、代表的なデータで評価します。
サンプルワークフローについては、 サンプルチューニング環境でFrontierチューニングを試すを参照してください。
チューニングの前後を評価する
使用可能な基本モデルを評価して、チューニング ジョブを開始する前にベースラインを確立します。 チューニングが完了したら、結果として得られるモデルを同じ評価サンプルと評価基準で評価します。
タスクに関係する基準と結果を比較します。 失敗したツール呼び出しと応答品質の違いを確認します。スロットリングまたはタイムアウトは、評価結果とモデルが学習する内容に影響を与える可能性があります。 チューニングは必ずしもすべての応答を改善するわけではありません。
解釈可能な比較の場合:
- 管理され保留された検証ケースとその派生物は、生成、改良、およびトレーニングの入力から除外されます。 サンプル ラベルだけでは分離できません。
- 命令、ソースとツールの状態、モデルとバージョン、推論オプション、サンプル コンテンツと ID、評価基準とグレーダー、および繰り返し条件は固定されたままにしてください。 テスト中の変数のみを変更します。 使用できないコントロールとドリフトを制限として記録します。
- 基準を変更した後、品質の向上に帰属する前に、新しいベースラインと改訂された基準で候補の両方をスコアリングします。
- グレーディングされたカバレッジ、実際の出力、およびツールの証拠をスコアとともに検査します。 完了したジョブは、タスクの成功が確認されません。
- 遅延と消費を既知の測定範囲と比較します。使用量がないことは、ゼロ消費の証拠ではありません。
重点的な改善を選択する
必須のエスカレーション パスではなく、観察されたギャップによって選択してください。
| 改善目標 | 変更箇所 | テストの決定 |
|---|---|---|
| 推論の構成。 | 重みをトレーニングせずに固定モデルがどのように実行されるか。 | 別の戦略を使用して、許容可能な待機時間と消費量の範囲内で結果を改善できますか? |
| スキルの指示または評価基準。 | 命令は実行をガイドします。条件の測定値を変更し、サポートされている選択に影響を与える可能性があります。 | このギャップは、専門家による修正が必要な不明瞭な指示や基準を反映していますか? |
| モデルの重み付けトレーニング。 | モデル自体はトレーニングを通じて適応されます。 | トレーニングされたモデルは、一致した評価条件下で基本モデルよりも改善されますか? |
パブリック v1 リファレンスでは、 Simple を 1 つの実行、 BestOfN スコア付けされた候補の選択、 TreeSearch 代替案の探索として説明します。
変更と承認の確認
専門家によるレビュー、コンテンツの受け入れ、承認されたリソースの変更、ランタイム ツールのアクセス許可、有料操作の同意、および公開は別個の決定事項です。 変更を承認する前に、現在の状態を調べます。 操作が結果を提案するか、すぐに保存するかを確認します。即時保存操作の承認前に確認し、後で保存状態を検査します。
パブリック v1 絞り込みパスでは、 Training サンプルが使用されます。 条件の絞り込み結果を適用すると、選択した候補ではなく、セット全体が置き換えられます。
高度な適応とメンテナンス
さまざまな微調整手法を組み合わせることで、organization のトーン、タスク完了パターン、Microsoft Purview データ ガバナンスの要件を反映するモデルを作成できます。 これらの基礎となるモデルは、organization の独自の声と運用に関する知識を次のことに応用します。
- タスク全体で一貫したトーンと書式を維持します。
- ドキュメントの作成、要約、質問への専門家の回答の提供などのタスクにドメイン固有の知識を埋め込みます。
- トレーニングと推論中は、アクセス制御とデータ分類ポリシーを尊重します。
- 社内基準とユーザーの期待に沿った正確な回答を生成します。
すべての評価は機密であり、Microsoft の責任ある AI 原則に準拠しています。
新しいデータが利用可能になったらエージェントを進化させ続け、次の方法でモデルを調整できます。
- 新しいデータをアップロードしています。
- 新しいタスクの種類や規制の変更に適応するために、目標と評価指標を更新します。
タスク データ、ツール、または評価基準を変更する場合は、再度評価して効果を評価します。 新しいトレーニング ジョブが必要かどうかを判断する前に、結果、ユーザー フィードバック、ドリフトを確認します。 後のスキル、基準、またはサンプル編集は、パブリック v1 リファレンスで既に生成されたモデルを再トレーニングしません。