Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of mappen te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen om mappen te wijzigen.
Naarmate organisaties hun digitale transformatie versnellen, wordt het vermogen om data effectief te beheren een strategische zakelijke noodzaak. Met de opkomst van AI-gestuurde applicaties en Copilot-gestuurde workflows genereren en consumeren ondernemingen data in ongekende mate. Deze data stimuleert innovatie, maakt gepersonaliseerde ervaringen mogelijk en ondersteunt cruciale besluitvorming. Maar alleen als de data op een intelligente manier wordt beheerd en opgeslagen.
Om aan deze veranderende zakelijke behoeften te voldoen, moeten organisaties een proactieve strategie voor opslagbeheer hanteren. Hiermee wordt gewaarborgd dat gegevens die niet langer nodig zijn voor de dagelijkse werkzaamheden, op verantwoorde wijze worden verwerkt. Zo komt er capaciteit vrij voor werklasten met een hoge toegevoegde waarde, worden operationele problemen verminderd en wordt voldaan aan de nalevings- en auditvereisten.
Vanuit technisch oogpunt verbetert effectief opslagbeheer in Dataverse en Dynamics 365 de systeemprestaties, verbetert het de kostenefficiëntie en zorgt het ervoor dat beleid voor langetermijnretentie (LTR) wordt nageleefd. Beide platforms bieden hulpmiddelen en automatiseringsmogelijkheden waarmee organisaties opslag kunnen beheren.
Door de in dit artikel beschreven strategieën te implementeren, kunnen bedrijven de ondersteuningskosten verlagen, naleving stroomlijnen en meer waarde uit hun zakelijke applicaties halen. Zo verandert opslag van een beperking in een concurrentievoordeel.
Belangrijkste voordelen
Effectief opslagbeheer in Dataverse en Dynamics 365 biedt een aantal belangrijke voordelen die veelvoorkomende pijnpunten bij klanten aanpakken en de algehele operationele efficiëntie verbeteren.
Betere naleving van LTR: effectief opslagbeheer zorgt ervoor dat gegevens worden opgeslagen in overeenstemming met LTR-beleid. Dit helpt niet alleen bij het voldoen aan de wettelijke vereisten, maar zorgt er ook voor dat cruciale gegevens bewaard blijven en toegankelijk zijn wanneer dat nodig is.
Verbeterde prestaties: Door het opslagbeheer te optimaliseren, kunnen organisaties de prestaties van hun systemen aanzienlijk verbeteren. Efficiënte toewijzing en beheer van opslag vermindert de latentie en verbetert de snelheid van het ophalen van gegevens, wat resulteert in soepelere en snellere bewerkingen.
kostenefficiëntie bevorderen: effectief opslagbeheer stelt organisaties in staat zich te richten op waardevolle gegevens door hun opslaglandschap te stroomlijnen en overzichtelijker te maken. Door alleen te behouden wat strikt noodzakelijk is, kunnen bedrijven hun opslagcapaciteit optimaliseren. Dit leidt tot slimmer gebruik van bronnen en kosteneffectieve schaalbaarheid.
Achtergrond
Naarmate organisaties groeien en hun processen steeds verder digitaliseren, neemt de hoeveelheid bedrijfsgegevens die is opgeslagen in systemen als Dataverse en Dynamics 365 gestaag toe. Hieronder vallen niet alleen actieve transactiegegevens, maar ook historische gegevens die bewaard moeten worden ten behoeve van audits, regelgeving of bedrijfscontinuïteit. Na verloop van tijd kan deze ophoping leiden tot prestatieverslechtering, hogere operationele overheadkosten en stijgende opslagkosten, vooral wanneer gegevens die niet langer actief worden gebruikt, in opslaglagen met hoge prestaties blijven staan.
Een goed gedefinieerde opslagbeheerstrategie helpt organisaties deze uitdagingen aan te gaan door te bepalen welke gegevens kunnen worden gearchiveerd, opgeschoond of verplaatst naar goedkopere, voor lezen geoptimaliseerde opslag. Dit is belangrijk in nalevingsscenario's waarbij gegevens onveranderlijk, moeilijk toegankelijk en alleen-lezen moeten blijven, zoals financiële gegevens, auditlogs of wettelijke indieningen. Het is voor veel ondernemingen een belangrijke vereiste dat dergelijke gegevens op een conforme manier worden bewaard, zonder dat dit de prestaties van actieve systemen beïnvloedt.
Door gebruik te maken van de tools en strategieën die op beide platforms beschikbaar zijn, krijgen organisaties beter inzicht in hun opslagvoetafdruk, kunnen ze onnodig verbruik verminderen en ervoor zorgen dat nalevingskritische gegevens op de juiste manier worden verwerkt.
In dit artikel worden praktische benaderingen voor opslagbeheer beschreven waarmee klanten hun gegevensretentiepraktijken kunnen afstemmen op de bedrijfs- en regelgevingsbehoeften. Hierdoor worden de systeemprestaties verbeterd, de operationele overhead verlaagd en wordt gegarandeerd dat aan nalevingsverplichtingen wordt voldaan zonder dat dit ten koste gaat van de naleving.
Waarom we gegevens opslaan
Om het juiste gegevensretentiepatroon voor uw gegevens te selecteren en optimaliseren, is het nuttig om na te denken over de redenen waarom we gegevens opslaan en waarvoor we dat doen.
Operationele gegevens
In een bedrijfsapplicatie worden operationele gegevens gebruikt om verkoop-, financiële of supply chain-acties bij te houden.
Deze gegevens moeten in realtime toegankelijk zijn en de operationele processen van klanten en interne medewerkers ondersteunen. Hierbij worden gedetailleerde acties, zoals interacties met klanten, bestellingen of voorraadactiviteiten, vastgelegd.
Operationele gegevens worden in de loop van de tijd mogelijk niet meer actief gebruikt, maar worden nu minder vaak gebruikt. Het kan nodig zijn dat de gegevens bijna in realtime toegankelijk zijn, om een klant te helpen met een bestelling of bij een supportcase. Neem bijvoorbeeld de volgende scenario's:
- Een klant plaatst een bestelling, terwijl een andere klant, die al een tijdje geen interactie met het bedrijf heeft gehad, ook een bestelling plaatst.
- Elke bestelling die is geplaatst en wordt verzonden, wordt voortdurend gecontroleerd. Er zijn ook bestellingen die onder de garantieperiode van drie jaar vallen en waarvoor mogelijk ondersteuning nodig is en waarvoor mogelijk een terugbetaling vereist is.
Dit kan leiden tot verschillende fasen van operationele data-toegangsbehoeften, zoals:
- Minder dan een jaar aan actief geraadpleegde gegevens.
- Minder dan drie jaar aan zelden geraadpleegde gegevens.
- Meer dan drie jaar waarin de gegevens niet langer operationeel toegankelijk zijn.
Door het real-time karakter van operationele opslag is dit relatief duur vergeleken met andere vormen van opslag. Daarom is het belangrijk om te weten wanneer gegevens operationeel toegankelijk moeten zijn en wanneer niet, voor het bepalen van bewaarstrategieën.
Operationele integratie
Omdat het een gespecialiseerde categorie van operationeel gebruik betreft, kan het nodig zijn dat gegevens tussen meerdere operationele systemen worden gerepliceerd, waaronder patronen zoals:
- Bankieren : Klantrelatiebeheer voor interacties met klanten aan de frontlinie en replicatie naar meerdere banksystemen. U hebt bijvoorbeeld betaalrekeningen, creditcards, hypotheken en kredietchecksystemen.
- productie : Klantrelatiebeheer voor het aannemen van orders aan de frontlinie en ERP-systeem (Enterprise Resource Management) voor supply chain management.
- Noodhulp door de politie : Klantrelatiebeheer voor interacties met burgers en verzendsystemen voor politieafdelingen bieden implementatiebeheer.
In deze gevallen worden in elk systeem unieke gegevens bijgehouden, maar er zijn vaak gemeenschappelijke hoofdgegevens die tussen de systemen gedeeld en gesynchroniseerd moeten worden, wat leidt tot integratiebehoeften.
Auditgegevens
Een bedrijf is doorgaans wettelijk verplicht om gegevens gedurende langere perioden te bewaren, bijvoorbeeld gemiddeld zeven jaar, voor interne of externe controledoeleinden, zoals ter ondersteuning van financiële audits, openbaarmaking door toezichthouders of fraudeonderzoek.
Deze gegevens omvatten doorgaans zowel gegevens die nodig zijn voor operationele doeleinden als gegevens die niet langer nodig zijn, omdat dit het mogelijk maakt de dataset op één plek te bekijken.
Analysegegevens
Organisaties hebben er behoefte aan om de staat van hun bedrijf te beoordelen en analyseren. Ze moeten statistieken over een langere periode meten en vergelijken, en daarbij meerdere of alle onderdelen van het bedrijf bestrijken.
De grote periodes en de breedte van de gegevens waarop deze analyses kunnen worden uitgevoerd, maken het noodzakelijk om operationele gegevens te repliceren in gespecialiseerde analysetools. Hiermee wordt voorkomen dat complexe analyses de prestaties van operationele systemen beïnvloeden, en is het mogelijk om analyses uit te voeren op datasets die verder gaan dan de periode waarvoor de gegevens operationeel nodig zijn. Het kan bijvoorbeeld nodig zijn om gegevens over een periode van zeven jaar te vergelijken, in plaats van over een periode van één of twee jaar. Verschillende analysebehoeften vereisen echter mogelijk de volledige bewaartermijnen van gegevens of alleen de gegevens die in operationele systemen worden bewaard.
Met analysegegevens kunt u doorgaans gegevens uit meerdere bedrijfsonderdelen samenvoegen en gegevens uit meerdere systemen combineren.
Gegevensstroom
Gegevens van dit type vloeien doorgaans in de loop van de tijd van operationele gegevens naar transactie- of historische gegevens, zoals weergegeven in de onderstaande afbeelding.
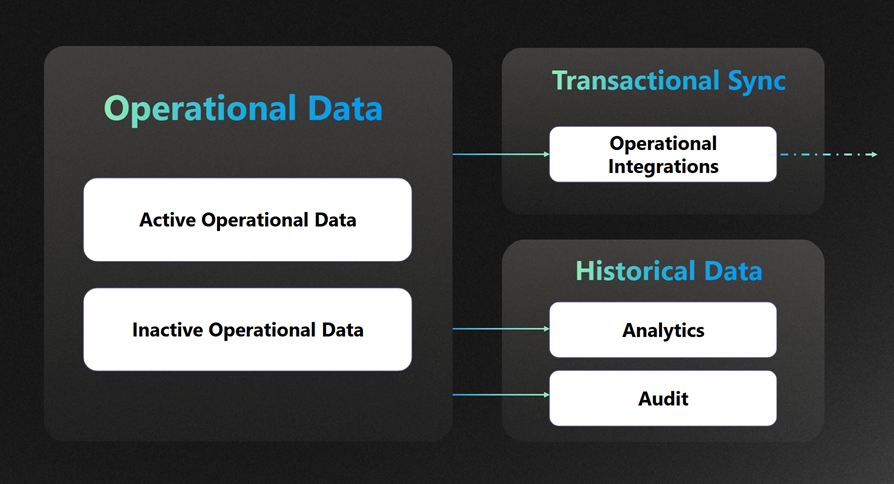
Verschillende soorten opslag
Dataverse opslagtypen
Dataverse organiseert opslag in drie hoofdcategorieën, elk met unieke gebruikspatronen en factureringsimplicaties.
| Opslagtype | Omschrijving | Veelvoorkomende toepassingen |
|---|---|---|
| Databaseopslag | Slaat gestructureerde gegevens op in tabellen: standaard en aangepast. | Bedrijfsgegevens, metagegevens, relaties en configuraties |
| Bestandsopslag | Slaat bijlagen en binaire gegevens op. | E-mailbijlagen, afbeeldingen, documenten geüpload via Power Apps |
| Logboekopslag | Slaat auditlogs en plug-in-tracelogs op. | Wijzigingen bijhouden, controle, diagnostiek en naleving |
Opslagtypen voor financiële en operationele platformen
De opslag van financiën en bedrijfsvoering wordt apart beheerd, maar wordt steeds meer geïntegreerd in het Power Platform ecosysteem. Het omvat de volgende opslagtypen.
| Opslagtype | Omschrijving | Veelvoorkomende toepassingen |
|---|---|---|
| Operationele databaseopslag | Kerntransactiegegevens voor financiën, toeleveringsketen, personeelszaken en meer | Grootboekposten, inventaris, klantorders |
| Opslag voor documentbeheer | Binaire grote objecten (Blobs) opgeslagen in Azure Blob Storage | Facturen, ontvangstbewijzen, gescande documenten |
| Telemetrie- en diagnostische logboeken | Systeemlogboeken en telemetriegegevens | Prestatiebewaking, probleemdiagnostiek. |
Gedeelde en geïntegreerde opslagscenario's
Dubbele schrijfopslag
- Maakt realtime synchronisatie tussen financiële en operationele apps mogelijk. Dataverse
- Vereist zorgvuldig rol- en capaciteitsbeheer om duplicatie en overmatig gebruik te voorkomen.
Langetermijnretentie (LTR)
- Verplaatst historische gegevens naar een Managed Data Lake (MDL).
- Vermindert het primaire opslaggebruik terwijl de naleving en toegang tot analyses behouden blijven.
- Integreert met:
- Snel zoeken (Dataverse-systeemeigen zoekfunctie)
- OneLake (Fabric-gebaseerde analyse)
- Synapse Link (aangepaste analyse van meren)
Hoe uw gegevens in de loop van de tijd groeien
Naarmate organisaties hun gebruik van het Dynamics 365 Finance & Operations-platform opschalen, wordt de groei van data zowel een teken van succes als een strategische uitdaging. Dataverse Wat begint als een kleine, transactionele dataset, kan zich snel ontwikkelen tot een complex, gelaagd datalandschap. In dit hoofdstuk worden vijf belangrijke factoren voor datagroei en de gevolgen hiervan voor opslag, prestaties en governance besproken.
Het gebruik van datawarehousing op operationele data
Om inzichten uit operationele systemen te ontsluiten, gebruiken veel organisaties Azure Synapse Link, OneLake of data-export om gegevens uit Dataverse financiële en operationele apps te repliceren naar een analysesysteem. Dit ondersteunt geavanceerde rapportage en AI-workloads, maar introduceert ook:
Redundante opslag in de operationele en de analytische lagen
Gegevens worden vaak gedupliceerd tussen de operationele en analytische omgeving. Deze redundantie verhoogt het totale opslagverbruik en kan leiden tot hogere kosten, vooral als historische gegevens voor onbepaalde tijd in beide systemen worden bewaard.
Schemaduplicatie en versiebeheeroverhead
Om consistentie tussen systemen te behouden, moeten organisaties schemawijzigingen (bijvoorbeeld nieuwe velden en hernoemde kolommen) repliceren op zowel operationele als analytische lagen. Hierdoor wordt het databeheer complexer en neemt het risico op schemaverloop toe, waardoor downstream-rapporten of -modellen verstoord kunnen raken.
Verhoogde retentie van historische gegevens voor trendanalyse
Analytische systemen bewaren gegevens doorgaans gedurende langere perioden ter ondersteuning van trendanalyses, prognoses en wettelijke rapportages. Hoewel deze langdurige bewaring waardevol is, kan het leiden tot grote datasets als er geen goede archiverings- en tieringstrategieën worden gebruikt.
Datawarehousing is essentieel voor analyses, maar zonder levenscyclusbeleid kan het uw opslagcapaciteit verdubbelen of verdrievoudigen.
De zoekfunctie voor de gegevens gebruiken
Functies zoals zoeken, Copilot-indexering en relevantiezoeken vereisen het indexeren van grote volumes gestructureerde en ongestructureerde gegevens. Dataverse Deze indexen hebben vaak de volgende kenmerken:
Log- en databaseopslag gebruiken
Zoekindexen worden opgeslagen in zowel logboek- als databaseopslag. Naarmate er meer tabellen en velden als doorzoekbaar worden gemarkeerd, groeit de indexgrootte evenredig. Dit kan een aanzienlijke impact hebben op het totale opslaggebruik, vooral in omgevingen met grote hoeveelheden records of frequente schemawijzigingen.
Blijft bestaan, zelfs voor ongebruikte of verouderde tabellen
Zelfs wanneer bepaalde tabellen zijn verouderd of niet meer actief worden gebruikt, kunnen de bijbehorende zoekindexen nog steeds aanwezig zijn, tenzij ze expliciet worden verwijderd. Dit leidt tot onnodig opslagverbruik en kan de capaciteitsplanning ingewikkeld maken.
Worden vaak gedupliceerd in verschillende omgevingen, zoals ontwikkelings-, test- en productieomgevingen
Zoekindexen worden doorgaans gerepliceerd in ontwikkelings-, test- en productieomgevingen. Dit zorgt niet alleen voor consistent zoekgedrag, maar vergroot ook de opslagruimte, vooral wanneer omgevingen vaak worden gekloond of vernieuwd.
Zoeken verbetert de bruikbaarheid en de AI-gereedheid, maar index-bloat draagt in stilte bij aan overschrijding van de opslagruimte.
Logregistratie voor de gegevens inschakelen
Auditlogs, plug-in trace logs en telemetrie zijn essentieel voor naleving, foutopsporing en monitoring. Let echter wel op de volgende punten:
De logboekopslag groeit lineair met het gebruik en het aantal gebruikers.
Loggegevens groeien evenredig met:
- Het aantal gebruikers en hun activiteitsniveau
- Het volume van transacties en integraties
- De complexiteit van bedrijfslogica zoals plug-ins en workflows
In omgevingen met intensief gebruik kan dit leiden tot een snelle uitbreiding van logtabellen, waardoor zowel de database- als de logopslagquota worden verbruikt.
Standaardwaarden voor retentie zijn vaak te genereus, bijvoorbeeld 90 dagen of meer.
Standaard worden gegevens bij veel logfuncties gedurende langere perioden bewaard, bijvoorbeeld 90 dagen of langer. Hoewel dit de traceerbaarheid op lange termijn ten goede komt, kan het leiden tot onnodig opslagruimteverbruik, vooral wanneer logboeken niet actief worden gecontroleerd of geëxporteerd.
Door het systeem gegenereerde logs worden aan de klant gefactureerd in Dataverse.
In Dataverse, door het systeem gegenereerde logboeken, waaronder auditlogs en plug-in trace-logs, worden in mindering gebracht op de opslagrechten van de klant. Dit betekent dat zonder de juiste opruim- of exportstrategieën, logging direct kan bijdragen aan overschrijding van de opslagruimte en hogere licentiekosten.
Logging is niet-onderhandelbaar voor gereguleerde sectoren, maar moet worden gecombineerd met bewaar- en exportstrategieën, zoals Azure Monitor of Log Analytics.
Meerdere kopieën van de productieomgeving hebben
Ter ondersteuning van de ontwikkeling, het testen, de training en het oplossen van problemen maken klanten vaak sandbox- of gekloonde omgevingen. Elk exemplaar:
- Repliceert de volledige omvang van de gegevens en indexen.
- Kan niet-voor-de-hand-liggende afhankelijkheden bevatten, zoals zoekindexen, auditlogs en metagegevens.
- Wordt na gebruik zelden schoongemaakt.
De uitbreiding van het milieu is een belangrijke factor voor hogere opslagkosten en -complexiteit. Bestuursbeleid en automatisering zijn essentieel voor inperking.
Optimalisatie van query's op de data
Naarmate de datavolumes toenemen en de responsiviteit van applicaties van cruciaal belang wordt, implementeren klanten en ISV's vaak verschillende query-optimalisatietechnieken om de prestaties te verbeteren. Dataverse en Dynamics 365. Deze strategieën worden vooral veel gebruikt in scenario's waarin rapportage, analyse en integratie een belangrijke rol spelen.
Om de prestaties te verbeteren, creëren klanten en ISV's vaak:
Aangepaste indexen en gematerialiseerde weergaven
Deze worden gebruikt om de uitvoering van query's te versnellen door joins of aggregaties vooraf te berekenen. Ze zijn handig in scenario's met complexe filters of grote datasets.
Gedenormaliseerde tabellen voor rapportage
Om rapportage te vereenvoudigen en de complexiteit van query's te verminderen, maken ontwikkelaars vaak afgeplatte versies van relationele gegevens. Deze tabellen verminderen de noodzaak voor runtime-joins en verbeteren de prestaties van het dashboard.
Cachinglagen of -aggregaties
Vaak geraadpleegde gegevens worden soms vooraf samengevoegd of gecached in tussenliggende tabellen of externe opslagplaatsen om de belasting van de primaire database te verminderen.
Deze verbeteren niet alleen de responsiviteit, maar zorgen er ook voor dat:
Verhoog het opslaggebruik
Elke optimalisatielaag introduceert meer datastructuren, of het nu gaat om een kopie van bestaande data in een gedenormaliseerd formaat, een vooraf berekende weergave of een cachetabel. Deze structuren dupliceren vaak gegevens die al elders zijn opgeslagen, wat leidt tot een grotere totale opslagvoetafdruk. In omgevingen met strikte opslagquota's of op kosten gebaseerde licentiemodellen, zoals Dataverse, kan dit snel leiden tot vermijdbare overschrijdingen.
Kan verweesd raken naarmate apps evolueren
Naarmate applicaties evolueren, worden sommige optimalisatieartefacten mogelijk niet meer aangehaald door actieve rapporten, dashboards of integraties. Deze verweesde objecten blijven opslagruimte innemen en kunnen zelfs de systeemwerking vertragen, bijvoorbeeld tijdens back-ups of indexering, als ze niet worden geïdentificeerd en verwijderd. Zonder regelmatige controles kunnen ze zich ongemerkt ophopen en de prestatieverbeteringen die ze juist zouden moeten ondersteunen, ondermijnen.
Optimalisatie van query's is essentieel voor schaalbaarheid, maar moet in evenwicht zijn met opslaghygiëne en telemetriegestuurde afstemming.
Indexen en hun impact op opslag
Indexen zijn essentieel voor het verbeteren van queryprestaties en het snel ophalen van gegevens in grote datasets. In zowel de Finance and Operations-app als in de Dynamics 365 Finance and Operations-apps worden automatisch indexen gemaakt voor primaire sleutels en vaak opgevraagde velden. Daarnaast kunnen andere aangepaste indexen worden gedefinieerd ter ondersteuning van specifieke bedrijfsscenario's. Dataverse
Hoewel indexen essentieel zijn voor de prestaties, hebben ze ook een directe impact op het opslagverbruik. Dit wordt vaak onderschat tijdens het ontwerp van oplossingen.
Hoe indexen opslagruimte verbruiken
Fysieke duplicatie van gegevens: Elke index slaat een kopie van de geïndexeerde kolommen op, samen met verwijzingen naar de overeenkomstige rijen. Hoe meer kolommen en rijen er zijn geïndexeerd, hoe groter de indexgrootte.
Groei met het datavolume: Naarmate de onderliggende tabel groeit, groeit ook de index. In omgevingen met veel transacties kunnen indexen snel groeien, vooral in grote, gedenormaliseerde tabellen of tabellen met frequente invoegingen en updates.
Meerdere indexen per tabel: Het is gebruikelijk dat één tabel meerdere indexen heeft, bijvoorbeeld voor zoeken, filteren, sorteren en samenvoegen. Elke andere index draagt bij aan de cumulatieve opslagvoetafdruk.
Zoekindexen in Dataverse: Functies zoals Dataverse zoeken en Copilot-indexering maken gespecialiseerde indexen die meerdere velden en tabellen omvatten. Deze worden opgeslagen in de DataverseSearch tabel en kunnen veel ruimte in beslag nemen, vooral wanneer ze in meerdere omgevingen worden gebruikt, zoals ontwikkel-, test- en productieomgevingen.
Door het systeem gegenereerde indexen: Sommige indexen worden automatisch door het platform gemaakt, zoals voor opzoekvelden of relaties. Deze kunnen blijven bestaan, zelfs als de bijbehorende tabellen verouderd zijn, tenzij ze expliciet worden verwijderd.
Implicaties voor opslag
- Grotere database- en logboekopslag: Indexen dragen bij aan het gebruik van database- en logboekopslag, wat van invloed kan zijn op de licentiekosten in Dataverse.
- Duplicatie van omgevingen: Wanneer omgevingen worden gekopieerd of vernieuwd, worden alle indexen gedupliceerd, waardoor het opslaggebruik in ontwikkelings-, test- en productieomgevingen wordt vergroot.
- Onderhoudsoverhead: Indexen moeten worden bijgewerkt wanneer gegevens wijzigen, wat de schrijflatentie en het resourceverbruik kan verhogen.
Impact van server-side synchronisatie op opslag
Server-side synchronisatie in Dataverse zorgt voor naadloze integratie van e-mails, afspraken en taken tussen Microsoft Exchange en Dataverse. Het verbetert de productiviteit en automatisering, maar draagt ook op de volgende manieren bij aan het opslagverbruik.
- Activiteitsrecord maken: Elke gesynchroniseerde e-mail of afspraak genereert een activiteitsrecord in Dataverse, dat metagegevens, de hoofdtekst en mogelijk bijlagen bevat.
- Opslag van bijlagen: Als bijlagen niet worden gefilterd of overgeladen, worden ze rechtstreeks in Dataverse opgeslagen, waardoor het opslaggebruik toeneemt.
- Naleving en bewaartermijn: Organisaties die server-side synchronisatie gebruiken om naleving bij te houden, bewaren mogelijk meer gegevens dan nodig is, waardoor de opslagruimte nog groter wordt.
- Beveiligde inhoud: Zelfs door Purview beveiligde e-mails genereren nog steeds tijdelijke records die ruimte innemen, ook al is de zichtbaarheid van de inhoud beperkt.
Om deze impact te beheersen, moeten bedrijven bewaarbeleid implementeren, overwegen om bijlagen te offloaden en de omvang van activiteitsrecords regelmatig controleren.
Hoe kan ik omgaan met de steeds groeiende opslagruimte?
Of u nu al te maken hebt met overschrijdingen van de opslagcapaciteit of dit wilt voorkomen, voor het beheren van de gegevensgroei in het Dynamics 365 Finance and Operations-platform is een doelbewuste, beleidsgestuurde aanpak vereist. Dataverse In dit hoofdstuk worden twee strategische invalshoeken beschreven: reactief herstel en proactief bestuur.
Er zijn twee mogelijke scenario's:
- U wilt proactief best practices toepassen om opslag te beheren en hoge kosten in de toekomst te vermijden.
- U bevindt zich al in een situatie waarin het noodzakelijk is de opslagruimte en de kosten te verkleinen.
Pas best practices toe om de opslagcapaciteit en -kosten te beheren
Scenario 1: U wilt proactief best practices toepassen om opslag te beheren
Als u nog niet in de crisismodus zit, is dit het moment om hulpmiddelen en technieken toe te passen om de opslag proactief te beheren.
Configureer analyses voor uw gegevens
Naarmate organisaties groeien, groeit ook de behoefte om inzichten uit operationele data te halen, zonder dat dit gevolgen heeft voor de prestaties van de belangrijkste bedrijfsapplicaties. Microsoft biedt meerdere manieren om analyses uit te voeren op Dataverse financiële en operationele gegevens uit Dynamics 365 door integratie met uw eigen data lake of warehouse.
Hier zijn twee krachtige opties om te overwegen:
Optie 1. Gebruik Azure Synapse Link – breng je eigen meer mee
Met Azure Synapse Link kunt u Dataverse rechtstreeks verbinden met uw eigen Azure Data Lake of Synapse-werkruimte. Hierdoor is bijna realtime replicatie van operationele gegevens in een analytische omgeving mogelijk, zonder dat er complexe ETL-pijplijnen geschreven hoeven te worden.
Voordelen:
- Voer geavanceerde analyses en AI-modellen uit op live- of bijna-livegegevens.
- Voorkom dat dit gevolgen heeft voor de prestaties van uw productiesystemen.
- Gebruik bekende hulpmiddelen zoals T-SQL, Spark of Power BI voor rapportage.
Praktijkvoorbeeld: Een detailhandelsbedrijf gebruikt Synapse Link om het aankoopgedrag van klanten in verschillende regio's te analyseren, waarbij klantrelatiebeheergegevens uit Dataverse worden gecombineerd met externe marktgegevens in hun eigen data lake.
Optie 2. Gebruik OneLake – uniforme analyses met Microsoft Fabric
OneLake, onderdeel van Microsoft Fabric, biedt een uniforme data lake-ervaring waarin u gegevens uit meerdere bronnen, waaronder Dataverse financiële en operationele apps, kunt opslaan en analyseren zonder duplicatie.
Voordelen:
- Gecentraliseerde opslag voor alle analytische workloads.
- Native integratie met Power BI-, Synapse- en AI-services.
- Vereenvoudigd beheer en beveiliging in alle datadomeinen.
Voorbeeld van een gebruiksscenario: Een financiële dienstverlener gebruikt OneLake om operationele gegevens uit financiële en operationele apps te consolideren en Dataverse met externe economische indicatoren, wat realtime risicomodellering en dashboards voor leidinggevenden mogelijk maakt. Zo kunt u operationele gegevens loskoppelen van uw kernsystemen en schaalbare, kosteneffectieve analyses uitvoeren door die gegevens te exporteren naar uw eigen analytische omgevingen, zonder dat u werklasten dupliceert of de prestaties beïnvloedt.
Hulpmiddelen en technieken om de opslag te verminderen
Dataverse biedt diverse ingebouwde hulpmiddelen en strategieën waarmee beheerders de opslag efficiënt kunnen beheren en de systeemprestaties kunnen handhaven.
Dataverse
Gegevens beheren met governancebeleid
- Begin met de omgevingen en tabellen die de meeste opslag gebruiken.
- Gebruik terugkerend governancebeleid om voorspelbare gegevensgroei te beheren, in plaats van alleen te vertrouwen op een eenmalige opschoning.
- Test verwijderings- en bewaarcriteria in een sandbox-omgeving voordat u deze in productie gebruikt.
- Controleer regelmatig de beleidsresultaten en fouten.
- Voeg opslagcapaciteit toe wanneer vereiste gegevens niet kunnen worden verwijderd of verplaatst naar langetermijnretentie.
Opschonen van omgeving en gegevens
- Ongebruikte omgevingen verwijderen: U kunt een omgeving verwijderen om opslagruimte vrij te maken en persoonlijk identificeerbare informatie (PII) te verwijderen.
-
Bulkverwijderingstaken: U kunt de volgende gegevens in bulk verwijderen:
- Verouderde gegevens of gegevens die niet relevant zijn voor het bedrijf.
- Overbodige test- of voorbeeldgegevens.
- Gegevens die verkeerd vanuit andere systemen zijn geïmporteerd.
Bestands- en tabeloptimalisatie
- Verminder de bestandsopslag met behulp van geavanceerd zoeken: Dit artikel geeft u 15 methoden om uw opslag beter te beheren. Gebruik een of meer van deze methoden om uw totale gegevensopslaggebruik te regelen. U kunt gegevenscategorieën verwijderen als de situatie dit vereist, of terugkerende bulkverwijderingstaken met ingestelde tussenpozen instellen. U kunt bijvoorbeeld notities, bijlagen, importgeschiedenis en andere gegevens verwijderen.
- Records opschonen uit systeemtaaktabellen (AsyncOperationBase) en proceslogboektabellen (workflowLogBase): Als uw organisatie intensief gebruikmaakt van workflows of bedrijfsprocesstromen, worden deze tabellen (AsyncOperationBase, workflowLogBase) na verloop van tijd groter en groter dan verwacht. Ze kunnen prestatieproblemen veroorzaken en te veel opslagruimte innemen in de database van uw organisatie. Voor workflowLogBase kunt u configureren dat voltooide achtergrondworkflowtaken automatisch worden verwijderd. ...
Langetermijnretentie (LTR) en archivering
- Gegevensarchivering: LTR: Dataverse ondersteunt aangepaste bewaarbeleidsregels om op een kostenefficiënte manier onbeperkt gegevens langdurig en veilig te bewaren. Hoewel Dataverse uw bedrijfsgroei kunt ondersteunen zonder limiet op actieve data, kunt u overwegen om inactieve data te verplaatsen naar de Dataverse opslag voor lange termijnretentie.
- Dataverse Tabellen opschonen: Als u de gegevens wilt behouden, maar deze uit de relationele opslag wilt verwijderen, kunt u Dataverse langetermijnbewaring van gegevens toepassen. Anders moet u de volgende tabellen opschonen:
- ActivityPointerBase: U kunt de onderstaande stappen volgen om de tabel op te schonen.
- AsyncOperationBase: U kunt de onderstaande stappen volgen om de tabel op te schonen.
- msdyn_copilotinteraction: U kunt de stappen hier volgen om de tabel op te schonen.
- PrincipalObjectsAcces: U kunt de onderstaande stappen volgen om de tabel op te schonen.
- Abonnement volgen: U kunt de onderstaande stappen volgen om de tabel op te schonen.
Zoekindexoptimalisatie
- Dataverse-zoekfunctie beperken: U kunt de opslaggrootte verkleinen door alle stappen in Details van op capaciteit gebaseerde Dataverse-opslag uit te voeren.
- Verklein de grootte van de DataverseSearch-tabel: De DataverseSearch tabel is de cumulatieve opslag die wordt gebruikt door de Dataverse zoekindex. Deze bevat de gegevens van alle doorzoekbare, ophaalbare en filterbare velden van de tabellen die u voor uw omgeving hebt geïndexeerd. U kunt de tabelgrootte verkleinen door zoekkolommen, weergavekolommen en filtervoorwaarden voor een of meer tabellen te verwijderen. U kunt de zoekfunctie van Dataverse uitschakelen om alle geïndexeerde gegevens te verwijderen.
Apps voor financiële en bedrijfsactiviteiten
Apps voor financiën en bedrijfsvoering bieden flexibele opties voor het beheren van opslag in productie- en sandboxomgevingen.
Milieubeheer
- Beperk het aantal volledige productiekopieën: u kunt het totale opslagverbruik van financiële en operationele apps verminderen door volledige productiekopieën in sandboxomgevingen te verwijderen. Als u bijvoorbeeld vijf kopieën van productieomgevingen in een sandbox hebt, is uw opslagverbruik de som van de productieomgeving plus vijf kopieën van productieomgevingen in een sandbox.
- Gegevens in sandbox-omgevingen beperken: door de gegevens in een sandbox-omgeving te beperken, kunt u de totale opslagruimte verkleinen. U kunt de onderstaande methoden volgen om de gegevens in de sandbox op te schonen.
- Tijdens het herstelproces worden het openen en bijsnijden uitgevoerd
- Schrijf T-SQL
- Schrijf X++
- Een transactieloze kopie uitvoeren tussen omgevingen: Het kopiëren van omgevingen voor financiële en operationele apps omvatte traditioneel volledige databaseduplicatie, inclusief configuratie, stamgegevens en transacties. Dit is weliswaar handig voor foutopsporing, maar verhoogt het opslagverbruik aanzienlijk voor zowel financiële als operationele toepassingen. Dataverse
Aangepaste opschoning en logboekbeheer
- Schrijf indien nodig aangepaste opschoonroutines: U kunt indien nodig aangepaste opschoonroutines schrijven om ongewenste gegevens op te schonen.
- Vermijd het opslaan van logboeken: U kunt SysDatabaseLog verplaatsen naar een minder transactionele database om de totale opslagvoetafdruk te verkleinen.
Archief- en langetermijnbewaring
-
Gegevensarchivering: LTR: Financiële en operationele apps stellen organisaties in staat de volgende voordelen te behalen door middel van archivering:
- Beveilig historische, inactieve applicatiegegevens voor de lange termijn om te voldoen aan audit-, juridische en wettelijke vereisten.
- Verminder de omvang van de toepassingsdatabase en de gebruikte capaciteit om mogelijk de toepassingsprestaties te verbeteren die verband houden met grote tabellen.
- Archiefgegevens instellen en beheren
- Archief aanpassen
- Consolidatie van voorraadtransacties
Ingebouwde opruimroutines
- Opschoonroutines: In Dynamics 365 Finance en Dynamics 365 Supply Chain Management zijn opschoonroutines beschikbaar in verschillende modules. Opruimroutines geeft een overzicht van de routines die momenteel beschikbaar zijn. Nadat u de sandbox-database hebt gekopieerd, voert u proactief de volgende opschoonroutines uit om onnodige tabellen te verwijderen, zoals batchgeschiedenis, logboeken en geschiedenis van detailhandelstransacties. Verwijder verouderde of irrelevante gegevens.
- Creditcardtransactiegegevens archiveren: Beschrijft een archiveringstaak in Dynamics 365 Commerce die kan helpen ruimte vrij te maken in de database door creditcardbetalingstokens te archiveren.
Verminder de opslagcapaciteit en -kosten
Scenario 2: U bevindt zich al in een situatie waarin het noodzakelijk is de opslagcapaciteit en -kosten te verkleinen
Beoordeel wat opslagruimte verbruikt
- Gebruik het Power Platform beheercentrum en de opslagrapporten voor financiën en bedrijfsvoering om de tabellen, bestandstypen en logboeken te identificeren die het meest worden verbruikt.
- Gebruik telemetrie (indien beschikbaar) om gebruik toe te wijzen aan specifieke apps, gebruikers of bedrijfseenheden.
Geef prioriteit aan kandidaten die een schoonmaakklus willen klaren
- Concentreer u op:
- Faserings- en integratietabellen, zoals buffers voor twee keer wegschrijven
- Auditlogs: bewaar ze in uw eigen opslag
- Ongebruikte omgevingen of sandboxen
- Verweesde metagegevens en zoekindexen
- Verwijder wat u niet nodig hebt, bijvoorbeeld door bulkverwijdering.
gebruik Synapse Link en OneLake voor analytische rapportage
- Exporteer de analytische gegevens naar Synapse Link.
- Met OneLake krijgt u toegang tot de bewaarde gegevens en bedrijfsgegevens voor rapportage- en analysedoeleinden.
Pas langetermijnretentie (LTR) toe
- Verplaats historische gegevens naar een Managed Data Lake (MDL) met behulp van LTR-beleid.
- Beheer zoek- en analysetoegang via Quick Find, Synapse Link of OneLake.
Gebruiksscenario's
Toepassingsscenario’s voor opslagbeheer in Dataverse- en finance and operations-omgevingen zijn van cruciaal belang voor het optimaliseren van databaseruimte, het verbeteren van de systeemprestaties en het voldoen aan regelgevingsvereisten. Hieronder staan enkele typische scenario's die laten zien hoe deze strategieën kunnen worden toegepast:
Het beheren van de groei van historische data
- Scenario: Een bedrijf werkt al enkele jaren met Dynamics 365 en heeft grote hoeveelheden historische transacties en bijlagen verzameld.
- Actie: Implementeer langetermijnretentiestrategieën om inactieve gegevens te bewaren, verklein de omvang van de primaire database en zorg voor naleving van auditvereisten.
Op naleving gebaseerde gegevensretentie
- Scenario: Een klant uit een gereguleerde sector moet financiële en klantgegevens zeven tot tien jaar bewaren in een fraudebestendig formaat.
- Actie: Gebruik LTR om de onveranderlijke, alleen-lezen gegevens te bewaren in overeenstemming met wettelijke en regelgevende vereisten, terwijl u de bedrijfsgegevens beperkt houdt zonder dat dit ten koste gaat van de analyses en rapportages.
Optimalisatie van zoek- en Copilot-index
- Scenario: Dataverse Zoeken en Copilot-indexering zijn ingeschakeld in alle omgevingen, inclusief ongebruikte tabellen.
- Actie: Controleer doorzoekbare velden en schakel indexering uit voor tabellen met een lage waarde of verouderde tabellen. Houd de grootte van de DataverseSearch-tabel in de gaten en optimaliseer configuraties om de logboek- en databaseopslag te verminderen.
Audit- en telemetriebeheer
- Scenario: Plug-in trace logs en audit logs groeien snel, verbruiken opslagruimte en hebben invloed op de prestaties.
- Actie: Exporteer logboeken naar externe systemen, zoals Azure Monitor, en automatiseer het opschonen van oude vermeldingen om de zichtbaarheid te behouden zonder dat dit de opslagruimte opblaast.
Integratie van datawarehousing en analyse
- Scenario: De organisatie repliceert operationele gegevens naar Azure Synapse of OneLake voor analyses, wat leidt tot dubbele opslag.
- Actie: Gebruik incrementele exports, pas filters toe en vermijd volledige replicatie van datasets om redundantie te minimaliseren en toch uitgebreide inzichten te bieden.
Het verminderen van opslagoverschotten
- Scenario: Een klant ontvangt een melding dat zijn/haar opslagquotum is overschreden, wat tot onverwachte kosten leidt. Dataverse
- Actie: Gebruik capaciteitsrapporten om de tabellen te identificeren die het meest verbruiken, om verouderde omgevingen op te schonen en om ongebruikte bijlagen of logboeken te verwijderen. Overweeg om koude gegevens (meestal historische of weinig gebruikte gegevens) te verplaatsen naar goedkopere opslaglagen.
Prestaties optimaliseren in grote tabellen
- Scenario: Bedrijfskritische processen worden vertraagd door grote tabellen.
- Actie: Archiveer oude records, ruim systeemtaken op, bijvoorbeeld AsyncOperationBase en workflowLogBase.
Levenscyclusbeheer van het milieu
- Scenario: Ontwikkel- en testomgevingen worden gekloond vanuit de productieomgeving, waarbij alle gegevens en indexen worden gedupliceerd.
- Actie: Sandbox-omgevingen na een vernieuwing bijwerken, onnodige zoekindexering uitschakelen en testgegevens verwijderen om redundant opslagverbruik te verminderen. Verwijder ongebruikte sandbox-omgevingen om opslagruimte te besparen.
Praktijkvoorbeelden
Praktijkvoorbeeld 1: Opslagoverschrijdingen verminderen door indexopschoning
Klantprofiel: Een wereldwijd productiebedrijf dat Dynamics 365 gebruikt voor apps voor toeleveringsketens, financiën en bedrijfsvoering.
Uitdaging: De klant had last van onverwachte overschrijdingen van de opslagruimte en prestatieverslechtering in hun productieomgeving. Uit onderzoek is gebleken dat meerdere aangepaste indexen en gematerialiseerde weergaven, die tijdens een vroege implementatie waren gemaakt, niet meer in gebruik waren, maar nog steeds veel opslagruimte in beslag namen.
Oplossing: Het team voerde elk kwartaal een controle uit van alle aangepaste indexen en verwijderde de indexen waarnaar niet werd verwezen door actieve query's of rapporten. Ze hebben ook een governancebeleid geïmplementeerd om nieuwe indexaanvragen te beoordelen voordat ze worden geïmplementeerd.
Resultaat:
- Verminderde databaseopslag met 28%.
- Verbeterde de queryprestaties met 15%.
- Bespaarde naar verwachting $ 12.000 per jaar aan overige opslagkosten.
Casestudy 2: Archiveren van historische gegevens om te voldoen aan nalevings- en prestatiedoelstellingen
Klantprofiel: Een financiële dienstverlener die Dataverse en Dynamics 365 gebruikt voor onboarding van klanten en casemanagementfunctionaliteit.
Uitdaging: Het bedrijf moest klantgegevens langer dan zeven jaar bewaren om te voldoen aan de wettelijke vereisten, maar de groeiende hoeveelheid inactieve gegevens vertraagde de actieve workflows en verhoogde de opslagkosten.
Oplossing: De klant implementeerde een strategie voor langetermijnretentie met behulp van de archiveringsmogelijkheden van Dataverse. Inactieve records werden verplaatst naar een opslaglaag met alleen-leestoegang die voor kosten was geoptimaliseerd, terwijl actieve gegevens in opslag met hoge prestaties bleven.
Resultaat:
- Meer dan 1,2 miljoen records gearchiveerd.
- De primaire databasegrootte is met 40% verkleind.
- Volledige controleerbaarheid en naleving van het retentiebeleid.
Casestudy 3: Zoekindexen stroomlijnen in verschillende omgevingen
Klantprofiel: Een retailorganisatie met meerdere Dataverse omgevingen, waaronder ontwikkelings-, test- en productieomgevingen, die een Copilot-compatibele oplossing voor klantrelatiebeheer ondersteunen.
Uitdaging: Zoekindexen werden in alle omgevingen gebruikt, inclusief ongebruikte tabellen en testgegevens. Dit leidde tot opgeblazen DataverseSearch tabellen en onnodig opslagverbruik.
Oplossing: Het team beoordeelde de doorzoekbare velden en stopte met het gebruik van indexering op niet-kritieke tabellen in ontwikkel- en testomgevingen. Ze automatiseerden ook het opschonen van indexen tijdens het vernieuwen van de omgeving.
Resultaat:
- Zoekindexopslag met 35% verminderd.
- De refreshtijd van de omgeving is met 20% verkort.
- Verlaagd totaal logboek- en databaseopslaggebruik.
Casestudy 4: Gegevensexport gebruiken voor analyses zonder opslag te dupliceren
Klantprofiel: Een zorgverlener die Dynamics 365 en Dataverse gebruikt voor patiëntbetrokkenheid en facturering.
Uitdaging: Het analyseteam had toegang nodig tot operationele gegevens voor trendanalyse en AI-modellering, maar het dupliceren van gegevens in een apart datacenter leidde tot hogere opslagkosten en meer complexiteit.
Oplossing: De klant gebruikte Azure Synapse Link met incrementele export en gelaagde opslag in OneLake. Ze bewaarden alleen de essentiële analytische gegevens en pasten bewaarbeleid toe om de historische diepgang te beheren.
Resultaat:
- Maakt realtime-analyses mogelijk zonder dat dit gevolgen heeft voor operationele systemen.
- Vermindering van redundante opslag met 45%.
- Verbeterd beheer van de levenscyclus van analytische gegevens.
Conclusie
Effectief opslagbeheer is essentieel voor het handhaven van de systeemprestaties en het optimaliseren van het resourcegebruik in Dynamics 365-omgevingen. De opruimroutines en archiveringstaken die in dit artikel worden beschreven, bieden robuuste oplossingen om kostbare databaseruimte vrij te maken en de bedrijfsvoering te stroomlijnen. Met behulp van hulpmiddelen zoals LTR en vergelijkbare technieken kunnen klanten veelvoorkomende opslaguitdagingen aanpakken en duurzame gegevensbeheerpraktijken creëren. Bovendien tonen praktijkcases de doeltreffendheid van deze benaderingen aan en bieden ze inzicht in hun praktische toepassingen. Door deze strategieën te implementeren, kunnen organisaties hun opslagbehoeften proactief beheren en de algehele efficiëntie verbeteren.
Verwijzingen
Opslagopruiming in Dataverse:
- Opslagruimte vrijmaken
- Records opschonen uit de tabellen Systeemtaak (AsyncOperationBase) en Proceslogboek (workflowLogBase)
Opruimen van opslag in financiën en bedrijfsvoering:
- Opslagcapaciteit voor financiën en bedrijfsvoering
- Opschoningsroutines in Dynamics 365 Finance en Dynamics 365 Supply Chain Management
- Gegevens van creditcardtransacties archiveren - Commerce
Opslagcapaciteit: